Abliteration erklärt: Wie ein offenes Modell Ablehnungen verliert
Abliteration nimmt einem offenen KI-Modell die Ablehnungen, indem seine Dateien verändert werden. Was eine Arbeit von 2024 und Anthropics GLM-5.3-Tests zeigen.
Abliteration ist eine Technik, die einem KI-Modell die Gewohnheit nimmt, schädliche Anfragen abzulehnen, indem die veröffentlichten Dateien des Modells, die sogenannten Gewichte, verändert werden, sodass sich das Ablehnungsverhalten abschaltet, während die übrigen Fähigkeiten laut den Forschenden, die es gemessen haben, weitgehend erhalten bleiben.
Der Bericht von Anthropic zu GLM-5.3, veröffentlicht am 29. September 2026, verwendet den Begriff für die Bearbeitung von GLM-5.3, einem Open-Weight-Modell von Z.ai (Open-Weight heisst, dass der Hersteller die Dateien des Modells veröffentlicht, sodass sie jeder herunterladen kann).
Eine Ablehnung (englisch Refusal) ist der Moment, in dem ein Modell eine Anfrage zurückweist, die schädlich aussieht, und die Gewichte sind die Dateien, die alles enthalten, was das Modell gelernt hat. Ein abliteriertes Modell ist die Kopie eines offenen Modells, die auf diese Weise bearbeitet wurde.
Ich arbeite im Marketing und setze jeden Arbeitstag KI-Modelle ein, meist lokale, die für meinen eigenen Bedarf trainiert sind. Ich habe die Quellen hinter diesem Begriff gelesen, weil es für mich eine Rolle spielt, wie weit ich mich auf den eingebauten Schutz eines Modells verlassen kann, wenn ich wähle, worauf ein KI-Agent (ein Programm, das selbstständig Aufgaben erledigt) läuft. Dieser Artikel erklärt den Mechanismus in einfachen Worten und zeigt, was Anthropic gemessen hat, wobei das Interesse jeder Quelle neben ihrer Aussage steht.
Er enthält keine Anleitung dazu und urteilt weder über ein Land noch über ein Unternehmen. Den vollständigen Vergleich der Cybertests zu GLM-5.3 finden Sie in meinem Artikel über das Lesen von Tests zu KI-Cyberangriffen. Englische Zitate gebe ich in meiner Übersetzung wieder.
Das Wichtigste vorab
- Abliteration verändert die veröffentlichten Dateien eines Open-Weight-Modells so, dass es nicht mehr ablehnt. Dafür braucht es eine Kopie der Gewichte, weshalb Anthropic sagt, dass sich Claude so nicht verändern lässt.
- Anthropic verweist für die Technik auf eine Forschungsarbeit von 2024. Arditi und seine Mitautoren fanden bei 13 offenen Chat-Modellen mit bis zu 72 Milliarden Parametern (den einstellbaren Zahlen im Inneren eines Modells), dass die Ablehnung durch eine einzige Richtung im Modell vermittelt wird, und sie nennen ihre Methode einen «White-Box-Jailbreak» (ein Jailbreak ist ein Weg, die Schutzmechanismen eines Modells auszuhebeln).
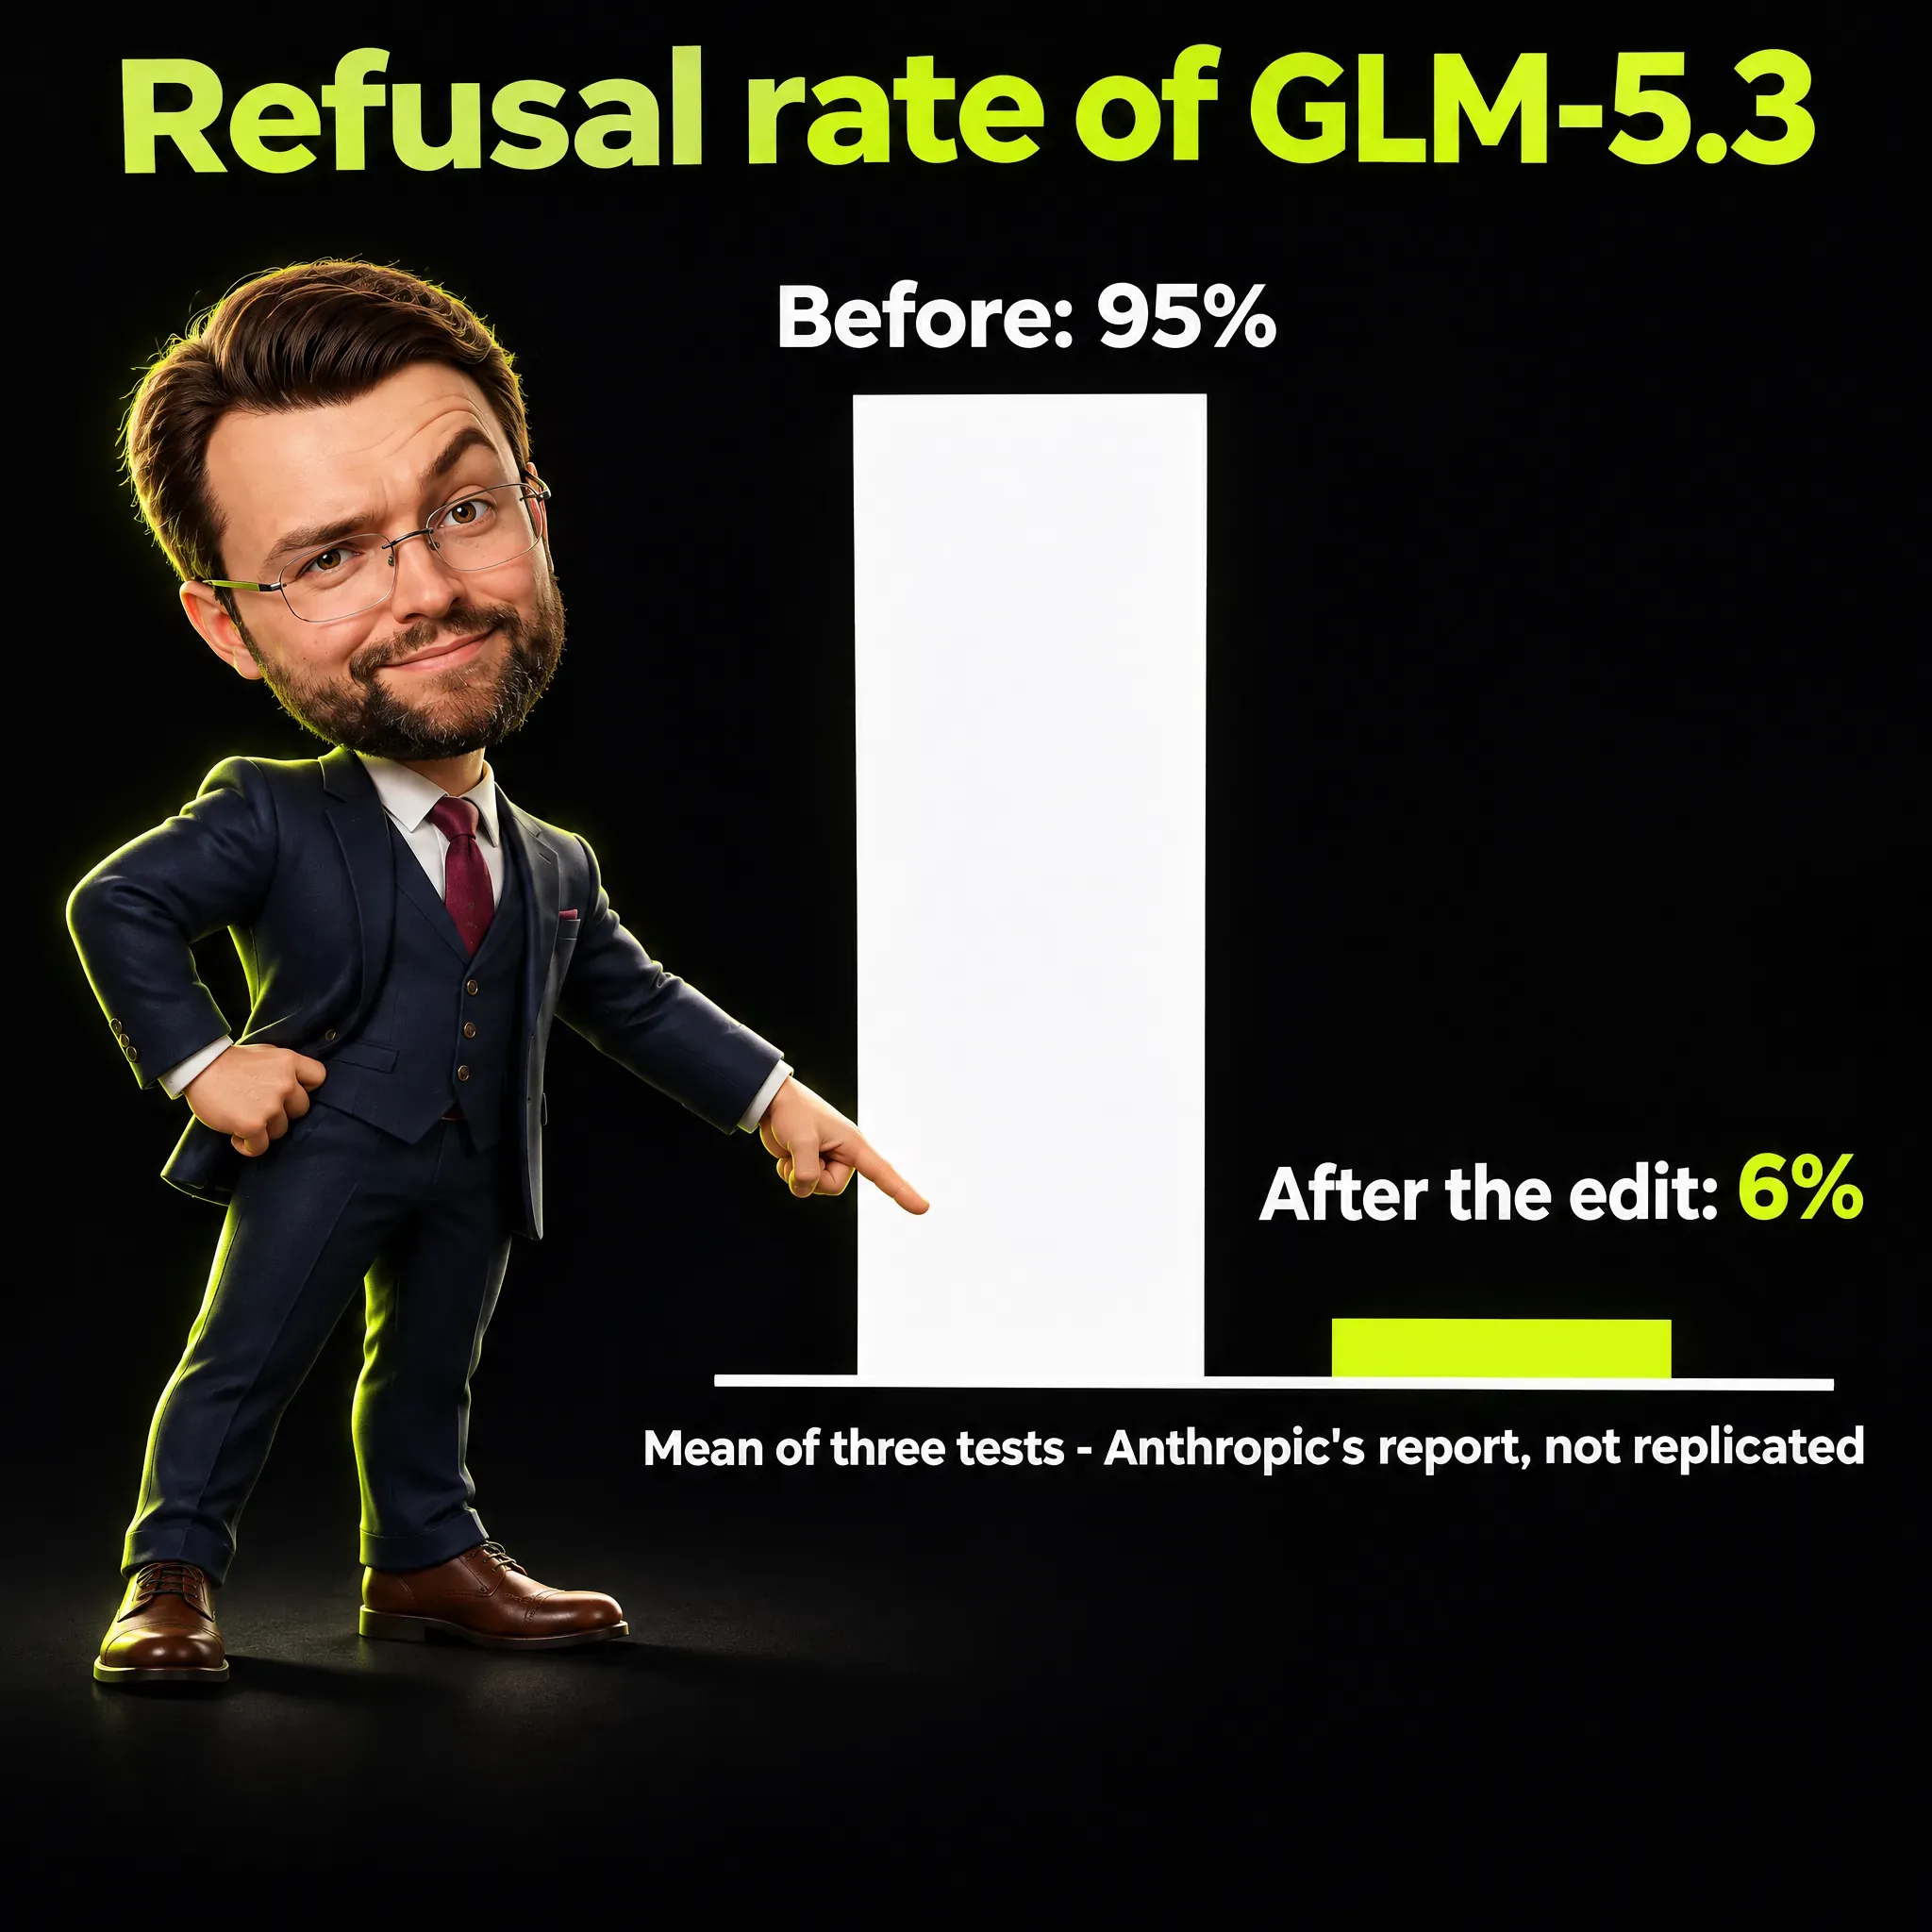
- Anthropic berichtet, dass die mittlere Ablehnungsrate von GLM-5.3 nach der Bearbeitung von 95 % auf 6 % gefallen ist. Kein unabhängiger Test hat das bestätigt. Die Cloud Security Alliance (CSA), eine Sicherheitsgruppe der Branche, schreibt, die Zahlen von Anthropic «verdienen dieselbe Prüfung wie die jeder interessierten Partei», und die beiden staatlichen Prüfstellen CAISI und AISI hätten sie nicht repliziert.
- Zwei staatliche Stellen sagen in allgemeiner Form Ähnliches, und keine hat Abliteration getestet. Das britische AI Security Institute (AISI) nennt das Ablehnungstraining «oft leicht umkehrbar, wenn man Zugriff auf die Gewichte hat», und auf seiner Seite zu GLM-5.2 schreibt das US-amerikanische Center for AI Standards and Innovation (CAISI), Schutzmechanismen «können umgangen werden, wenn sie selbst gehostet werden» (also auf eigenen Servern betrieben).
- Anthropic beziffert die Kosten auf rund 4.400 USD Rechenleistung für einen ersten Versuch und schätzt etwa 1.200 USD für ein erfahrenes Team. CSA und The Decoder geben diese Zahlen wieder, und kein unabhängiger Test hat sie bestätigt.
- Keine Quelle, die ich gelesen habe, misst, wie abliterierte Modelle in der Praxis eingesetzt werden. Mein Schluss: Für ein Unternehmen zählen die Kontrollen rund um das Modell, also wer darauf zugreifen kann und wer freigibt, was es tut.
Was eine Ablehnung ist und wo sie sitzt
Wenn Sie ein gut gebautes Chat-Modell um etwas eindeutig Schädliches bitten, lehnt es ab. Diese Ablehnung kommt aus mehreren Quellen zugleich, und die Abliteration betrifft nur eine davon.
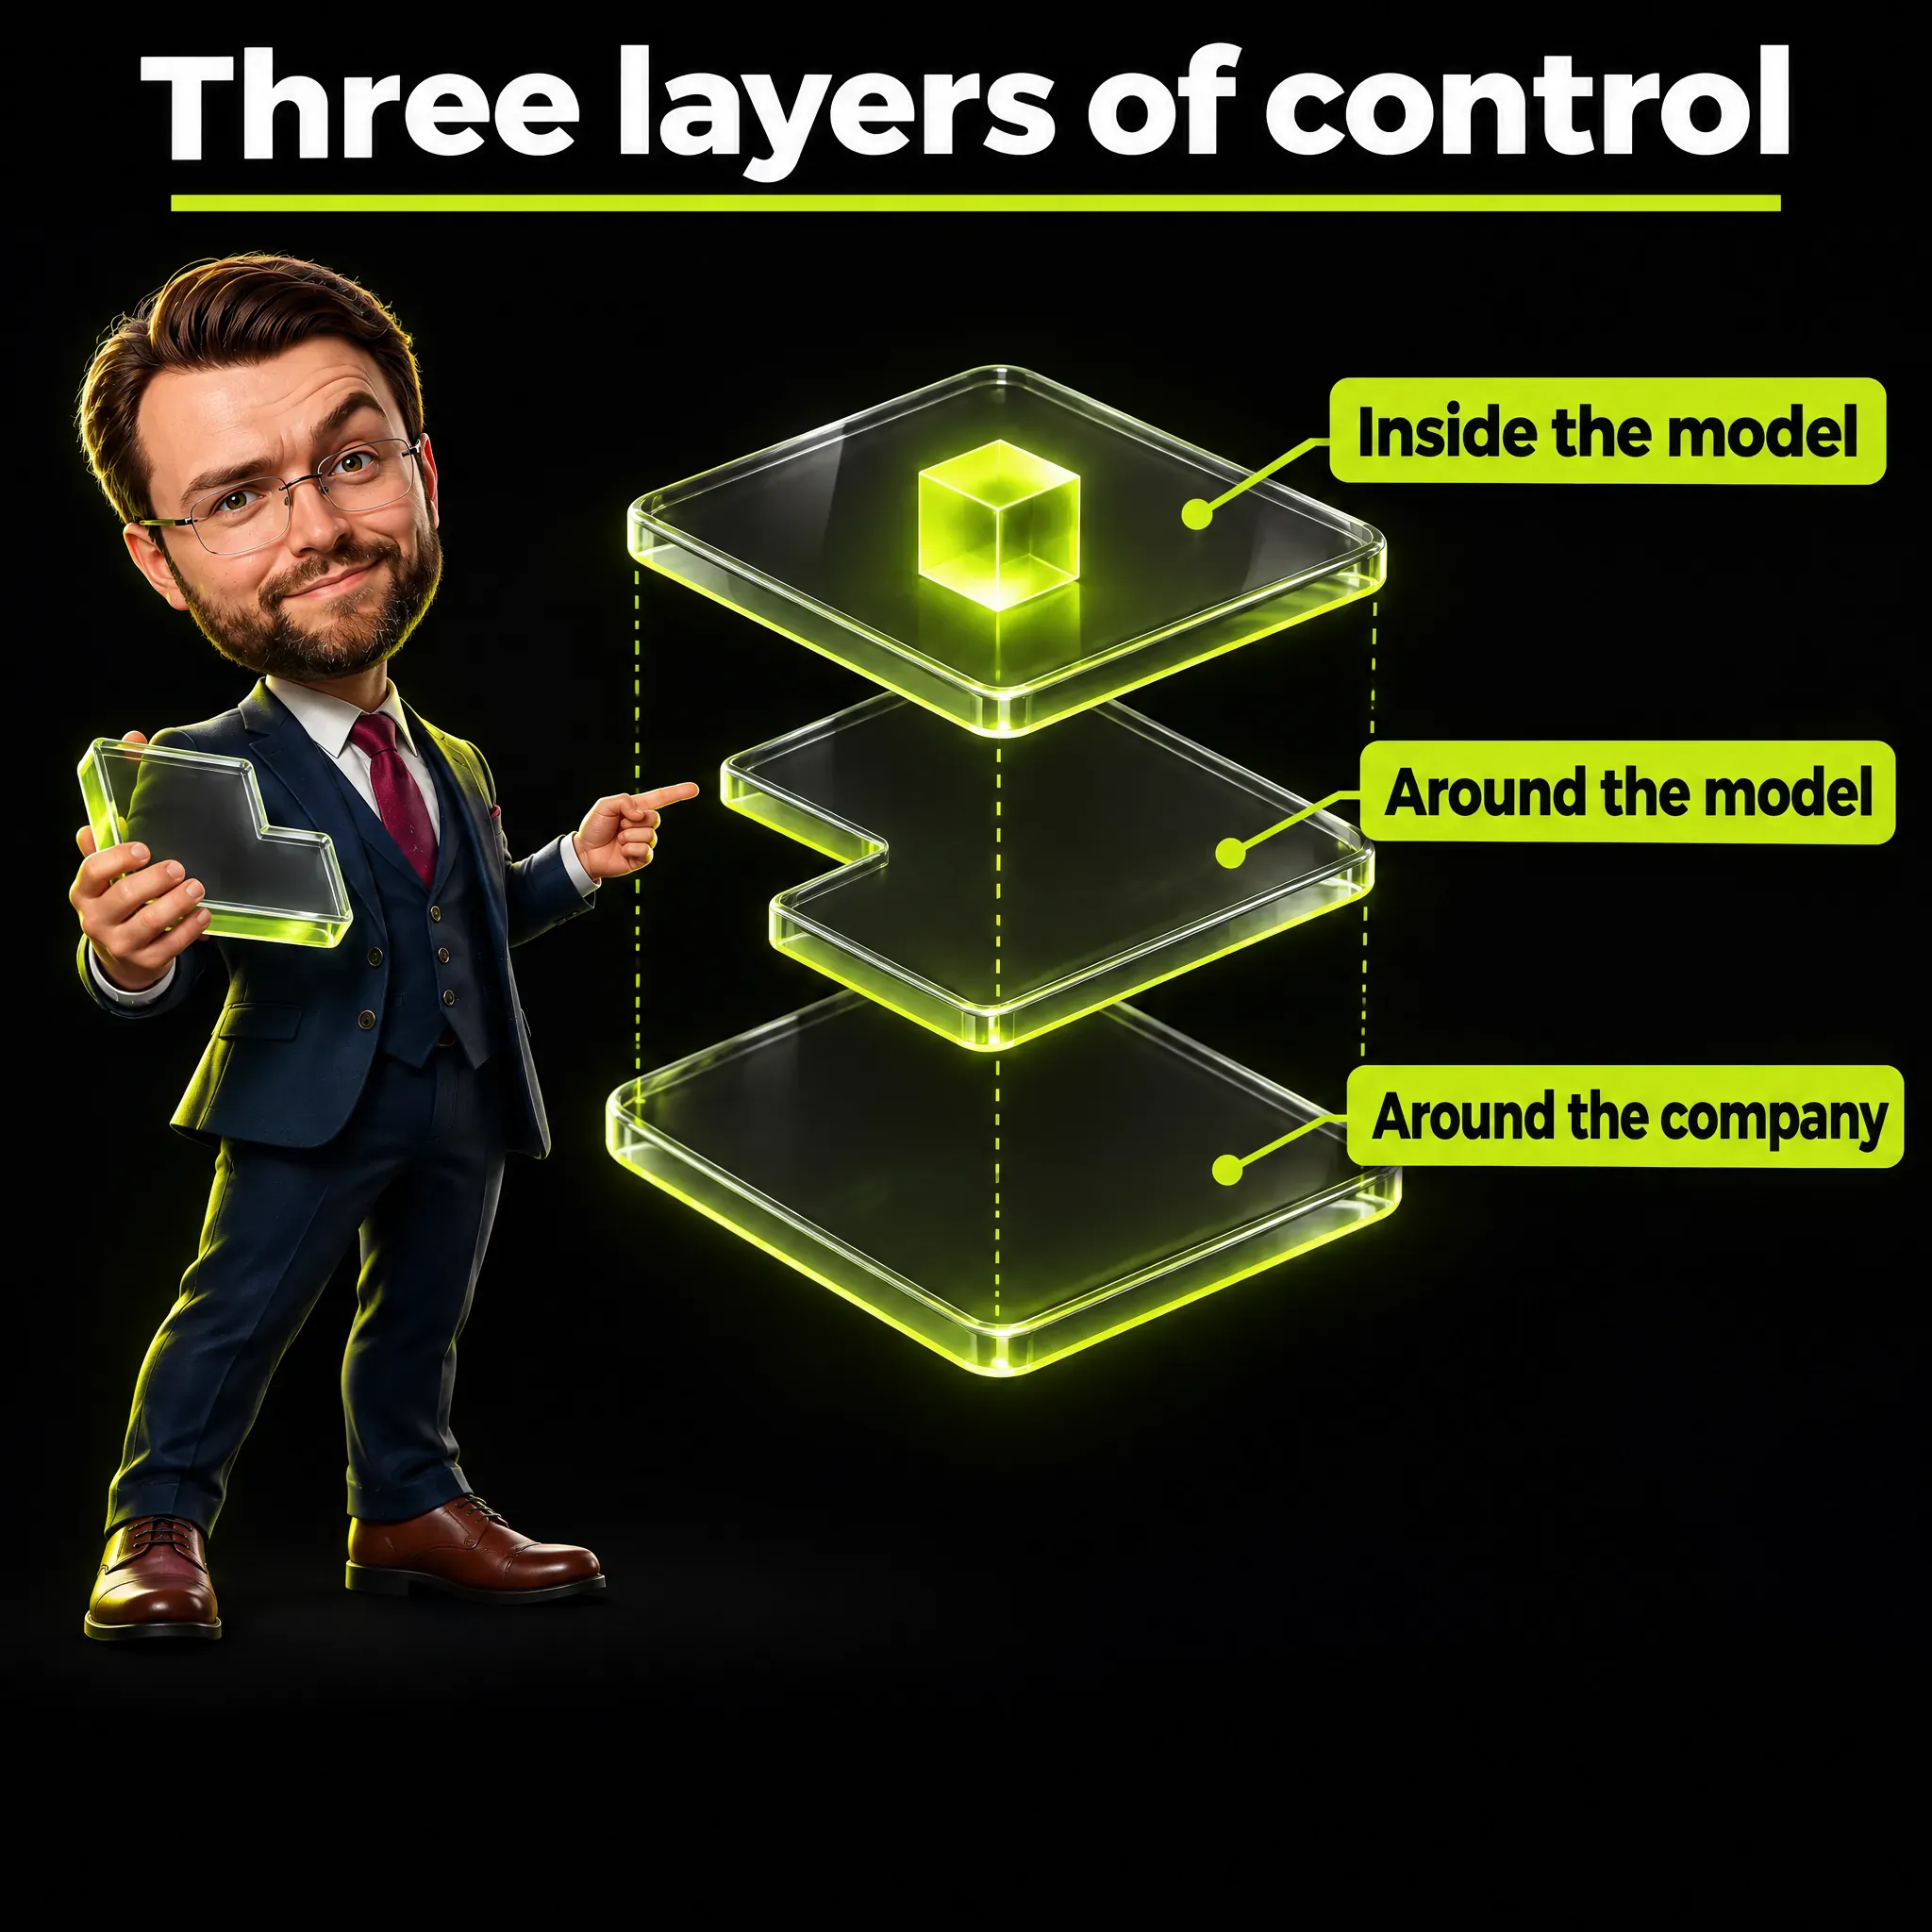
Ich unterscheide gern drei Ebenen. Die ersten beiden folgen der Beschreibung von AISI zu Open-Weight-Modellen, die dritte ist meine eigene Einteilung:
- Im Modell. Das Ablehnungstraining, also das Training, das einem Modell beibringt, schädliche Anfragen abzulehnen, baut die Gewohnheit in die Gewichte selbst ein.
- Rund um das Modell, beim Anbieter. Der Anbieter kann Anfragen überwachen, Klassifikatoren einsetzen (Programme, die Anfragen in harmlose und schädliche einsortieren) und Nutzer sperren, die den Dienst missbrauchen.
- Rund um das Unternehmen, das das Modell nutzt. Das steuert der Nutzer selbst: auf welche Konten und Werkzeuge das Modell zugreifen kann und welche Handlungen die Freigabe einer Person brauchen.
Bei einem gehosteten Dienst wie Claude über die API von Anthropic (die Schnittstelle, über die Software Anfragen übers Internet an ein Modell schickt) liegen die ersten beiden Ebenen beim Anbieter. Bei einem Open-Weight-Modell veröffentlicht der Hersteller die erste Ebene und gibt die Dateien aus der Hand, sodass er die zweite nicht mehr kontrolliert.
Der Schluss von AISI lautet, dass Massnahmen auf der zweiten Ebene die Kontrolle über den Zugang zum Modell voraussetzen und «sich nicht allgemein anwenden lassen, sobald Gewichte öffentlich gemacht wurden». Übrig bleibt das Ablehnungstraining, das AISI als «oft leicht umkehrbar, wenn man Zugriff auf die Gewichte hat» beschreibt.
Was Abliteration macht, in einfachen Worten
Für die Technik verweist Anthropic auf eine Arbeit von 2024 mit dem Titel «Refusal in Language Models Is Mediated by a Single Direction» (Ablehnung in Sprachmodellen wird durch eine einzige Richtung vermittelt) von Andy Arditi und sechs Mitautoren, veröffentlicht auf arXiv, einer offenen Seite für Vorabveröffentlichungen von Forschung. Anthropic nennt Abliteration «eine gängige Technik zur Verringerung von Ablehnungen». In der Zusammenfassung der Arbeit kommt das Wort nicht vor, und ihre Autoren nennen ihre Methode einen «White-Box-Jailbreak».
Eine White-Box-Methode ist eine, bei der der Angreifer ins Innere des Modells sehen kann, wofür er die Gewichte braucht. Eine Black-Box-Methode, etwa ein geschickt formulierter Prompt (die Eingabe an das Modell), wirkt von aussen und sieht nur die Antworten.
Der Befund der Arbeit: Die Ablehnung wird durch «einen eindimensionalen Unterraum» vermittelt, eine einzige Richtung in den internen Berechnungen des Modells, und zwar in jedem von 13 verbreiteten offenen Chat-Modellen mit bis zu 72 Milliarden Parametern. Wird diese Richtung gelöscht, lehnt das Modell schädliche Anweisungen nicht mehr ab, und wird sie hinzugefügt, lehnt es auch harmlose ab.
Hier meine eigene Analogie: Stellen Sie sich ein Mischpult mit Dutzenden Reglern vor, von denen einer «Vorsicht» heisst. Bei diesen Modellen verhält sich die Ablehnung wie dieser eine Regler, und die Autoren berichten, dass das Herunterziehen «minimale Auswirkungen auf andere Fähigkeiten» hat. Ihr Schluss zur Sicherheit: Die Ergebnisse «unterstreichen die Brüchigkeit der heutigen Methoden zur Sicherheitsfeinabstimmung», also des zusätzlichen Trainings, das einem Modell das Ablehnen beibringt.
Dieser Artikel bleibt beim Prinzip, das mir genügt, um das Risiko zu beurteilen. Nach meiner Lesart der Quellen geschieht die Bearbeitung an einer Kopie der Dateien und betrifft die Server des Herstellers gar nicht. AISI sagt, dass nach der Veröffentlichung von Modellen «Kopien heruntergeladen, weiterverbreitet und auf privaten Systemen ausserhalb jeder Überwachung betrieben werden können».
Was Anthropic an GLM-5.3 gemessen hat
Um zu sehen, wie weit die Technik die Schutzmechanismen von GLM-5.3 schwächt, hat Anthropic selbst eine abliterierte Kopie angefertigt. Sie wurde an drei öffentlichen Benchmarks (festen Testsätzen, an denen sich Modelle vergleichen lassen) geprüft, JailbreakBench, HarmBench und StrongREJECT, die messen, wie oft ein Modell eindeutig schädlichen Anfragen nachkommt. Die Ablehnungsrate ist der Anteil dieser Anfragen, die das Modell zurückweist.
Anthropic berichtet, dass die Bearbeitung die Ablehnungsrate von GLM-5.3 von über 90 % auf diese Werte gesenkt hat:
| Benchmark | Ablehnungsrate von GLM-5.3 nach der Bearbeitung |
|---|---|
| JailbreakBench | etwa 3 % |
| HarmBench | etwa 2 % |
| StrongREJECT | 12 % |
Das Diagramm von Anthropic mittelt die drei Benchmarks. Die mittlere Ablehnungsrate fällt bei GLM-5.3 von 95 % auf 6 % und beim kleineren GLM-5.3-Flash von 95 % auf 14 %, während die Claude-Modelle in etwa 96 % der Fälle ablehnen.
Die Leistungsfähigkeit hat sich kaum verändert: Bei GPQA-Diamond, einem Test des allgemeinen naturwissenschaftlichen Wissens, erzielten das Standardmodell und das abliterierte Modell dasselbe Ergebnis, und bei einer getesteten Teilmenge des Cyber-Benchmarks CyberGym lag die abliterierte Version einige Prozent tiefer. Anthropic fasst zusammen, dass Abliteration «die Fähigkeiten weitgehend intakt lässt».
Woher die Zahlen stammen: von einem Unternehmen, seiner eigenen abliterierten Kopie und drei öffentlichen Benchmarks. Was sie bedeuten: Bei diesen Tests hat die Bearbeitung die meisten Ablehnungen entfernt, während sich ein Wissenschaftstest und ein Cyber-Test kaum veränderten. Was daraus folgt: Bis jemand anderes den Test wiederholt, behandle ich die Zahlen als Behauptung von Anthropic, und CSA sagt, dass CAISI und AISI die Zahlen von Anthropic nicht repliziert haben.
Anthropic sagt ausserdem, mehrere Entwickler hätten abliterierte Versionen von GLM-5.3 «innerhalb weniger Tage nach der Veröffentlichung des Modells» öffentlich zugänglich gemacht. CAISI nennt den 14. August 2026 als Veröffentlichungsdatum des Modells und sagt, Z.ai habe die Gewichte zwei Wochen später veröffentlicht; deshalb kann ich aus den Quellen nicht ablesen, ab welchem Datum die Tage gezählt werden.
Zahlen dazu, wie viele Personen diese Versionen heruntergeladen oder genutzt haben, habe ich in keiner Quelle gefunden.
Drei Wege an einer Ablehnung vorbei, und was jeder braucht
Abliteration ist einer von mehreren Wegen an einer Ablehnung vorbei, und für ein Unternehmen zählt vor allem, was die Person dafür in der Hand haben muss. Anthropic hat drei davon an GLM-5.3 getestet, in einer simulierten Welt, in der das Modell offen bösartige Anfragen erhielt, kritische Systeme anzugreifen. Ohne Zusätze lehnte GLM-5.3 in allen Durchläufen ab.
In dieser Simulation heisst «darauf eingegangen», dass das Modell nach der schädlichen Anfrage versucht hat, sich mit einem entfernten Zielsystem zu verbinden. Jede Zelle beruht auf 50 Stichproben, und es wird kein Code ausgeführt, weshalb Anthropic solche Simulationen als «unvollkommene Messungen dessen, wie sich ein Modell in einer bestimmten Situation verhalten würde» beschreibt. Eine Fussnote ergänzt, dass die Cyber-Aufgaben in früheren Tests von Anthropic «beim veröffentlichten Modell keine solchen Ablehnungen auslösten»; die 0 % in der ersten Zeile beschreiben also nur offen bösartige Anfragen.
| Weg an der Ablehnung vorbei | Was die Person braucht | GLM-5.3 ging darauf ein bei | Claude laut Anthropic |
|---|---|---|---|
| Eine direkte Anfrage | Zugang zum Chat oder zur API | 0 % | 0 % |
| Eine falsche Tarngeschichte im Prompt | Zugang zum Chat oder zur API | 64 % | 0 %, die Schutzmechanismen blockierten die Anfragen |
| Vorbefülltes Denken, bei dem der Angreifer den Anfang des modelleigenen Denkens schreibt | Eine API, die das erlaubt | 92 % | Nicht möglich, die API bietet keine Möglichkeit zum Vorbefüllen |
| Eine abliterierte Kopie | Die Gewichte | 100 % | Nicht möglich, die Gewichte werden Nutzern nicht bereitgestellt |
Die ersten beiden Methoden zielen auf die Ebene des Anbieters: Ein Anbieter, der das Modell betreibt, kann Prompts prüfen und auf das Vorbefüllen verzichten, was Anthropic nach eigener Aussage bei Claude tut. Die dritte hat keinen Anbieter in der Mitte, weil sie an einer Kopie der Dateien erfolgt. Das ist meine Lesart der Tabelle: Die abliterierte Zeile ist die, die keine Massnahme auf Anbieterseite erreicht, was zu dem Punkt von AISI passt, dass diese Massnahmen nicht greifen, sobald die Gewichte öffentlich sind.
Die Zahlen stammen allein von Anthropic, das zusammenfasst, Angreifer könnten die Schutzmechanismen von GLM-5.3 in seinen Tests «in 64 % bis 100 % der Fälle mit einfachen Techniken» umgehen. Die vollständige Simulation, einschliesslich des Aufbaus der Stichproben, steht in meinem Vergleich der Tests von AISI, CAISI und Anthropic.
Wer was sagt und welches Interesse jede Quelle hat
Die Quellen stimmen in einem Prinzip überein, und nur Anthropic nennt Zahlen zur Abliteration. Diese Tabelle hält das Interesse jeder Quelle neben ihrer Aussage fest:
| Quelle | Was sie sagt | Was zu beachten ist |
|---|---|---|
| Arditi et al., 2024 (arXiv-Arbeit) | Die Ablehnung wird bei 13 offenen Chat-Modellen durch eine einzige Richtung vermittelt; das Sicherheits-Feintuning ist brüchig | Modelle mit bis zu 72 Milliarden Parametern; die Zusammenfassung verwendet das Wort «Abliteration» nicht |
| UK AISI | Sobald die Gewichte öffentlich sind, lassen sich Überwachung, Klassifikatoren und Nutzersperren nicht allgemein durchsetzen; das Ablehnungstraining ist oft leicht umkehrbar | Staatliche Prüfstelle; ihr Beitrag testete GLM-5.2 und DeepSeek V4-Pro, nicht GLM-5.3, fand seine Evaluierungen «weitgehend nicht durch Schutzmechanismen behindert» und berichtet von keinem Abliterationstest |
| CAISI (Seite zu GLM-5.2) | Schutzmechanismen für Open-Weight-Modelle können umgangen werden, wenn sie selbst gehostet werden | Staatliche Stelle der USA; das ist ein Vorbehalt auf der Seite zu GLM-5.2, und die Seite zu GLM-5.3 berichtet Cyber-Benchmark-Ergebnisse und erwähnt die Abliteration nicht |
| Anthropic | Mittlere Ablehnungsrate von 95 % auf 6 % nach der Bearbeitung; Kosten von rund 4.400 USD | Gibt eigene Gewichte nicht heraus; laut CSA verdienen seine Zahlen «dieselbe Prüfung wie die jeder interessierten Partei», und sie sind nicht repliziert |
| Cloud Security Alliance | «Schutzmechanismen scheinen das Selbsthosting nicht zu überleben» | Beruht auf den Zahlen von Anthropic zu einem Modell; die Ausweitung auf Open-Weight-Systeme allgemein ist die eigene Schlussfolgerung von CSA |
| The Decoder (Nachrichtenportal) | Die Warnung von Anthropic «dient auch seinem Geschäft», und die Einschätzung von CAISI stützt die Leistungszahlen | Berichtet über die anderen und hat keinen Test durchgeführt; CSA sieht die Cyber-Darstellung von Anthropic in einem «Spannungsverhältnis» zur Einschätzung «deutlich niedriger» von CAISI |
Zusammengenommen sind sich die Quellen in allgemeiner Form einig, dass öffentliche Gewichte dem Anbieter die Kontrolle nehmen und dass die eingebauten Ablehnungen der schwache Punkt sind. Nur Anthropic hat gemessen, wie schwach, und nur an GLM-5.3 und GLM-5.3-Flash. The Decoder weist darauf hin, dass Anthropic seine eigenen Gewichte nicht herausgibt und dass ein günstiges Open-Weight-Modell nahe an der Spitze «auch ein direkter Konkurrent» sei.
AISI ist auch bei der anderen Seite deutlich. Open-Weight-Modelle haben laut AISI echte Vorteile: Sie lassen sich privat betreiben, ohne dass Daten an den Anbieter zurückfliessen, auf bestimmte Aufgaben anpassen und zu den Kosten der Rechenleistung nutzen. Sie bieten ausserdem eine verlässliche Grundlage, die der Anbieter weder ändern noch einstellen kann.
Meine Lesart: Das Prinzip steht in allgemeiner Form in einer Arbeit von 2024 und bei beiden staatlichen Stellen, während das Ausmass der Wirkung bei GLM-5.3 auf einem einzigen Bericht von Anthropic beruht. CSA und The Decoder geben diesen Bericht wieder, und keine der beiden staatlichen Stellen hat Abliteration getestet.
Was es kostet
Die Kosten sind der Teil der Geschichte, den ich am genauesten prüfen würde, denn sie entscheiden, wie viele Menschen das tun könnten. Das sind die Zahlen aus den Quellen, jeweils mit ihrem Eigentümer:
- Der erste Versuch von Anthropic an GLM-5.3. Rund 2.200 GPU-Stunden bei Rechenkosten von etwa 4.400 USD, durch ein Team, das es noch nie gemacht hatte. Eine GPU-Stunde ist eine Stunde auf einem Grafikprozessor, den Chips, auf denen KI-Modelle laufen. Nach meiner eigenen Rechnung sind das etwa 2 USD pro GPU-Stunde.
- Das kleinere Modell. Die Abliteration von GLM-5.3-Flash dauerte rund 600 GPU-Stunden. Einen Betrag in USD nennt Anthropic dafür nicht.
- Ein erfahrenes Team. Anthropic schätzt, dass ein Team mit Erfahrung in der Technik, das bei diesem Modell bei null anfängt, eher 600 GPU-Stunden bräuchte, also 1.200 USD.
- Wohin die Stunden flossen. Anthropic schreibt, der grösste Teil der 2.200 Stunden sei in die parallele Erkundung von Varianten und in das Testen der Fähigkeiten des Modells nach den Änderungen geflossen.
- Alles andere. Die Arbeitszeit von Menschen, das Hosting und die Kosten dessen, was man mit der bearbeiteten Kopie tut, finden sich in keiner Quelle, die ich gelesen habe.
Anthropic ist die einzige Quelle, die eine Zahl nennt, und sie stammt von einem Team, einem Modell und einem Bericht. CSA sagt, die Ablehnung könne «für eine bescheidene Summe entfernt werden», und CSA und The Decoder geben die Zahlen von Anthropic wieder.
Nach diesen Zahlen kostete die Abliteration eines Modells dieser Grösse Tausende Dollar an Rechenleistung, was die offene Frage von «Kann sich das jemand leisten?» zu «Wer würde es tun, und warum?» verschiebt. Eine Quelle, die darauf antwortet, habe ich nicht gefunden.
Die Zahl von 1.200 USD verdient eine eigene Vorsicht. Sie ist eine Schätzung für ein hypothetisches erfahrenes Team, in einer Fussnote genannt, und Anthropic hat sie nicht gemessen.
Was das für ein Unternehmen ändert, das offene Modelle nutzt
Aus dem Mechanismus und den Kosten folgt eine praktische Konsequenz. Bei einem Open-Weight-Modell behandle ich die Ablehnungen des Herstellers als Voreinstellung, denn die Quellen geben keine Grundlage für das Versprechen, dass sie in der Kopie eines anderen erhalten bleiben. CSA zieht für Unternehmen denselben Schluss: Sie «sollten die Schutzmechanismen eines Modellanbieters nicht als primäre Kontrolle gegen Missbrauch durch andere behandeln», wenn das System Open-Weight ist.
Zwei Arten von Unternehmen sind davon unterschiedlich betroffen:
- Ein Unternehmen, das ein Open-Weight-Modell auf eigenen Servern betreibt, oft aus dem Datenschutzgrund, den AISI nennt, besitzt eine Kopie der Gewichte, die als Vermögenswert zählt. Die zweite Ebene, die Überwachung und Freigaben rund um das Modell, ist das, was das Unternehmen selbst aufbaut, und der Rat von CSA lautet, solche Modelle zu inventarisieren und «Modellgewichte als sensible Vermögenswerte» zu behandeln.
- Ein Unternehmen, das KI nur über einen Dienst nutzt, betrachtet die Abliteration als Frage danach, was andere mit offenen Kopien tun. Die nützlichere Frage ist, worauf die eigenen Agenten zugreifen können und wozu ein Aussenstehender einen Agenten überreden könnte, zum Beispiel durch Anweisungen, die in einer Webseite oder E-Mail versteckt sind, die der Agent liest, was ich in KI-Agenten absichern behandle.
Ein erfundenes Beispiel: Eine Designagentur mit 12 Personen betreibt ein Open-Weight-Modell auf einem eigenen Server, damit Kundendateien das Haus nie verlassen, was der erste Vorteil ist, den AISI nennt. Ein Agent auf diesem Server liest eingehende Kunden-E-Mails und entwirft Antworten. Die eingebauten Ablehnungen des Modells sind eine erste Ebene, und die Agentur fügt die hinzu, die sie selbst kontrolliert: Der Agent darf nur den Posteingangsordner lesen, und nichts, was er entwirft, wird ohne die Freigabe einer Person versendet.
Nehmen wir nun an, jemand in der Agentur tauscht eine veränderte Kopie des Modells ein, die freier antwortet. Die eingebauten Ablehnungen sind weg, doch der Agent liest weiterhin nur den Posteingangsordner, und jeder ausgehende Entwurf wartet weiterhin auf eine Person.
In diesem erfundenen Aufbau gelten die beiden Grenzen weiter, auch wenn keine Quelle prüft, ob sie halten. Rutscht ein Entwurf bei einer Person durch, die in Eile freigibt, wäre das dennoch ein Weg, auf dem Informationen das Haus verlassen.
CSA empfiehlt für Unternehmen mit Werkzeugzugriff dieselbe Richtung: den Zugriff zu prüfen «in der Annahme, dass auf Ablehnung beruhende Schutzmechanismen gegen gezielt feindliche Prompts nicht standhalten», also gegen Prompts, die geschrieben sind, um das Modell auszutricksen. Den Freigabeschritt beschreibe ich in Human-in-the-Loop-KI-Verifikation und den Aufbau, den ich für Agenten nutze, in KI-Marketing-Agenten.
Ich würde nichts davon als Argument gegen Open-Weight-Modelle lesen. AISI selbst nennt Vorteile, die für ein Unternehmen wichtig sind, das Kundendaten im Haus behält, und was der Betrieb kostet, ist das Thema von LLM selbst hosten: die Kosten. Die Konsequenz, die ich ziehe, ist enger: Ich wähle das Modell nach Qualität und Preis und baue die Sicherheitskontrollen selbst darum herum.
Was nicht bekannt ist
Die Quellen lassen diese Fragen offen:
- Replikation. CSA sagt, CAISI und AISI hätten die Zahlen von Anthropic nicht repliziert. Die veröffentlichten Tests von AISI betrafen GLM-5.2 und DeepSeek V4-Pro, und jede Zelle der Angriffssimulation von Anthropic beruht auf 50 Stichproben.
- Was die Simulation zeigt. Weil sie keinen Code ausführt, zeigt sie laut The Decoder, was das Modell versucht, und kann nicht zeigen, ob ein Angriff gelungen wäre.
- Grösse und Methode. Die Arbeit von 2024 testete Modelle mit bis zu 72 Milliarden Parametern, während die Hugging-Face-Seite zu GLM-5.3 753 Milliarden nennt. Anthropic hat GLM-5.3 selbst abliteriert und verweist für die Technik auf die Arbeit, aber ich kann nicht prüfen, wie genau beide Methoden übereinstimmen.
- Einsatz in der Praxis. Ich habe keine Zahlen dazu gefunden, wie oft abliterierte Modelle eingesetzt werden oder welcher Schaden daraus folgte.
- Das Recht. Ob das Verändern, Weitergeben oder Nutzen solcher Kopien zulässig ist, ist eine Frage für eine Rechtsberatung, und ich gebe hier keine Rechtsberatung.
Eine Checkliste, bevor Sie ein offenes Modell nutzen oder kaufen
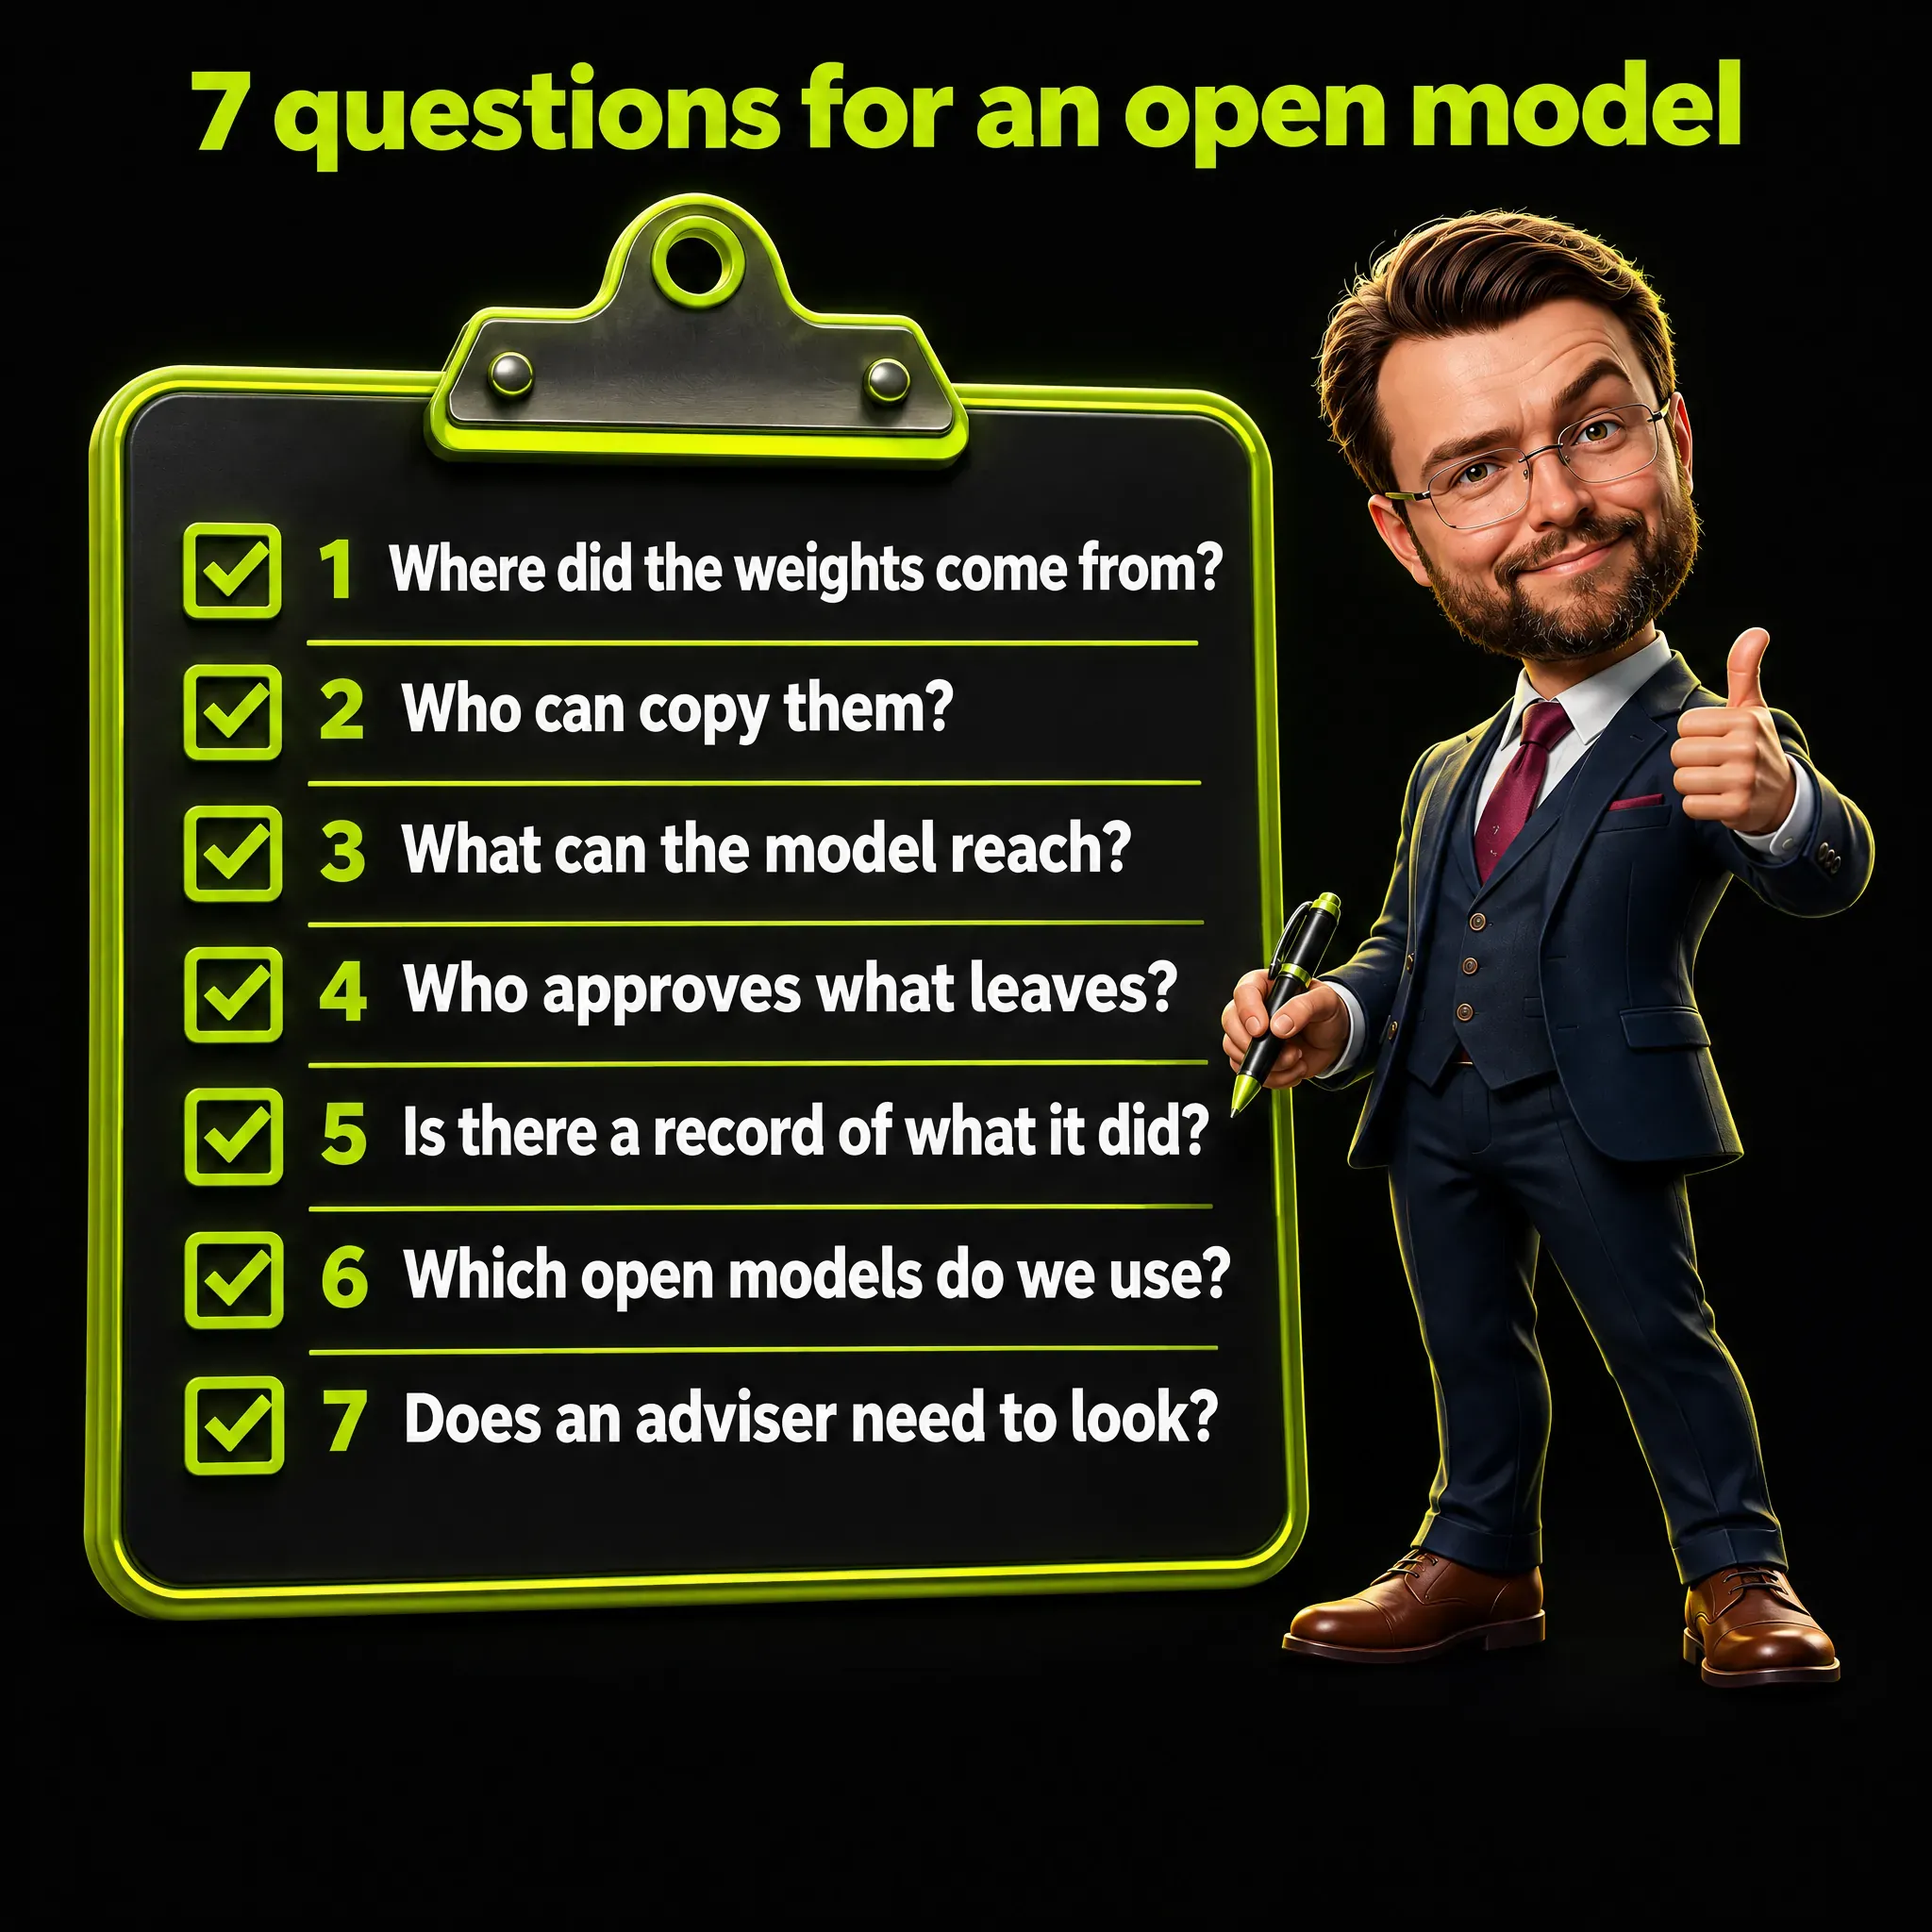
Diese Tabelle macht aus den Quellen Fragen, die eine Führungskraft ohne technischen Hintergrund einem Anbieter oder einem IT-Team stellen kann:
| Frage | Warum sie zählt | Was ich verlangen würde |
|---|---|---|
| Woher stammen die Gewichte? | Anthropic sagt, mehrere Entwickler hätten abliterierte Versionen von GLM-5.3 veröffentlicht | Die Seite des Herstellers als Quelle, schriftlich festgehalten |
| Wer kann bei uns die Gewichte kopieren? | CSA: Modellgewichte als sensible Vermögenswerte behandeln | Eine namentlich benannte verantwortliche Person und eine kurze Liste der Personen mit Zugriff |
| Worauf kann das Modell zugreifen? | CSA: davon ausgehen, dass auf Ablehnung beruhende Schutzmechanismen nicht halten | Eine Liste der Konten, Ordner und Werkzeuge, die das Modell nutzen kann |
| Wer gibt Handlungen frei, die das Unternehmen verlassen? | CSA: Die Schutzmechanismen eines Anbieters sollten nicht die primäre Kontrolle sein | Eine Person, die alles freigibt, was nach aussen geht |
| Gibt es ein Protokoll dessen, was das Modell getan hat? | AISI: Überwachung auf Anbieterseite lässt sich bei öffentlichen Gewichten nicht allgemein durchsetzen | Protokolle, die jemand liest |
| Welche Open-Weight-Modelle nutzen wir schon? | CSA: inventarisieren | Eine Liste mit Verantwortlichen, Zweck und Quelle jedes Modells |
| Muss eine Fachberatung einen Blick darauf werfen? | Lizenz und personenbezogene Daten sind Rechtsfragen | Eine kurze Notiz der Rechts- oder Datenschutzberatung |
Häufige Fragen
Was ist Abliteration?
Abliteration ist eine Technik, die die Ablehnungen eines Modells entfernt, indem die veröffentlichten Gewichte verändert werden, wie in der Einleitung dieses Artikels beschrieben. Anthropic verwendet das Wort für «eine gängige Technik zur Verringerung von Ablehnungen» und verweist auf die Arbeit von Arditi und seinen Mitautoren von 2024.
Was ist ein abliteriertes Modell?
Es ist die Kopie eines Open-Weight-Modells, deren Ablehnungsverhalten herausgeschnitten wurde. Anthropic hat eine von GLM-5.3 angefertigt, um sie zu testen, und sagt, andere seien von Entwicklern «innerhalb weniger Tage nach der Veröffentlichung des Modells» veröffentlicht worden.
Wie funktioniert Abliteration?
Die Arbeit von 2024, auf die Anthropic verweist, fand bei den 13 getesteten offenen Chat-Modellen heraus, dass die Ablehnung durch eine einzige Richtung im Inneren des Modells vermittelt wird. Wird diese Richtung entfernt, hören die Ablehnungen auf, während die übrigen Fähigkeiten weitgehend unverändert bleiben.
Ist Abliteration dasselbe wie Jailbreaking?
Ein Jailbreak im üblichen Sinn ist ein Prompt, der ein Modell dazu bringt, doch zu gehorchen, und er wirkt von aussen. Abliteration verändert die Dateien des Modells, wofür eine Kopie der Gewichte nötig ist. Die Arbeit von 2024 nennt ihre Methode einen «White-Box-Jailbreak», die beiden Begriffe überschneiden sich also.
Kann man Claude abliterieren?
Anthropic sagt, Claude lasse sich so nicht verändern, weil die Gewichte nicht an Nutzer herausgegeben werden. Nach derselben Logik lässt sich ein Modell mit unveröffentlichten Gewichten so nicht bearbeiten, es sei denn, die Gewichte gelangen nach aussen; das ist mein Schluss. CSA nennt das Exfiltrieren der Gewichte (das unerlaubte Herauskopieren) als Risiko für die eigenen Kopien von Unternehmen, und einen Test anderer geschlossener Modelle habe ich nicht gefunden.
Macht Abliteration ein Modell weniger leistungsfähig?
Anthropic berichtet dasselbe Ergebnis bei GPQA-Diamond und einige Prozent weniger bei einer Teilmenge von CyberGym. Die Arbeit von 2024 berichtet minimale Auswirkungen auf andere Fähigkeiten.
Was kostet Abliteration?
Anthropic berichtet von rund 2.200 GPU-Stunden und etwa 4.400 USD für den ersten Versuch an GLM-5.3 und schätzt für ein erfahrenes Team etwa 1.200 USD. CSA und The Decoder geben diese Zahlen wieder, und kein unabhängiger Test hat sie bestätigt.
Sollte ein Unternehmen Open-Weight-Modelle meiden?
Auf Grundlage dieser Quellen würde ich das nicht tun, denn AISI nennt echte Vorteile wie das private Hosting und eine Grundlage, die der Anbieter nicht zurückziehen kann. Die Quellen legen nahe, die Gewichte als Vermögenswert zu behandeln und die Sicherheitskontrollen um das Modell herum aufzubauen.
Mein Fazit
Der Kern der Geschichte um die Abliteration ist ein Prinzip: Sind die Dateien öffentlich, sind die Ablehnungen des Herstellers eine Voreinstellung, die andere ändern können. Eine Arbeit von 2024 hat es an anderen, kleineren Modellen getestet, und AISI und CAISI formulieren es in allgemeiner Form.
Das Ausmass der Wirkung bei GLM-5.3 beruht auf einem einzigen Bericht von Anthropic. CSA und The Decoder geben ihn wieder, und kein unabhängiger Test hat ihn bestätigt, deshalb lese ich die Zahlen bis zu einer Replikation durch CAISI oder AISI als Messung eines einzelnen Unternehmens.
Für meine eigene Arbeit ändert das die Reihenfolge meiner Fragen. Früher habe ich gefragt, ob ein Modell schädliche Anfragen ablehnt, heute frage ich, worauf das Modell zugreifen kann und wer freigibt, was es tut, denn diese Antworten gelten unabhängig von der Ablehnungsrate.


