LLM selbst hosten: Was Revoluts Einsparung von 90 % auslässt
LLM selbst hosten: Revolut meldet für KI-Coding ein Zehntel der früheren Rechnung. Was die Zahl umfasst, was sie auslässt und was Sie vorher fragen sollten.
LLM selbst hosten heisst, ein grosses Sprachmodell (Large Language Model, LLM) auf Rechnern zu betreiben, die man besitzt oder mietet, statt Anfragen an den gehosteten Dienst eines Anbieters zu senden; die Kosten verlagern sich von einer Gebühr pro Token, einer kleinen Texteinheit, auf Maschinen und die Menschen, die sie betreiben.
Anfang November 2026 meldeten Schlagzeilen, Revolut, eine Digitalbank in Europa, habe seine Kosten für KI-Coding um 90 Prozent gesenkt, also auf ein Zehntel, indem sie die GLM-Modelle von Z.ai auf dedizierten GPUs betreibe. Eine GPU ist der Chip, auf dem KI-Modelle laufen, und das Ausführen eines Modells, damit es Anfragen beantwortet, heisst Inferenz. Die Zahlen stammen aus einem Vortrag von David Abitbol, Ops- und Infrastrukturleiter bei Revolut, auf der Konferenz AI Engineer in New York.
Ich arbeite im Marketing und nutze jeden Arbeitstag KI-Modelle, meist lokale, die ich für meine eigenen Bedürfnisse trainiert habe. Ich lese das also als Anwender von KI-Werkzeugen und beanspruche keine Ingenieurskompetenz. Bevor eine solche Zahl in einer Budgetsitzung landet, will ich wissen, was in ihr steckt.
Dieser Artikel nimmt die Behauptung auseinander und endet mit Fragen, die man stellen sollte, bevor jemand ein Modell selbst hostet.
Es geht um Kosten und Kontrolle, nicht um Rechtsberatung, und die Geopolitik bleibt aussen vor. Die Preislisten und die drei Wege, ein GLM-Modell zu betreiben, stehen in meinem Artikel über chinesische KI-Modelle für Unternehmen.
Das Wichtigste vorab
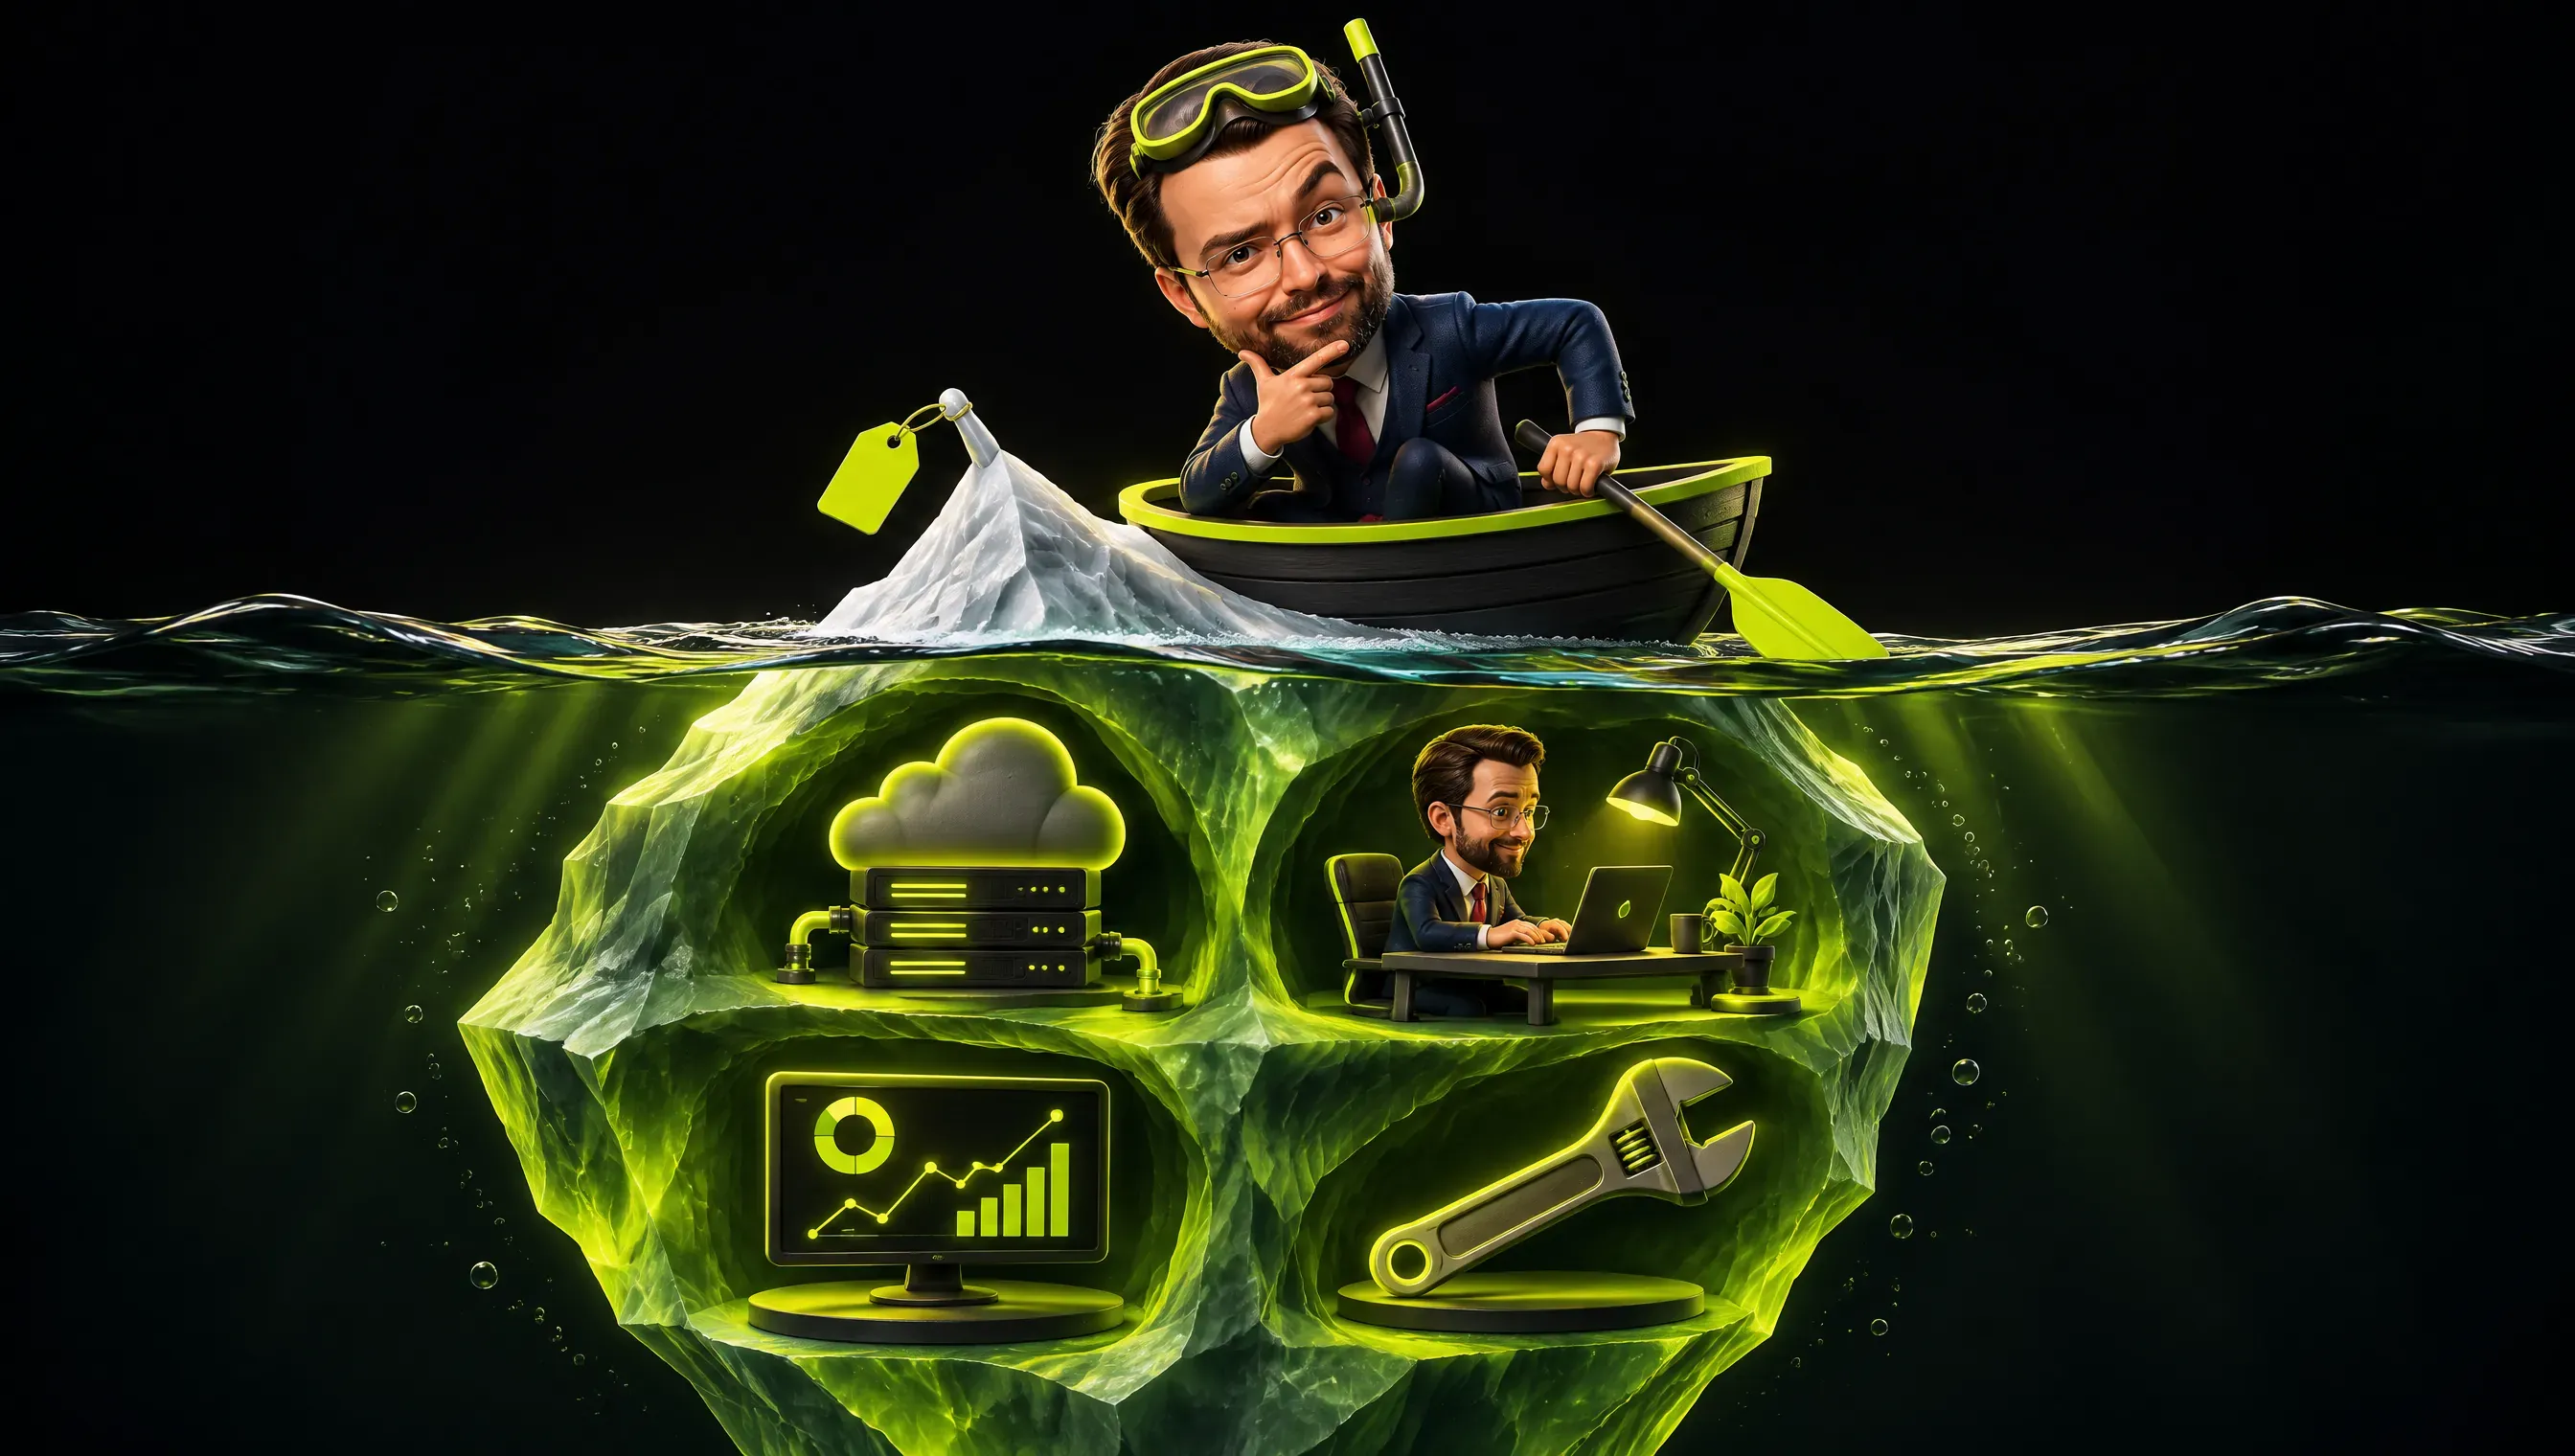
- Keine Quelle nennt einen Preis fürs Selbst-Hosting, den man übernehmen könnte. Der am besten belegte Fall ist der von Revolut, und die Konferenzseite hält fest, seine Zahlen «beschreiben den Einsatz und die Auslastung bei Revolut, nicht einen übertragbaren Preis für ein selbst gehostetes Modell».
- Die 90 % vergleichen zwei Rechnungen für die Arbeitslast eines einzelnen Unternehmens. Revolut sagt, seine Ausgaben lägen bei rund einem Zehntel der früheren Rechnung von Anthropic und OpenAI, und das ist eine engere Aussage als ein Rückgang von 90 % bei allem, was KI das Unternehmen kostet.
- Die Kosten rund um die GPUs fehlen in der Schlagzeile. Red Hot Cyber schreibt, die Einsparung schliesse Cloud-, Personal- und Monitoringkosten aus. Ich fand dazu keine Zahl und auch keinen Hinweis auf diesen Ausschluss, weder im Vortrag noch bei The Register.
- Nach meiner Lesart hängt der Preis pro Token davon ab, wie ausgelastet die Maschinen sind. Auf denselben 56 GPUs meldet Revolut nach dem Tuning 76 % mehr verarbeitete Anfragen pro Sekunde und eine um 88 % kürzere Wartezeit auf das erste Wort einer Antwort.
- Selbst-Hosting bringt Kontrollen mit, die jemand betreiben muss. Revolut koppelt die günstigere Inferenz an eine Sandbox, Freigaberegeln und detaillierte Protokolle, und laut Konferenzseite bleibt die Bank beim Selbst-Hosting für die tieferen Inferenzkosten, die Sandbox-Regeln und die Telemetrie gleichermassen verantwortlich.
- Für ein Marketingteam würde ich vorschlagen, mit einem gehosteten Modell zu beginnen. Keine Quelle testet das, und die Fragen am Ende dieses Artikels sind mein Weg, es zu prüfen.
Was Revolut gemeldet hat und wer was sagt
Alles Folgende geht auf drei Arten von Quellen zurück. Die erste ist der Vortrag selbst, den ich über die schriftliche Zusammenfassung der Konferenz AI Engineer lese, unten Konferenzseite genannt, und über sein Transkript. Die zweite ist der Journalismus, der ihn weitererzählt hat, vor allem The Register und Red Hot Cyber.
Die dritte ist meine eigene Rechnung mit ihren Zahlen. Ich halte die drei auseinander, weil jede Nacherzählung die Aussage ein wenig verändert hat und der Vortrag ein Unternehmen ist, das sein eigenes Setup beschreibt.
Zuerst vier Begriffe, weil die Tabelle sie verwendet:
- Token: die kleine Texteinheit, die ein Modell liest und schreibt, oft ein kurzes Wort oder ein Stück eines längeren.
- Mischkosten (Blended Cost): ein einziger Durchschnittspreis über alles, was hineingeht und herauskommt.
- Erstes Token: das erste Stück einer Antwort, das auf dem Bildschirm erscheint.
- Coding-Zeit und Lead Time: die Stunden, die ein Entwickler mit dem Schreiben von Code verbringt, und die Tage von der Übernahme eines Features bis zur Auslieferungsbereitschaft.
| Posten | Zahl | Quelle |
|---|---|---|
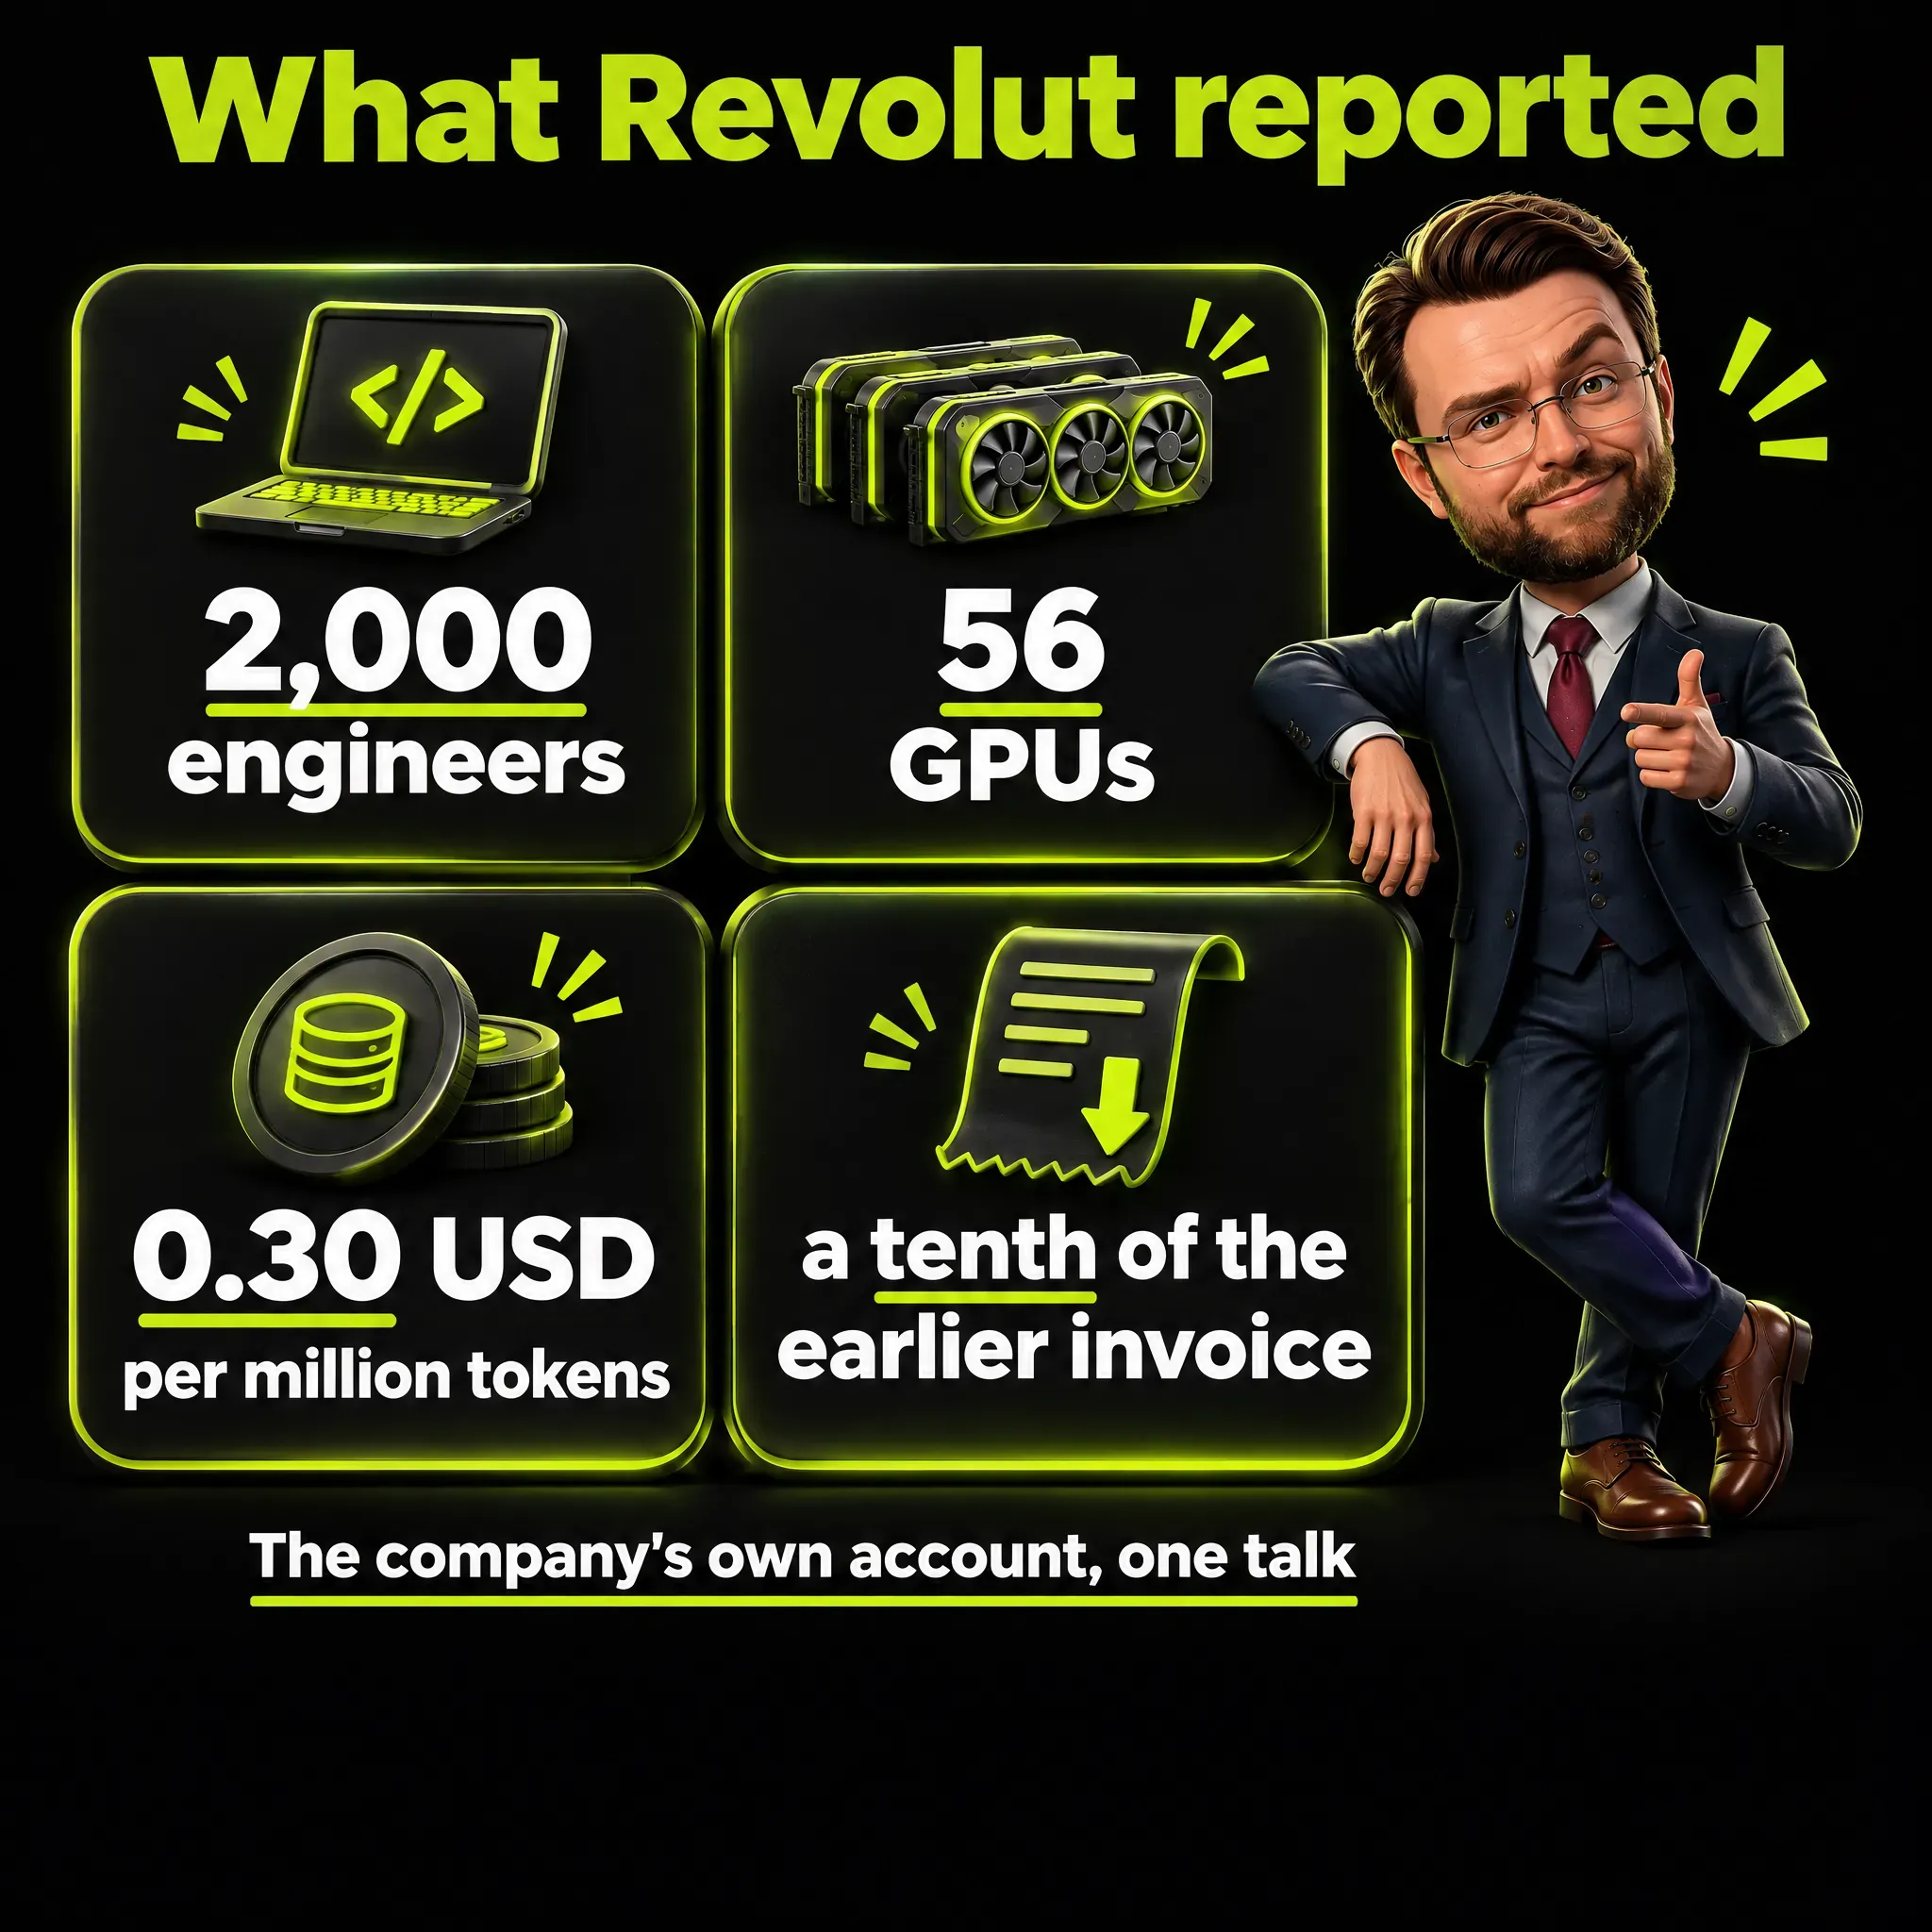
| Nutzer | Rund 2.000 Entwicklerinnen und Entwickler | Der Vortrag |
| Hardware | 56 Nvidia-B200-GPUs betreiben GLM-5.3 | Der Vortrag, The Register |
| Kosten pro Token | Mischkosten von rund 0,30 USD pro Million Tokens | Der Vortrag (Konferenzseite) |
| Ausgaben | Rund ein Zehntel der früheren Rechnung von Anthropic und OpenAI | Der Vortrag (Konferenzseite) |
| Wirkung auf die Arbeit | Rund 60 % bessere Coding-Zeit, 70 % bessere Lead Time | Der Vortrag, mit Vorbehalt |
| Wartezeit auf eine Antwort | Erstes Token nach 14,26 Sekunden, dann nach 1,68 Sekunden, auf denselben GPUs | Folie, beschrieben auf der Konferenzseite |
| Ziele | Erstes Token unter 3 Sekunden, rund 200 Tokens pro Sekunde | Der Vortrag |
Die Verbesserungen von 60 % und 70 % brauchen einen Vorbehalt, den die Konferenzseite selbst nennt: «Der interne Vergleich trennt den Modellwechsel nicht von anderen Ursachen». Die Grafik zeigt also, was in den Monaten der Einführung bei Revolut geschah, und nicht, was das Modell allein bewirkte. Red Hot Cyber nennt einen der anderen Faktoren: die Aufhebung der Token-Limits.
Der Vortrag nennt die 0,30 US-Dollar pro Million Tokens für «GLM», ohne eine Version zu nennen, während The Register sie an das frühere Setup mit GLM-5.1 knüpft; ich würde die Zahl deshalb nicht an ein einzelnes Modell binden. Revolut hat laut Abitbol 80 Millionen Kunden, aber diese Arbeitslast betrifft rund 2.000 Entwicklerinnen und Entwickler.
Drei Aussagen, eine Zahl
Dieselbe Rechnung hat drei verschiedene Sätze hervorgebracht, und sie sind nicht gleich sicher weiterzugeben. Zehnmal günstiger und 90 Prozent weniger sind dasselbe Verhältnis; sie unterscheiden sich darin, was das Verhältnis angeblich abdeckt.
Die erste Aussage stammt von Abitbol selbst, wie die Konferenzseite sie zusammenfasst: Revoluts Ausgaben liegen bei rund einem Zehntel der früheren Rechnung von Anthropic und OpenAI. Verglichen wird, was ein Unternehmen bisher an Anbieter zahlte, mit dem, was es heute für eine Art von Arbeit zahlt: Coding durch rund 2.000 Entwicklerinnen und Entwickler.
Abitbol sagt auch, bei der ersten Einführung von Claude Code hätten einige Entwicklerinnen und Entwickler «tausend im Monat, 10.000 im Monat, bei nicht allzu viel ROI» ausgegeben, laut dem gedruckten Zitat von The Register in Dollar, weshalb das Unternehmen es «mit strikten Budgetgrenzen» eingeführt habe. Die frühere Rechnung deckt daher rationierte Nutzung ab, die heutige eine Nutzung, die man ohne Blick auf den Zähler machen kann, und das ist ein Vergleich zweier Arbeitsweisen.
Die zweite Aussage ist die Schlagzeile von The Register, laut der Revolut die Kosten für KI-Coding um den Faktor 10 gedrückt hat, «indem es Claude gestrichen hat und auf Selbst-Hosting umgestiegen ist». Der Text ist an einigen Stellen vorsichtiger: Er sagt, GLM habe «GPT oder Claude nicht vollständig ersetzt», und zitiert Abitbol mit den Worten «die Frontier ist die Ausnahme». Frontier bedeutet hier die leistungsfähigsten Modelle der grossen Anbieter, und die Konferenzseite bestätigt, dass solche Dienste für Ausnahmen verfügbar bleiben.
Der Text gibt das Verhältnis auch anders wieder als der Vortrag. Er sagt, bei 0,30 USD pro Million Input- und Output-Tokens habe das Selbst-Hosting von GLM-5.1 rund ein Zehntel dessen gekostet, was Codex oder Claude Code kosten, die Coding-Agenten von OpenAI und Anthropic. Nach meiner Lesart stellt das Kosten pro Token einem Produkt gegenüber, was etwas anderes ist als der Vergleich zweier Rechnungen.
Die dritte Aussage stammt von Red Hot Cyber, das seinen Beitrag mit den 90 % betitelt und sie dann einschränkt. Es schreibt: «Die Einsparung von 90 % schliesst Cloud-, Personal- und Monitoringkosten aus und hängt von sorgfältiger Optimierung ab». Kleinere Unternehmen, «denen Revoluts Grösse und Infrastrukturteam fehlen», erreichten womöglich nicht dasselbe Ergebnis.
Woher die Zahl stammt: aus Revoluts Vergleich der früheren Rechnung mit den heutigen Ausgaben, vorgestellt im Vortrag. Was sie bedeutet: Für diese Arbeitslast, bei diesem Volumen und mit diesem Tuning beträgt die Rechnung für KI-Coding rund ein Zehntel von früher. Was sich ändert: Die Zahl sagt, um wie viel kleiner eine Rechnung wurde, und nicht, um wie viel kleiner die Gesamtkosten des Betriebs wurden.
Eine Aufschlüsselung der Kosten für Cloud, Personal oder Monitoring fand ich weder auf der Konferenzseite noch im Transkript noch bei The Register. Auch Red Hot Cyber nennt den Ausschluss ohne Zahlen, und die Wortwahl des Vortrags selbst, «unsere Rechnung» und «dort bekommt man seine GPUs», lässt offen, ob das Zehntel bereits eine Rechnung für gemietete GPUs enthält. Ich behandle den Ausschluss als Behauptung von Red Hot Cyber und als Grenze der Zahl.
Warum sich ein Token-Preis ohne die Mischung nicht vergleichen lässt
Die Listenpreise von Z.ai zeigen, warum eine Mischzahl ihre Zusammensetzung braucht. In Dollar pro Million Tokens kostet der Input bei GLM-5.3 1,40, der zwischengespeicherte Input 0,26 und der Output 4,40. Zwischengespeicherter Input ist Text, den das System bereits verarbeitet hat und zu einem tieferen Satz berechnet.
Coding-Agenten senden bei jedem Schritt grosse Teile desselben Textes erneut, weshalb zwischengespeicherter Input ihren Datenverkehr dominiert. Die Seite zum Coding Plan von Z.ai, dem Abonnement für Coding-Werkzeuge, geht von einer Cache-Trefferquote von 95 % aus, das heisst, 95 von 100 Input-Tokens sind bereits verarbeiteter Text. Rechnet man mit diesen beiden Quellen, kommt 0,95 x 0,26 + 0,05 x 1,40 auf rund 0,32 USD pro Million Input-Tokens zum Listenpreis.
Das liegt nahe an Revoluts Mischkosten von 0,30, und ich ziehe daraus keinen Schluss. Die Quellen nennen Revoluts Mischung aus Input, zwischengespeichertem Input und Output nicht, und Output-Tokens kosten auf der Liste von Z.ai 4,40. Abitbol rät seinem Publikum immerhin zu prüfen, dass der Cache-Treffer bei einer Coding-Arbeitslast «über 90 % liegen muss», und eine Mischzahl von 0,30 kann aus vielen verschiedenen Mischungen entstehen.
Wenn jemand Kosten pro Million Tokens für ein gehostetes Setup nennt, würde ich drei Dinge fragen: ob sie Input, Output oder beides umfassen, welcher Anteil des Inputs aus dem Cache kam und ob sie nur die GPUs zählen. Ohne diese Antworten lässt sich die Zahl nicht mit der Preisliste eines Anbieters vergleichen, und deshalb lese ich Revoluts Vergleich als einen zwischen zwei Rechnungen.
Die vollständige Preisliste steht in meinem Leitfaden zu chinesischen KI-Modellen für Unternehmen. Wo die Modellkosten neben den anderen Werkzeugen eines Teams stehen, ordne ich mit dem Raster in meinem Marketing Tech Stack 2026 ein.
Warum der Preis pro Token davon abhängt, wie ausgelastet die Maschinen sind
Abitbols Vortrag handelt vom «Selbst-Hosting eines Open-Source-Modells auf dedizierten GPUs», also von Maschinen, die für Revoluts eigenen Gebrauch reserviert sind. Wie ich es lese, kosten reservierte Maschinen gleich viel, ob sie eine Anfrage beantworten oder tausend. Der Preis pro Token ist damit die feste Rechnung geteilt durch die Zahl der Tokens, welche die Maschinen verarbeiten.
Ein erfundenes Beispiel mit runden Zahlen, nicht von Revolut: Angenommen, die Maschinen kosten 100 Einheiten im Monat. Verarbeiten sie 100 Millionen Tokens, kostet jede Million 1 Einheit. Erlaubt das Tuning denselben Maschinen, 500 Millionen zu verarbeiten, kostet jede Million 0,2 Einheiten, und die Rechnung hat sich nicht verändert.
Revolut formuliert seine Einsparung nicht so, doch seine Tuning-Grafik passt zu diesem Mechanismus. Abitbol warnt, dass es ohne dieses Tuning eine «schreckliche Leistung» gebe, wenn man die Gewichte auf GPUs lädt und die Inferenz startet, den Schritt, in dem das Modell Anfragen beantwortet. Das Team hat sein System für die Bereitstellung auf die tatsächliche Nachfrage abgestimmt, und seine Grafik hält die Zahl der GPUs von April bis August konstant.
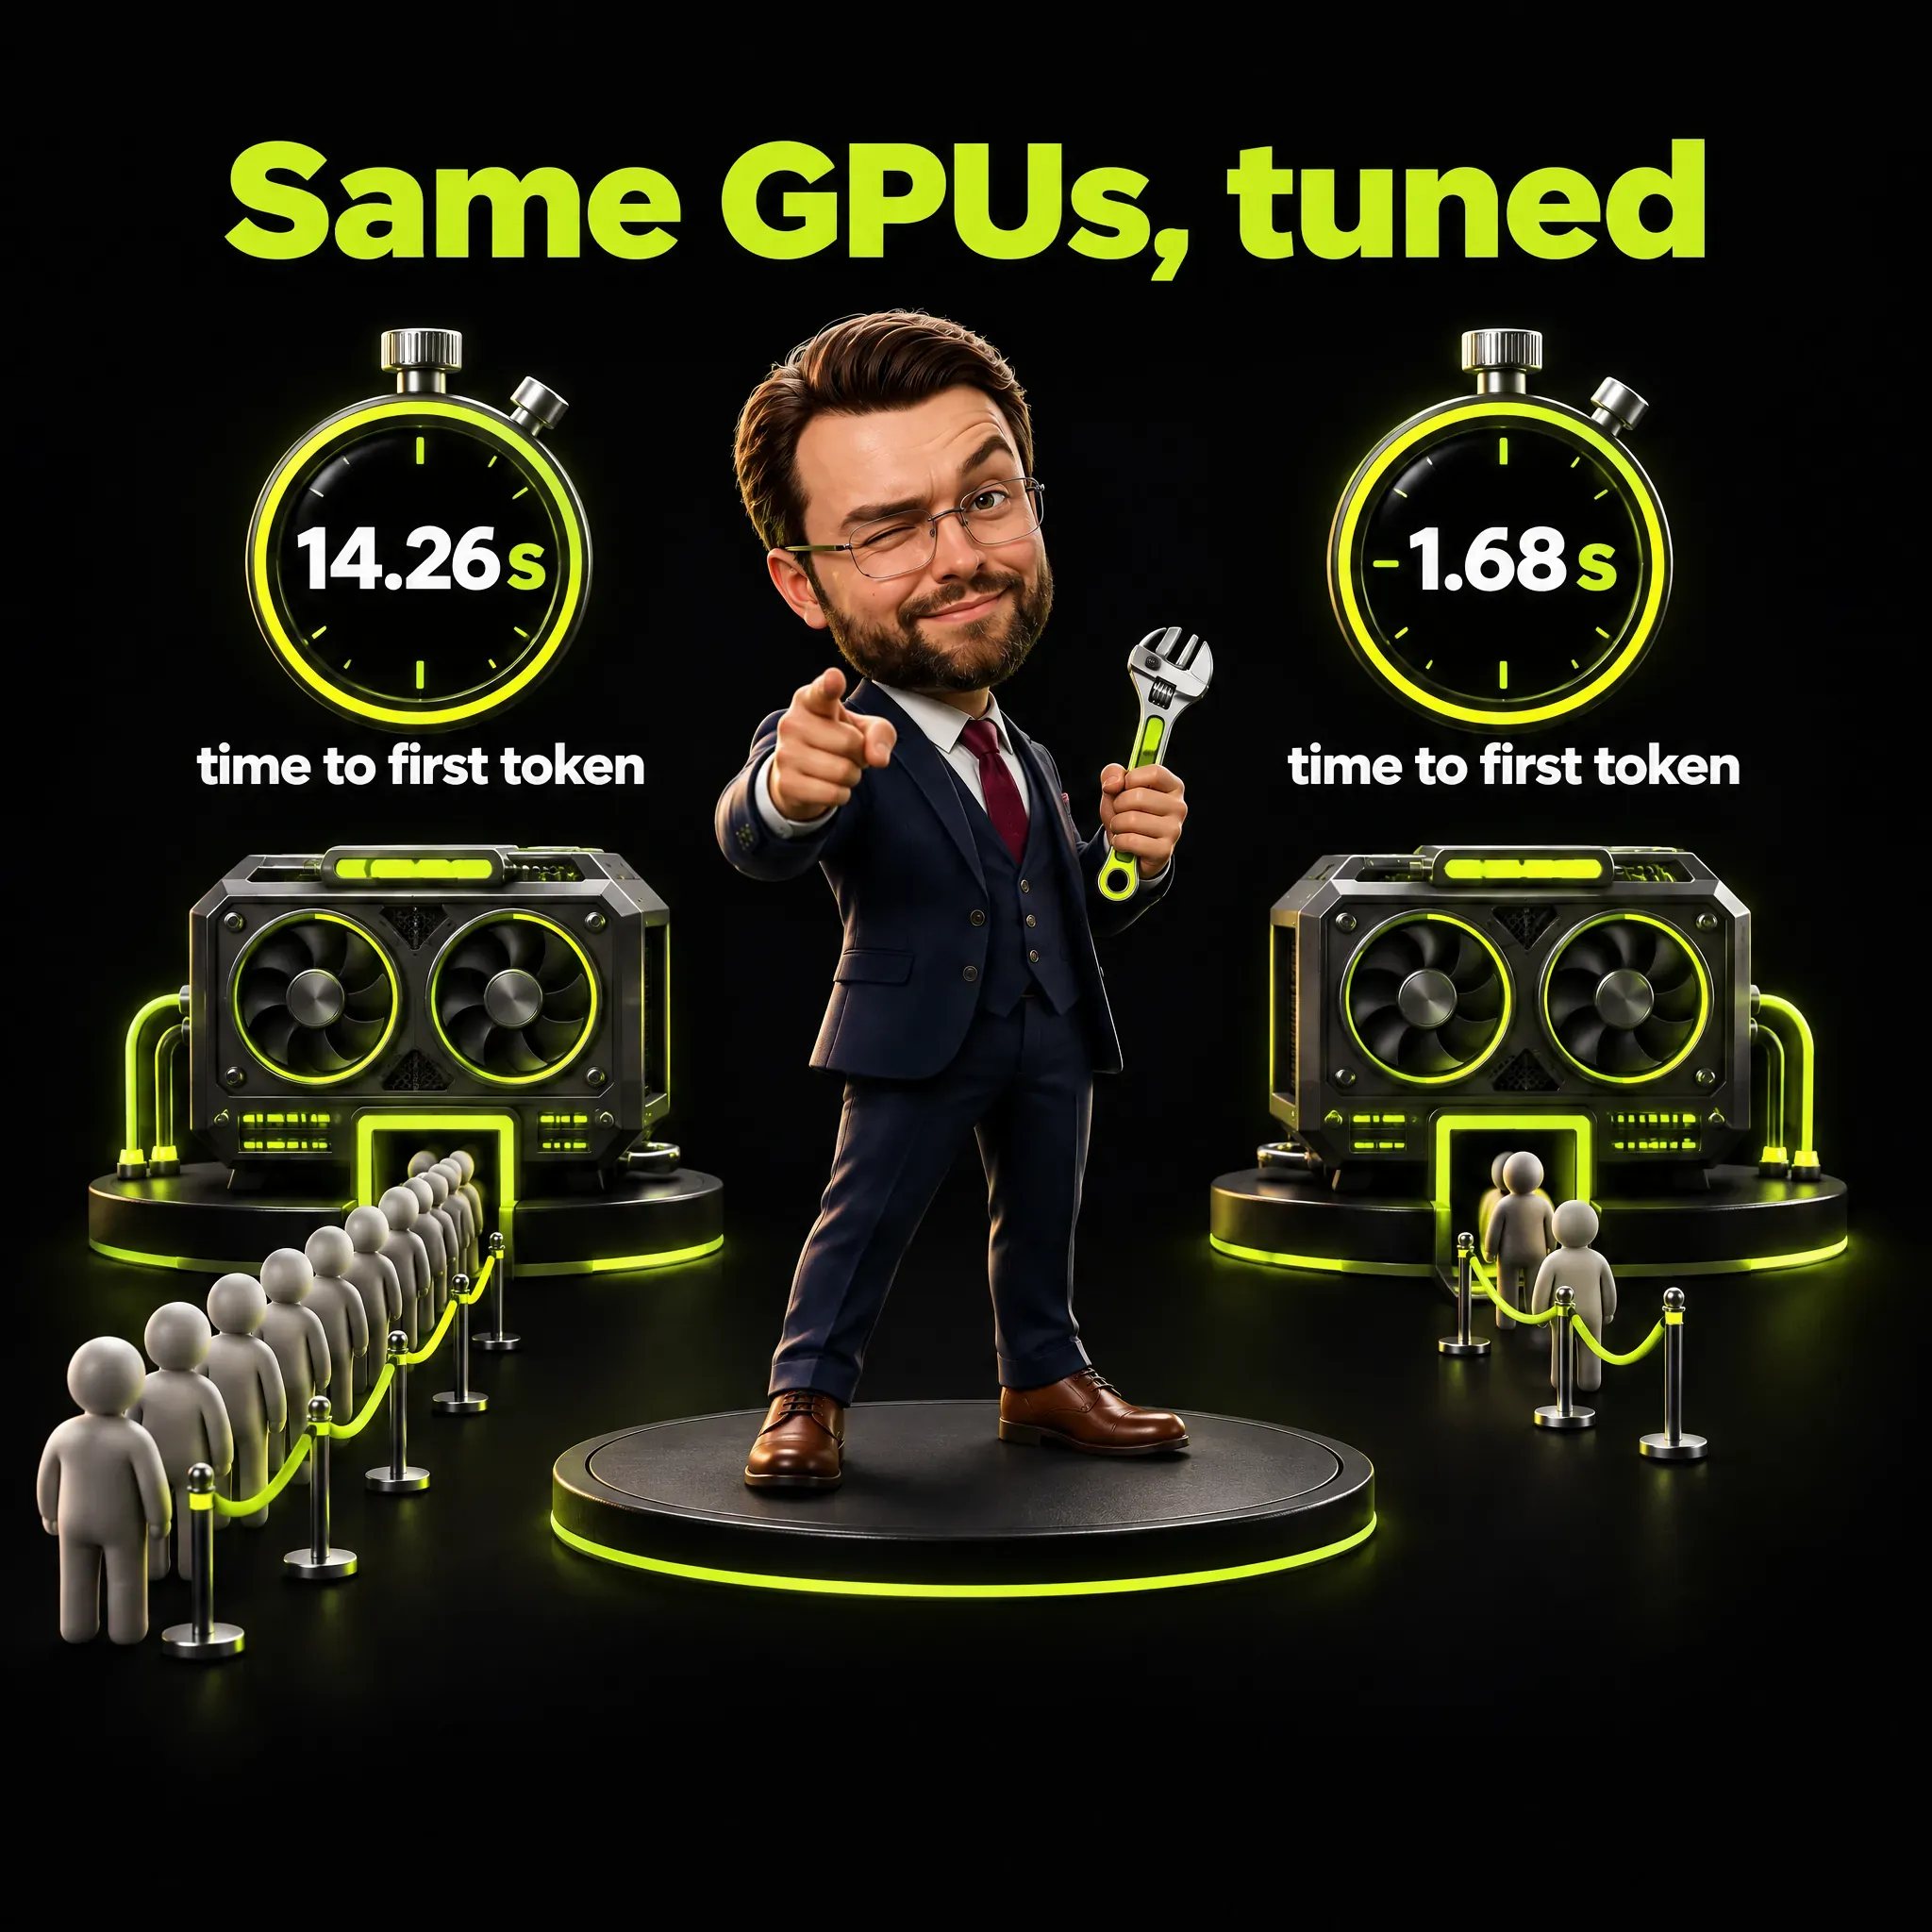
Die Folie meldet, wie die Konferenzseite sie beschreibt, 76 % mehr Anfragen pro Sekunde und eine um 88 % kürzere Zeit bis zum ersten Token, von 14,26 Sekunden während der Migration auf 1,68 Sekunden im stabilen Setup. Die Zeit bis zum ersten Token ist die Wartezeit zwischen dem Senden einer Anfrage und dem ersten Wort der Antwort. Nach meiner Rechnung wurde die Wartezeit etwa 8,5-mal kürzer.
Abitbols Ziele sind konkret. Er strebt «eine Zeit bis zum ersten Token unter 3 Sekunden» an und sagt: «Sobald man 5 Sekunden überschreitet, läuft mein Slack-Postfach über». Sein Rat lautet, dem Ausbau zu «widerstehen», das heisst, die vorhandenen GPUs zu tunen, bevor man weitere kauft.
Abitbol sagt, wer sich nach 17 Uhr verbinde, könne 800 Tokens pro Sekunde erhalten, gegenüber den 200, die laut Konferenzseite für interaktive Arbeit genügen. Ich lese das so, dass die Nachfrage am Abend tiefer ist, die gleichen Maschinen also schneller antworten, und dass die ungenutzte Kapazität am Abend ohnehin bezahlt ist. Bei einem Team mit einer Handvoll Nutzer verteilt sich dieselbe feste Rechnung auf weit weniger Tokens.
LLM selbst hosten: Was es dafür braucht, in einfachen Worten
Ein Modell der GLM-Klasse braucht Rechenzentrums-Hardware. The Register berichtet, GLM-5.1 habe rund 754 Milliarden Parameter, von denen 40 Milliarden für jedes erzeugte Token aktiviert werden, und brauche etwa 380 GB GPU-Speicher, um seine Gewichte zu halten. Parameter sind die Zahlen, die ein Modell im Training gelernt hat, und Gewichte sind die Dateien, in denen sie gespeichert sind.
Die offene Unterhaltung jedes Nutzers belegt zusätzlich Speicher. The Register beziffert ihn je nach Präzision auf weitere 6 bis 26 GB pro Nutzer. Die Seite zu GLM-5.3 auf Hugging Face, der öffentlichen Bibliothek, in der solche Modelle veröffentlicht werden, nennt 753 Milliarden Parameter, und diese Zahl verwende ich für das aktuelle Modell.
Das sind die Entscheidungen, die der Vortrag und The Register beschreiben, in einer Reihenfolge, der auch Nicht-Ingenieure folgen können:
- Kontextgrösse. Das Kontextfenster ist die Textmenge, die das Modell gleichzeitig im Blick hat, und es konkurriert mit den Anfragen anderer Nutzer um GPU-Speicher. Abitbol sagt «langer Kontext ist ein Schwindel»: Das Modell kann eine Million Tokens bedienen, aber 256.000 sind das, was seine Entwicklerinnen und Entwickler brauchen.
- Die Gewichte kompakter speichern. Quantisierung heisst, die Zahlen mit weniger Stellen zu speichern, um Speicher zu sparen, und Revolut bevorzugt auf seinen B200-GPUs, einem aktuellen Nvidia-Chip für Rechenzentren, ein 4-Bit-Format.
- Das Modell auf mehrere GPUs verteilen. Die Konferenzseite hält fest, dass bei einer Verteilung der Gewichte auf vier GPUs zu wenig Speicher für den Cache des bereits verarbeiteten Textes bleiben kann, sodass eine Aufteilung auf acht besser abschneiden kann.
- Manche Aufgaben anderswohin schicken. Das GLM-Modell, das Revolut fürs Coding betreibt, verarbeitet nur Text, daher nutzt Revolut einen Router, der Bildanfragen an Gemini oder GPT Luna leitet, während die Codeerzeugung auf GLM bleibt.
Ein Preis pro Token verbirgt diese Entscheidungen über Speicher, Geschwindigkeit und Weiterleitung. Zu den Kosten eines selbst gehosteten Modells gehört das Können, sie zu treffen, und Revolut zahlte weiter Anbietern für die Aufgaben, die das Modell nicht erledigen kann.
Die Kosten, die niemand veröffentlicht hat
Hier steht jede Kostenzeile, die ich ausgefüllt sehen möchte, bevor ich ein selbst gehostetes Setup mit dem Preis eines Anbieters vergleiche. «Nicht verfügbar» heisst, dass ich in keiner gelesenen Quelle eine Zahl fand, und ich habe die Lücke nicht mit einer Schätzung gefüllt.
| Kostenzeile | Was die Quellen sagen | Zahl |
|---|---|---|
| Die GPUs, gekauft oder gemietet | 56 B200-GPUs betreiben GLM-5.3 | Nicht verfügbar |
| Cloud | Red Hot Cyber sagt, die 90 % schliessen Cloudkosten aus | Nicht verfügbar |
| Die Menschen, die es betreiben | Red Hot Cyber sagt, die 90 % schliessen Personal aus; kleineren Firmen fehlt womöglich ein Infrastrukturteam | Nicht verfügbar |
| Monitoring und Protokolle | Red Hot Cyber sagt, die 90 % schliessen Monitoring aus; Abitbol verlangt detaillierte Telemetrie, um Vorfälle zu untersuchen | Nicht verfügbar |
| Tuning-Zeit | Die Grafik reicht von April bis August auf denselben GPUs | Stunden nicht verfügbar |
| Anbieter, die für Ausnahmen bleiben | Frontier-Dienste bleiben verfügbar; Bildanfragen gehen an Gemini oder GPT Luna | Nicht verfügbar |
| Wechsel von einem Modell zum nächsten | Revolut wechselte von GLM-5.1 zu GLM-5.3 | Nicht verfügbar |
Ein Punkt bleibt offen. Red Hot Cyber beschreibt die Maschinen als Revoluts eigene Infrastruktur in den Vereinigten Staaten, während Abitbol für die Länder, die er aufzählt, sagt «dort bekommt man seine GPUs» und von GPU-Anbietern spricht, die standardmässig keine Kopie der Daten behalten, was er «Zero Data Retention» nennt. Aus den Quellen kann ich nicht erkennen, ob die GPUs gekauft oder gemietet sind, und die Antwort verändert die Form der Rechnung.
Mein Vorschlag ist, die Tabelle als Formular zu verwenden. Wenn Ihnen jemand eine Einsparung von 90 % nennt, bitten Sie ihn, jede Zeile für den eigenen Fall auszufüllen oder zu sagen, welche Zeilen die Zahl auslässt. Eine Einsparung, die diese Übung übersteht, würde ich in ein Budget aufnehmen.
Für die Kosten, die nach der Rechnung entstehen, nämlich die Zeit der Person, die das Ergebnis prüft, vergleiche ich zwei Claude-Stufen im Vergleich der Claude-Modelle fürs Marketing. Die Methode dort, 20 echte Stichproben blind laufen zu lassen, funktioniert für ein gehostetes GLM-Modell genauso.
Was günstigere Tokens an der Arbeitsweise ändern
Für mich ist der nützlichste Teil des Vortrags der über das Verhalten. Die Konferenzseite beschreibt, was unter Token-Limits geschah: Wenn Tokens knapp wirken, sparen Entwicklerinnen und Entwickler sie für eine schwierige Coding-Aufgabe auf und setzen sie nicht für die Arbeit rundherum ein. Revoluts Antwort war ein pauschaler Preis, mit dem sie mehr delegieren konnten.
Abitbols eigene Deutung ist, dass zu den Verzögerungen in der Entwicklung das Postfach, Jira und Confluence gehören, die Werkzeuge für Projektverfolgung und Dokumentation rund um den Code. Günstigerer Zugang erweiterte nach seiner Darstellung die Aufgaben, die Menschen dem Modell zu übergeben bereit waren. The Register zitiert ihn zu Debugging und Ticketarbeit: «Wenn man unbegrenzt Tokens hat, hat man die Freiheit, das zu tun».
Das macht die Zahlen von 60 % und 70 % schwer lesbar. Ein Teil der Verbesserung kann vom Modell stammen, ein Teil davon, dass Entwicklerinnen und Entwickler KI für mehr Arten von Arbeit nutzen, und die Konferenzseite sagt, der Vergleich trenne die beiden nicht. Ich würde weder dem Modell allein noch dem Selbst-Hosting allein den Verdienst zuschreiben.
Für mein eigenes Gebiet kann ich nur ein Szenario anbieten, und es ist erfunden. Stellen Sie sich ein Marketingteam vor, das einen KI-Agenten rationiert, weil jeder lange Auftrag echtes Geld kostet, und ihn deshalb für den Monatsbericht einsetzt, während es das tägliche Taggen und Kontrollieren von Hand erledigt. Wäre die Rechnung pauschal, würde dasselbe Team womöglich auch diese kleinen Aufgaben abgeben.
Keine Quelle misst das fürs Marketing. Jemand bezahlt trotzdem die Maschinen, und der Gewinn zeigt sich nur, wenn die zusätzliche Arbeit des Agenten gut genug ist, um sie zu behalten, nachdem eine Person sie geprüft hat.
Wohin die Daten gehen und was der Vortrag offenlässt
Die Konferenzseite macht einen schlichten Punkt: Die Gewichte herunterzuladen und auf einer vom Unternehmen gewählten Infrastruktur zu betreiben, ist ein anderer Datenweg, als Anfragen an den gehosteten Dienst eines Modellentwicklers zu senden. Abitbol sagt dazu, die Datenschutzsorge bei chinesischen Modellen betreffe den Aufruf eines dedizierten Endpunkts in China, während es ein anderer Fall sei, die Gewichte zu nehmen und sie «auf einem US-basierten Dienst» laufen zu lassen. The Register fasst seine Sicht so zusammen, dass Maschinen vor Ort (On-Premises), also die eigenen Server des Unternehmens, oder ein Cloud-Anbieter in derselben Region wenig Anlass zur Sorge lassen, was die Formulierung des Reporters ist und kein Zitat von Abitbol.
Er fügt hinzu, Daten in den Ländern dessen, was das Transkript als «Data Equivalency Framework» wiedergibt, nämlich den USA, der EU, dem Vereinigten Königreich und Israel, seien in Ordnung, und Inferenz- und GPU-Anbieter hätten «standardmässig Zero Data Retention». Keine Quelle, die ich gelesen habe, überprüft diese Aussage über die Anbieter. Das sind seine Aussagen über Revolut, eine Bank, und die Konferenzseite sagt, sie «sind nicht als allgemeine Feststellung zu lesen, dass ein Modell, eine Region oder eine Sandbox automatisch die Pflichten einer anderen Organisation erfüllt».
Für die API (Programmierschnittstelle) des Herstellers selbst sagt die Datenschutzerklärung von Z.ai, ihre Dienste würden in der Regel von Singapur aus erbracht, und ihre Zusatzvereinbarung zur API enthält eine Klausel zur Nichtspeicherung. Beides sind Aussagen von Z.ai selbst, und keine wurde von einer dritten Stelle überprüft. Beide Dokumente gehe ich im Datenabschnitt meines Artikels über chinesische KI-Modelle durch.
Ich bin kein Jurist, und das ist keine Rechtsberatung. Sollten Personendaten wie Kundenlisten oder Lead-Exporte an irgendein Modell gehen, würde ich zuerst der Datenschutzberatung drei Fragen stellen: in welches Land, unter welchem Vertrag und mit welcher Aufbewahrung.
Kontrollen rund um das Modell
Abitbols Schlussbotschaft handelt von der Kontrolle rund um das Modell. Revolut richtet eine Sandbox ein, einen abgegrenzten Bereich, in dem der Coding-Agent läuft, samt Freigaberegeln für Vorgänge, die das Unternehmen nicht zulassen will. Sein Beispiel lautet «grep erlauben, aber nicht gradle»: Eine Regel kann den Agenten Dateien durchsuchen lassen und ihm das Ausführen eines Build-Werkzeugs verwehren.
Er sagt, die Coding-Aufgaben würden nicht als autonome Agenten behandelt, denn «sie laufen immer mit einem Menschen in der Schleife» (Human in the Loop), und die Sandbox gebe der Aufsichtsbehörde in diesem Punkt Sicherheit. Er sagt auch, die Sandbox schütze vor Missbrauch durch Personen im Unternehmen. Die letzte Anforderung ist Telemetrie, also detaillierte Protokolle, damit das Team einen Vorfall durch das System zurückverfolgen kann.
Zur Prompt Injection, einem Angriff, bei dem in einem Dokument oder auf einer Webseite versteckter Text dem Agenten neue Befehle zu erteilen versucht, fällt Abitbols Bemerkung kurz aus: «Heute nicht mehr so sehr ein Thema, so klug die Modelle sind, aber immer ein Thema». Das ist seine Meinung in einem Vortrag, und in dieser Passage nennt er keinen Test dafür.
Die Konferenzseite nennt tiefere Inferenzkosten, Sandbox-Regeln und Telemetrie und schliesst mit: «Mit dem Selbst-Hosting bleibt Revolut für alle drei verantwortlich».
Mit offenen Gewichten, den Modelldateien, die ein Hersteller zum Herunterladen für alle veröffentlicht, kommt eine weitere Verantwortung. Die in ein solches Modell eingebauten Ablehnungen von Anfragen stecken in diesen Dateien, und der Bericht von Anthropic zu GLM-5.3 beschreibt, wie sie mit der Technik entfernt wurden, die ich in was Abliteration ist erkläre. Die Cloud Security Alliance, eine Sicherheitsvereinigung der Branche, gibt die Zahlen von Anthropic wieder und empfiehlt, Modellgewichte als sensible Werte zu behandeln.
Ein Marketingteam, das nie ein Modell hostet, braucht trotzdem eine Sandbox, Freigaberegeln und Protokolle, sobald ein Agent auf seinen Konten handeln kann. Den Freigabeschritt beschreibe ich in KI-Verifikation mit Human in the Loop, und die weiteren Risiken stehen in meinem Beitrag zur Sicherheit von KI-Agenten.
Fragen, die Sie vor dem Hosten eines Modells stellen sollten
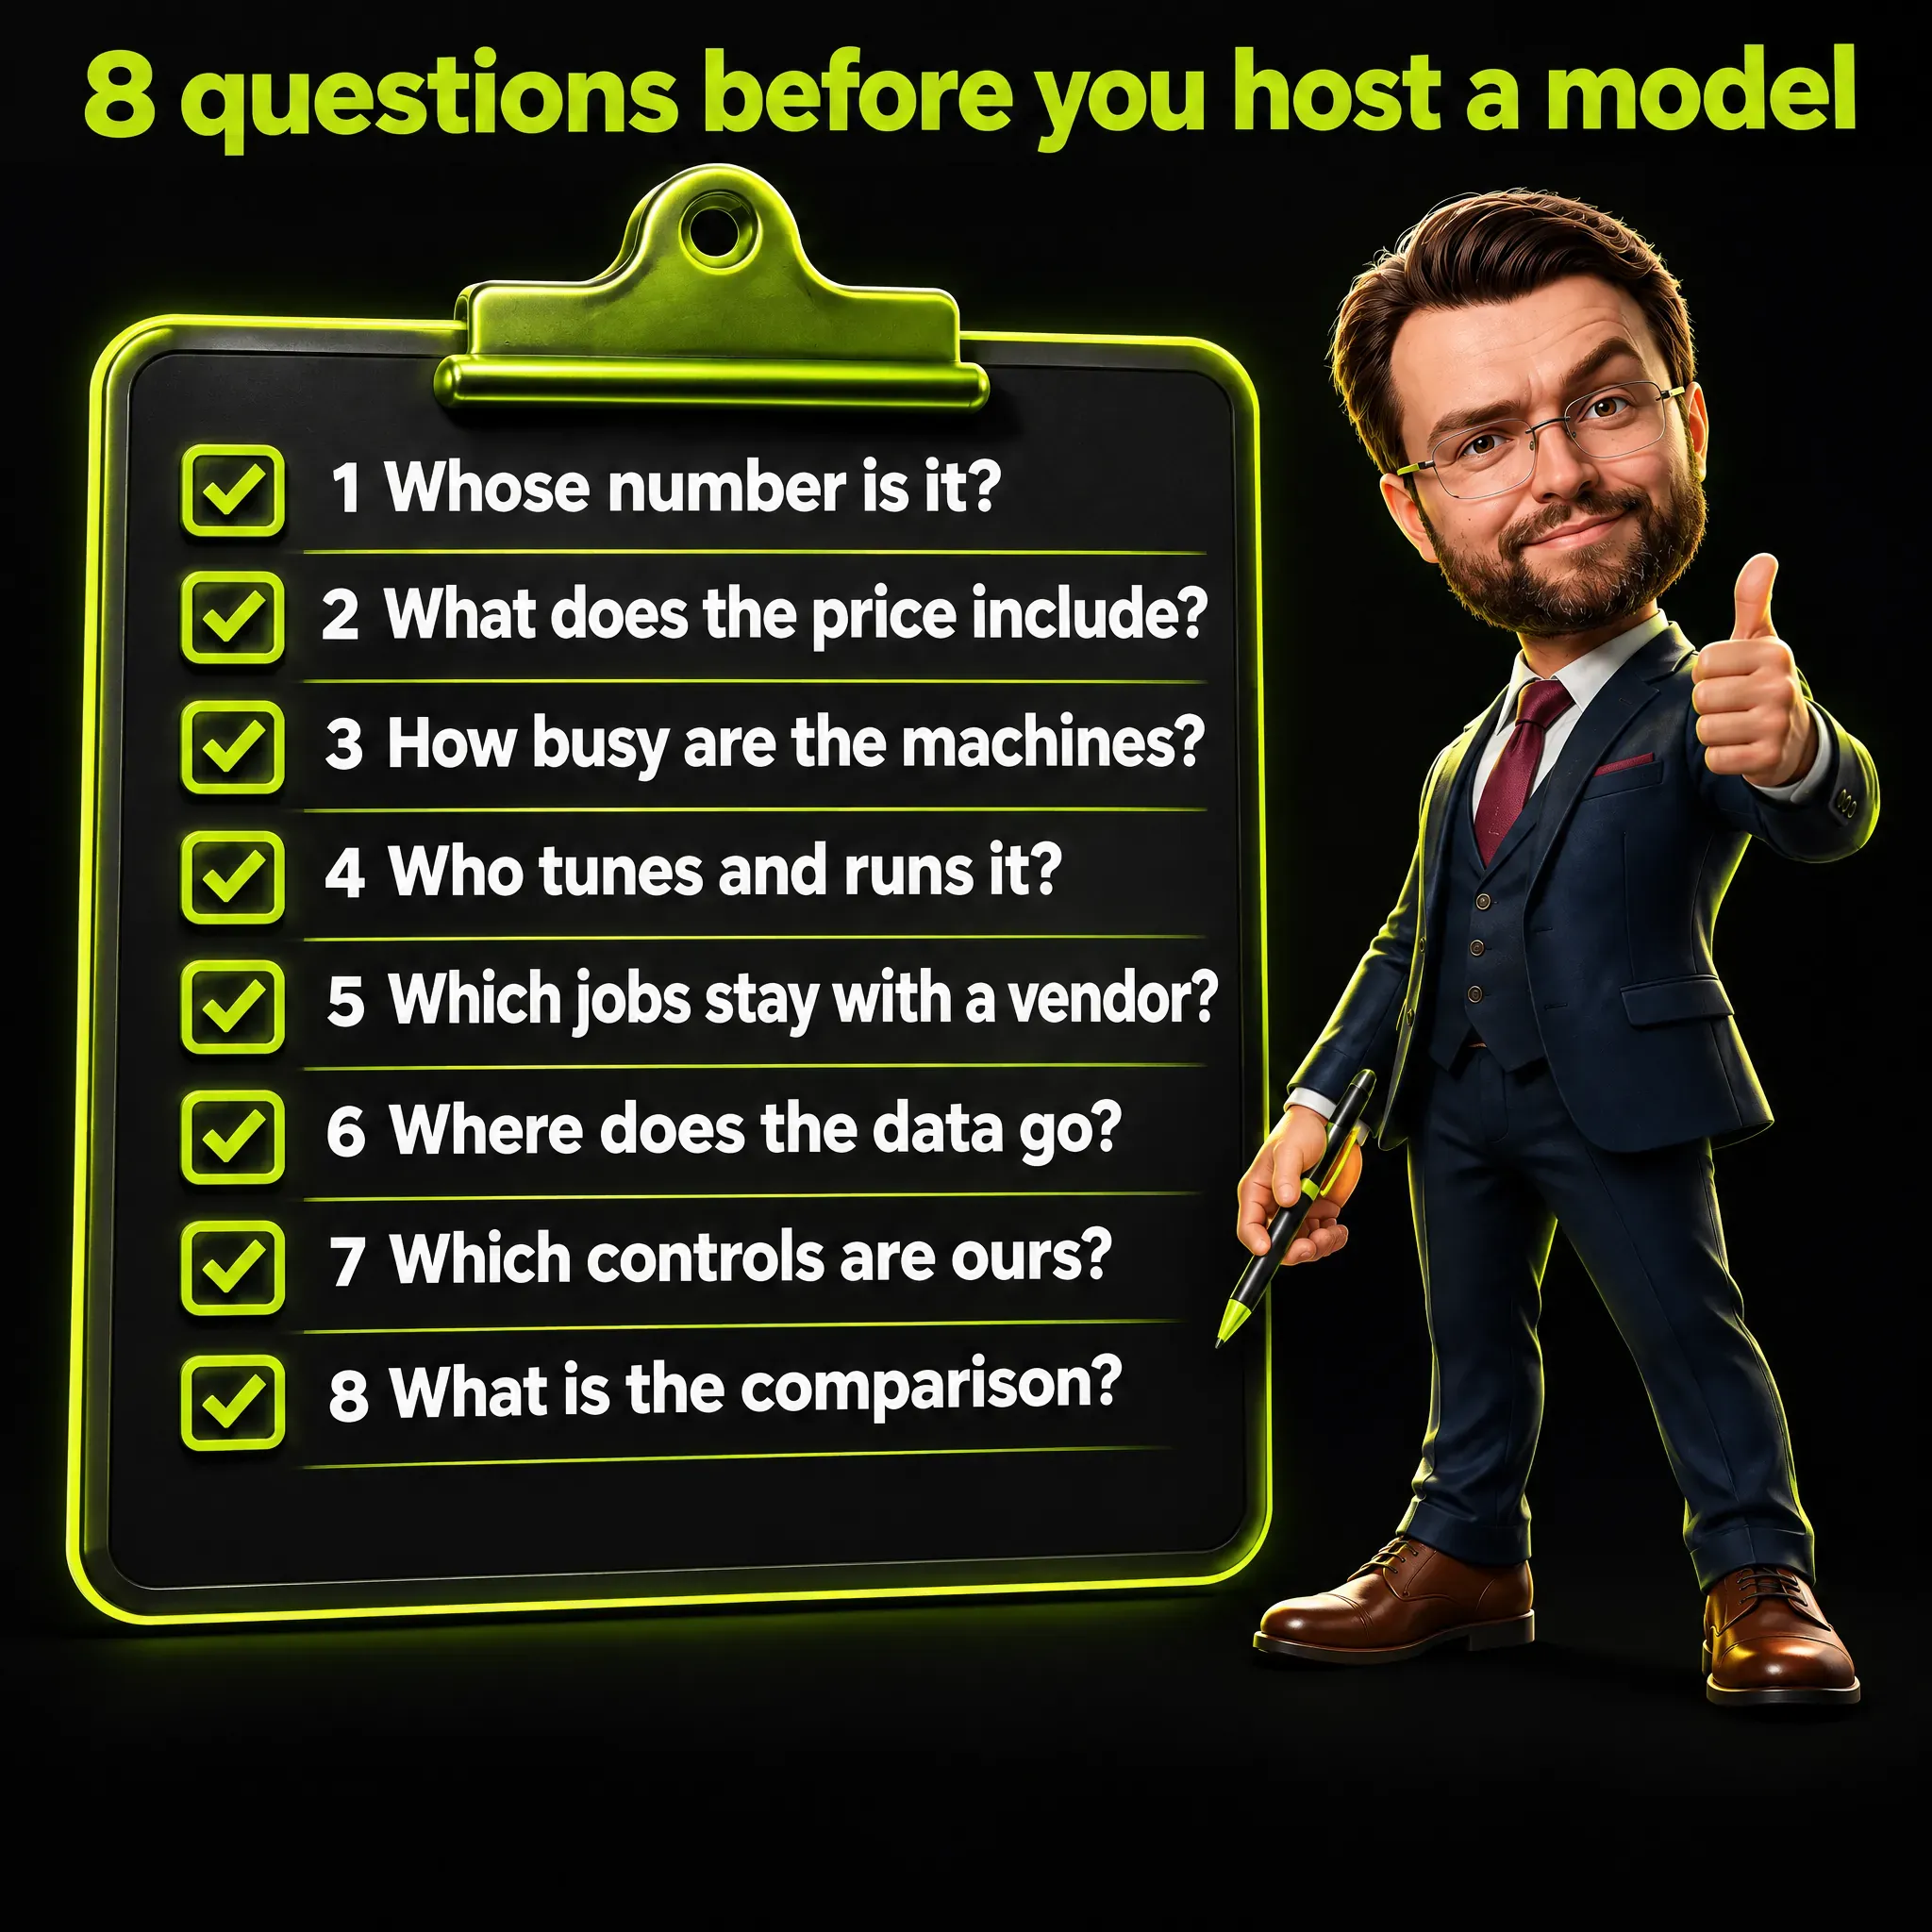
Aus den Abschnitten oben habe ich acht Fragen gemacht. Sie sind meine eigene Checkliste und gelten, ob die Aussage aus einem Konferenzvortrag oder von der Folie eines Anbieters stammt.
| Frage | Was ich sehen möchte |
|---|---|
| Wessen Zahl ist es? | Die Quelle der Einsparung, der Zeitraum und die Arbeitslast, die sie abdeckt |
| Was umfassen «Kosten pro Token»? | Input, Output oder beides, die Cache-Trefferquote und ob nur GPUs gezählt werden |
| Wie ausgelastet sind die Maschinen? | Erwartete Nutzer und Anfragen, denn der Preis pro Token sinkt mit steigender Nutzung |
| Wer tunt und betreibt es? | Ein benanntes Team mit seinen Stunden, denn Revoluts Tuning-Grafik reicht von April bis August |
| Welche Aufgaben bleiben bei einem Anbieter? | Eine Liste von Aufgaben, etwa Bildanfragen, die weiterhin ein anderes Modell brauchen |
| Wohin gehen die Daten? | Das Land, der Vertrag und die Aufbewahrung, zur Datenschutzberatung mitgenommen |
| Welche Kontrollen sind unsere? | Eine Sandbox, Freigaberegeln, Protokolle und eine Person, der die Gewichte gehören |
| Was ist der Vergleich? | Ein gehostetes Modell bei derselben Aufgabe, blind beurteilt an 20 echten Stichproben |
Sind die Antworten vage, behandle ich die Einsparung als Hypothese. Sind sie konkret und das Volumen gross, wird das Selbst-Hosting zu einer ernsthaften Option. Für ein kleines Team sind nach meinem Schluss aus Revoluts Zahlen die feste Rechnung und der Bedarf an einem Infrastrukturteam die Hindernisse.
Häufige Fragen
Was ist ein selbst gehostetes LLM?
Es ist ein grosses Sprachmodell, das ein Unternehmen auf Maschinen betreibt, die es besitzt oder mietet, statt den gehosteten Dienst eines Anbieters aufzurufen. Die Modelldateien müssen zum Herunterladen verfügbar sein, weshalb Selbst-Hosting meist ein Open-Weight-Modell meint, also ein Modell, dessen Hersteller diese Dateien veröffentlicht.
Was kostet es, ein LLM selbst zu hosten?
Keine Quelle, die ich gelesen habe, nennt einen übertragbaren Preis. Revolut meldet Mischkosten von rund 0,30 USD pro Million Tokens und Ausgaben von rund einem Zehntel der früheren Rechnung, bei 56 B200-GPUs für rund 2.000 Entwicklerinnen und Entwickler. Die Kosten für Cloud, Personal und Monitoring sind nicht veröffentlicht.
Ist Selbst-Hosting günstiger, als eine API zu bezahlen?
Für Revolut war es das nach eigener Darstellung. Allgemein kann ich das nicht sagen, weil die Antwort vom Volumen, von der Auslastung der Maschinen und von den Kosten der Menschen abhängt, die sie betreiben, und die Quellen, die ich fand, beschreiben einen einzigen Fall.
Kann ich ein LLM auf meinem eigenen Computer betreiben?
Eines dieser Klasse nicht. GLM-5.3 hat laut seiner Hugging-Face-Seite 753 Milliarden Parameter, und The Register beziffert die Gewichte des früheren GLM-5.1 auf rund 380 GB GPU-Speicher, weit mehr, als ein Laptop hat.
Was ist der Unterschied zwischen Open-Weight und Selbst-Hosting?
Open-Weight heisst, dass der Hersteller die Modelldateien veröffentlicht. Selbst-Hosting heisst, dass Sie sie auf Maschinen betreiben, die Sie kontrollieren. Auch ein Dritter kann die offenen Gewichte für Sie hosten, und das ist der zweite Weg in meinem Artikel über chinesische KI-Modelle.
Bleiben meine Daten beim Selbst-Hosting privat?
Es verändert den Weg, den die Daten nehmen; die Konferenzseite nennt das einen anderen Datenweg als beim gehosteten Dienst eines Entwicklers. Rechtliche Fragen beantwortet es nicht, und es macht die Schutzmassnahmen und die Protokolle zu Ihrer eigenen Aufgabe, deshalb würde ich die Datenfrage zur Datenschutzberatung tragen.
Brauche ich ein Infrastrukturteam?
Red Hot Cyber sagt, kleinere Unternehmen ohne Revoluts Grösse und Infrastrukturteam erreichten womöglich nicht dasselbe Ergebnis. Wie gross ein solches Team sein muss, ist in den Quellen nicht verfügbar.
Lohnt es sich für ein Marketingteam, ein LLM selbst zu hosten?
Meine Sicht, kein Befund: Ich würde zuerst ein gehostetes Modell nutzen und die acht Fragen oben durchgehen. Ein gehosteter Weg hält die Rechnung variabel, erspart aber die Maschinen, das Tuning und die Kontrollen, die dazugehören.
Mein Fazit
Was ich aus dem Fall Revolut mitnehme, ist eine Methode, jede Einsparung zu lesen. Eine Einsparung von 90 % verdient dieselben Fragen wie jede Behauptung in einer Budgetsitzung: wessen Zahl, welcher Zeitraum, was ist drin und was bleibt draussen. Red Hot Cyber beantwortet die letzte Frage mit Cloud, Personal und Monitoring; der Vortrag selbst nennt keine Ausschlüsse, und niemand hat diese Kosten veröffentlicht.
Auch die Verhaltensänderung nehme ich ernst. Wenn eine Rechnung die Nutzung von KI nicht mehr rationiert, geben Menschen ihr mehr Arbeit ab, und die Wirkung auf die Produktivität kann so gross sein wie die auf die Rechnung. Das gilt für ein Pauschalabo und für gehostete Modelle genauso wie für eigene GPUs.
Ich würde mit einem gehosteten Modell beginnen, die tatsächliche Nutzung über einige Monate messen und die Kostentabelle oben mit Ihren eigenen Zahlen ausfüllen. Wollen Sie danach ein LLM selbst hosten, also auf eigenen Maschinen, weil Volumen und Team es rechtfertigen, sind das Tuning und die Kontrollen der Teil, den man zuerst plant.


