LLM self-hosted: cosa non dice il risparmio del 90% di Revolut
Revolut dice che ospitare modelli GLM ha ridotto a un decimo la spesa IA per il codice. Cosa copre il dato per un LLM self-hosted, cosa omette e cosa chiedere.
Un LLM self-hosted è un modello linguistico di grandi dimensioni che un’azienda esegue su computer propri o noleggiati, invece di inviare richieste al servizio di un fornitore: il costo passa così da un addebito per token, una piccola unità di testo, alle macchine e alle persone che le gestiscono.
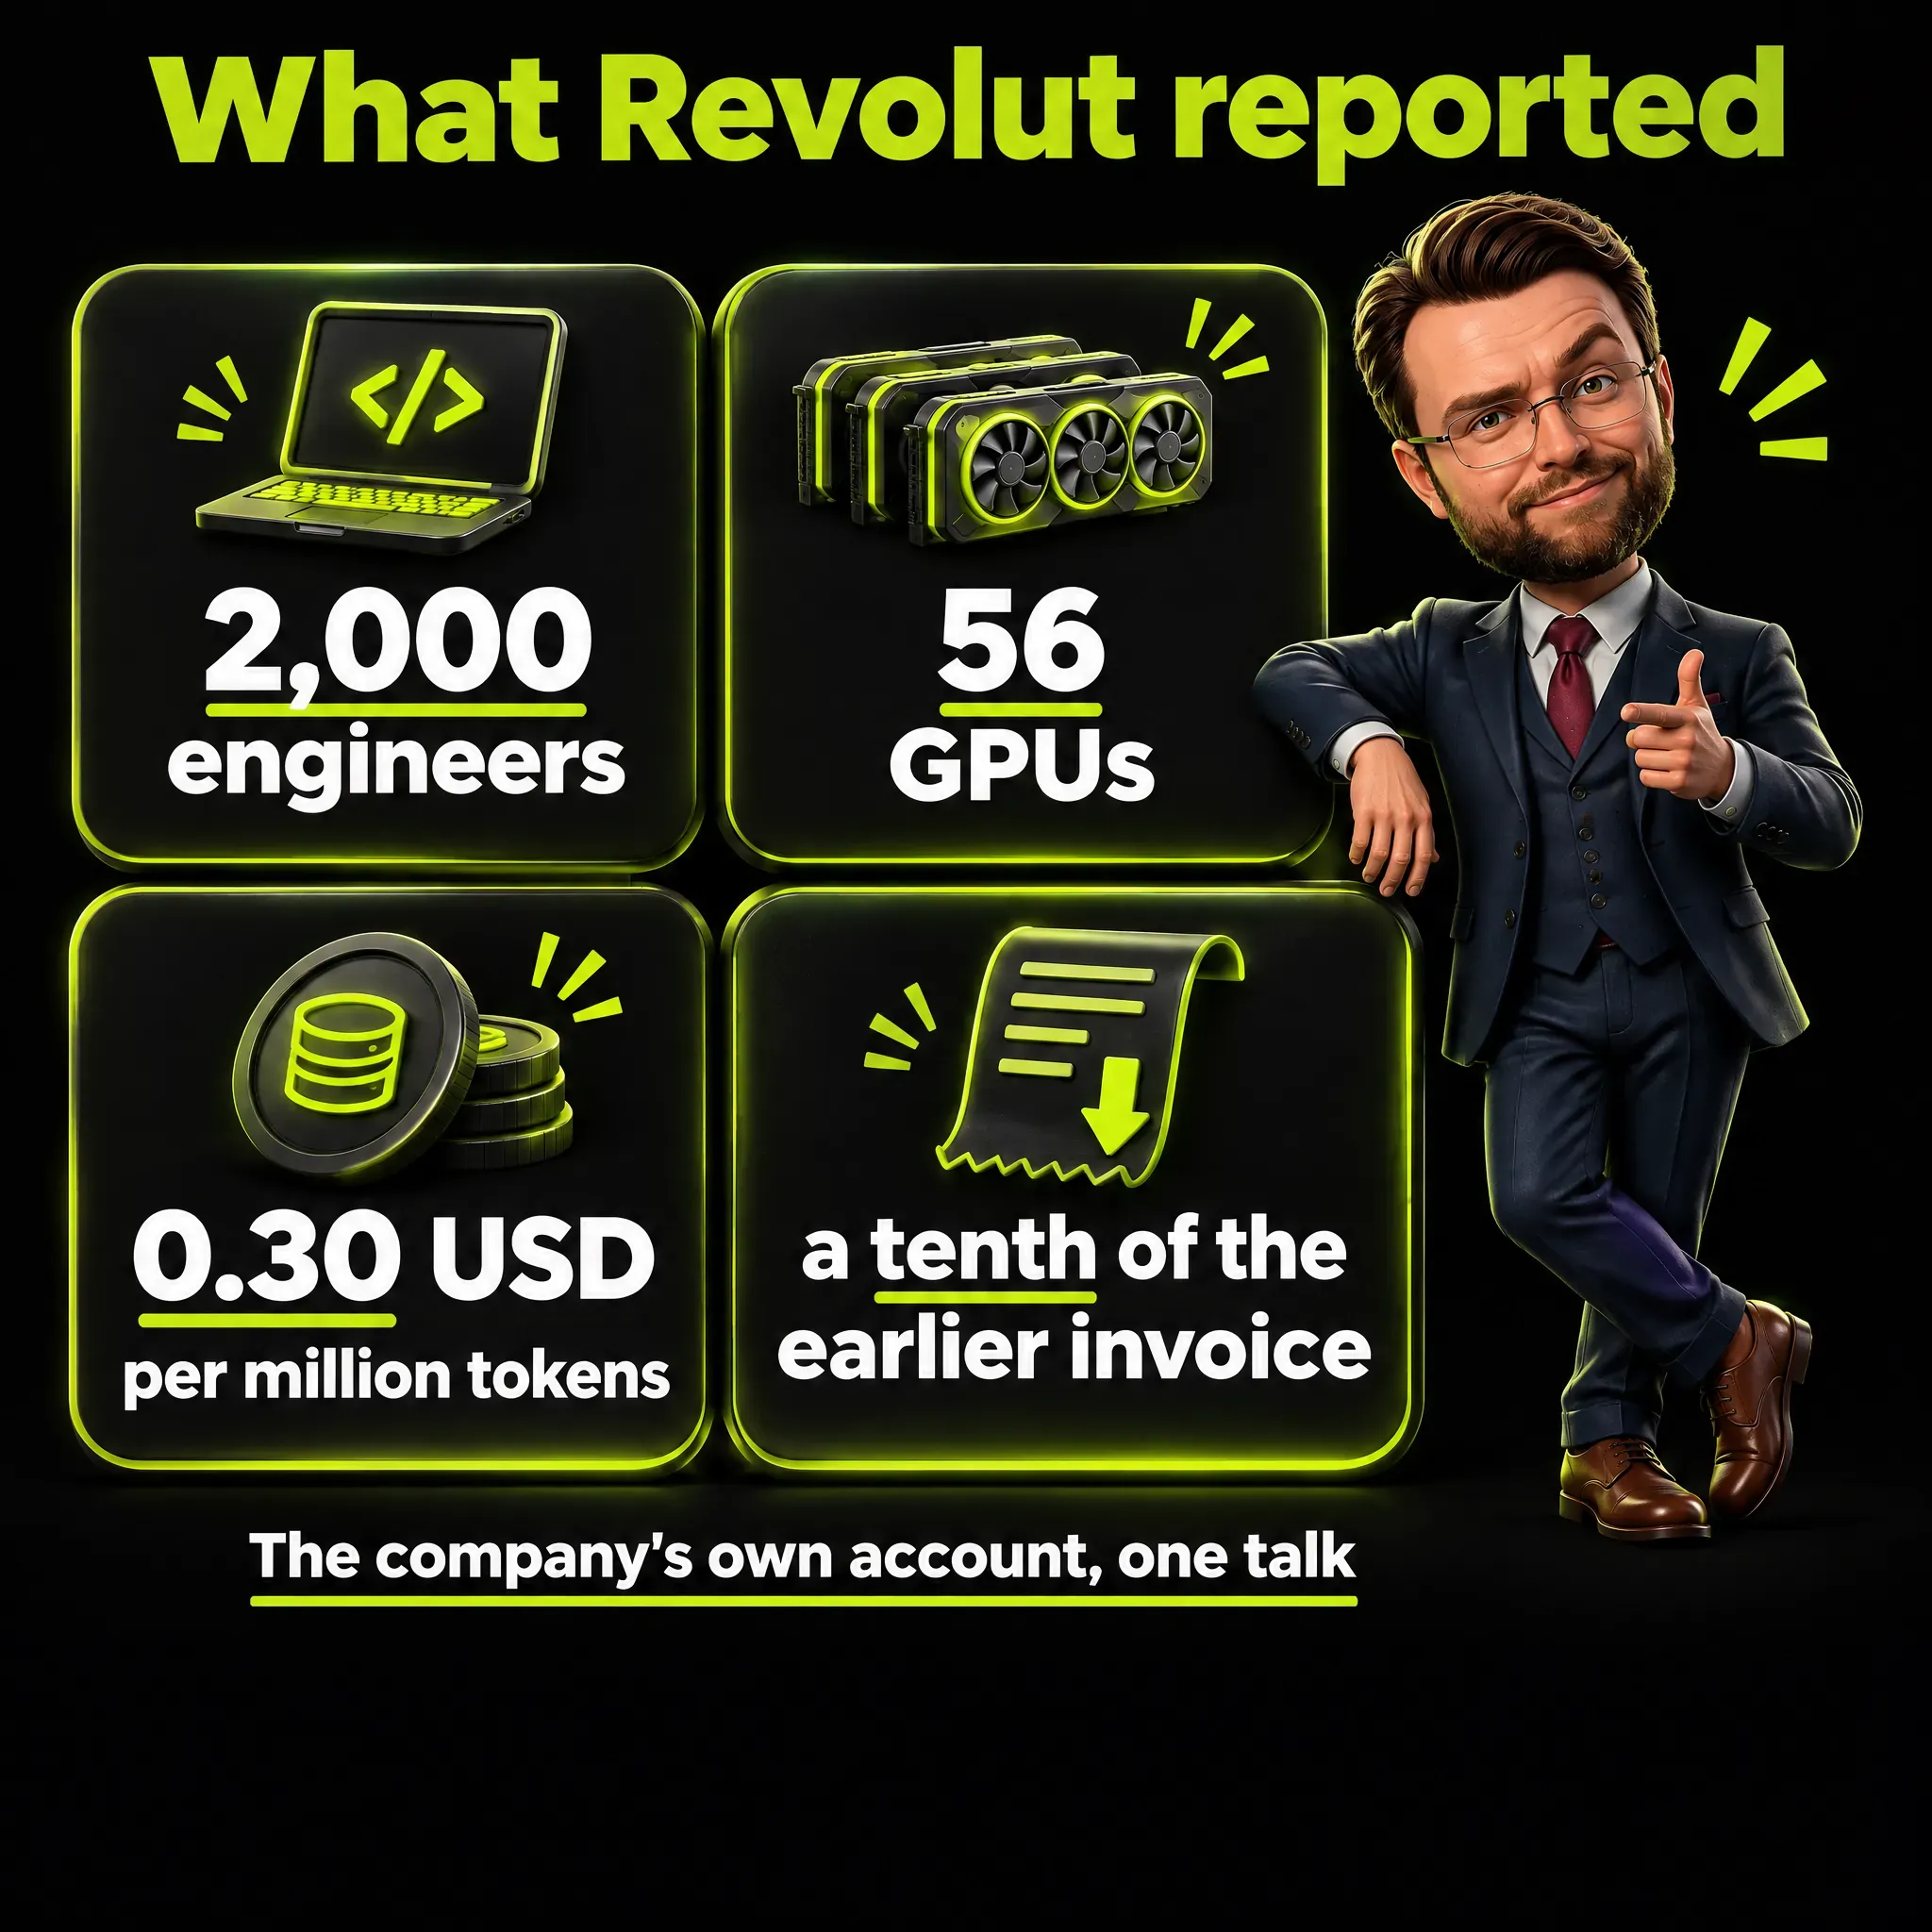
All’inizio di novembre 2026 i titoli dei giornali dicevano che Revolut, una banca digitale europea, aveva ridotto del 90 per cento, cioè di dieci volte, i costi dell’IA per scrivere codice, facendo girare i modelli GLM di Z.ai su GPU dedicate. Una GPU è il tipo di chip che fa girare i modelli di IA, e far rispondere un modello alle richieste si chiama inferenza. I numeri vengono da un talk di David Abitbol, responsabile di operations e infrastruttura di Revolut, alla conferenza AI Engineer di New York.
Lavoro nel marketing e uso modelli di IA ogni giorno, soprattutto modelli locali addestrati per le mie esigenze, perciò leggo questa notizia da utente di strumenti IA e non vanto competenze di ingegneria. Prima che una cifra così arrivi in una riunione sul budget, voglio sapere che cosa c’è dentro.
Questo articolo smonta l’affermazione e finisce con le domande da farsi prima di ospitare un modello.
Riguarda costi e controllo, non dà consigli legali e lascia fuori la geopolitica. I listini e le tre strade per usare un modello GLM sono nel mio articolo sui modelli IA cinesi per le aziende.
In sintesi
- Nessuna fonte indica un prezzo di self-hosting che si possa copiare. Il caso meglio documentato è quello di Revolut, e la pagina della conferenza dice che le sue cifre «descrivono l’implementazione e l’utilizzo di Revolut, non un prezzo portabile per un modello self-hosted».
- Il 90% mette a confronto due fatture per il carico di lavoro di una sola azienda. Revolut dice che la sua spesa è circa un decimo della precedente fattura di Anthropic e OpenAI, un’affermazione più ristretta di un calo del 90% di tutto ciò che l’IA costa all’azienda.
- Nel titolo manca il costo che sta intorno alle GPU. Red Hot Cyber scrive che il risparmio esclude i costi di cloud, personale e monitoraggio. Non ho trovato nessuna cifra per questi costi, né alcuna menzione di questa esclusione, nel talk o in The Register.
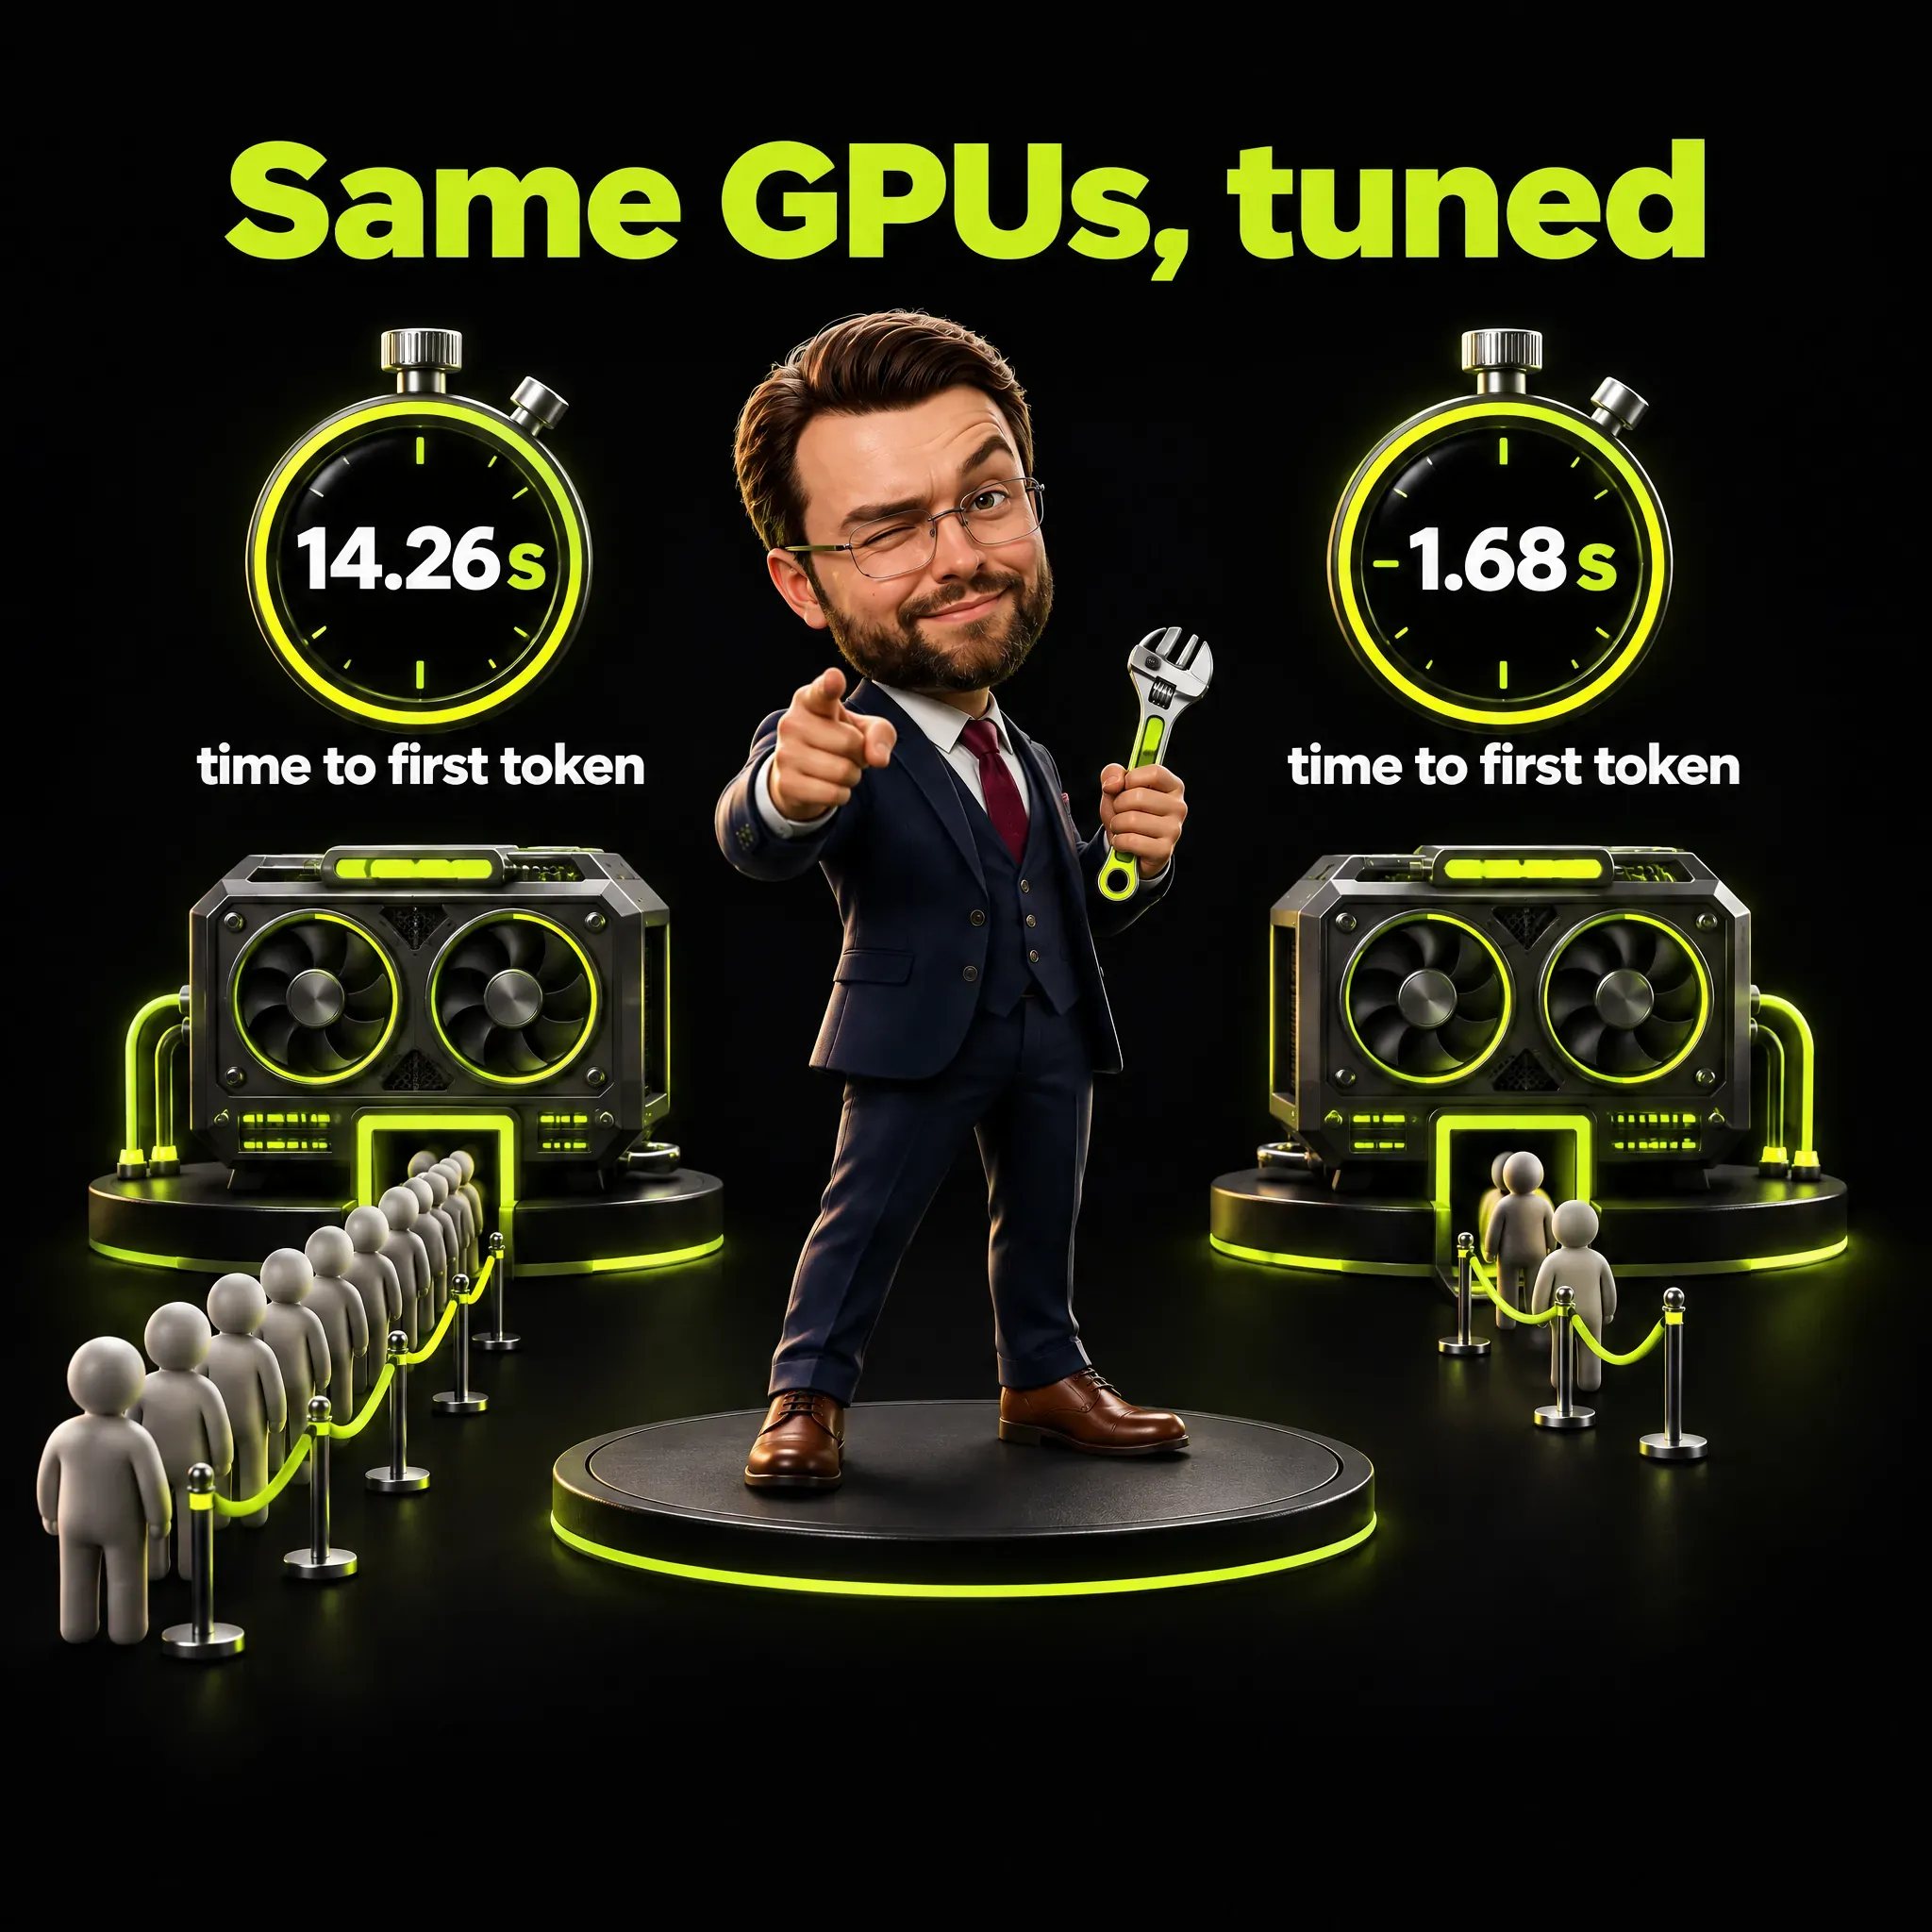
- A mio avviso il prezzo per token dipende da quanto sono occupate le macchine. Sulle stesse 56 GPU, dopo la messa a punto Revolut riferisce il 76% di richieste in più gestite ogni secondo e un’attesa per la prima parola della risposta più corta dell’88%.
- L’hosting aggiunge controlli che qualcuno deve gestire. Revolut abbina un’inferenza più economica a una sandbox (un’area recintata per l’agente), a regole di approvazione e a log dettagliati (la telemetria), e la pagina della conferenza dice che il self-hosting lascia alla banca la responsabilità di tutti e tre i punti.
- Per un team di marketing suggerisco di partire da un modello ospitato dal fornitore. Nessuna fonte lo mette alla prova, e le domande in fondo a questo articolo sono il modo in cui lo verificherei.
Cosa ha riferito Revolut e chi dice cosa
Tutto ciò che segue risale a tre tipi di fonte. Il primo è il talk stesso, che ho letto attraverso il riassunto scritto della conferenza AI Engineer, chiamato qui sotto pagina della conferenza, e attraverso la sua trascrizione. Il secondo è il giornalismo che lo ha raccontato, soprattutto The Register e Red Hot Cyber.
Il terzo è la mia aritmetica sui loro numeri. Tengo separati i tre tipi perché ogni racconto ha cambiato un po’ l’affermazione, e il talk è un’azienda che descrive il proprio impianto. Le citazioni dall’inglese sono traduzioni mie.
Prima quattro termini, perché la tabella li usa:
- Token: la piccola unità di testo che un modello legge e scrive, spesso una parola breve o un pezzo di una più lunga.
- Costo misto (blended cost): un unico prezzo medio su tutto ciò che entra e su tutto ciò che esce.
- Primo token: il primo pezzo di una risposta che compare sullo schermo.
- Tempo di codifica e lead time: le ore che un ingegnere passa a scrivere codice e i giorni che passano da quando prende in carico una funzione a quando è pronta per il rilascio.
| Voce | Cifra | Fonte |
|---|---|---|
| Utenti | Circa 2.000 ingegneri | Il talk |
| Hardware | 56 GPU Nvidia B200 che servono GLM-5.3 | Il talk, The Register |
| Costo per token | Un costo misto vicino a 0,30 dollari per milione di token | Il talk (pagina della conferenza) |
| Spesa | Circa un decimo della precedente fattura di Anthropic e OpenAI | Il talk (pagina della conferenza) |
| Effetto sul lavoro | Circa il 60% di miglioramento nel tempo di codifica, il 70% nel lead time | Il talk, con una riserva |
| Attesa per una risposta | Primo token in 14,26 secondi, poi in 1,68 secondi, sulle stesse GPU | Slide descritta nella pagina della conferenza |
| Obiettivi | Primo token sotto i 3 secondi, circa 200 token al secondo | Il talk |
I miglioramenti del 60% e del 70% richiedono una riserva che la pagina della conferenza dichiara da sola: «Il confronto interno non isola il cambio di modello da altre cause.» Il grafico mostra quindi che cosa è successo in Revolut nei mesi dell’introduzione, e non che cosa ha fatto il solo modello. Red Hot Cyber nomina uno degli altri fattori: l’eliminazione dei limiti di token.
Il talk indica 0,30 dollari per milione di token per «GLM» senza nominare una versione, mentre The Register lo lega alla configurazione precedente con GLM-5.1, perciò non attaccherei il numero a un solo modello. Revolut ha 80 milioni di clienti, secondo Abitbol, ma questo carico di lavoro riguarda circa 2.000 ingegneri.
Tre affermazioni, un solo numero
La stessa aritmetica ha prodotto tre frasi diverse, e non sono ugualmente sicure da ripetere. Dieci volte meno costoso e il 90 per cento in meno sono lo stesso rapporto; si distinguono per ciò che quel rapporto dovrebbe coprire.
La prima è di Abitbol stesso, come la riassume la pagina della conferenza: la spesa di Revolut è circa un decimo della precedente fattura di Anthropic e OpenAI. È un confronto tra ciò che un’azienda ha pagato ai fornitori e ciò che paga oggi per un solo tipo di lavoro, la scrittura di codice di circa 2.000 ingegneri.
Abitbol dice anche che, quando Revolut ha introdotto Claude Code, alcuni ingegneri spendevano «mille al mese, 10.000 al mese con un ritorno non così alto» (in dollari, secondo la citazione stampata da The Register). Per questo l’azienda lo ha lanciato «con limiti di budget rigorosi». La fattura precedente copre quindi un uso razionato e quella attuale un uso che gli ingegneri possono fare senza guardare il contatore, un confronto tra due modi di lavorare.
La seconda è il titolo di The Register, che dice che Revolut ha tagliato di dieci volte i costi dell’IA per il codice «eliminando Claude e passando al self-hosting». Il corpo dell’articolo è in alcuni punti più prudente: dice che GLM «non ha sostituito del tutto GPT o Claude» e cita Abitbol che afferma «la frontiera è l’eccezione». Qui frontiera indica i modelli più capaci dei grandi fornitori, e la pagina della conferenza concorda che questi servizi restano disponibili per le eccezioni.
Il corpo dell’articolo enuncia il rapporto anche in modo diverso dal talk. Dice che, a 0,30 dollari per milione di token in input e output, il self-hosting di GLM-5.1 costava circa un decimo di Codex o Claude Code, gli agenti di programmazione di OpenAI e Anthropic. A mio avviso questo mette a confronto un costo per token con un prodotto, il che è diverso da un confronto tra due fatture.
La terza è di Red Hot Cyber, che titola sul 90% e poi lo qualifica. Scrive che «Il risparmio del 90% esclude i costi di cloud, personale e monitoraggio e dipende da un’ottimizzazione accurata». Aggiunge che le aziende più piccole, «prive della scala e del team di infrastruttura di Revolut», potrebbero non ottenere lo stesso risultato.
Da dove viene il numero: dal confronto di Revolut tra la fattura precedente e la spesa attuale, presentato nel talk. Cosa significa: per quel carico di lavoro, a quel volume e con quella messa a punto, il conto dell’IA per il codice è circa un decimo di quello di prima. Cosa cambia: la cifra dice quanto si è ridotta una fattura, e non dice quanto si è ridotto il costo totale dell’operazione.
Sulla pagina della conferenza, nella trascrizione e in The Register non ho trovato alcuna ripartizione dei costi di cloud, personale o monitoraggio. Anche Red Hot Cyber dichiara l’esclusione senza numeri, e le parole del talk, «la nostra fattura» e «lì puoi procurarti le tue GPU», non chiariscono se quel decimo includa già le GPU in affitto. Considero l’esclusione un’affermazione di Red Hot Cyber e un limite della cifra.
Perché un prezzo per token non si confronta senza il mix
I prezzi di listino di Z.ai mostrano perché un numero misto richiede la sua composizione. In dollari per milione di token, l’input di GLM-5.3 costa 1,40, l’input in cache 0,26 e l’output 4,40. L’input in cache è testo che il sistema ha già elaborato e fattura a una tariffa più bassa.
Gli agenti di programmazione rimandano buona parte dello stesso testo a ogni passaggio, quindi l’input in cache domina il loro traffico. La pagina del Coding Plan di Z.ai, il suo abbonamento per gli strumenti di programmazione, ipotizza una percentuale di cache hit del 95%, cioè 95 token di input su 100 sono testo già elaborato. Ecco l’aritmetica su queste due fonti: 0,95 x 0,26 + 0,05 x 1,40 dà circa 0,32 dollari per milione di token di input a prezzo di listino.
Il valore è vicino allo 0,30 misto di Revolut, e non ne traggo alcuna conclusione. Le fonti non indicano il mix di Revolut tra input, input in cache e output, e i token di output costano 4,40 nel listino di Z.ai. Abitbol dice comunque al suo pubblico di controllare che la cache hit per un carico di programmazione «deve essere sopra il 90%», e una cifra mista di 0,30 potrebbe nascere da molti mix diversi.
Quando qualcuno cita un costo per milione di token per un impianto in self-hosting, farei tre domande: se copre input, output o entrambi, quale quota dell’input viene dalla cache e se conta solo le GPU. Senza queste risposte il numero non si può confrontare con il listino di un fornitore, ed è per questo che leggo il confronto di Revolut come un confronto tra due fatture.
Il listino completo è nella mia guida ai modelli IA cinesi per le aziende. Per capire dove stanno i costi dei modelli tra gli altri strumenti di un team, uso il quadro del mio marketing tech stack del 2026.
Perché il prezzo per token dipende da quanto lavorano le macchine
Il talk di Abitbol parla di «self-hosting di un modello open source su GPU dedicate», cioè macchine riservate all’uso di Revolut. Per come lo leggo, le macchine riservate costano lo stesso sia che rispondano a una richiesta sia che ne servano mille. Il prezzo per token è quindi la fattura fissa divisa per il numero di token che le macchine elaborano.
Un esempio inventato con numeri tondi, non di Revolut: poniamo che le macchine costino 100 unità al mese. Se elaborano 100 milioni di token, ogni milione costa 1 unità. Se la messa a punto permette alle stesse macchine di elaborarne 500 milioni, ogni milione costa 0,2 unità e il conto non è cambiato.
Revolut non presenta così i suoi risparmi, ma il suo grafico di messa a punto è coerente con questo meccanismo. Abitbol avverte che caricare i pesi, cioè i file del modello, sulle GPU e avviare l’inferenza, il passaggio in cui il modello risponde alle richieste, dà «prestazioni pessime» senza quella messa a punto. Il team ha regolato il sistema che serve il modello sulla propria domanda reale, e il suo grafico tiene costante il numero di GPU da aprile ad agosto.
La slide, come la descrive la pagina della conferenza, riporta il 76% di richieste al secondo in più e il tempo al primo token ridotto dell’88%, da 14,26 secondi durante la migrazione a 1,68 nella configurazione stabile. Il tempo al primo token è l’attesa tra l’invio di una richiesta e la comparsa della prima parola della risposta. Secondo la mia aritmetica, l’attesa è diventata circa 8,5 volte più corta.
Gli obiettivi di Abitbol sono concreti. Punta a «un tempo al primo token sotto i 3 secondi» e dice che «appena si superano i 5 secondi, la mia casella di Slack comincia a esplodere». Il suo consiglio è «resistere allo scaling», cioè mettere a punto le GPU che ci sono prima di comprarne altre.
Abitbol dice che gli ingegneri che si collegano dopo le 17 possono ottenere 800 token al secondo, contro i 200 che la pagina della conferenza considera adeguati per il lavoro interattivo. A mio avviso la domanda serale è più bassa, quindi le stesse macchine rispondono più in fretta, e la capacità inattiva della sera si paga comunque. Per un team con una manciata di utenti, la stessa fattura fissa si spalma su molti meno token.
Cosa serve per far girare un LLM self-hosted, in parole semplici
Un modello della classe di GLM richiede hardware da data center. The Register riporta che GLM-5.1 ha circa 754 miliardi di parametri, con 40 miliardi attivati per ogni token che genera, e che servono circa 380 GB di memoria GPU per contenerne i pesi. I parametri sono i numeri che un modello ha appreso durante l’addestramento, e i pesi sono i file che li conservano.
La conversazione aperta di ogni utente occupa memoria in aggiunta. The Register la stima in altri 6-26 GB per utente, a seconda della precisione. La pagina di GLM-5.3 su Hugging Face, la libreria pubblica dove questi modelli vengono pubblicati, indica 753 miliardi di parametri, la cifra che uso per il modello attuale.
Queste sono le decisioni che il talk e The Register descrivono, nell’ordine in cui un non ingegnere riesce a seguirle:
- Dimensione del contesto. La finestra di contesto è la quantità di testo che il modello tiene in vista in una volta, e compete con le richieste degli altri utenti per la memoria delle GPU. Abitbol dice che «il contesto lungo è una truffa»: il modello può servire un milione di token, ma 256.000 è quanto serve ai suoi ingegneri.
- Memorizzare i pesi in modo più compatto. La quantizzazione significa memorizzare i numeri con meno cifre per risparmiare memoria, e Revolut preferisce un formato a 4 bit sulle sue GPU B200, un chip Nvidia da data center attuale.
- Distribuire il modello su più GPU. La pagina della conferenza osserva che far stare i pesi su quattro GPU può lasciare troppo poca memoria per la cache del testo già elaborato, quindi una suddivisione su otto GPU può funzionare meglio.
- Mandare altrove alcuni lavori. Il modello GLM che Revolut usa per la programmazione gestisce solo testo, perciò Revolut usa un router che manda le richieste con immagini a Gemini o a GPT Luna mentre la generazione di codice resta su GLM.
Un prezzo per token nasconde queste scelte su memoria, velocità e instradamento. Il costo di un modello self-hosted comprende la competenza per farle, e Revolut ha continuato a pagare i fornitori per i lavori che il modello non sa fare.
I costi che nessuno ha pubblicato
Ecco ogni voce di costo che vorrei vedere compilata prima di confrontare un impianto self-hosted con il prezzo di un fornitore. «Non disponibile» significa che non ho trovato alcun numero in nessuna fonte letta, e non ho riempito il vuoto con una stima.
| Voce di costo | Cosa dicono le fonti | Cifra |
|---|---|---|
| Le GPU, acquistate o noleggiate | 56 GPU B200 servono GLM-5.3 | Non disponibile |
| Cloud | Red Hot Cyber dice che il 90% esclude i costi di cloud | Non disponibile |
| Le persone che lo gestiscono | Red Hot Cyber dice che il 90% esclude il personale; le aziende più piccole potrebbero non avere un team di infrastruttura | Non disponibile |
| Monitoraggio e log | Red Hot Cyber dice che il 90% esclude il monitoraggio; Abitbol chiede telemetria dettagliata per indagare sugli incidenti | Non disponibile |
| Tempo di messa a punto | Il grafico copre da aprile ad agosto sulle stesse GPU | Ore non disponibili |
| Fornitori mantenuti per le eccezioni | I servizi di frontiera restano disponibili; le richieste con immagini vanno a Gemini o a GPT Luna | Non disponibile |
| Passaggio da un modello al successivo | Revolut è passata da GLM-5.1 a GLM-5.3 | Non disponibile |
Resta aperto un punto: Red Hot Cyber descrive le macchine come infrastruttura di Revolut negli Stati Uniti. Abitbol invece dice «lì puoi procurarti le tue GPU» nei paesi che elenca e parla di fornitori di GPU che per impostazione predefinita non conservano copia dei dati, la «zero data retention». Non riesco a capire dalle fonti se le GPU siano acquistate o noleggiate, e la risposta cambia la forma del conto.
Il mio suggerimento è usare la tabella come un modulo. Quando qualcuno ti parla di un risparmio del 90%, chiedigli di compilare ogni riga per il suo caso, o di dire quali righe la cifra lascia fuori. Un risparmio che supera questo esercizio è uno che metterei in un budget.
Per il costo che compare dopo la fattura, il tempo di chi controlla l’output, confronto due livelli di Claude in Claude Haiku contro Sonnet per il marketing. Il metodo che uso lì, provare 20 campioni reali alla cieca, funziona allo stesso modo per un modello GLM ospitato dal fornitore.
Cosa cambiano i token più economici nel modo di lavorare
Per me la parte più utile del talk riguarda il comportamento. La pagina della conferenza descrive che cosa è successo con i limiti di token: quando i token sembrano scarsi, gli ingegneri li tengono per un compito di programmazione difficile e non li usano nel lavoro che lo circonda. La risposta di Revolut è stata un costo fisso che ha permesso agli ingegneri di delegare di più.
L’interpretazione di Abitbol è che i ritardi nell’ingegneria comprendono la posta in arrivo, Jira e Confluence, cioè gli strumenti di gestione dei progetti e di documentazione intorno al codice. Un accesso più economico, secondo lui, ha allargato i compiti che le persone erano disposte ad affidare al modello. The Register lo cita sul debug e sul lavoro sui ticket: «Quando hai token illimitati, sei libero di farlo.»
Questo rende difficili da leggere le cifre del 60% e del 70%. Una parte del miglioramento può venire dal modello, una parte dagli ingegneri che usano l’IA per più tipi di lavoro, e la pagina della conferenza dice che il confronto non li separa. Non attribuirei il merito né al solo modello né al solo self-hosting.
Per il mio settore posso offrire solo uno scenario, ed è inventato. Immagina un team di marketing che limita l’uso di un agente IA perché ogni lavoro lungo costa denaro vero: lo usa per il report mensile e fa a mano il tagging e i controlli di ogni giorno. Se il conto fosse fisso, lo stesso team potrebbe affidargli anche quei lavori minori.
Nessuna fonte misura questo per il marketing. Qualcuno paga comunque le macchine, e il vantaggio compare solo se il lavoro in più che l’agente fa è abbastanza buono da essere tenuto dopo il controllo di una persona.
Dove vanno i dati e cosa il talk non chiarisce
La pagina della conferenza fa un’osservazione semplice: scaricare i pesi ed eseguirli su un’infrastruttura scelta dall’azienda è un percorso dei dati diverso dall’inviare richieste al servizio ospitato di uno sviluppatore di modelli. Su questo Abitbol dice che la preoccupazione per la privacy dei modelli cinesi riguarda la chiamata a un endpoint dedicato (un indirizzo di servizio) in Cina, mentre portare i pesi «su un servizio con sede negli Stati Uniti» è un altro caso. Secondo The Register, per lui macchine on premises (i server dell’azienda stessa) o un fornitore cloud nella stessa regione lasciano poco da temere, ma è la formulazione del giornalista e non una citazione di Abitbol.
Aggiunge che vanno bene i dati tenuti nei paesi di quello che la trascrizione rende con «quadro di equivalenza dei dati» (data equivalency framework), cioè Stati Uniti, UE, Regno Unito e Israele. Secondo lui i fornitori di inferenza e di GPU avranno «zero data retention per impostazione predefinita», cioè nessuna conservazione dei dati, ma nessuna fonte che ho letto verifica questa affermazione. Sono sue dichiarazioni su Revolut, una banca, e la pagina della conferenza dice che «non vanno lette come una determinazione generale per cui un modello, una regione o una sandbox soddisfi automaticamente gli obblighi di un’altra organizzazione».
Per l’API del produttore (l’accesso tecnico al suo servizio), l’informativa sulla privacy di Z.ai dice che i servizi sono in genere forniti da Singapore, e l’addendum sull’API contiene una clausola di non archiviazione. Entrambe sono dichiarazioni di Z.ai stessa e nessuna è stata verificata da terzi. Esamino entrambi i documenti nella sezione sui dati del mio articolo sui modelli IA cinesi.
Non sono un avvocato e questo non è un parere legale. Se dei dati personali, come elenchi di clienti o esportazioni di lead, finissero in un modello qualsiasi, porrei prima tre domande al consulente per la protezione dei dati: quale paese, con quale contratto, con quale conservazione.
I controlli intorno al modello
Il messaggio finale di Abitbol riguarda il controllo intorno al modello. Revolut allestisce una sandbox, cioè un’area recintata in cui gira l’agente di programmazione, insieme a regole di approvazione per le operazioni che l’azienda non vuole permettere. Il suo esempio è che «puoi permettere grep ma non gradle»: una regola può lasciare che l’agente cerchi nei file e impedirgli di avviare uno strumento di build.
Dice che i compiti di programmazione non vengono trattati come agenti autonomi, perché «hanno sempre un umano nel ciclo», e che la sandbox rassicura il regolatore su questo punto. Dice anche che la sandbox protegge dagli abusi di chi sta dentro l’azienda. L’ultimo requisito è la telemetria, cioè log dettagliati, in modo che il team possa ricostruire un incidente nel sistema.
Sulla prompt injection, un attacco in cui un testo nascosto in un documento o in una pagina web cerca di dare nuovi ordini all’agente, l’osservazione di Abitbol è breve: «Ormai non è più tanto un problema, dato quanto sono intelligenti i modelli, ma resta sempre un tema.» È la sua opinione in un talk, e in quel passaggio non cita alcun test a sostegno.
La pagina della conferenza elenca costi di inferenza più bassi, regole della sandbox e telemetria, e chiude con «Il self-hosting lascia a Revolut la responsabilità di tutti e tre.»
Un’altra responsabilità accompagna i pesi aperti, i file del modello che un produttore pubblica perché chiunque possa scaricarli. Il comportamento di rifiuto incorporato in un modello simile vive in quei file, e il rapporto di Anthropic su GLM-5.3 descrive la sua rimozione con la tecnica che spiego in cos’è l’abliteration. La Cloud Security Alliance, un gruppo di settore sulla sicurezza, riprende le cifre di Anthropic e raccomanda di trattare i pesi dei modelli come risorse sensibili.
Un team di marketing che non ospita mai un modello ha comunque bisogno di una sandbox, di regole di approvazione e di log nel momento in cui un agente può agire sui suoi account. Il passaggio di approvazione è quello che descrivo in human in the loop e verifica dell’IA, e i rischi più ampi sono nel mio pezzo sulla sicurezza degli agenti IA.
Domande da farsi prima di ospitare un modello
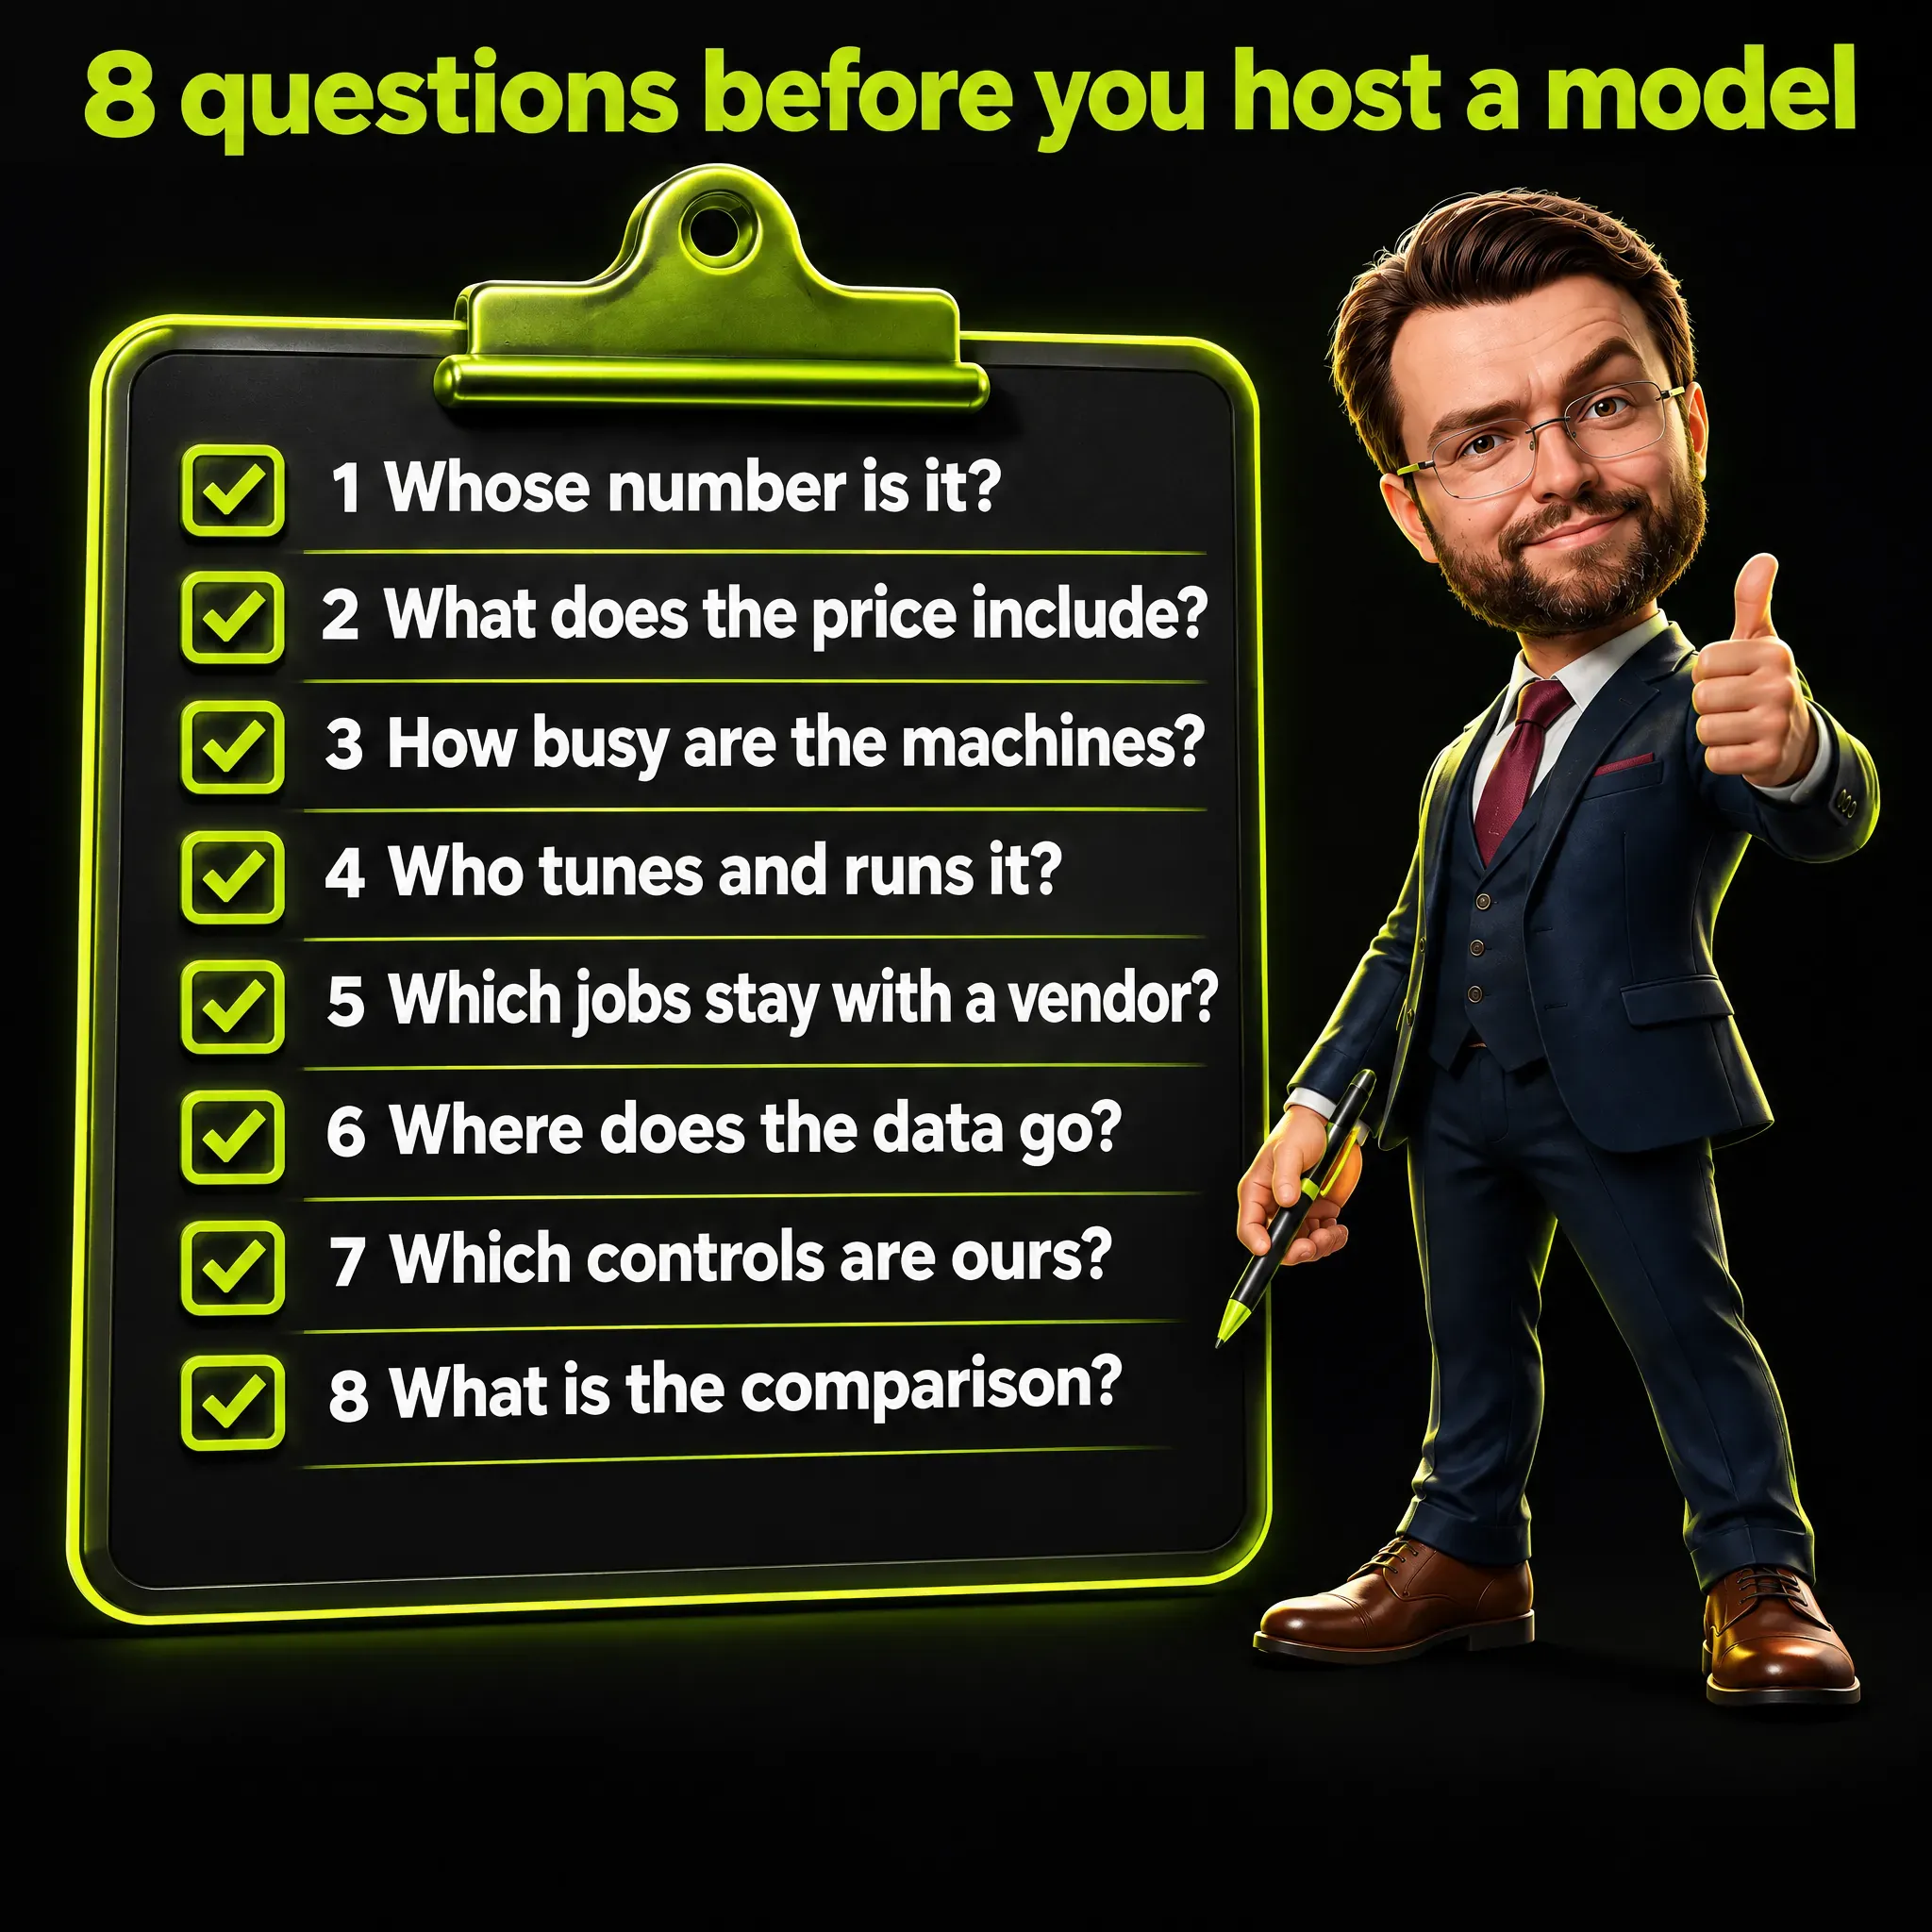
Ho trasformato le sezioni precedenti in otto domande. Sono una mia checklist e valgono sia che l’affermazione venga da un talk di una conferenza sia che venga da una slide di un fornitore.
| Domanda | Cosa vorrei vedere |
|---|---|
| Di chi è il numero? | La fonte del risparmio, il periodo e il carico di lavoro che copre |
| Cosa include il «costo per token»? | Input, output o entrambi, la percentuale di cache hit e se si contano solo le GPU |
| Quanto lavoreranno le macchine? | Utenti e richieste attesi, perché il prezzo per token scende al crescere dell’uso |
| Chi lo mette a punto e lo gestisce? | Un team con un nome e le sue ore, perché il grafico di messa a punto di Revolut copre da aprile ad agosto |
| Quali lavori restano a un fornitore? | Un elenco di compiti, come le richieste con immagini, che richiedono ancora un altro modello |
| Dove vanno i dati? | Il paese, il contratto e la conservazione, da portare al consulente per la protezione dei dati |
| Quali controlli sono nostri? | Una sandbox, regole di approvazione, log e una persona che risponda dei pesi |
| Qual è il confronto? | Un modello ospitato dal fornitore sullo stesso compito, giudicato alla cieca su 20 campioni reali |
Se le risposte sono vaghe, tratto il risparmio come un’ipotesi. Se sono precise e il volume è grande, il self-hosting diventa un’opzione seria. Per un team piccolo, la mia deduzione dai numeri di Revolut è che gli ostacoli siano il conto fisso e la necessità di un team di infrastruttura.
Domande frequenti
Che cos’è un LLM self-hosted?
È un modello linguistico di grandi dimensioni che un’azienda esegue su macchine proprie o noleggiate, invece di chiamare il servizio ospitato di un fornitore. I file del modello devono essere scaricabili, ed è per questo che il self-hosting di solito riguarda un modello a pesi aperti, cioè uno il cui produttore pubblica quei file.
Quanto costa un LLM self-hosted?
Nessuna fonte che ho letto indica un prezzo portabile. Revolut riporta un costo misto vicino a 0,30 dollari per milione di token e una spesa di circa un decimo della precedente fattura, con 56 GPU B200 per circa 2.000 ingegneri. I costi di cloud, personale e monitoraggio non sono pubblicati.
Il self-hosting costa meno che pagare un’API?
Per Revolut, secondo il suo stesso racconto, è stato così. In generale non posso dirlo, perché la risposta dipende dal volume, da quanto lavorano le macchine e dal costo delle persone che le gestiscono, e le fonti che ho trovato descrivono un solo caso.
Posso far girare un LLM sul mio computer?
Non uno di questa classe. GLM-5.3 ha 753 miliardi di parametri secondo la sua pagina su Hugging Face, e The Register stima i pesi del precedente GLM-5.1 in circa 380 GB di memoria GPU, ben oltre un portatile.
Che differenza c’è tra open weight e self-hosted?
Open weight significa che il produttore pubblica i file del modello. Self-hosted significa che li esegui su macchine che controlli. Anche una terza parte può ospitare per te i pesi aperti, ed è la seconda strada del mio articolo sui modelli IA cinesi.
Il self-hosting mantiene privati i miei dati?
Cambia il percorso che i dati compiono, che la pagina della conferenza definisce un percorso diverso da quello del servizio ospitato di uno sviluppatore. Non risolve le questioni legali e fa ricadere su di te le salvaguardie (i blocchi contro gli usi dannosi) e i log, perciò porterei la questione dei dati al consulente per la protezione dei dati.
Mi serve un team di infrastruttura?
Red Hot Cyber dice che le aziende più piccole, prive della scala e del team di infrastruttura di Revolut, potrebbero non ottenere lo stesso risultato. Quanto grande debba essere un team simile non è disponibile nelle fonti.
Un LLM self-hosted conviene a un team di marketing?
La mia opinione, non un risultato: userei prima un modello ospitato dal fornitore e farei le otto domande qui sopra. Questa strada lascia il conto variabile ma evita le macchine, la messa a punto e i controlli che le accompagnano.
La mia conclusione
Dal caso Revolut ricavo un metodo per leggere qualsiasi risparmio. Un risparmio del 90% merita le stesse domande di ogni affermazione in una riunione sul budget: di chi è la cifra, che periodo copre, cosa c’è dentro e cosa resta fuori. Red Hot Cyber risponde all’ultima con cloud, persone e monitoraggio; il talk stesso non elenca esclusioni e nessuno ha pubblicato quei costi.
Prendo sul serio anche il cambio di comportamento. Se una fattura smette di razionare l’uso dell’IA, le persone le affidano più lavoro, e l’effetto sulla produttività può essere grande quanto quello sul conto. Vale per un abbonamento fisso e per i modelli ospitati dal fornitore tanto quanto per GPU proprie.
Prima di scegliere un LLM self-hosted partirei da un modello ospitato dal fornitore, misurerei l’uso reale per qualche mese e compilerei la tabella dei costi qui sopra con le tue cifre. Se il volume e il team giustificano macchine proprie, la messa a punto e i controlli sono la parte da pianificare per prima.


