Abliteration: cos'è e come un modello smette di rifiutare
Abliteration spegne i rifiuti di un modello di IA modificandone i file. Cosa mostrano uno studio del 2024 e i test di Anthropic su GLM-5.3, e quanto costa.
Abliteration è una tecnica che toglie a un modello di IA l’abitudine di rifiutare le richieste dannose modificando i file pubblicati del modello, chiamati pesi: il comportamento di rifiuto si spegne, mentre le altre capacità restano in gran parte intatte, secondo i ricercatori che l’hanno misurata.
Il rapporto di Anthropic su GLM-5.3, pubblicato il 29 settembre 2026, usa il termine per una modifica di GLM-5.3, un modello di Z.ai a pesi aperti (significa che chi lo crea ne pubblica i file, quindi chiunque può scaricarli). Un rifiuto è il modello che declina una richiesta dall’aspetto dannoso, e i pesi sono i file che contengono tutto ciò che il modello ha imparato. Un modello abliterated è una copia di un modello aperto modificata in questo modo.
Lavoro nel marketing e uso ogni giorno modelli di IA, per lo più locali, addestrati per le mie esigenze. Ho letto le fonti dietro questo termine perché incide su quanto posso fidarmi della sicurezza integrata in un modello quando scelgo su cosa far girare un agente. Questo articolo spiega il meccanismo in parole semplici e mostra che cosa ha misurato Anthropic, con l’interesse di ciascuna fonte accanto alla sua affermazione.
Non fornisce istruzioni per farlo e non esprime giudizi su alcun paese o azienda. Le citazioni dall’inglese sono traduzioni mie. Il confronto completo dei test cyber su GLM-5.3 è nel mio articolo su come leggere i test sugli attacchi informatici dell’IA.
In sintesi
- L’abliteration modifica i file pubblicati di un modello a pesi aperti perché smetta di rifiutare. Serve una copia dei pesi, ed è per questo che Anthropic dice che non si può fare a Claude.
- Anthropic rimanda a uno studio di ricerca del 2024 per la tecnica. Arditi e i coautori hanno trovato che in 13 modelli di chat aperti fino a 72 miliardi di parametri (i numeri regolabili all’interno di un modello) il rifiuto è mediato da una sola direzione interna al modello, e chiamano il loro metodo un «white-box jailbreak» (un aggiramento delle salvaguardie che richiede di vedere dentro il modello).
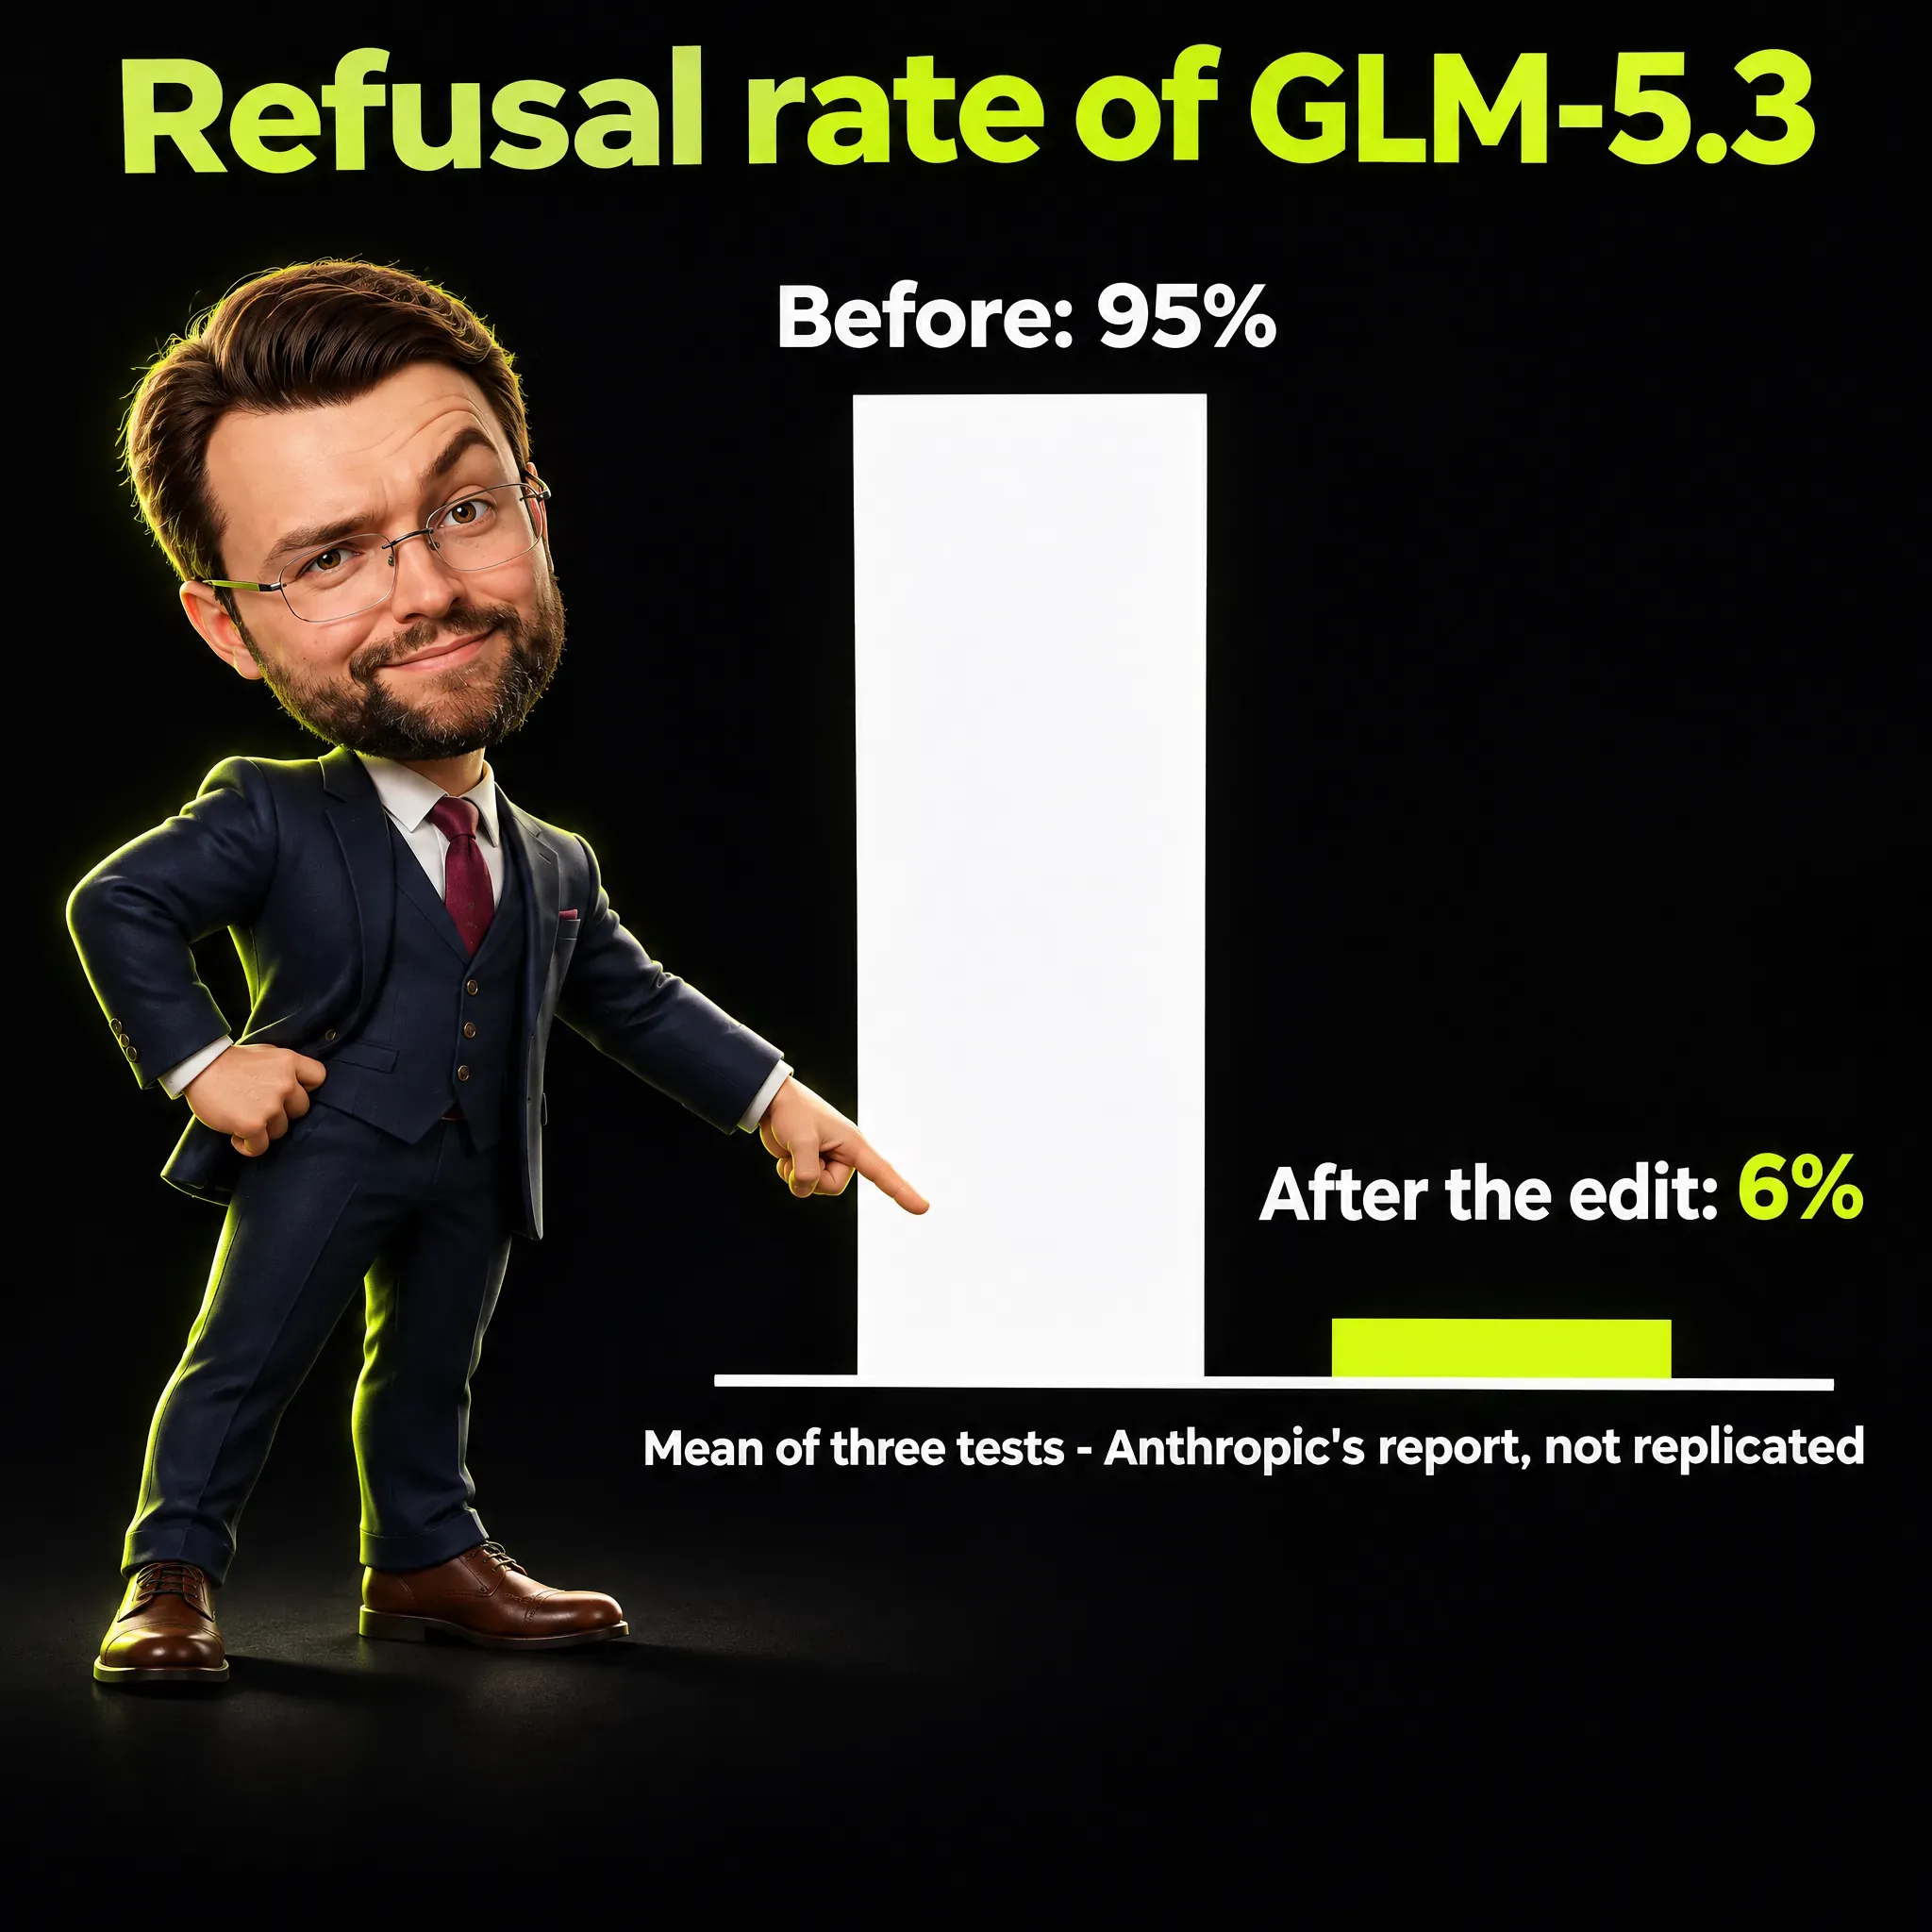
- Anthropic riferisce che il tasso medio di rifiuto di GLM-5.3 è sceso dal 95% al 6% dopo la modifica. Nessun test indipendente lo ha confermato. La Cloud Security Alliance (CSA), un gruppo di settore sulla sicurezza, dice che le cifre di Anthropic «meritano lo stesso vaglio di quelle di qualunque parte interessata» e che i due enti di test governativi, CAISI e AISI, non le hanno replicate.
- Due enti governativi esprimono un concetto simile in termini generali, e nessuno dei due ha testato l’abliteration. L’UK AI Security Institute (AISI) definisce l’addestramento al rifiuto «spesso facilmente reversibile con l’accesso ai pesi», e sulla sua pagina su GLM-5.2 il Center for AI Standards and Innovation (CAISI) statunitense scrive che le salvaguardie «possono essere aggirate quando il modello è self-hosted», cioè ospitato sui propri server.
- Anthropic stima il costo in circa 4.400 dollari di calcolo per un primo tentativo, e in circa 1.200 dollari per un gruppo esperto. CSA e The Decoder riprendono queste cifre, e nessun test indipendente le ha confermate.
- Nessuna fonte che ho letto misura come vengono usati in pratica i modelli abliterated. La mia conclusione: per un’azienda contano i controlli attorno al modello, cioè chi può raggiungerlo e chi approva ciò che fa.
Cos’è un rifiuto e dove vive
Quando chiedi a un buon modello di chat qualcosa di chiaramente dannoso, il modello declina. Quel rifiuto nasce in più punti contemporaneamente, e l’abliteration ne tocca uno solo.
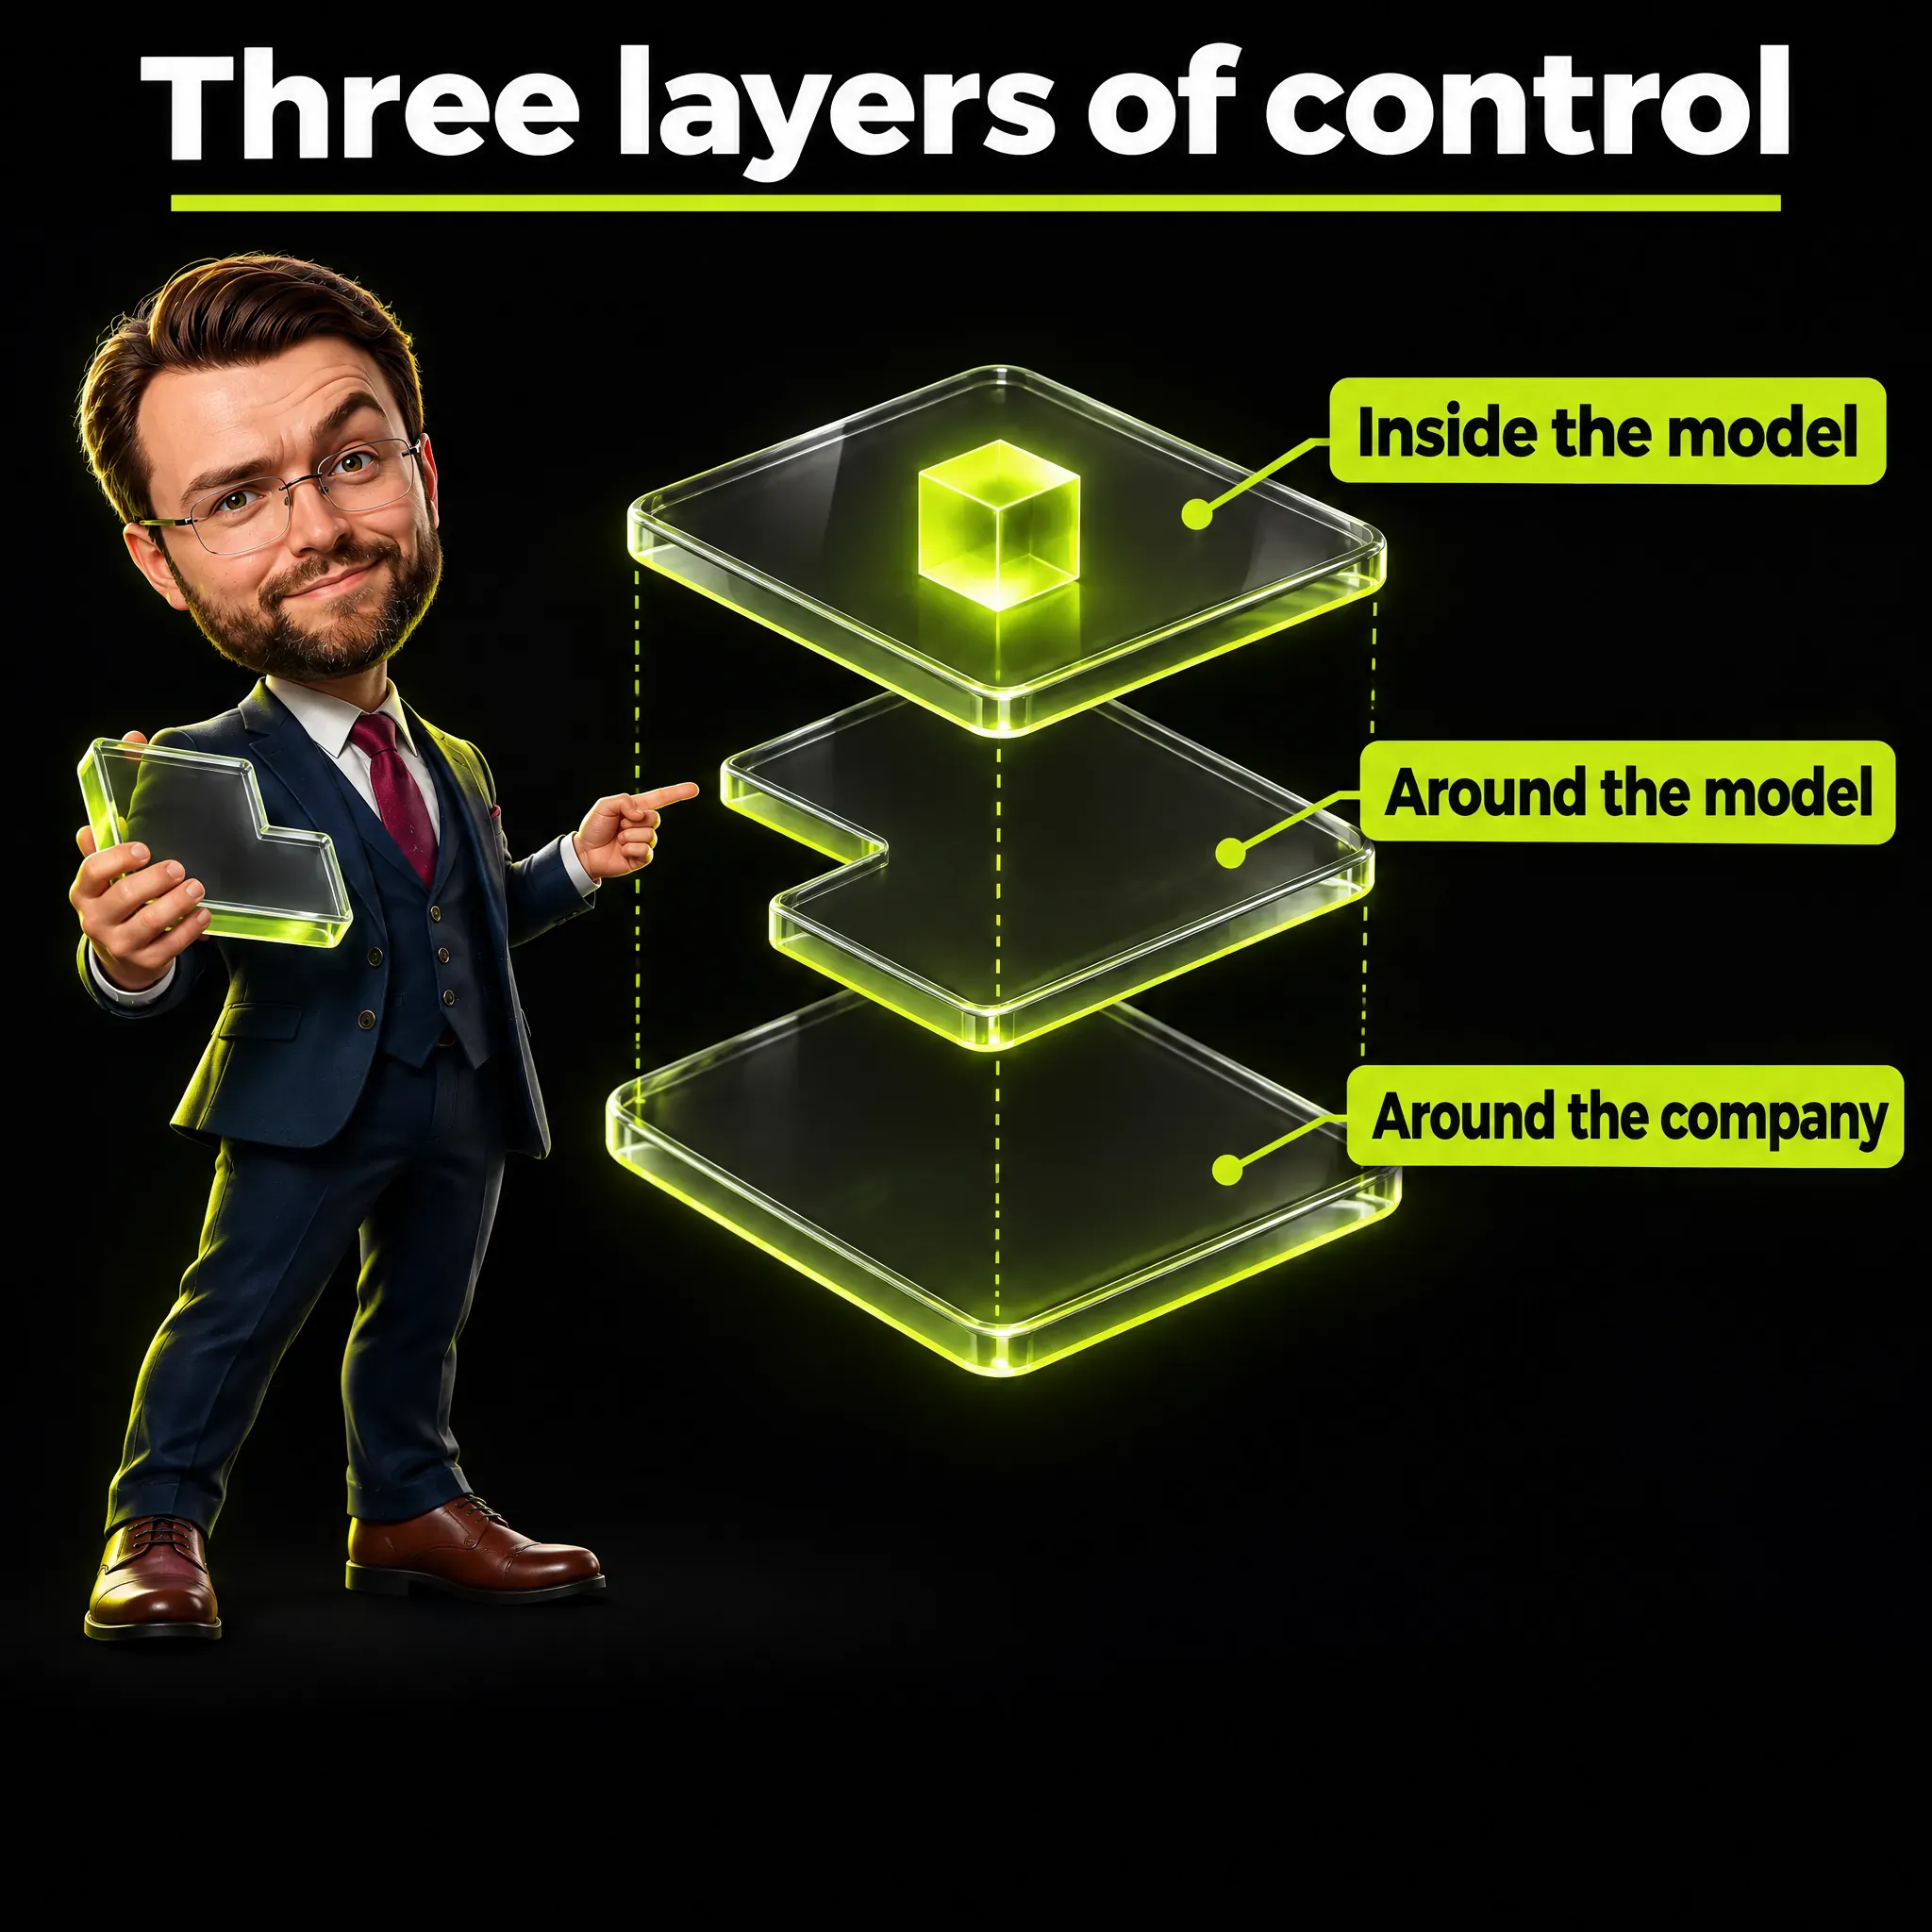
Trovo utile separare tre livelli. I primi due seguono la descrizione dei modelli a pesi aperti data da AISI, il terzo è una mia impostazione:
- Dentro il modello. L’addestramento al rifiuto, cioè l’addestramento che insegna a un modello a declinare le richieste dannose, inserisce l’abitudine nei pesi stessi.
- Attorno al modello, presso il fornitore. Il fornitore può monitorare le richieste, usare classificatori (programmi che smistano le richieste in innocue e dannose) e bloccare gli utenti che abusano del servizio.
- Attorno all’azienda che usa il modello. Lo controlla chi lo usa: a quali account e strumenti il modello può accedere e quali azioni richiedono l’approvazione di una persona.
Con un servizio ospitato come Claude tramite l’API di Anthropic (il modo in cui un software invia richieste a un modello via internet), i primi due livelli stanno dal fornitore. Con un modello a pesi aperti chi lo crea pubblica il primo livello e consegna i file, quindi non controlla più il secondo.
La conclusione di AISI è che le misure del secondo livello richiedono il controllo dell’accesso al modello e «non si possono applicare in modo universale una volta che i pesi sono pubblici». Resta l’addestramento al rifiuto, che AISI descrive come «spesso facilmente reversibile con l’accesso ai pesi».
Cosa fa l’abliteration, in parole semplici
Anthropic rimanda per la tecnica a uno studio del 2024 di Andy Arditi e sei coautori, «Refusal in Language Models Is Mediated by a Single Direction» («Nei modelli linguistici il rifiuto è mediato da una sola direzione»), pubblicato su arXiv, un sito aperto per le bozze di ricerca. Anthropic definisce l’abliteration «una tecnica standard di riduzione del rifiuto». L’abstract dello studio non usa la parola, e i suoi autori chiamano il loro metodo un «white-box jailbreak».
Un metodo white-box è uno in cui l’attaccante può vedere dentro il modello, e questo richiede i pesi. Un metodo black-box, come un prompt scritto con astuzia, lavora dall’esterno e vede solo le risposte.
La scoperta dello studio è che il rifiuto è mediato da «un sottospazio unidimensionale», una sola direzione nei calcoli interni del modello, in ciascuno di 13 diffusi modelli di chat open source fino a 72 miliardi di parametri. Cancellando quella direzione il modello smette di rifiutare le istruzioni dannose, e aggiungendola il modello rifiuta anche richieste innocue.
Ecco una mia analogia: immagina un mixer audio con decine di cursori, uno dei quali etichettato «cautela». In questi modelli il rifiuto si comporta come quel cursore, e gli autori riportano che abbassarlo ha un «effetto minimo sulle altre capacità». La loro conclusione sulla sicurezza è che i risultati «mettono in evidenza la fragilità degli attuali metodi di fine-tuning di sicurezza», cioè dell’addestramento aggiuntivo che insegna a un modello a declinare.
Questo articolo resta sul principio, che mi basta per giudicare il rischio. Per come leggo le fonti, la modifica avviene su una copia dei file, quindi non coinvolge affatto i server di chi ha creato il modello. AISI dice che una volta rilasciati i modelli «le copie possono essere scaricate, ridistribuite ed eseguite su sistemi privati fuori da ogni monitoraggio».
Cosa ha misurato Anthropic su GLM-5.3
Per capire quanto la tecnica indebolisca le salvaguardie di GLM-5.3, Anthropic ha creato da sé una copia abliterated. L’ha eseguita su tre benchmark pubblici, JailbreakBench, HarmBench e StrongREJECT, che misurano quanto spesso un modello asseconda richieste chiaramente dannose. Un tasso di rifiuto è la quota di quelle richieste che il modello declina.
Anthropic riferisce che la modifica ha portato il tasso di rifiuto di GLM-5.3 da oltre il 90% ai valori seguenti:
| Benchmark | Tasso di rifiuto di GLM-5.3 dopo la modifica |
|---|---|
| JailbreakBench | circa 3% |
| HarmBench | circa 2% |
| StrongREJECT | 12% |
Il grafico di Anthropic fa la media dei tre benchmark. Il tasso medio di rifiuto scende dal 95% al 6% per GLM-5.3 e dal 95% al 14% per il più piccolo GLM-5.3-Flash, mentre i modelli Claude rifiutano circa il 96% delle volte.
La capacità è cambiata poco: su GPQA-Diamond, un test di conoscenze scientifiche generali, il modello standard e quello abliterated hanno ottenuto lo stesso punteggio, e su un sottoinsieme testato del benchmark cyber CyberGym la versione abliterated ha ottenuto qualche percento in meno. Anthropic riassume che l’abliteration «lascia le capacità in gran parte intatte».
Da dove vengono i numeri: un’azienda, la sua copia abliterated e tre benchmark pubblici. Cosa significano: in questi test la modifica ha eliminato la maggior parte dei rifiuti, mentre un test scientifico e uno cyber sono cambiati poco. Cosa cambia: finché qualcun altro non ripete il test, tratto le cifre come un’affermazione di Anthropic, e CSA dice che CAISI e AISI non hanno replicato le cifre di Anthropic.
Anthropic dice anche che diversi sviluppatori hanno rilasciato al pubblico versioni abliterated di GLM-5.3 «entro pochi giorni dal rilascio del modello». CAISI indica il 14 agosto 2026 come data di rilascio del modello e dice che Z.ai ha pubblicato i pesi due settimane dopo, quindi dalle fonti non capisco da quale data si contino i giorni. In nessuna fonte ho trovato una cifra su quante persone abbiano scaricato o usato queste versioni.
Tre modi di aggirare un rifiuto, e che cosa serve per ciascuno
L’abliteration è uno dei vari modi per aggirare un rifiuto, e per un’azienda la differenza che conta è che cosa deve avere in mano la persona. Anthropic ne ha messi alla prova tre contro GLM-5.3 in un mondo simulato in cui il modello riceveva richieste apertamente malevole di attaccare sistemi critici. Così com’è, GLM-5.3 ha rifiutato in tutte le prove.
In questa simulazione «dare seguito» significa che il modello ha provato a collegarsi a un sistema bersaglio remoto dopo la richiesta dannosa. Ogni cella poggia su 50 campioni e non viene eseguito alcun codice, perciò Anthropic descrive queste simulazioni come «misure imperfette di come si comporterebbe un modello in una data situazione». Una nota aggiunge che i compiti cyber dei test precedenti di Anthropic «non hanno scatenato tali rifiuti sul modello rilasciato», quindi lo 0% della prima riga descrive solo richieste apertamente malevole.
| Modo di aggirare il rifiuto | Cosa serve alla persona | GLM-5.3 ha dato seguito | Claude, secondo Anthropic |
|---|---|---|---|
| Una richiesta diretta | Accesso alla chat o all’API | 0% | 0% |
| Una falsa storia di copertura nel prompt | Accesso alla chat o all’API | 64% | 0%, le salvaguardie hanno bloccato le richieste |
| Ragionamento precompilato, in cui l’attaccante scrive l’inizio del pensiero del modello | Un’API che lo consente | 92% | Impossibile, l’API non offre modo di precompilare |
| Una copia abliterated | I pesi | 100% | Impossibile, i pesi non sono forniti agli utenti |
I primi due metodi, la falsa storia e il ragionamento precompilato, puntano al livello del fornitore. Un fornitore che serve il modello può controllare i prompt e decidere di non offrire la precompilazione, come Anthropic dice di fare per Claude. Il terzo metodo, la copia abliterated, non ha nessun fornitore di mezzo, perché si fa su una copia dei file.
Questa è la mia lettura della tabella: la riga della copia abliterated è l’unica che nessuna misura lato fornitore può raggiungere, in linea con il punto di AISI secondo cui quelle misure non si applicano una volta che i pesi sono pubblici.
I numeri sono solo di Anthropic, che nei suoi test riassume così: gli attaccanti possono aggirare le salvaguardie di GLM-5.3 «tra il 64% e il 100% delle volte con tecniche semplici». La simulazione completa, compreso come sono stati costruiti i campioni, è esposta nel mio confronto dei test di AISI, CAISI e Anthropic.
Chi dice cosa, e che cosa ha in gioco ciascuna fonte
Le fonti concordano su un principio, e solo Anthropic fornisce numeri sull’abliteration. Questa tabella tiene visibile l’interesse di ciascuna fonte accanto alla sua affermazione:
| Fonte | Cosa dice | Cosa tenere a mente |
|---|---|---|
| Arditi et al., 2024 (studio su arXiv) | Il rifiuto è mediato da una sola direzione in 13 modelli di chat aperti; il fine-tuning di sicurezza è fragile | Modelli fino a 72 miliardi di parametri; l’abstract non usa la parola «abliteration» |
| UK AISI | Una volta pubblici i pesi, monitoraggio, classificatori e blocco degli utenti non si possono applicare in modo universale; l’addestramento al rifiuto è spesso facilmente reversibile | Ente di test governativo; il suo post ha testato GLM-5.2 e DeepSeek V4-Pro, non GLM-5.3, ha trovato le sue valutazioni «in gran parte non ostacolate dalle salvaguardie» e non riporta alcun test di abliteration |
| CAISI (pagina su GLM-5.2) | Le salvaguardie dei modelli a pesi aperti possono essere aggirate quando il modello è self-hosted | Ente del governo USA; è un’avvertenza sulla sua pagina su GLM-5.2, mentre la pagina su GLM-5.3 riporta risultati di benchmark cyber e non menziona l’abliteration |
| Anthropic | Tasso medio di rifiuto dal 95% al 6% dopo la modifica; costo di circa 4.400 dollari | Non rilascia i propri pesi; CSA dice che le sue cifre «meritano lo stesso vaglio di quelle di qualunque parte interessata» e non sono state replicate |
| Cloud Security Alliance | «Le salvaguardie sembrano non sopravvivere al self-hosting» | Poggia sulle cifre di Anthropic per un solo modello; l’estensione ai sistemi a pesi aperti in generale è un’inferenza di CSA |
| The Decoder (testata giornalistica) | L’allarme di Anthropic «serve anche al suo business», e la valutazione di CAISI conferma le cifre sulle capacità | Riferisce sugli altri e non ha fatto alcun test; CSA dice che l’impostazione cyber di Anthropic «è in tensione con» la valutazione «significativamente inferiore» di CAISI |
Lette insieme, le fonti concordano in termini generali che i pesi pubblici tolgono al fornitore il controllo e che i rifiuti integrati sono la parte debole. Solo Anthropic ha misurato quanto siano deboli, e solo su GLM-5.3 e GLM-5.3-Flash. The Decoder osserva che Anthropic non rilascia i propri pesi e che un modello a pesi aperti economico e vicino alla frontiera «è anche un concorrente diretto».
AISI è diretta anche sull’altro lato. I modelli a pesi aperti, scrive, hanno benefici reali: si possono ospitare in privato senza che i dati tornino al fornitore, adattare a compiti specifici e usare al solo costo del calcolo. Offrono anche una base affidabile che il fornitore non può cambiare né ritirare.
La mia lettura: il principio è affermato in termini generali da uno studio del 2024 e da entrambi gli enti governativi, mentre la misura dell’effetto su GLM-5.3 poggia su un solo rapporto di Anthropic. CSA e The Decoder riprendono quel rapporto, e nessuno dei due enti governativi ha testato l’abliteration.
Quanto costa
Il costo è la parte della storia che controllerei con più attenzione, perché decide quante persone potrebbero farlo. Ecco le cifre presenti nelle fonti, ciascuna con il suo titolare:
- Il primo tentativo di Anthropic su GLM-5.3. Circa 2.200 ore di GPU per un costo di calcolo di circa 4.400 dollari, da parte di un gruppo che non aveva mai usato la tecnica. Un’ora di GPU è un’ora di lavoro di un processore grafico, i chip su cui girano i modelli di IA. Con un mio calcolo, sono circa 2 dollari per ora di GPU.
- Il modello più piccolo. Abliterare GLM-5.3-Flash ha richiesto circa 600 ore di GPU. Anthropic non dà una cifra in dollari.
- Un gruppo esperto. Anthropic stima che un gruppo esperto della tecnica, partendo da zero su questo modello, avrebbe bisogno di una cifra più vicina a 600 ore di GPU, cioè 1.200 dollari.
- Dove sono andate le ore. Anthropic scrive che la maggior parte delle 2.200 ore è servita a esplorare varianti in parallelo e a verificare le capacità del modello dopo le modifiche.
- Tutto il resto. Il tempo delle persone, l’hosting e il costo di ciò che si fa con la copia modificata non compaiono in nessuna fonte che ho letto.
Anthropic è l’unica fonte che dà un numero, e viene da un gruppo, un modello e un rapporto. CSA dice che il rifiuto «può essere rimosso con una somma modesta», e CSA e The Decoder riprendono le cifre di Anthropic.
Secondo queste cifre, abliterare un modello di queste dimensioni ha richiesto migliaia di dollari di calcolo, e questo sposta la questione aperta da se qualcuno potesse permetterselo a chi lo farebbe e perché. Non ho trovato una fonte che risponda.
La cifra di 1.200 dollari richiede una cautela a parte. È una stima per un ipotetico gruppo esperto, data in una nota, e Anthropic non l’ha misurata.
Cosa cambia per un’azienda che usa modelli aperti
Il meccanismo e il costo portano a una conseguenza pratica. Per un modello a pesi aperti, tratto i rifiuti di chi lo ha creato come un’impostazione predefinita, perché le fonti non danno motivo di promettere che sopravvivano nella copia di qualcun altro. CSA arriva alla stessa conclusione per le aziende: quando il sistema è a pesi aperti, non dovrebbero «trattare le salvaguardie di un fornitore di modelli come un controllo primario contro l’abuso da parte di altri».
Due tipi di azienda si trovano di fronte a questo in modo diverso:
- Un’azienda che fa girare un modello a pesi aperti sui propri server, spesso per il motivo di privacy che elenca AISI, possiede una copia dei pesi che conta come un asset. Il secondo livello, il monitoraggio e le approvazioni attorno al modello, è ciò che l’azienda costruisce, e il consiglio di CSA è di fare l’inventario di tali modelli e di «trattare i pesi dei modelli come asset sensibili».
- Un’azienda che usa l’IA solo tramite un servizio vede la questione dell’abliteration come una domanda su ciò che altri fanno con le copie aperte. La domanda più utile è che cosa possono raggiungere i suoi agenti e a che cosa un estraneo potrebbe convincere un agente, per esempio nascondendo istruzioni in una pagina web o in un’email che l’agente legge, tema che tratto in sicurezza degli agenti IA.
Un esempio inventato: un’agenzia di design di 12 persone fa girare un modello a pesi aperti sul proprio server, in modo che i file dei clienti non lascino mai la sede, che è il primo beneficio indicato da AISI. Un agente su quel server legge le email in arrivo dei clienti e prepara le risposte. I rifiuti integrati nel modello sono un primo livello, e l’agenzia aggiunge quello che controlla: l’agente può leggere solo la cartella della posta in arrivo, e nulla di ciò che prepara viene inviato senza l’approvazione di una persona.
Ora supponi che qualcuno dell’agenzia sostituisca il modello con una copia modificata che risponde più liberamente. I rifiuti integrati non ci sono più, ma l’agente continua a leggere solo la cartella della posta in arrivo e ogni bozza in uscita aspetta ancora una persona. In questa situazione inventata i due limiti continuano ad applicarsi, anche se nessuna fonte verifica che reggano, e una bozza che sfugge a un approvatore di fretta resterebbe comunque una via d’uscita per le informazioni.
CSA raccomanda la stessa direzione alle aziende con accesso a strumenti: rivederlo «partendo dal presupposto che le salvaguardie basate sul rifiuto non reggano sotto prompt avversari», cioè prompt scritti per ingannare il modello. Descrivo il passaggio di approvazione in human in the loop: la verifica del lavoro dell’IA, e la configurazione che uso per gli agenti in agenti IA per il marketing.
Non leggerei nulla di tutto questo come un argomento contro i modelli a pesi aperti. AISI stessa indica benefici che contano per un’azienda che tiene i dati dei clienti in casa, e quanto costa farne funzionare uno è il tema del mio articolo sul costo di un LLM self-hosted. La conseguenza che ne traggo è più ristretta: scelgo il modello per qualità e prezzo, e costruisco io stesso i controlli di sicurezza attorno.
Cosa non si sa
Le fonti lasciano aperte queste domande:
- Replica. CSA dice che CAISI e AISI non hanno replicato le cifre di Anthropic. I test pubblicati da AISI riguardavano GLM-5.2 e DeepSeek V4-Pro, e ogni cella della simulazione di attacco di Anthropic poggia su 50 campioni.
- Cosa mostra la simulazione. Poiché non esegue codice, osserva The Decoder, mostra che cosa il modello tenta di fare e non può mostrare se un attacco sarebbe riuscito.
- Dimensioni e metodo. Lo studio del 2024 ha testato modelli fino a 72 miliardi di parametri, mentre la pagina di Hugging Face per GLM-5.3 ne indica 753 miliardi. Anthropic ha abliterato GLM-5.3 da sé e rimanda allo studio per la tecnica, ma non posso verificare quanto i due metodi coincidano.
- Uso nel mondo reale. Non ho trovato cifre su quanto spesso si usino i modelli abliterated, né su eventuali danni che ne siano seguiti.
- La legge. Se modificare, condividere o usare tali copie sia lecito è una domanda per un consulente legale, e qui non do consigli legali.
Una lista di controllo prima di usare o acquistare un modello aperto
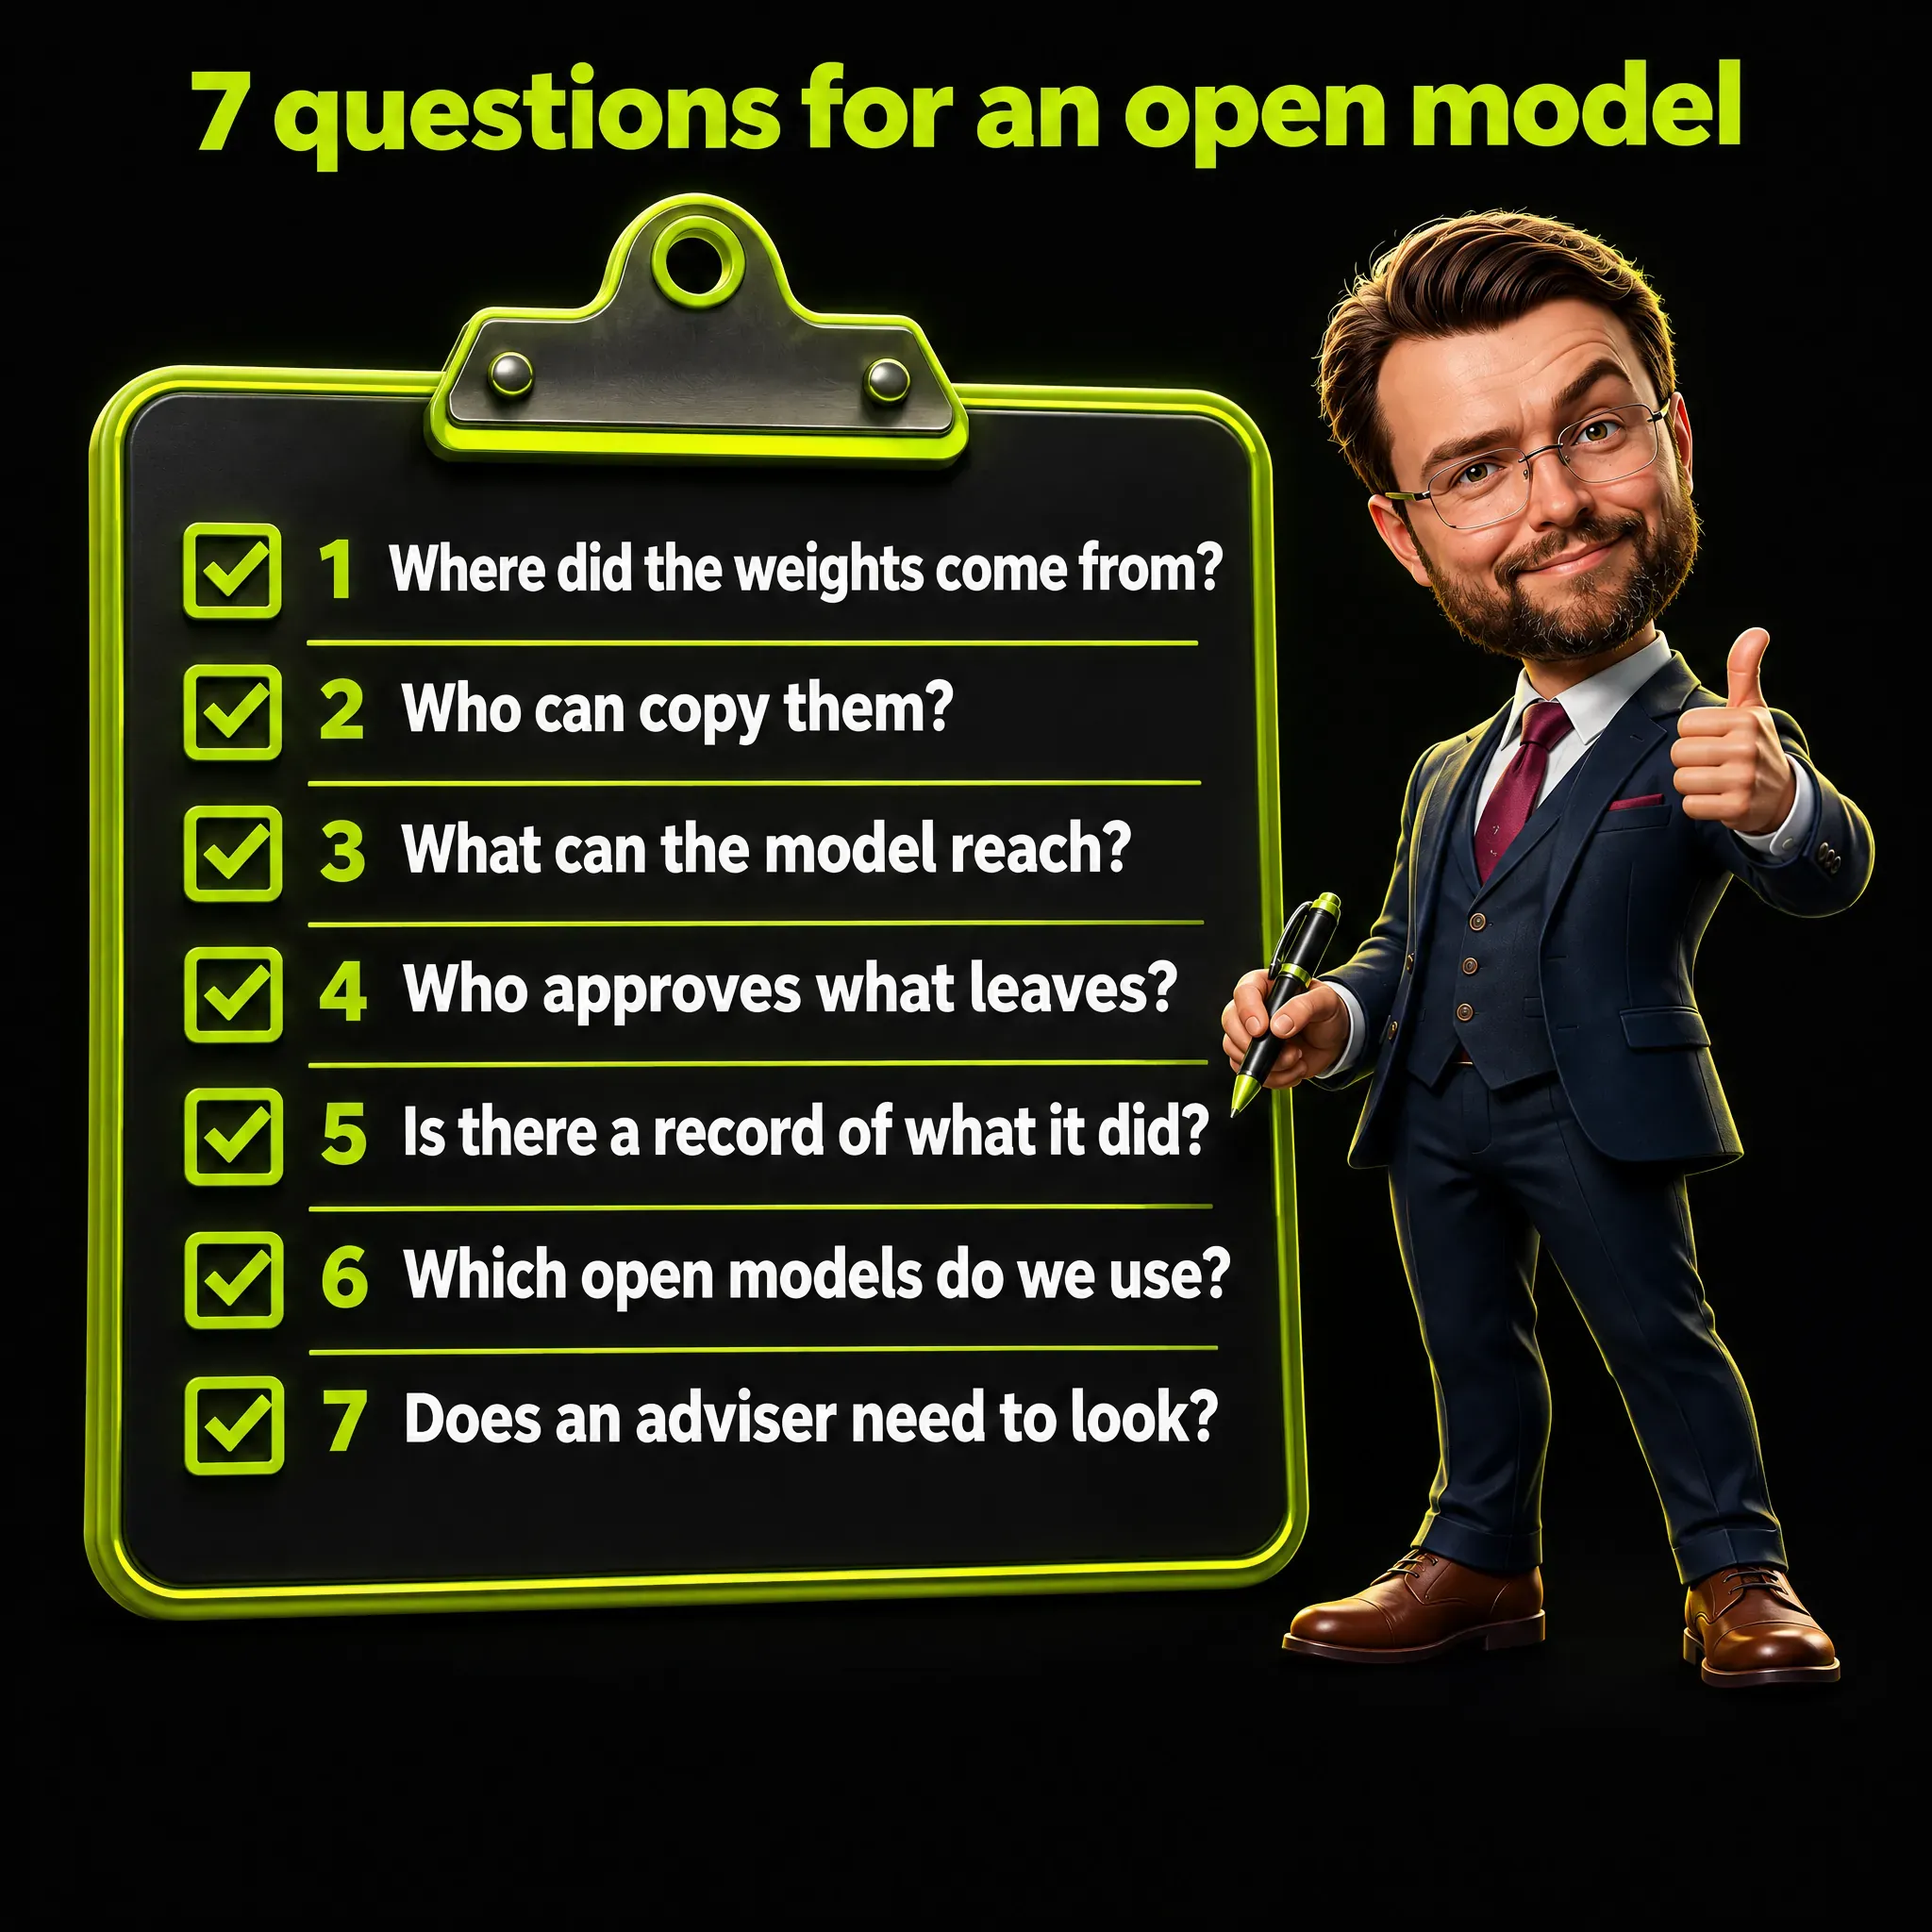
Questa tabella trasforma le fonti in domande che un manager non tecnico può porre a un fornitore o a un team IT:
| Domanda | Perché conta | Cosa chiederei |
|---|---|---|
| Da dove vengono i pesi? | Anthropic dice che diversi sviluppatori hanno pubblicato versioni abliterated di GLM-5.3 | La pagina di chi ha creato il modello come fonte, messa per iscritto |
| Chi può copiare i pesi da noi? | CSA: trattare i pesi dei modelli come asset sensibili | Un responsabile indicato per nome e un breve elenco di chi ha accesso |
| Che cosa può raggiungere il modello? | CSA: presumere che le salvaguardie basate sul rifiuto non reggano | Un elenco degli account, delle cartelle e degli strumenti che il modello può usare |
| Chi approva le azioni che escono dall’azienda? | CSA: le salvaguardie di un fornitore non dovrebbero essere il controllo primario | Una persona che approva tutto ciò che viene inviato all’esterno |
| Esiste una traccia di ciò che ha fatto il modello? | AISI: il monitoraggio lato fornitore non si può applicare in modo universale ai pesi pubblici | Log (registri delle attività) che qualcuno legge |
| Quali modelli a pesi aperti usiamo già? | CSA: farne l’inventario | Un elenco con responsabile, scopo e fonte di ciascuno |
| Serve che un consulente se ne occupi? | Licenza e dati personali sono questioni legali | Una breve nota del consulente legale o della protezione dei dati |
Domande frequenti
Che cos’è l’abliteration?
L’abliteration è una tecnica che toglie i rifiuti di un modello modificandone i pesi pubblicati, come descritto nell’apertura di questo articolo. Anthropic usa la parola per «una tecnica standard di riduzione del rifiuto» e rimanda allo studio del 2024 di Arditi e coautori.
Che cos’è un modello abliterated?
È una copia di un modello a pesi aperti da cui è stato eliminato con una modifica il comportamento di rifiuto. Anthropic ne ha creata una di GLM-5.3 per metterla alla prova e dice che altri sviluppatori ne hanno pubblicate «entro pochi giorni dal rilascio del modello».
Come funziona l’abliteration?
Lo studio del 2024 che Anthropic cita ha trovato che nei 13 modelli di chat aperti che ha testato il rifiuto è mediato da una sola direzione all’interno del modello. Eliminare quella direzione ferma i rifiuti e lascia le altre capacità in gran parte com’erano.
L’abliteration è lo stesso che il jailbreak?
Un jailbreak nel senso comune è un prompt che convince un modello a obbedire, e lavora dall’esterno. L’abliteration cambia i file del modello, e per questo serve una copia dei pesi. Lo studio del 2024 chiama il suo metodo un «white-box jailbreak», quindi i due termini si sovrappongono.
Si può abliterare Claude?
Anthropic dice di no, perché i suoi pesi non sono forniti agli utenti. Per lo stesso ragionamento un modello i cui pesi non sono pubblicati non si può modificare così, a meno che i pesi non escano; è una mia inferenza. CSA indica come rischio per le copie interne delle aziende i pesi sottratti (copiati all’esterno senza permesso), e non ho trovato alcun test su altri modelli chiusi.
L’abliteration rende un modello meno capace?
Anthropic riporta lo stesso punteggio su GPQA-Diamond e qualche percento in meno su un sottoinsieme di CyberGym. Lo studio del 2024 riporta un effetto minimo sulle altre capacità.
Quanto costa l’abliteration?
Anthropic riporta circa 2.200 ore di GPU e circa 4.400 dollari per il primo tentativo su GLM-5.3, e stima circa 1.200 dollari per un gruppo esperto. CSA e The Decoder riprendono queste cifre, e nessun test indipendente le ha confermate.
Un’azienda dovrebbe evitare i modelli a pesi aperti?
Io no, in base a queste fonti, perché AISI elenca benefici reali come l’hosting privato e una base che il fornitore non può ritirare. Le fonti suggeriscono di trattare i pesi come un asset e di mettere i controlli di sicurezza attorno al modello.
Il mio punto di vista
Il nucleo della storia dell’abliteration è un principio: quando i file sono pubblici, i rifiuti di chi ha creato il modello sono un’impostazione predefinita che altri possono cambiare. Uno studio del 2024 l’ha provato su altri modelli, più piccoli, e AISI e CAISI lo affermano in termini generali.
La misura dell’effetto su GLM-5.3 poggia su un solo rapporto di Anthropic. CSA e The Decoder lo riprendono e nessun test indipendente lo ha confermato, perciò finché non arriva una replica di CAISI o AISI leggo le cifre come la misurazione di una sola azienda.
Per il mio lavoro questo cambia l’ordine delle mie domande. Prima chiedevo se un modello rifiuta le richieste dannose, ora chiedo che cosa può raggiungere il modello e chi approva ciò che fa, perché quelle risposte valgono qualunque sia il tasso di rifiuto.


