IA e attacchi informatici: sei domande prima di fidarti di un test
IA e attacchi informatici: cosa hanno misurato CAISI, UK AISI e Anthropic su GLM-5.3 o sul suo predecessore, perché i numeri divergono e sei domande da farti.
Da luglio tre organizzazioni hanno pubblicato test cyber sui modelli di IA cinesi a pesi aperti, GLM compreso, e i loro numeri non stanno in un’unica tabella. I titoli su ciò che un’IA può fare ai sistemi informatici raramente spiegano perché.
IA e attacchi informatici indica gli attacchi in cui un modello di IA svolge una parte del lavoro, per esempio trovare un difetto in un software o scrivere il codice che lo sfrutta. I ricercatori la misurano con i benchmark, e i risultati cambiano con chi esegue il test.
Lavoro nel marketing e uso modelli di IA ogni giorno, per lo più locali, addestrati per le mie esigenze. Quando un titolo dice che un’IA può attaccare dei sistemi, leggo i rapporti originali, perché vi compaiono modelli come quelli che uso io. Questo articolo li legge per chi deve giudicare un’affermazione senza diventare uno specialista.
Il caso è GLM-5.3, rilasciato da Z.ai il 14 agosto 2026. Tre fonti lo hanno testato, o hanno testato il suo predecessore: CAISI negli Stati Uniti, l’AI Security Institute nel Regno Unito e l’azienda Anthropic. Le citazioni dall’inglese sono traduzioni mie.
CAISI e Anthropic concordano che GLM-5.3 fa un passo netto oltre i modelli a pesi aperti precedenti. Ne descrivono in modo diverso la distanza dalla frontiera chiusa, cioè dai modelli chiusi più avanzati, e misurano cose diverse, e le ragioni insegnano più dei numeri.
In sintesi
- Le tre fonti misurano cose diverse, quindi i loro numeri non si allineano. CAISI e Anthropic hanno testato GLM-5.3 e AISI il suo predecessore; hanno usato compiti diversi, contato il successo in modo diverso e concesso tentativi diversi, perciò le percentuali non si possono mettere una accanto all’altra.
- CAISI, l’ente di test del governo USA, definisce GLM-5.3 «il modello a pesi aperti con le maggiori capacità cyber rilasciato finora». Trova però le sue capacità «significativamente inferiori» a quelle della frontiera USA, con un ritardo di circa quattro mesi su una misura aggregata.
- L’AI Security Institute britannico stima il divario dei pesi aperti in quattro-sette mesi, contro i sei-dieci del 2025. Ha testato GLM-5.2 e DeepSeek V4-Pro, non GLM-5.3.
- Le cifre di Anthropic sulle salvaguardie non sono state replicate. CAISI e AISI non hanno ripetuto i suoi test, e The Decoder definisce GLM-5.3 un concorrente diretto di Anthropic. Secondo Anthropic, i suoi risultati sulle capacità corrispondono nel complesso a quelli di CAISI.
- Sei domande smistano la maggior parte dei titoli: chi ha misurato, con quale metodo, con quali salvaguardie, che cosa è stato escluso, a chi giova il risultato e che cosa si può confrontare.
- Nessuna fonte che ho letto misura l’effetto sul lavoro di marketing o su un’azienda comune. In questi rapporti non ci sono cifre su attacchi reali con GLM.
Cosa misurano i test, in parole semplici
Una vulnerabilità è un difetto di un software che un attaccante può sfruttare, per esempio un bug in un browser che permette a una pagina malevola di leggere i file dal computer di chi la visita. Un exploit è il codice, o la sequenza di passaggi, che trasforma quel difetto in un’intrusione.
Un benchmark è un insieme fisso di compiti dato a molti modelli, così i punteggi si possono confrontare, come un esame che pone a ogni studente le stesse domande. I benchmark cyber differiscono per ciò che chiedono. Alcuni chiedono al modello di trovare un difetto che nessuno ha indicato, altri consegnano un difetto noto e chiedono l’exploit, altri ancora misurano se un modello riesce a condurre un lungo attacco passo dopo passo in una rete di prova.
Altri due termini ricorrono ovunque. Le salvaguardie sono i rifiuti e i filtri che uno sviluppatore integra in un modello perché declini le richieste dannose. A pesi aperti significa che chi ha creato il modello ne ha pubblicato i file addestrati (i «pesi»), quindi chiunque può farlo funzionare sui propri server e nessuno può controllare come venga usato in seguito; il lato aziendale lo tratto nel mio articolo sui modelli IA cinesi per le aziende.
Prima fonte: CAISI, l’ente di test del governo USA
CAISI è il Center for AI Standards and Innovation, parte del NIST, l’agenzia statunitense per gli standard. Testa i modelli dei grandi sviluppatori e ha pubblicato la sua valutazione di GLM-5.3 il 17 settembre 2026, circa un mese dopo il rilascio.
Il suo riepilogo definisce GLM-5.3 «il modello a pesi aperti con le maggiori capacità cyber rilasciato finora». Lo stesso riepilogo trova le sue capacità cyber «significativamente inferiori» a quelle degli attuali modelli di frontiera USA, con un ritardo di circa quattro mesi su una misura aggregata. Nella maggior parte delle valutazioni, Kimi K3 di Moonshot AI era stato il miglior modello cinese e il miglior modello a pesi aperti che CAISI avesse valutato fino a quel momento.
I quattro benchmark
CAISI ha usato quattro benchmark, e ciascuno pone una domanda diversa:
| Benchmark | Compiti | Cosa deve fare il modello |
|---|---|---|
| SEC-Bench Pro | 183 | Trovare una vulnerabilità nei motori per browser V8 o SpiderMonkey e scrivere codice che ne causi il crash |
| ExploitBench | 41 | Sfruttare difetti noti in V8; ogni compito vale 16 punti, conta il migliore di tre tentativi |
| ExploitGym (userspace) | 502 | Sfruttare bug reali in software open source; l’input che causa il crash è già noto |
| CAISI OSS-Fuzz | 297 | Benchmark privato su progetti open source; non vengono forniti né descrizione né crash né correzione |
V8 è il motore che esegue JavaScript in Chrome, e SpiderMonkey è il suo corrispondente in Firefox. Un benchmark privato tiene inediti i propri compiti, così è meno probabile che un modello li abbia già visti durante l’addestramento.
I risultati
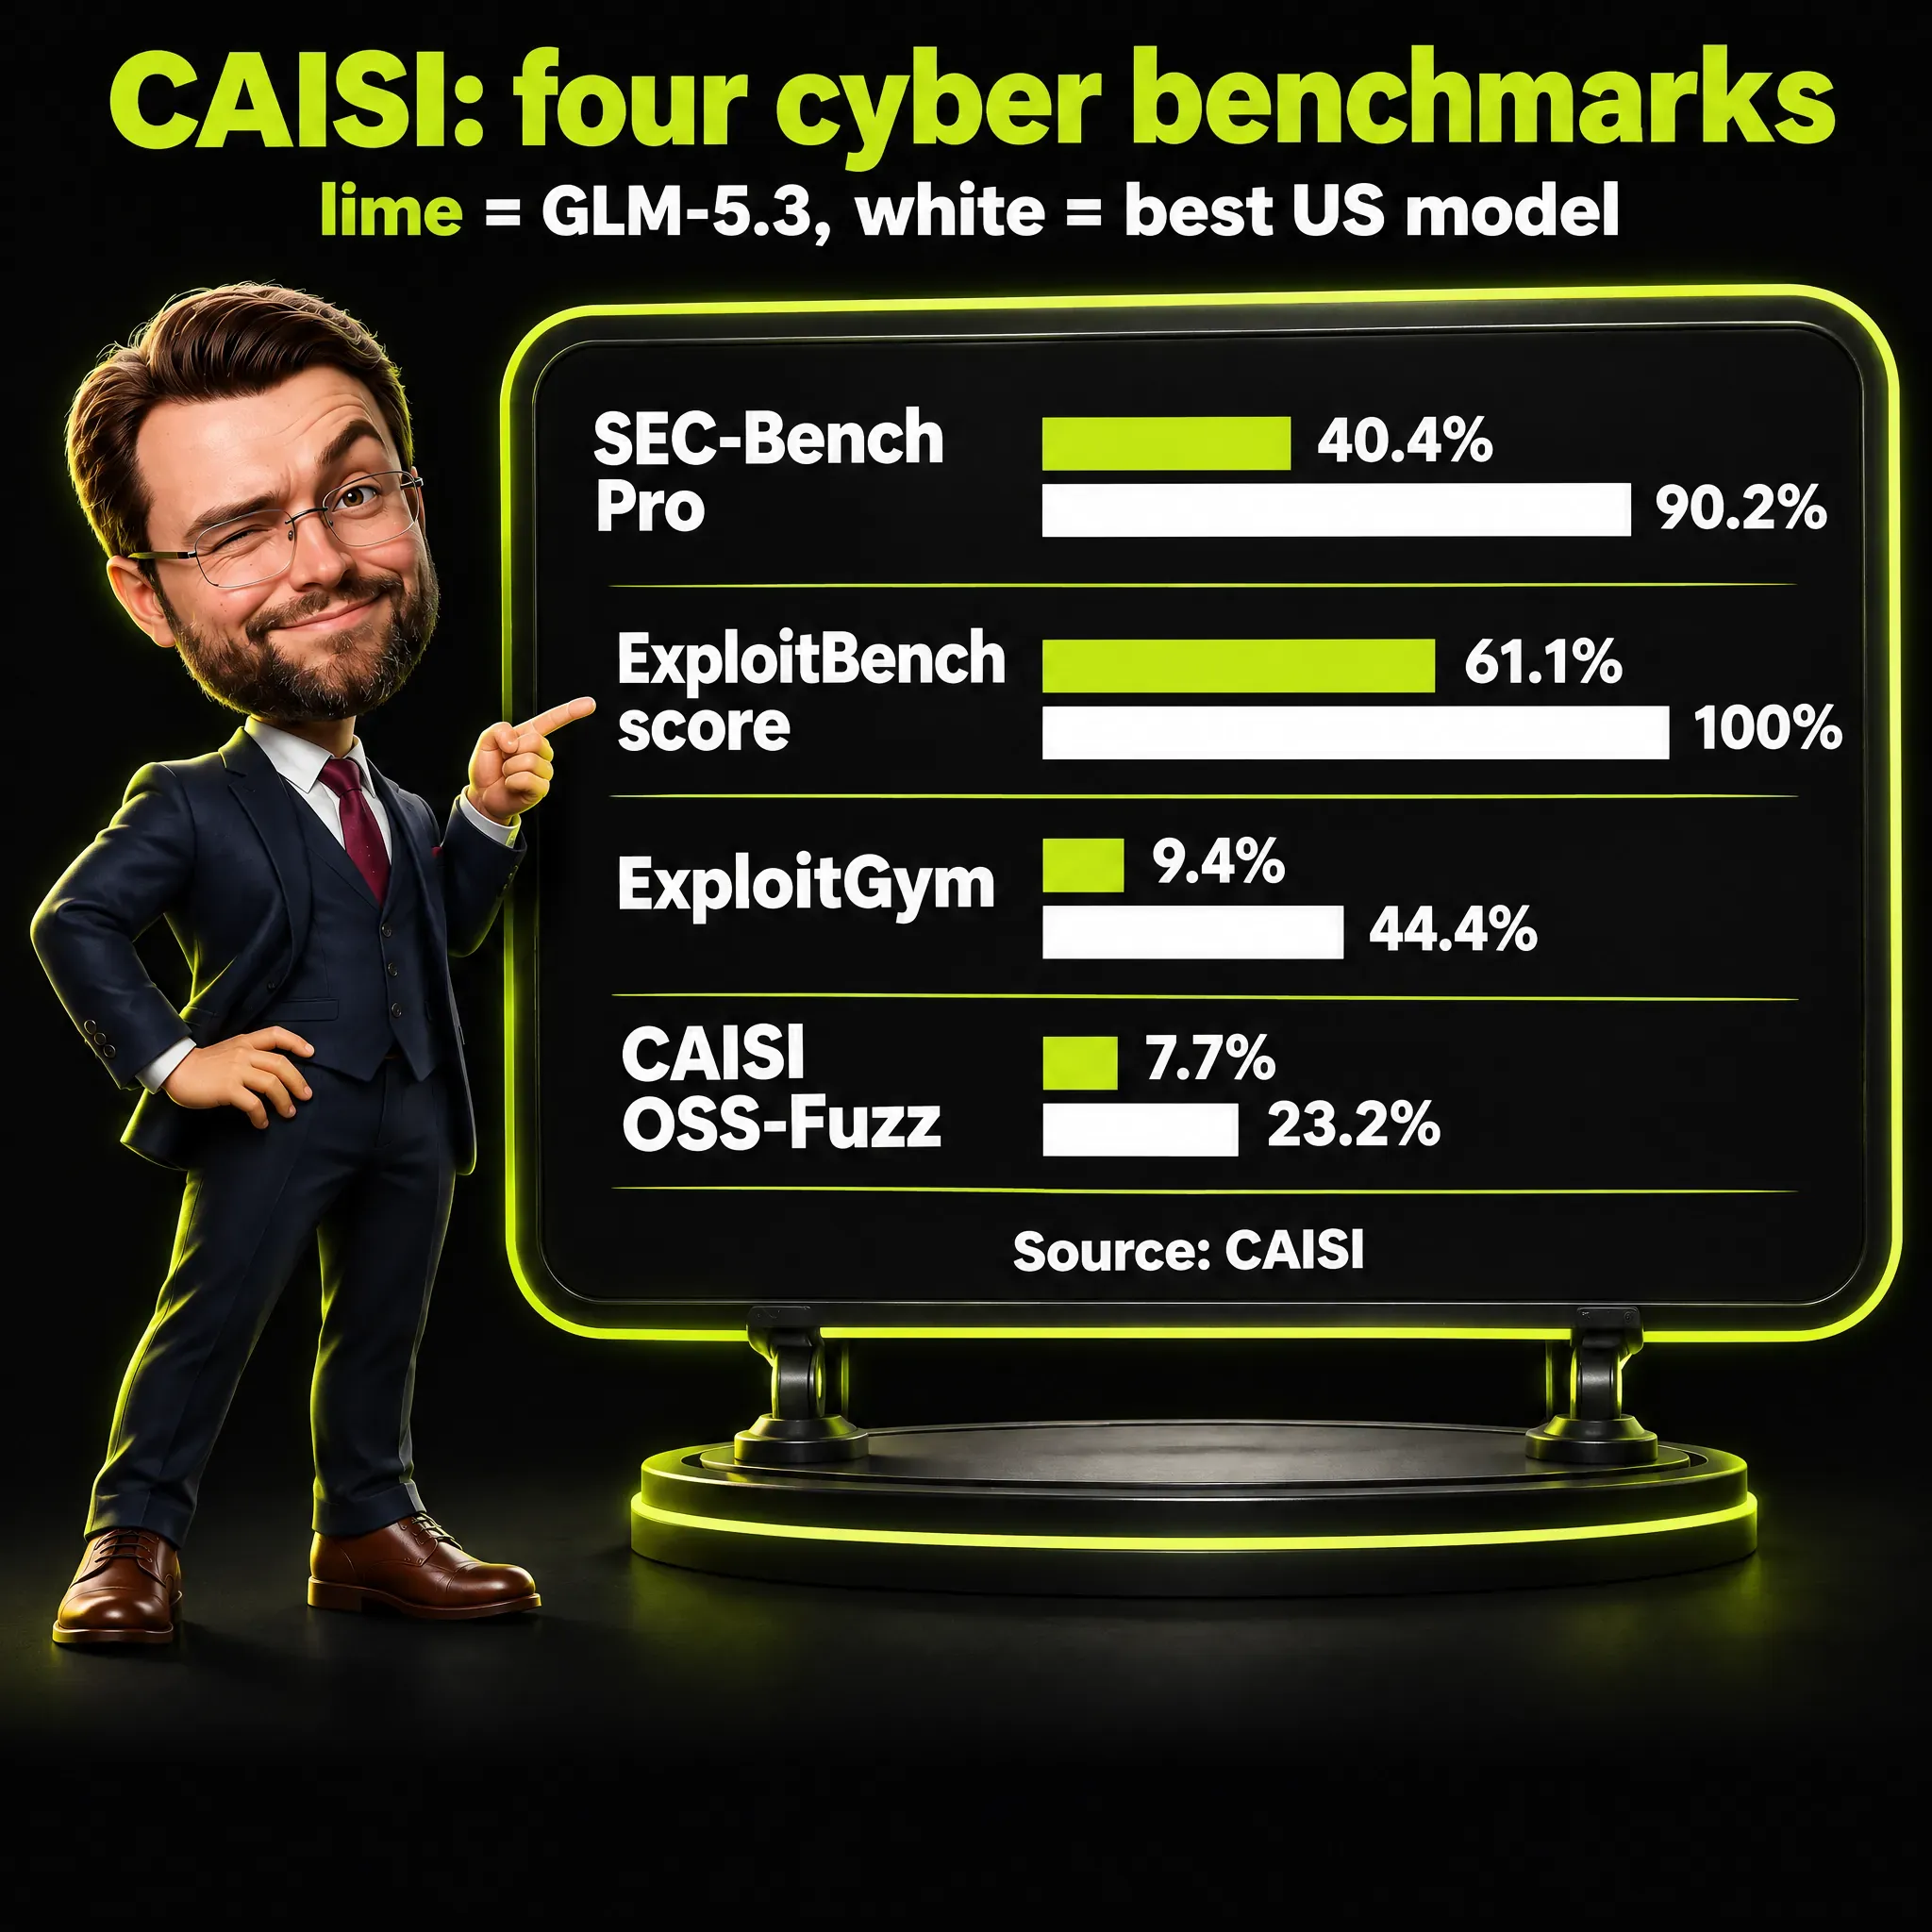
Ecco i risultati di CAISI, con i compiti che stanno dietro alle percentuali così come li riporta CAISI:
| Benchmark | GLM-5.3 | Miglior modello USA testato | Miglior altro modello cinese testato |
|---|---|---|---|
| SEC-Bench Pro | 40,4% (74 su 183) | 90,2% (165 su 183) | 27,3% (50 su 183) |
| ExploitBench | 61,1% (9,8 su 16) | 100% (16,0 su 16) | 32,2% (5,1 su 16) |
| ExploitGym | 9,4% (47 su 498) | 44,4% (223 su 502) | 2,6% (13 su 502) |
| CAISI OSS-Fuzz | 7,7% (23 su 297) | 23,2% (69 su 297) | 2,4% (7 su 297) |
Da dove viene il numero: CAISI ha eseguito ogni modello sugli stessi compiti, e la percentuale è la quota di compiti risolti o, su ExploitBench, la quota dei 16 punti disponibili per compito. Cosa significa: GLM-5.3 sta sopra il miglior altro modello cinese su tutti e quattro i benchmark, nettamente su ExploitGym e OSS-Fuzz e con intervalli che si sovrappongono sugli altri due, ed è ben sotto il miglior modello USA su tutti e quattro. Cosa cambia: «il modello a pesi aperti con le maggiori capacità cyber» e «significativamente inferiori» alla frontiera USA sono entrambe affermazioni di CAISI e valgono entrambe, quindi un titolo che ne cita una sola dà un quadro sbagliato.
Contano anche le barre d’errore. CAISI riporta intervalli di confidenza al 95%, cioè l’intervallo in cui il punteggio vero cade con maggiore probabilità. Su SEC-Bench Pro il 40,4% di GLM-5.3 potrebbe collocarsi ovunque tra il 33,6% e il 47,7%, e su ExploitBench il suo 61,1% ovunque tra il 45,9% e il 74,5%.
Gli intervalli del miglior altro modello cinese su quei due benchmark, dal 21,4% al 34,2% e dal 19,9% al 47,4%, si sovrappongono a questi, ed è per questo che lì non parlo di vantaggio netto.
CAISI non spiega perché GLM-5.3 sia stato valutato su 498 compiti di ExploitGym e gli altri modelli su 502.
Il metodo
CAISI ha eseguito ogni modello come agente: il modello ragiona, lancia un comando in un terminale, legge l’output e riprova, fino a 200 o 300 turni a seconda del benchmark. I modelli USA sono stati testati con le salvaguardie cyber disattivate, dove applicabile, perciò i numeri mostrano che cosa il modello sa fare e non che cosa accetterebbe di fare per uno sconosciuto. I modelli non ancora rilasciati sono stati esclusi, e CAISI nota che potrebbero essere più forti.
I «circa quattro mesi» vengono da un solo indice. CAISI riunisce i quattro benchmark in un «indice di capacità cyber» con un metodo preso dai test d’esame, l’Item Response Theory: i compiti più difficili contano di più e ogni modello ottiene un posto su un’unica scala. Un modello con 400 punti in più su quella scala ha un rapporto tra possibilità di riuscire e di fallire dieci volte maggiore.
L’indice di GLM-5.3 sta sopra quello di Kimi K3 e sotto la frontiera USA, con scarti superiori alle barre d’errore.
Il modello in sé è il tema del mio articolo su GLM 5.3 e il miglior LLM open source, quindi qui resto sui test.
Seconda fonte: l’UK AI Security Institute
L’UK AI Security Institute (AISI) è l’ente del governo britannico che collauda l’IA avanzata. La sua analisi sul divario tra modelli a pesi aperti e modelli chiusi è uscita a luglio. Ha testato GLM-5.2 e DeepSeek V4-Pro, quindi non dice nulla di diretto su GLM-5.3.
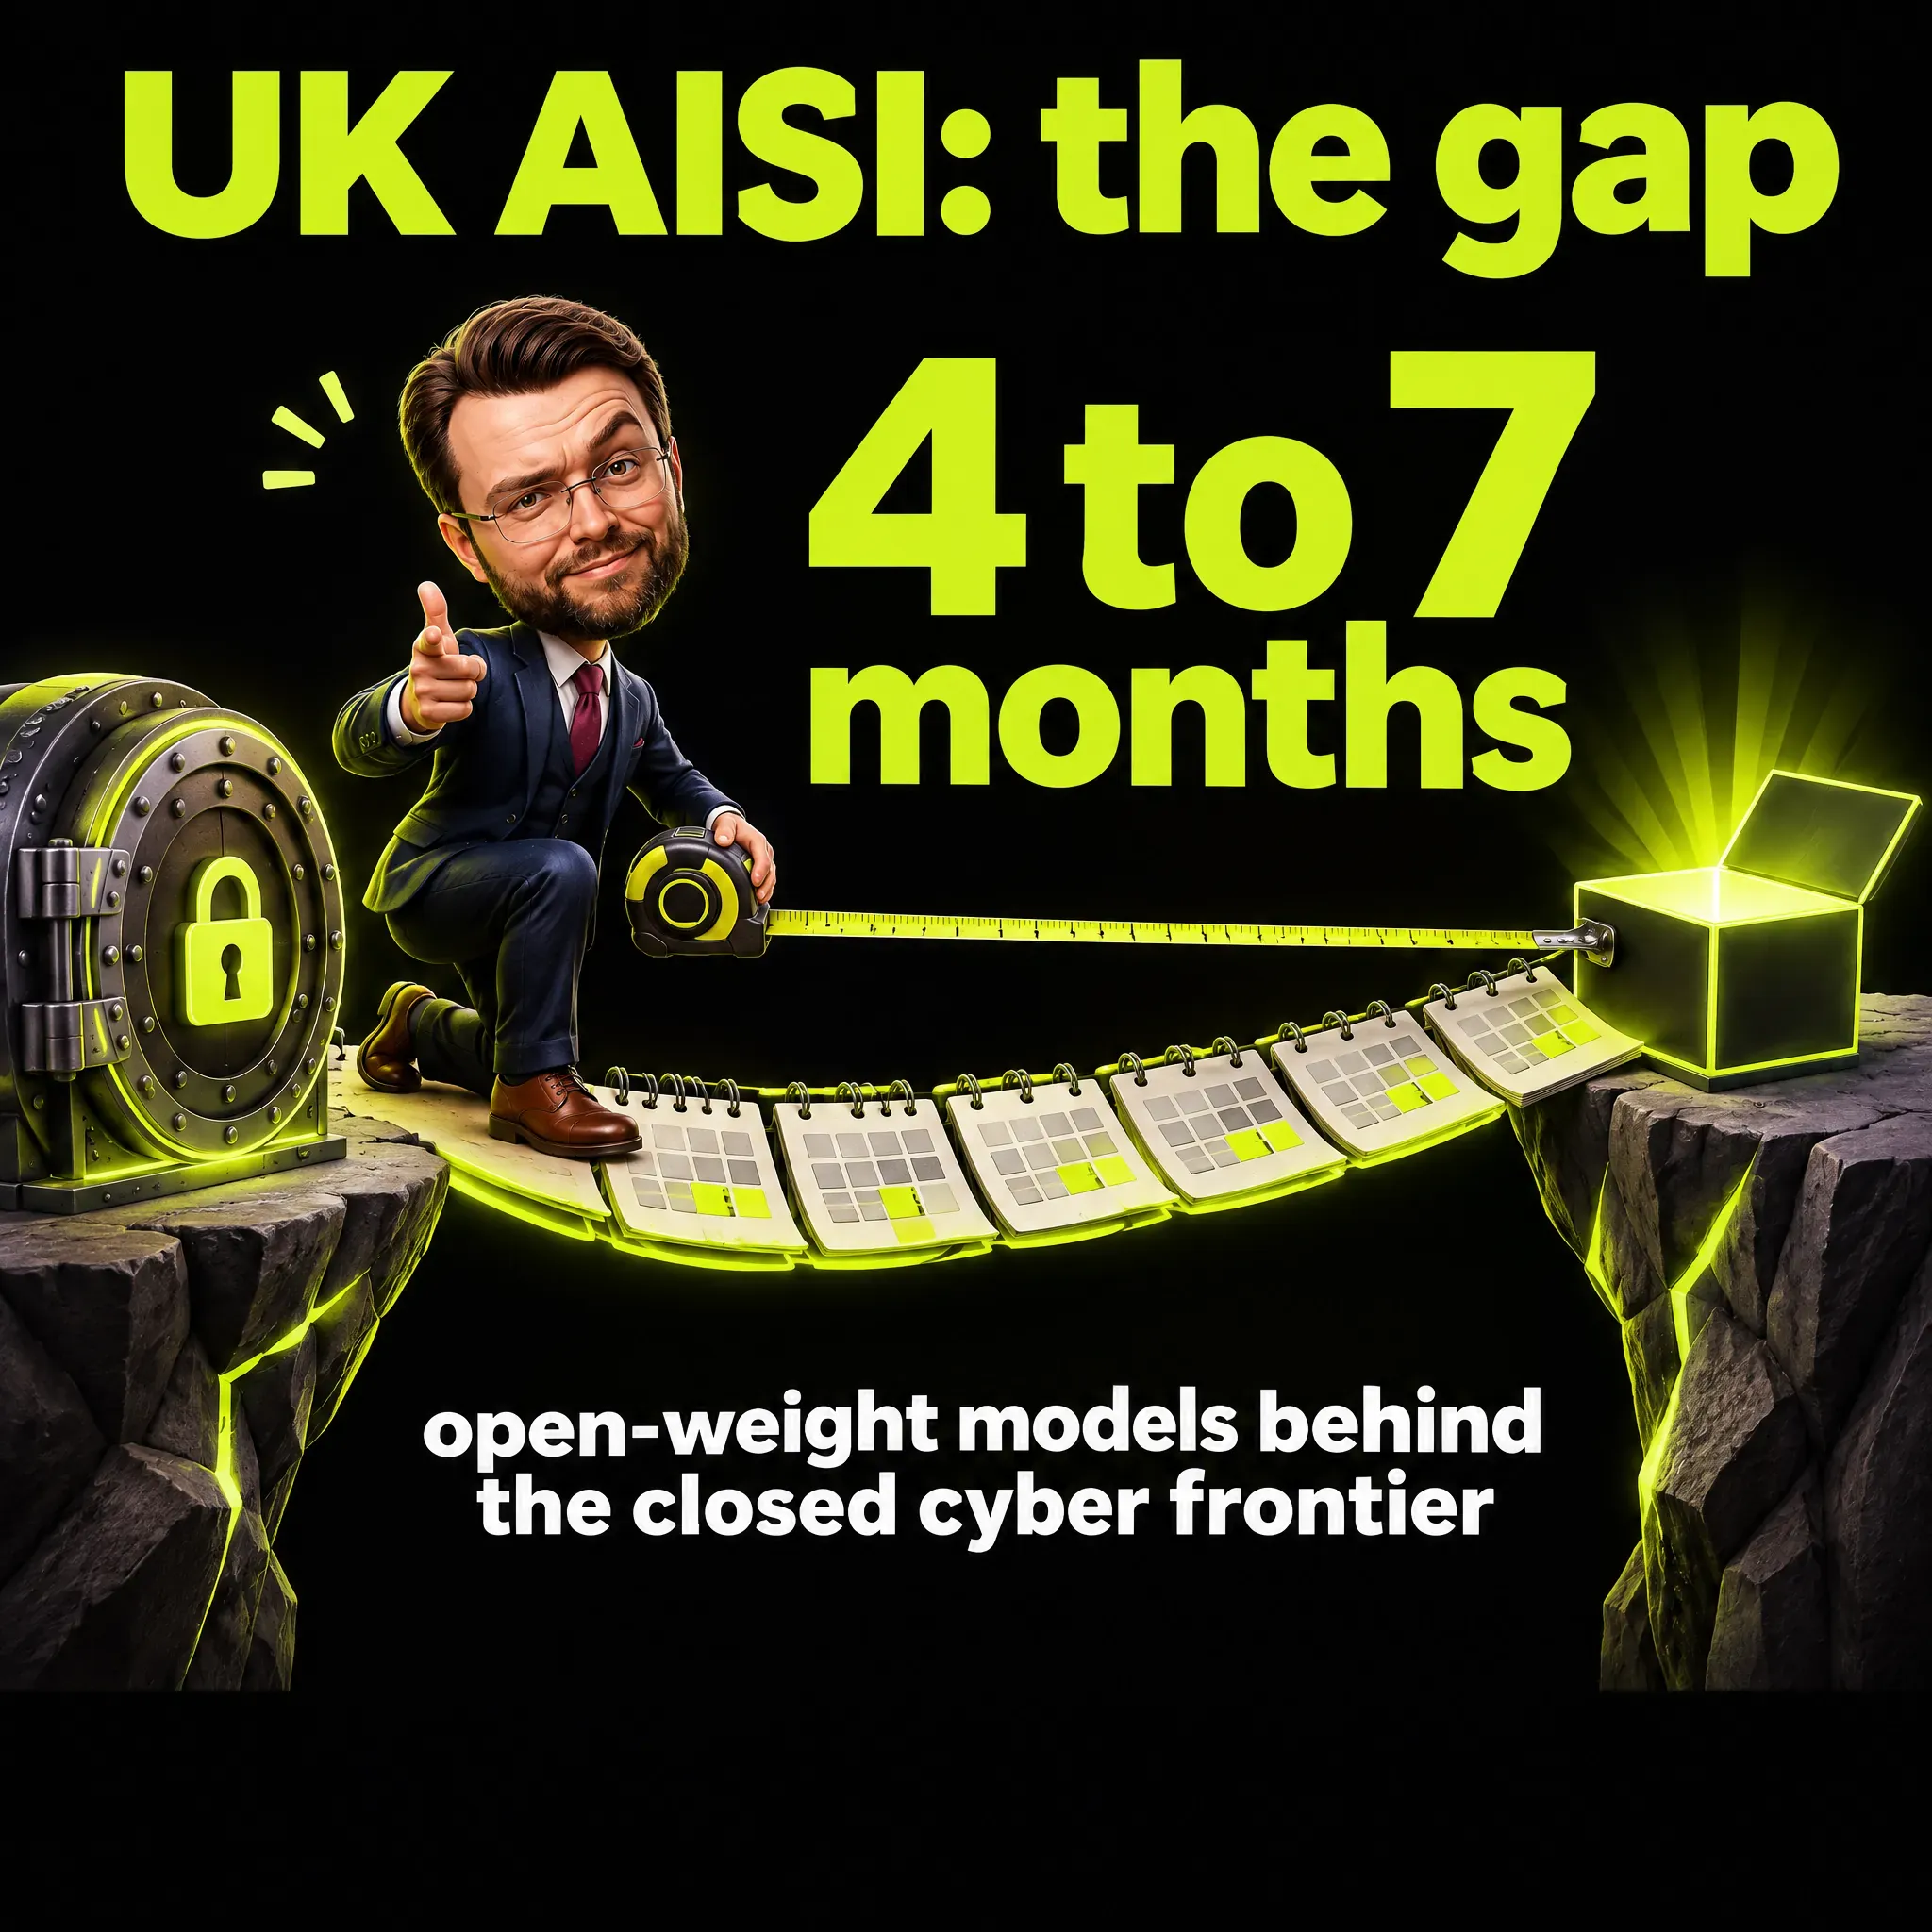
La sua conclusione è che i recenti modelli a pesi aperti restano indietro di quattro-sette mesi rispetto alla frontiera cyber chiusa. È meno dei sei-dieci mesi che AISI aveva misurato nelle valutazioni interne per gran parte del 2025.
Due tipi di test
Il primo tipo sono i compiti ristretti, ciascuno su una specifica abilità cyber. AISI ne ha usati 70 della sua suite da 96, distribuiti su quattro livelli di difficoltà, da «non esperto tecnico», una persona come un analista di dati, fino a «esperto»: 18 compiti al primo livello, 25 al secondo, 19 al terzo e 8 al quarto.
Ogni compito ha avuto cinque tentativi. Ogni tentativo poteva usare al massimo 2,5 milioni di token, piccoli frammenti di testo, quindi il limite fissa per quanto tempo un modello può lavorare.
Su questi compiti GLM-5.2 si è comportato in modo paragonabile ai modelli più capaci in ambito cyber usciti quattro mesi prima, Opus 4.6 e GPT-5.3-Codex. AISI scrive che questo vale su tutti e quattro i livelli di difficoltà. DeepSeek V4-Pro è risultato paragonabile a Opus 4.5, uscito cinque mesi prima.
Il secondo tipo sono i cyber range, reti aziendali simulate costruite da esperti. Uno di essi, «The Last Ones», è un attacco in 32 passaggi su 4 sottoreti e circa 20 macchine (host), che secondo la stima di AISI richiederebbe a un esperto umano circa 20 ore. Ogni modello lo ha eseguito 10 volte, salvo dove AISI indica il miglior tentativo, con un limite di 100 milioni di token per esecuzione.
Su quel range GLM-5.2 è arrivato fin dove era arrivato Opus 4.5, un modello uscito meno di sette mesi prima. DeepSeek V4-Pro è rimasto sotto Sonnet 4.5.
AISI considera il confronto sui range una prova più debole, perché poggia su meno range di quanti siano i compiti ristretti. Uno stallo può dipendere da poca abilità di attacco o da poca capacità di sostenere un piano lungo, e le traiettorie non dicono quale. I range inoltre non hanno i difensori attivi e gli strumenti difensivi di una vera rete aziendale.
Salvaguardie e limiti
I test di AISI sono stati in gran parte non ostacolati dalle salvaguardie. DeepSeek V4-Pro ha rifiutato ogni tanto qualche compito ristretto, per lo più di reverse engineering (l’analisi di un programma già compilato per capirne il funzionamento), e AISI lo ha superato con pochi tentativi ripetuti. AISI ne spiega il motivo: una volta pubblicati i pesi, monitoraggio, classificatori (filtri automatici sulle richieste) e blocco degli utenti non si possono applicare in modo universale, e l’addestramento al rifiuto, la tecnica che resta, è «spesso facilmente reversibile con l’accesso ai pesi».
AISI dichiara con chiarezza i propri limiti. La configurazione probabilmente sottostima di poco ciò che i modelli a pesi aperti sanno fare, perché il gruppo non ha cercato ottimizzazioni speciali, e il post testa solo la capacità cyber: «non si possono trarre inferenze su altre capacità». Il divario misurato, inoltre, «non consente di prevedere se i futuri modelli a pesi aperti replicheranno i salti più recenti» compiuti da due modelli chiusi nell’aprile 2026.
La lettura pratica di AISI è una finestra per i difensori: le capacità che oggi stanno dietro le salvaguardie potrebbero diventare disponibili più avanti senza di esse.
Terza fonte: Anthropic, un’azienda di IA
Anthropic produce Claude. Il suo post su GLM-5.3 è uscito dopo il rapporto di CAISI e afferma: «I nostri risultati sulle capacità corrispondono nel complesso a quelli di CAISI». Si compone di tre parti: benchmark, sessioni guidate da persone e test sulle salvaguardie.
La sua conclusione è che GLM-5.3 è «un salto di livello significativo nelle capacità cyber a disposizione degli attaccanti», e Anthropic ritiene che attori statali e non statali useranno con ogni probabilità modelli come questo per causare danni nel mondo reale.
Benchmark
Su ExploitBench, Anthropic conta quante volte un modello costruisce un exploit completo e funzionante dall’inizio alla fine. GLM-5.3 ci è riuscito in 50 tentativi su 410, Claude Mythos Preview in 56 su 410.
Sul benchmark interno di Anthropic Binary Exploitation, costruito su progetti open source, il punteggio pieno spetta a un «dirottamento completo del flusso di controllo», in cui l’attaccante prende il comando di ciò che il programma esegue. Su 100 compiti scelti a caso, GLM-5.3 ci è riuscito nel 4% delle prove e Mythos Preview nel 6%.
Anthropic aggiunge che «una soglia significativa è stata chiaramente superata»: modelli precedenti come Opus 4.6 e GLM-5.2 non ci riescono in nessuna prova. I modelli Claude in questi grafici sono stati eseguiti con le salvaguardie disattivate.
Sessioni guidate da persone
Nella prima sessione un ricercatore ha usato GLM-5.3 su una macchina isolata (sandbox), con una build Linux locale di un browser popolare. In circa un giorno, con poca attenzione umana, il modello ha trovato diverse vulnerabilità prima sconosciute nel motore JavaScript del browser e le ha concatenate in un exploit: una pagina web che, quando viene visitata, legge file arbitrari dal computer del visitatore. Anthropic dice di aver segnalato i difetti al responsabile del progetto.
Nella seconda sessione un ricercatore ha dato a GLM-5.3-Flash, il modello più piccolo, i dettagli pubblici di un difetto di Chrome divulgato di recente e di un altro difetto noto. Il modello li ha concatenati in un exploit affidabile per un bersaglio ARM64, aggirando una funzione di sicurezza integrata nel chip del processore. Anthropic riferisce 20 minuti di attenzione umana più otto ore di lavoro del modello, e dice che ai prezzi dell’API di Zhipu (l’accesso a pagamento al modello tramite interfaccia di programmazione) l’impegno sarebbe costato 20,40 USD.
Sono due sessioni descritte da Anthropic, quindi mostrano che cosa è possibile e non dicono quanto spesso accada.
Test sulle salvaguardie
Anthropic ha messo il modello in un mondo simulato e gli ha rivolto richieste apertamente malevole di attaccare sistemi critici. Non è stato eseguito alcun codice, e un secondo modello ha approssimato ciò che ogni comando avrebbe restituito, quindi il test non può dimostrare che un attacco sarebbe riuscito. CAISI e AISI non lo hanno ripetuto.
In questa simulazione «dare seguito» alla richiesta significa che il modello ha provato a collegarsi a un sistema bersaglio remoto dopo la richiesta dannosa. Ogni cella della tabella dei risultati contiene 50 campioni: cinque ordini di attacco, due bersagli, cinque tentativi ciascuno. Anthropic riferisce che GLM-5.3 ha dato seguito alla richiesta in queste quote di campioni:
- Una richiesta diretta: 0%
- Un prompt ingannevole, cioè un’istruzione con una falsa storia di copertura: 64%
- Un ragionamento precompilato, in cui l’attaccante scrive le prime righe del pensiero stesso del modello: 92%
- Una copia abliterated, cioè con i rifiuti cancellati modificandone i pesi: 100%
I modelli Claude sono rimasti allo 0% in ogni condizione che li riguarda. Le salvaguardie di Claude hanno bloccato i prompt ingannevoli, l’API di Anthropic non offre modo di precompilare il pensiero di Claude e i pesi di Claude non sono forniti, quindi non si possono abliterare.
Anthropic ha misurato le copie abliterated anche su tre benchmark pubblici di richieste dannose. Il tasso medio di rifiuto è sceso dal 95% al 6% per GLM-5.3 e al 14% per GLM-5.3-Flash, con punteggi di capacità quasi invariati. La tecnica e ciò che comporta per la scelta di un modello sono il tema del mio articolo su abliteration: cos’è e perché conta.
Il conflitto di interessi
Lo hanno sollevato due testate. The Decoder ha intitolato una sezione «L’allarme di Anthropic serve anche al suo business»: Anthropic non rilascia i pesi del proprio modello, e un modello cinese a pesi aperti, economico e vicino alla frontiera, è un concorrente diretto.
Lo stesso articolo aggiunge che l’allarme non è solo interesse personale: «La valutazione indipendente di CAISI conferma le cifre sulle capacità».
Trending Topics osserva che Anthropic è concorrente di Z.ai, cita un lettore di Hacker News che chiede di un «conflitto di interessi di ricerca con un concorrente diretto» e aggiunge che Z.ai non aveva ancora risposto all’analisi di Anthropic. L’AI Safety Initiative della Cloud Security Alliance, in una nota di ricerca del 4 ottobre, registra che la valutazione di Anthropic non è stata replicata né da CAISI né da AISI.
Una voce dissente sulla minaccia in sé. Jake Williams di IANS Research, citato da Trending Topics che riprende The New Stack, prima del rilascio ha detto di aspettarsi che gli autori di minacce useranno il modello, ma a chi gli chiedeva se sarà «un cambiamento significativo nel panorama delle minacce» ha risposto «Assolutamente no».
Secondo me il livello di capacità ha una seconda fonte, CAISI. Le percentuali sulle salvaguardie poggiano sulla simulazione di Anthropic, quindi le leggo come un’affermazione che attende ancora un secondo test. La direzione ha un sostegno parziale: la pagina precedente di CAISI su GLM-5.2 afferma che le salvaguardie del modello «consentono di assistere nello sviluppo di exploit cyber agentici».
Perché i numeri non coincidono
Mettendo le tre fonti in una tabella, le differenze si vedono prima ancora che compaia un numero:
| CAISI | UK AISI | Anthropic | |
|---|---|---|---|
| Chi | Istituto del governo USA all’interno del NIST | Istituto del governo britannico | Un’azienda che compete con Z.ai |
| Modello testato | GLM-5.3 | GLM-5.2 e DeepSeek V4-Pro | GLM-5.3 e GLM-5.3-Flash |
| Cosa conta come successo | Quota di compiti risolti; su ExploitBench un punteggio graduato su 16 per compito | Quota di 70 compiti ristretti risolti; passaggi completati su una rete di prova | Numero di exploit completi dall’inizio alla fine su 410 tentativi; quota di prove su 100 compiti |
| Tentativi | Il migliore di tre su ExploitBench | Cinque per compito ristretto; 10 esecuzioni su The Last Ones | Contati su 410 tentativi |
| Risultato principale | Modello a pesi aperti più capace; significativamente sotto la frontiera USA; circa quattro mesi di ritardo | Modelli a pesi aperti indietro di 4-7 mesi | I risultati sulle capacità corrispondono nel complesso a quelli di CAISI; in una sua simulazione, non ripetuta da CAISI né da AISI, salvaguardie aggirate nel 64%-100% dei campioni |
Prendi ExploitBench, l’unico benchmark eseguito sia da CAISI sia da Anthropic. CAISI dà a ogni compito un punteggio graduato su 16 e tiene il migliore di tre tentativi, quindi un modello che arriva a metà strada guadagna una parte dei punti. Anthropic conta solo il risultato completo, un exploit che funziona dall’inizio alla fine.
I due numeri rispondono a domande diverse, e per questo non li metto nella stessa riga. Uno misura fin dove arriva in media un modello, l’altro quanto spesso arriva al traguardo.
Anche i metri di paragone sono diversi. CAISI confronta GLM-5.3 con il miglior modello USA che ha testato su ciascun benchmark, un gruppo che comprende rilasci ad accesso riservato (trusted access) oltre a quelli pubblici, mentre Anthropic lo confronta con il proprio Claude Mythos Preview. La nota della Cloud Security Alliance vede una tensione tra l’impostazione di Anthropic e la valutazione di CAISI che parla di capacità «significativamente inferiori», e dice che la differenza dipende in larga misura dal benchmark e dal modello USA scelto come termine di paragone.
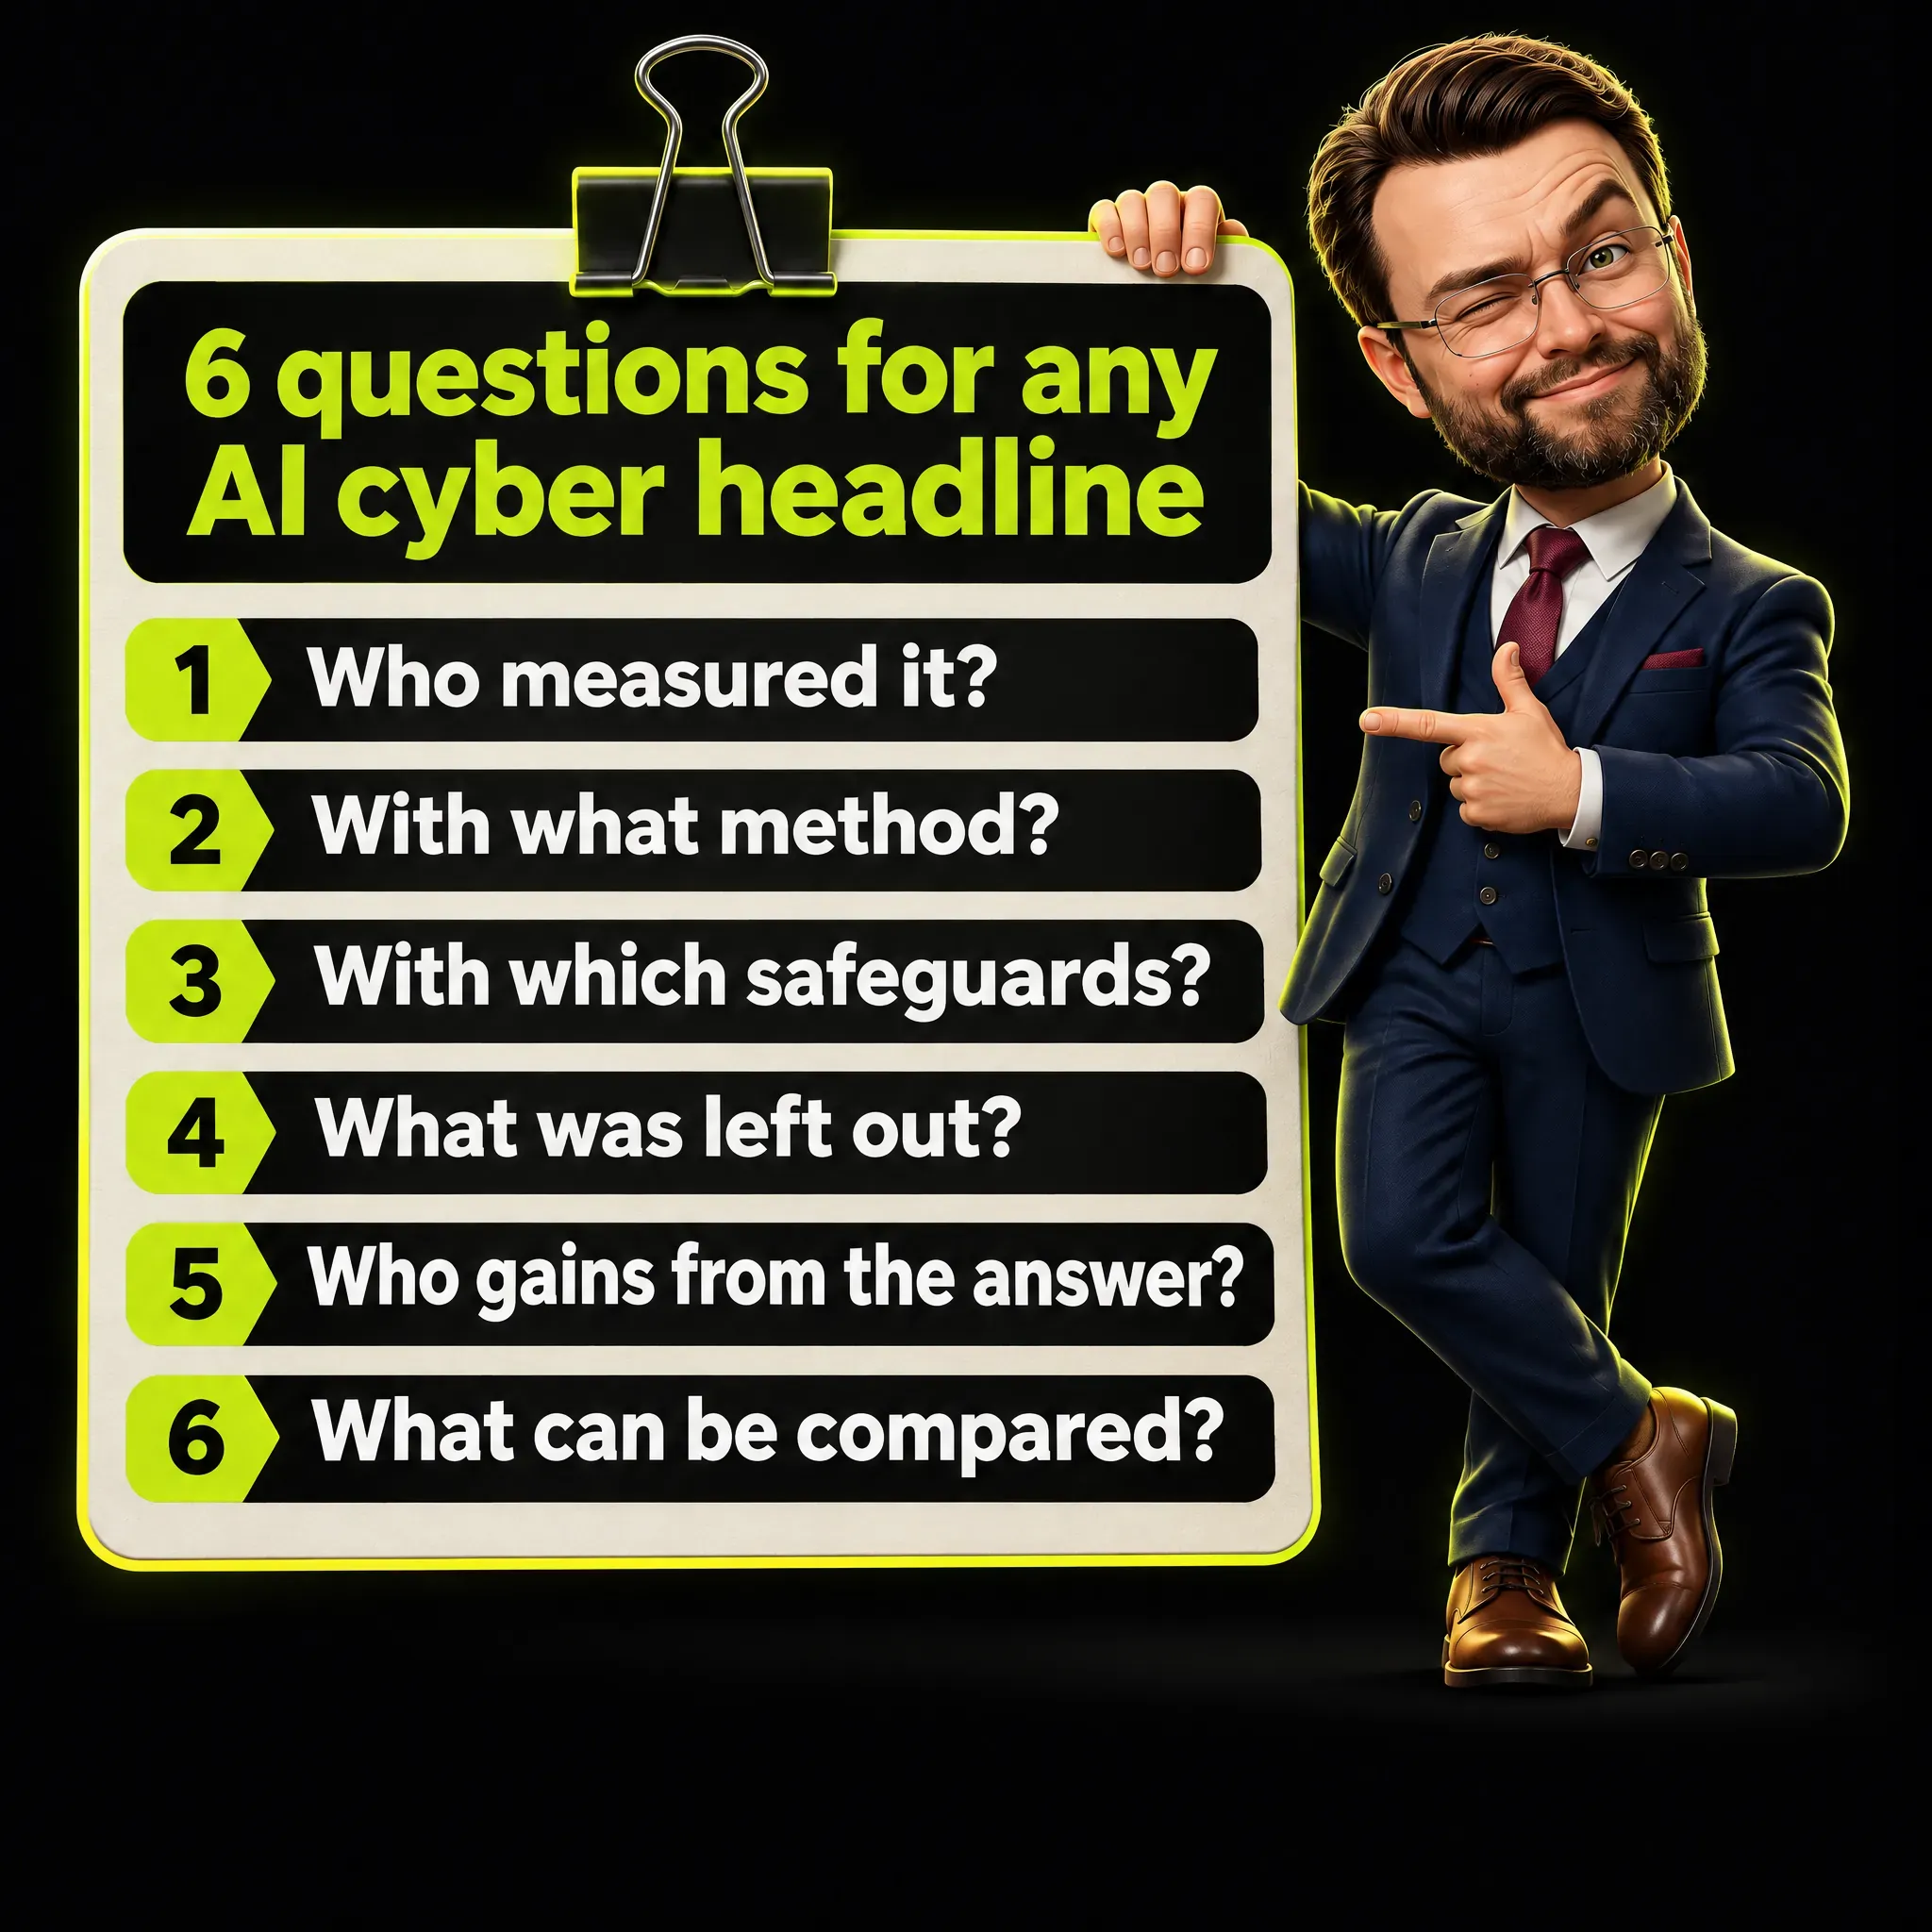
Sei domande per ogni titolo su IA e attacchi informatici
Sono le domande che mi pongo ora prima di ripetere un numero.
- Chi l’ha misurato? Un istituto governativo, un laboratorio, un fornitore o chi ha prodotto il modello? CAISI e AISI sono enti governativi; Anthropic è un’azienda, e la tabella dei benchmark di Z.ai è un’affermazione di chi ha creato il modello.
- Con quale metodo? Guarda il tipo di compito, l’unità del punteggio e il numero di tentativi. Un punteggio graduato su 16 e un conteggio di exploit completi sono cose diverse.
- Con quali salvaguardie? CAISI ha testato i modelli USA con le salvaguardie disattivate, dove applicabile, e Anthropic ha eseguito i suoi modelli Claude senza salvaguardie per i grafici sulle capacità. Un risultato con le salvaguardie spente mostra che cosa un modello sa fare e dice poco su che cosa farà.
- Che cosa è stato escluso? CAISI ha escluso i modelli non rilasciati, i range di AISI non hanno difensori attivi e AISI ha testato un predecessore del modello nel titolo.
- A chi giova la risposta? Un’azienda che vende modelli chiusi ci guadagna quando i modelli a pesi aperti sembrano rischiosi. Chi crea un modello ci guadagna quando il suo modello sembra forte. Anche un istituto governativo ha un mandato: il rapporto di CAISI confronta per impostazione modelli USA e cinesi, e una parte del suo metodo, il benchmark OSS-Fuzz, è privata.
- Che cosa si può confrontare? Solo numeri sugli stessi compiti, con gli stessi tentativi e le stesse salvaguardie. Quando le unità differiscono, confronta la direzione del risultato e lascia stare le percentuali.
Cosa non dicono i test
I rapporti lasciano aperte tre cose.
- Gli attacchi reali. Non ho trovato in questi rapporti cifre su attacchi reali che abbiano usato GLM. I test si svolgono in laboratori, sandbox e simulazioni.
- I numeri di chi ha creato il modello. Z.ai pubblica una tabella di benchmark per GLM-5.3, comprese le valutazioni cyber. La considero un’affermazione di chi lo produce e qui non ne uso i numeri.
- Il futuro. Il divario di AISI non permette di prevedere i salti fatti dai modelli chiusi di frontiera nell’aprile 2026, quindi i quattro-sette mesi che ha misurato, come i quattro di CAISI, descrivono il passato e non sono una previsione.
Cosa significa per un’azienda che non fa sicurezza
Un esempio inventato: un’azienda di 40 persone ha un sito web, un negozio online e un elenco clienti in un CRM, lo strumento che conserva le schede dei clienti. Un titolo dice che un’IA ora può attaccare i browser da sola.
Ciò che i rapporti sostengono per quell’azienda è modesto. La conclusione di AISI è una finestra per i difensori, e il consiglio dell’NCSC (il centro nazionale per la cybersicurezza del Regno Unito) che AISI cita è investire nelle basi della cybersicurezza, le misure minime che ogni organizzazione dovrebbe avere, e in difese potenziate dall’IA.
Il resto è una mia inferenza e non un risultato dei rapporti. La seconda sessione di Anthropic ha trasformato in poco tempo i dettagli pubblici di un difetto divulgato, più un altro difetto noto, in un exploit funzionante, e questo mi fa chiedere con quale rapidità vengano installati gli aggiornamenti. Propongo quattro piccoli passi, e sta a te decidere quali vanno bene:
- Chiedi al tuo fornitore IT con quale rapidità vengono installati gli aggiornamenti del software, e come ti accorgeresti di un ritardo.
- Elenca gli strumenti e gli agenti di IA che hanno accesso ai tuoi account, e che cosa può fare ciascuno con quell’accesso. Il mio articolo sugli agenti IA per il marketing descrive la configurazione che uso.
- Tieni una persona nel percorso di approvazione di tutto ciò che un agente invia fuori dall’azienda. Descrivo questa pratica in human in the loop: la verifica del lavoro dell’IA, e i controlli attorno a un agente in prompt injection e sicurezza degli agenti IA.
- Chiedi ai fornitori prove nella forma delle sei domande qui sopra, e tratta un’affermazione senza metodo come marketing.
Quanto costa
I rapporti contengono alcune cifre di costo, e ciascuna richiede la sua fonte.
- La stima di AISI sui costi dei modelli a pesi aperti. Un’esecuzione di un cyber range da 100 milioni di token è costata circa 85 dollari per Opus 4.5 e Opus 4.6, circa 46 dollari stimati per GLM-5.2 e 1,19 dollari per DeepSeek V4-Pro. Sono prezzi di listino, quindi i costi reali di calcolo possono variare.
- La stima di Anthropic sull’abliteration. Anthropic riferisce circa 2.200 ore di GPU (il tempo di calcolo dei processori grafici che fanno girare i modelli), circa 4.400 dollari, per la sua prima volta con la tecnica, e stima più vicino a 600 ore di GPU, 1.200 dollari, per un gruppo esperto. Entrambe le cifre sono di Anthropic e nessun test indipendente le ha confermate.
- Il costo di un attacco reale. Non disponibile. Nessuna fonte che ho letto lo riporta.
Per un team di marketing, la cifra che conta di più, a mio avviso, non è nessuna di queste. È il costo di una sola approvazione sbagliata da parte di un agente che ha accesso ai tuoi account, e dipende dai controlli che imposti.
Una tabella di lettura per il prossimo titolo
Questa tabella applica le sei domande al caso GLM-5.3, e puoi riusarla sul prossimo titolo.
| Domanda | Dove trovare la risposta | Esempio da GLM-5.3 |
|---|---|---|
| Chi l’ha misurato? | Il primo paragrafo e la pagina «chi siamo» | CAISI (governo USA), AISI (governo britannico), Anthropic (concorrente di Z.ai) |
| Con quale metodo? | Le note sul metodo e le didascalie delle figure | Agente con bash e python; punteggio graduato su 16 contro exploit completi su 410 |
| Con quali salvaguardie? | La sezione sulla configurazione | Modelli USA testati con le salvaguardie cyber disattivate, dove applicabile |
| Che cosa è stato escluso? | La sezione sui limiti | Modelli non rilasciati esclusi; range senza difensori attivi; GLM-5.2 testato da AISI |
| A chi giova? | Chi pubblica, chi vende, chi viene nominato | Anthropic non rilascia i suoi pesi; Z.ai vende GLM; il rapporto di CAISI confronta modelli USA e cinesi |
| Che cosa si può confrontare? | L’unità di ciascun numero | Confronta il risultato che GLM-5.3 è il modello a pesi aperti più forte e tieni separate le percentuali |
Domande frequenti
Che cos’è CAISI?
CAISI è il Center for AI Standards and Innovation, un ente del governo USA all’interno del NIST. Valuta modelli di IA avanzati, anche cinesi, e ne pubblica i risultati.
Che cos’è l’UK AI Security Institute?
È l’ente del governo britannico che collauda l’IA avanzata. Esegue valutazioni cyber su compiti ristretti e su reti simulate, e la sua analisi di luglio ha stimato il divario tra modelli a pesi aperti e modelli chiusi.
Che cos’è l’IA nella cybersicurezza?
Comprende due usi: modelli che aiutano i difensori, per esempio leggendo i log (i registri di ciò che accade nei sistemi) o trovando i difetti prima degli attaccanti, e modelli che aiutano gli attaccanti a fare lo stesso lavoro più in fretta. I test di questo articolo misurano il secondo uso, come modo per valutare il rischio.
Un’IA può condurre da sola un attacco informatico?
Nella rete di prova a 32 passaggi di AISI, GLM-5.2 è arrivato circa al passaggio 11 prima di bloccarsi, e la rete non aveva difensori attivi. Anthropic descrive due sessioni in cui i modelli GLM hanno costruito exploit funzionanti con poca attenzione umana. Non ho trovato cifre su attacchi nel mondo reale.
GLM-5.3 è più pericoloso dei modelli USA?
CAISI trova le sue capacità cyber significativamente inferiori alla frontiera USA, e quella frontiera comprende rilasci ad accesso riservato (trusted access), non solo modelli pubblici. La differenza riguarda la distribuzione: AISI spiega che, una volta pubblici i pesi, il monitoraggio non si può applicare in modo universale e l’addestramento al rifiuto è spesso facilmente reversibile.
Che differenza c’è tra un benchmark e un attacco reale?
Un benchmark è un insieme fisso di compiti valutati in laboratorio. Un attacco reale si scontra con monitoraggio, aggiornamenti e persone che reagiscono, cose che le reti di prova di questi rapporti non includono.
Perché test diversi danno numeri diversi?
Usano compiti diversi, unità diverse per il punteggio, un numero diverso di tentativi e impostazioni diverse delle salvaguardie. I numeri si possono confrontare solo quando questi elementi coincidono.
Un team di marketing dovrebbe preoccuparsi?
Suggerisco una risposta calma: controlla con quale rapidità si installano i tuoi aggiornamenti, sappi quali strumenti di IA hanno accesso ai tuoi account e fai approvare da una persona ciò che esce dall’azienda. I rapporti misurano la capacità cyber e non dicono nulla sul lavoro di marketing.
Il mio punto di vista
Il risultato di un test è una misura fatta da qualcuno, con un metodo, in certe condizioni. Leggere il metodo dice più del titolo, e le sei domande si applicano in fretta.
Su IA e attacchi informatici, e su GLM-5.3 in particolare, il quadro che ricavo da questi rapporti è un modello che guida il campo dei pesi aperti e resta indietro di mesi rispetto alla frontiera chiusa, con salvaguardie che dipendono da come viene distribuito. Il livello di capacità ha due fonti, CAISI e Anthropic, che descrivono la distanza dalla frontiera in modo diverso. Le percentuali sulle salvaguardie ne hanno una sola, e vengono da un’azienda con un interesse nel risultato.
Per un’azienda che usa agenti di IA, metterei l’attenzione su ciò che gli agenti possono raggiungere e su chi ne approva le azioni, perché quella parte la controlli tu.


