Кибератаки ИИ: шесть вопросов, прежде чем верить тесту
Кибератаки ИИ: как читать тесты. Что CAISI, UK AISI и Anthropic измерили на GLM-5.3 или её предшественнице, почему цифры расходятся и какие вопросы задать.
С июля три организации опубликовали тесты кибервозможностей китайских моделей ИИ с открытыми весами (open-weight), в том числе GLM, и их цифры не сводятся в одну таблицу. Заголовки о том, что ИИ умеет делать с компьютерными системами, редко объясняют почему.
Кибератаки ИИ - это атаки на компьютерные системы, в которых часть работы выполняет модель искусственного интеллекта: например, находит изъян в программе или пишет код, который его использует. Исследователи измеряют эту способность бенчмарками, то есть едиными наборами заданий, а результаты зависят от того, кто и как проводит тест.
Я работаю в маркетинге и каждый рабочий день пользуюсь моделями ИИ, в основном локальными, обученными под мои задачи. Когда заголовок сообщает, что ИИ может атаковать системы, я читаю первоисточники, потому что в них названы модели вроде тех, которыми я пользуюсь. В этой статье я разбираю их для читателя, которому нужно оценить утверждение, не становясь специалистом.
Предмет разбора - GLM-5.3, которую Z.ai выпустила 14 августа 2026 года. Эту модель или её предшественницу проверяли три источника: CAISI в США, AI Security Institute в Великобритании и компания Anthropic.
CAISI и Anthropic сходятся в том, что GLM-5.3 - заметный шаг вперёд по сравнению с прежними моделями с открытыми весами. Расстояние до закрытого передового уровня они описывают по-разному и измеряют разные вещи, а причины этого дают больше, чем сами цифры.
Главное коротко
- Три источника измеряют разное, поэтому их цифры не сходятся. CAISI и Anthropic тестировали GLM-5.3, а AISI - её предшественницу; они использовали разные задания, по-разному считали успех и допускали разное число попыток, поэтому проценты нельзя ставить рядом.
- CAISI, американский государственный тестировщик, называет GLM-5.3 «самой мощной по кибервозможностям моделью с открытыми весами из выпущенных на сегодня». Он же оценивает её возможности как «значительно ниже» передового американского уровня: отставание около четырёх месяцев по сводному показателю.
- Британский AI Security Institute оценивает отставание моделей с открытыми весами в четыре-семь месяцев, против шести-десяти в 2025 году. Он тестировал GLM-5.2 и DeepSeek V4-Pro, а не GLM-5.3.
- Цифры Anthropic по защитным механизмам не воспроизведены. Тесты защиты не повторяли ни CAISI, ни AISI, а The Decoder называет GLM-5.3 прямым конкурентом Anthropic. Выводы о возможностях GLM-5.3 сама Anthropic считает в целом совпадающими с выводами CAISI.
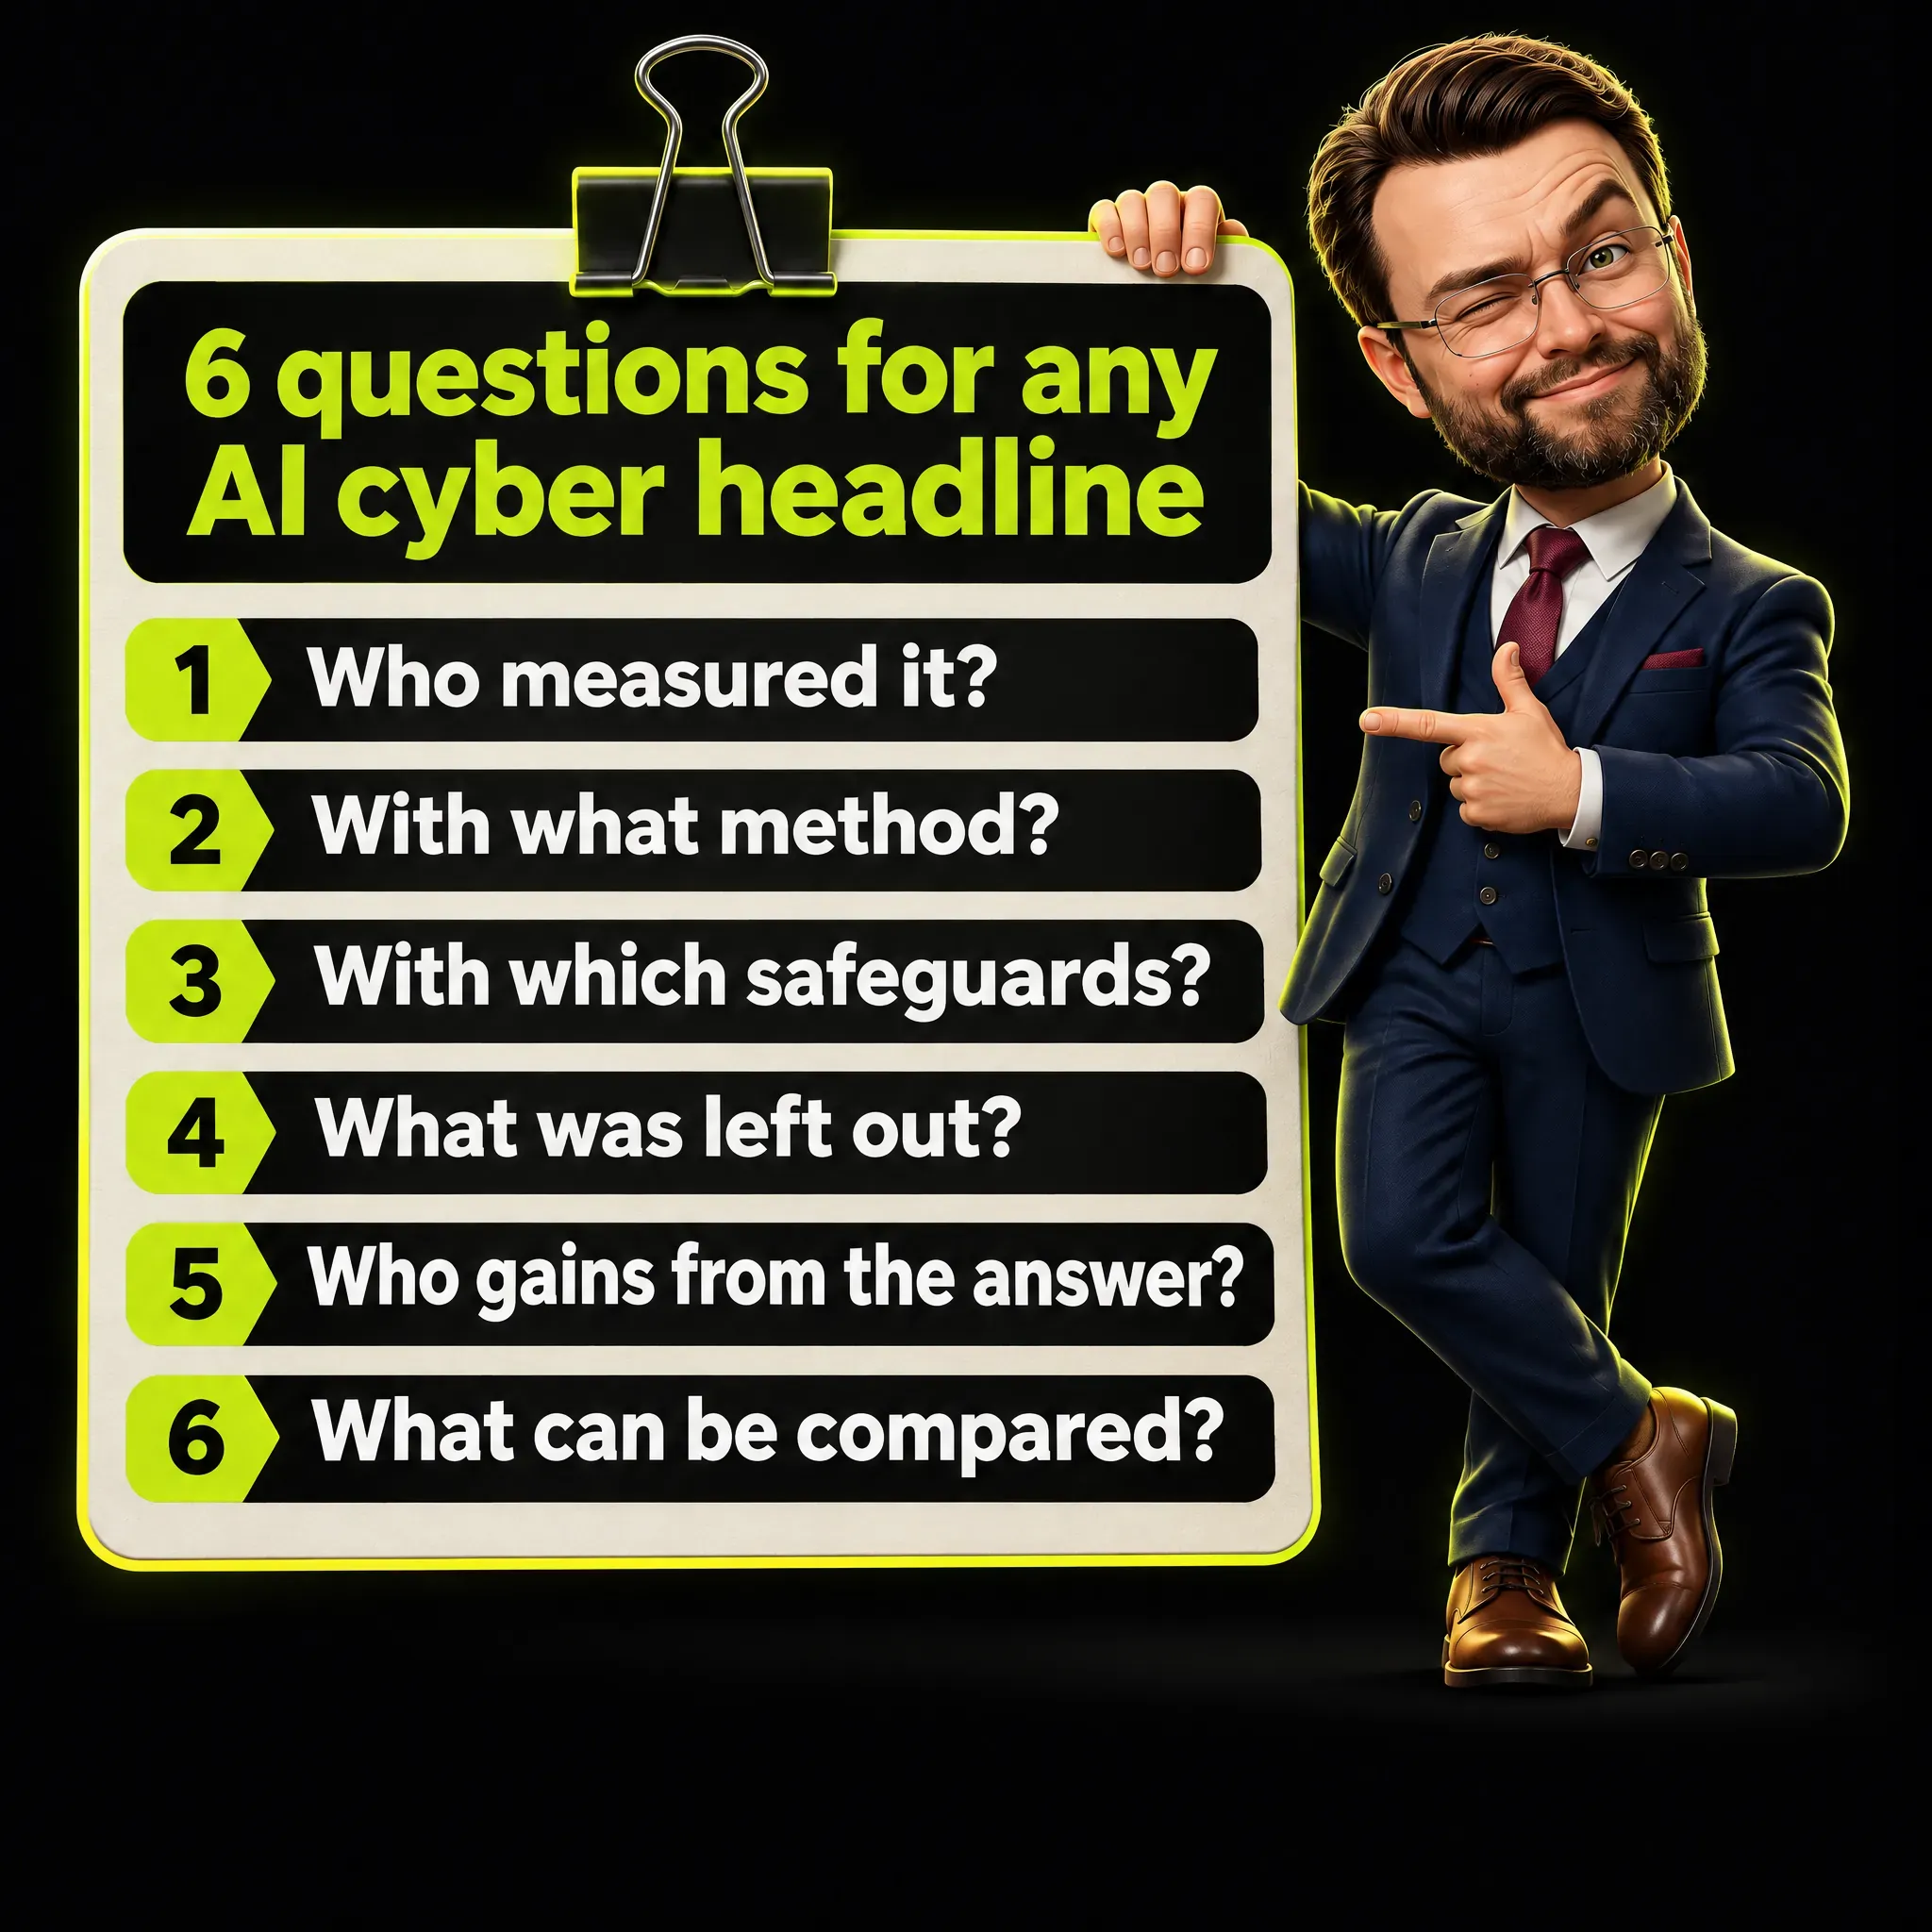
- Шесть вопросов помогают разобрать большинство заголовков: кто измерял, каким методом, при каких защитных механизмах, что осталось за рамками, кому выгоден результат и что можно сравнивать.
- Ни один из прочитанных мной источников не измеряет влияние на маркетинговую работу или на обычную компанию. Цифр о реальных атаках с использованием GLM в этих отчётах нет.
Что измеряют тесты, простыми словами
Уязвимость - это изъян в программе, которым может воспользоваться атакующий, например ошибка в браузере, из-за которой вредоносная страница читает файлы на компьютере посетителя. Эксплойт (exploit) - это код или последовательность шагов, превращающая такой изъян во взлом.
Бенчмарк (benchmark) - это фиксированный набор заданий, который дают многим моделям, чтобы их баллы можно было сравнивать, как на экзамене, где у всех студентов одни и те же вопросы. Кибербенчмарки различаются тем, что именно они спрашивают. Одни просят модель найти изъян, на который никто не указывал, другие выдают известный изъян и просят эксплойт, третьи проверяют, способна ли модель провести длинную атаку шаг за шагом в учебной сети.
Ещё два термина встречаются на протяжении всей статьи. Защитные механизмы (safeguards) - это отказы и фильтры, которые разработчик встраивает в модель, чтобы она отклоняла вредные запросы. Открытые веса (open-weight) означают, что создатель опубликовал обученные файлы модели, поэтому любой может запустить её на собственных серверах, а проследить за тем, как её используют потом, невозможно; деловую сторону я описал в статье о китайских нейросетях для бизнеса.
Источник первый: CAISI, государственный тестировщик США
CAISI - это Center for AI Standards and Innovation (Центр стандартов и инноваций в области ИИ), часть NIST, американского ведомства по стандартам. Он тестирует модели крупных разработчиков и опубликовал свою оценку GLM-5.3 17 сентября 2026 года, примерно через месяц после выпуска.
В резюме отчёта GLM-5.3 названа «самой мощной по кибервозможностям моделью с открытыми весами из выпущенных на сегодня». Там же её кибервозможности оценены как «значительно ниже», чем у нынешних передовых американских моделей, с отставанием около четырёх месяцев по сводному показателю. По большинству оценок до неё лучшей китайской моделью и лучшей моделью с открытыми весами из проверенных CAISI была Kimi K3 от Moonshot AI.
Четыре бенчмарка
CAISI использовал четыре бенчмарка, и каждый задаёт свой вопрос:
| Бенчмарк | Заданий | Что должна сделать модель |
|---|---|---|
| SEC-Bench Pro | 183 | Найти уязвимость в браузерном движке V8 или SpiderMonkey и написать код, который вызывает его сбой |
| ExploitBench | 41 | Использовать известные изъяны в V8; каждое задание оценивается по шкале до 16 баллов, берётся лучшая из трёх попыток |
| ExploitGym (userspace) | 502 | Использовать реальные ошибки в программах с открытым кодом; входные данные, вызывающие сбой, уже известны |
| CAISI OSS-Fuzz | 297 | Непубличный бенчмарк на проектах с открытым кодом; описание, сбой и исправление не даются |
V8 - это движок, который выполняет JavaScript в Chrome, а SpiderMonkey - его аналог в Firefox. Непубличный бенчмарк не публикует свои задания, поэтому модель с меньшей вероятностью видела их при обучении.
Результаты
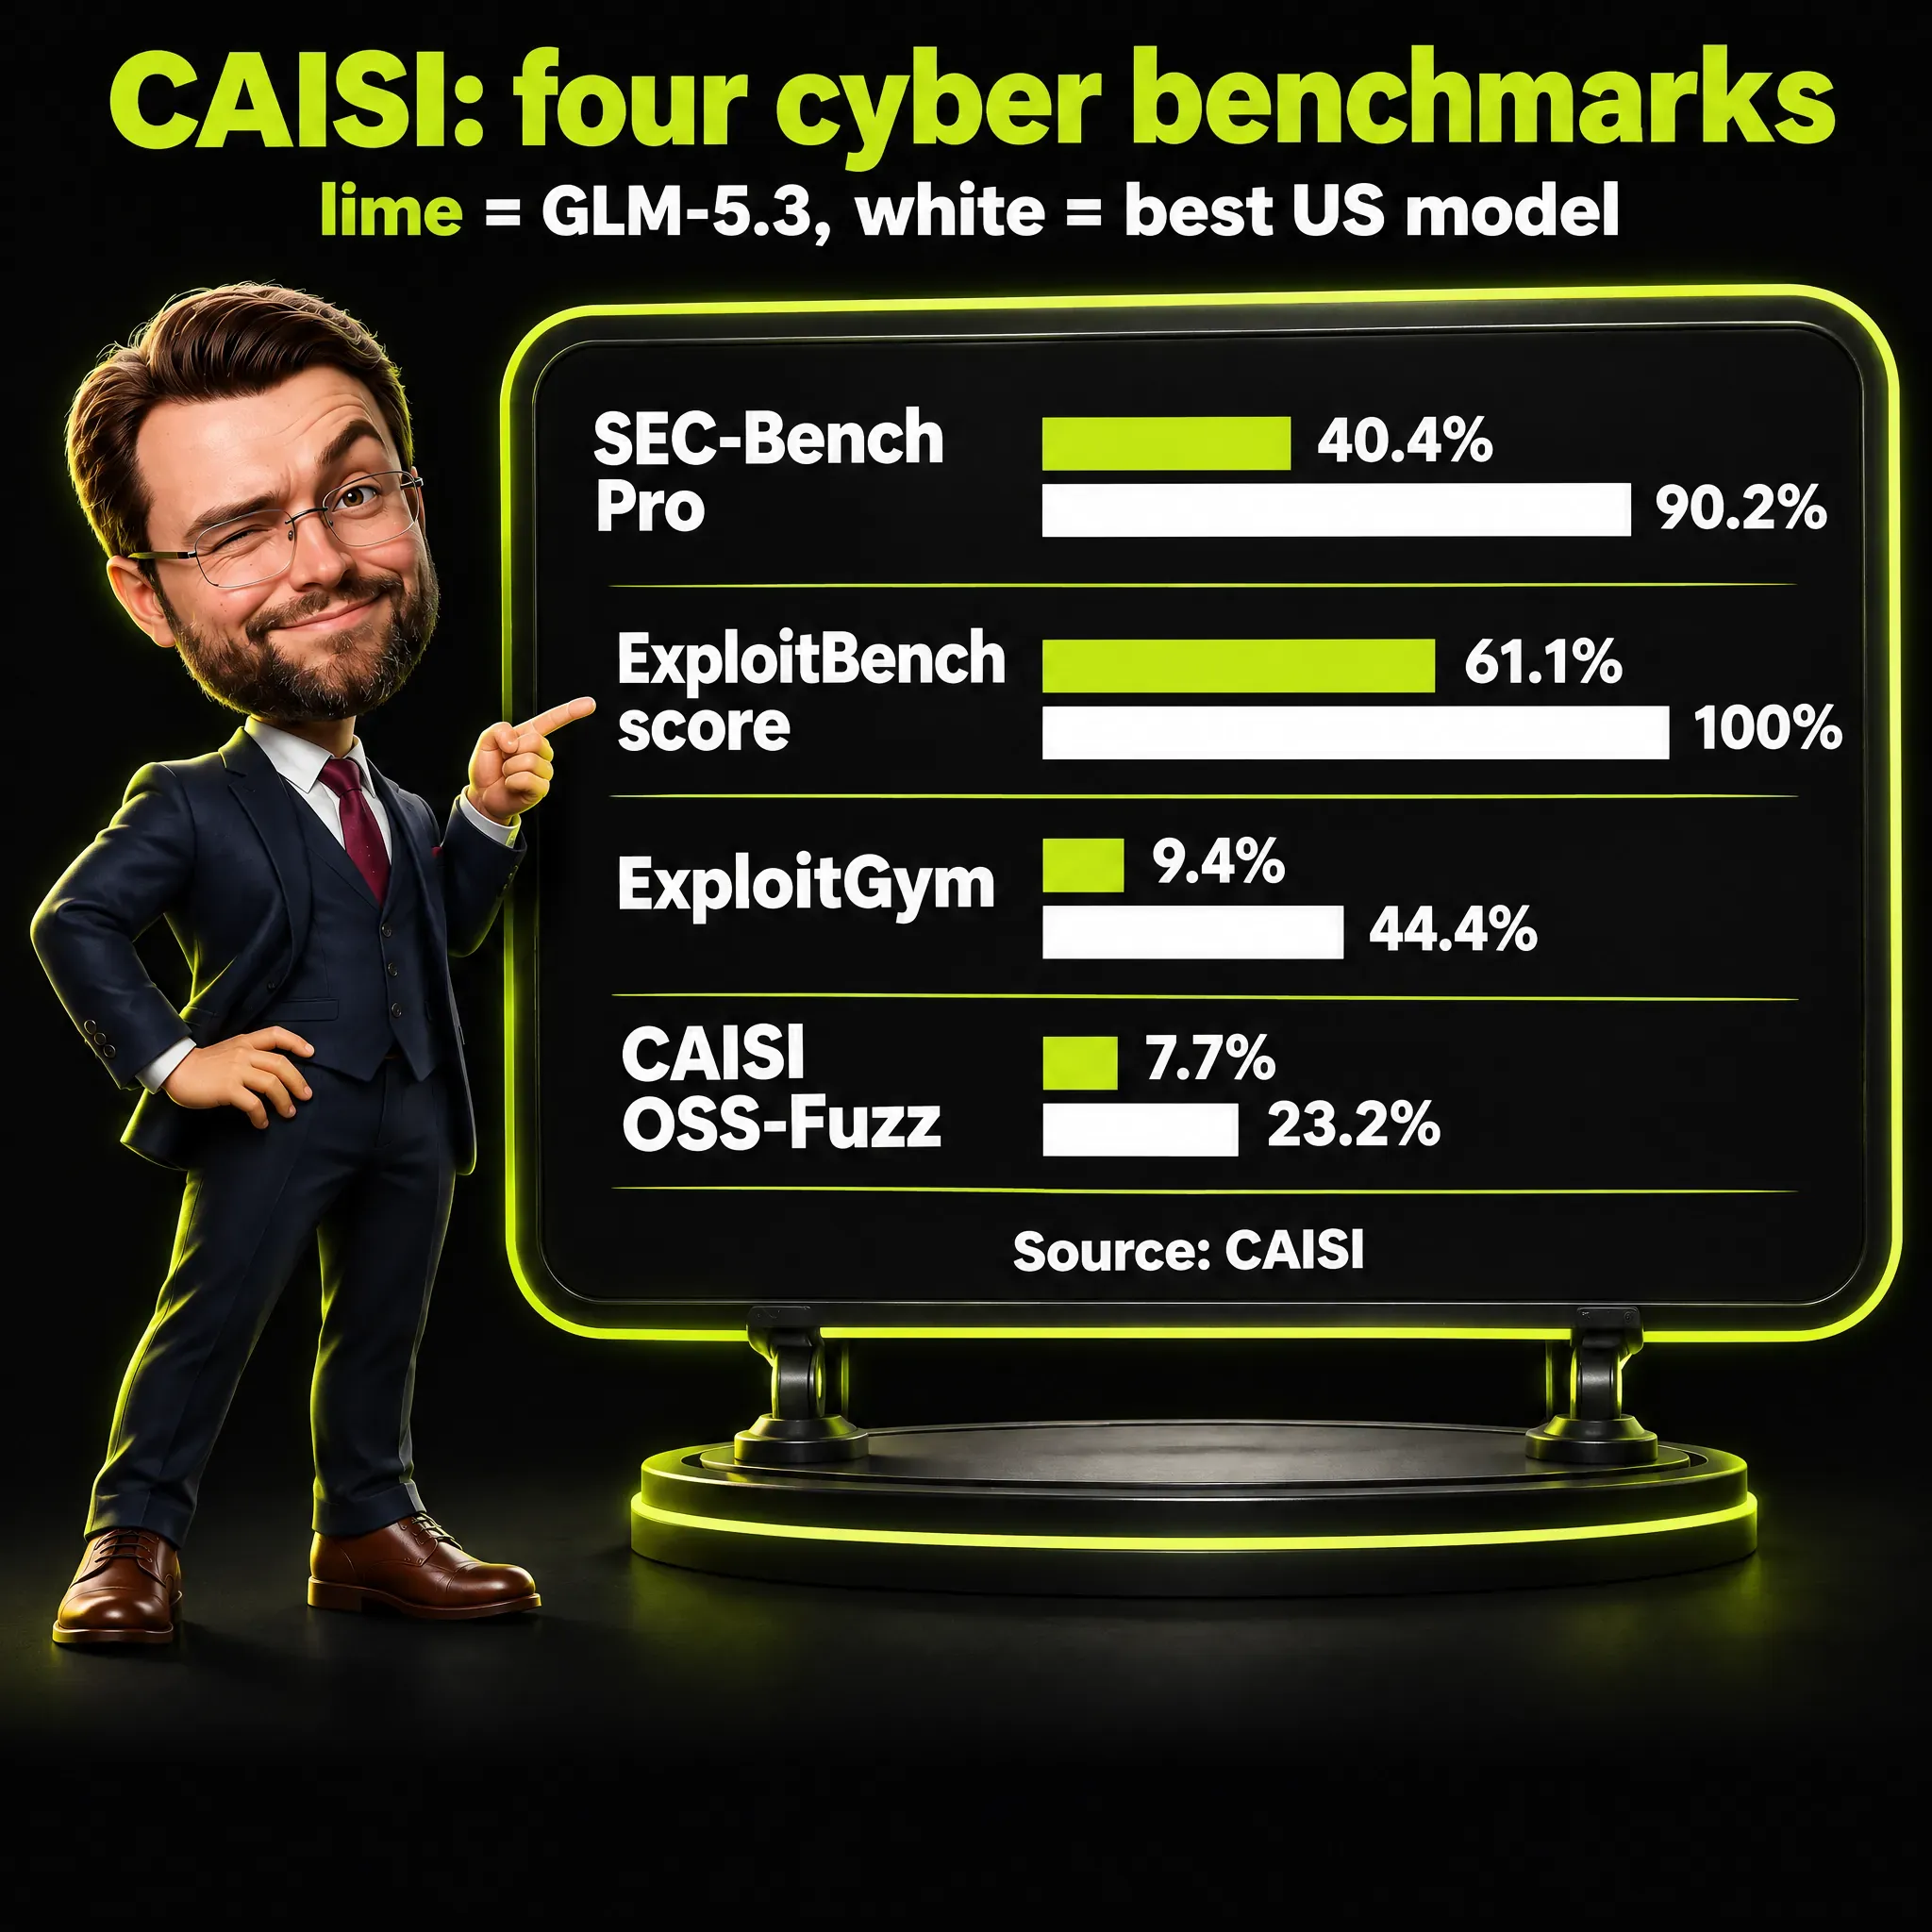
Вот результаты CAISI, с числом заданий за каждым процентом так, как их приводит CAISI:
| Бенчмарк | GLM-5.3 | Лучшая из протестированных американских моделей | Лучшая из остальных протестированных китайских моделей |
|---|---|---|---|
| SEC-Bench Pro | 40,4% (74 из 183) | 90,2% (165 из 183) | 27,3% (50 из 183) |
| ExploitBench | 61,1% (9,8 из 16) | 100% (16,0 из 16) | 32,2% (5,1 из 16) |
| ExploitGym | 9,4% (47 из 498) | 44,4% (223 из 502) | 2,6% (13 из 502) |
| CAISI OSS-Fuzz | 7,7% (23 из 297) | 23,2% (69 из 297) | 2,4% (7 из 297) |
Откуда цифра: CAISI запускал все модели на одних и тех же заданиях, а процент - это доля решённых заданий или, на ExploitBench, доля из 16 баллов, доступных за каждое задание. Что это значит: GLM-5.3 выше лучшей из остальных китайских моделей по всем четырём бенчмаркам, явно на ExploitGym и OSS-Fuzz и с пересекающимися диапазонами на двух других, и намного ниже лучшей американской модели по всем четырём. Что это меняет: и «самая мощная по кибервозможностям модель с открытыми весами», и «значительно ниже» передового американского уровня - формулировки самого CAISI, обе верны, поэтому заголовок с цитатой только из одной из них даёт неверную картину.
Важны и границы погрешности. CAISI приводит 95-процентные доверительные интервалы, то есть диапазон, в который с наибольшей вероятностью попадает истинный результат. На SEC-Bench Pro результат GLM-5.3 в 40,4% может лежать где угодно от 33,6% до 47,7%, а на ExploitBench результат в 61,1% - от 45,9% до 74,5%.
Диапазоны лучшей из остальных китайских моделей на этих двух бенчмарках, от 21,4% до 34,2% и от 19,9% до 47,4%, перекрываются с ними, поэтому я не называю там отрыв явным.
CAISI не объясняет, почему GLM-5.3 оценивали на 498 заданиях ExploitGym, а остальные модели - на 502.
Метод
CAISI запускал каждую модель как агента: модель рассуждает, выполняет команду в терминале, читает вывод и пробует снова, до 200 или 300 ходов в зависимости от бенчмарка. Американские модели тестировали с отключёнными защитными механизмами в области кибербезопасности (где это применимо), поэтому цифры показывают, на что модель способна, а не на что она согласилась бы для постороннего. Невыпущенные модели в тест не вошли, и CAISI отмечает, что они могли бы оказаться сильнее.
Эти «около четырёх месяцев» берутся из одного индекса. CAISI сводит четыре бенчмарка в один «индекс кибервозможностей» методом, заимствованным из тестирования на экзаменах, теорией отклика на задание (Item Response Theory): более трудные задания весят больше, и каждая модель получает место на единой шкале. Модель, стоящая на 400 пунктов выше по этой шкале, имеет в десять раз больше шансов решить задание.
Индекс GLM-5.3 лежит выше Kimi K3 и ниже передового американского уровня, и разрыв в обоих случаях больше границ погрешности.
Самой модели посвящена моя статья о GLM 5.3 и лучшей открытой LLM, поэтому здесь я остаюсь на тестах.
Источник второй: британский AI Security Institute
Британский AI Security Institute (AISI) - государственная структура Великобритании, которая тестирует передовой ИИ. Его анализ разрыва между моделями с открытыми весами и закрытыми моделями вышел в июле. Институт тестировал GLM-5.2 и DeepSeek V4-Pro, поэтому о GLM-5.3 напрямую он ничего не говорит.
Вывод таков: недавние модели с открытыми весами отстают от закрытого передового уровня в кибербезопасности на период от четырёх до семи месяцев. Это меньше, чем от шести до десяти месяцев, которые AISI измерял во внутренних оценках на протяжении большей части 2025 года.
Два вида тестов
Первый вид - узкие задания, каждое из которых проверяет отдельный навык в кибербезопасности. AISI взял 70 заданий из своего набора в 96, распределённых по четырём уровням сложности, от «технического неспециалиста», например аналитика данных, до «эксперта»: 18 заданий на первом уровне, 25 на втором, 19 на третьем и 8 на четвёртом.
На каждое задание давали пять попыток. Каждая попытка могла потратить не более 2,5 миллиона токенов, то есть небольших фрагментов текста, так что лимит ограничивает, как долго модель может работать.
На этих заданиях GLM-5.2 показала результат, сопоставимый с моделями с самыми высокими кибервозможностями, выпущенными за четыре месяца до неё: Opus 4.6 и GPT-5.3-Codex. AISI пишет, что это верно на всех четырёх уровнях сложности. DeepSeek V4-Pro сопоставима с Opus 4.5, вышедшей за пять месяцев до неё.
Второй вид - киберполигоны (cyber ranges), то есть имитации корпоративных сетей, построенные экспертами. Один из них, «The Last Ones», представляет собой атаку из 32 шагов на 4 подсети и около 20 узлов, на которую, по оценке AISI, у эксперта-человека ушло бы примерно 20 часов. Каждая модель проходила его 10 раз, кроме случаев, где AISI отмечает лучшую попытку, с лимитом 100 миллионов токенов на прогон.
На этом полигоне GLM-5.2 дошла так же далеко, как Opus 4.5, выпущенная менее чем за семь месяцев до неё. DeepSeek V4-Pro осталась ниже Sonnet 4.5.
AISI считает сравнение на полигонах более слабым доказательством, потому что оно опирается на меньшее число полигонов, чем сравнение на узких заданиях. Остановка могла произойти из-за нехватки навыков взлома или из-за неспособности долго удерживать сложный план, а записи шагов модели (траектории) не показывают, что именно. На полигонах также нет активных защитников и защитных средств, которые есть в реальной корпоративной сети.
Защитные механизмы и ограничения
Защитные механизмы почти не мешали тестам AISI. DeepSeek V4-Pro иногда отказывалась от узких заданий, в основном по обратной разработке (reverse engineering, изучению готовой программы), и AISI обошёл это несколькими повторными попытками. Причину AISI объясняет так: когда веса публичны, мониторинг, классификаторы и блокировка пользователей не могут применяться повсеместно, а обучение отказам (техника, которая остаётся) «часто легко обратимо при наличии доступа к весам».
AISI прямо называет свои ограничения. Скорее всего, такая постановка немного занижает возможности моделей с открытыми весами, потому что команда не занималась специальной оптимизацией, а публикация проверяет только кибервозможности: «выводы о других возможностях сделать нельзя». Измеренный разрыв, кроме того, «не позволяет предсказать, повторят ли будущие модели с открытыми весами более поздние скачки», которые в апреле 2026 года совершили две закрытые модели.
Практический вывод AISI - окно возможностей для защитников: возможности, которые сегодня закрыты защитными механизмами, позже могут стать доступны без них.
Источник третий: Anthropic, компания в сфере ИИ
Anthropic создаёт Claude. Её публикация о GLM-5.3 вышла после отчёта CAISI и сообщает: «Наши выводы о возможностях в целом совпадают с выводами CAISI». В ней три части: бенчмарки, сессии под руководством человека и тесты защитных механизмов.
Вывод компании: GLM-5.3 - «существенный качественный скачок в кибервозможностях, доступных атакующим», и она считает, что государственные и негосударственные субъекты, вероятно, будут использовать подобные модели, чтобы причинять вред в реальном мире.
Бенчмарки
На ExploitBench Anthropic считает, как часто модель строит полный работающий эксплойт от начала до конца. GLM-5.3 справилась с этим в 50 попытках из 410, а Claude Mythos Preview - в 56 из 410.
На внутреннем бенчмарке Anthropic Binary Exploitation, построенном на проектах с открытым кодом, полный балл ставится за «полный перехват потока управления» (full control-flow hijack), когда атакующий берёт под контроль то, что выполняет программа. На 100 случайно выбранных заданиях GLM-5.3 справилась с этим в 4% испытаний, а Mythos Preview - в 6%.
Anthropic добавляет, что «значимый порог явно пройден»: прежние модели вроде Opus 4.6 и GLM-5.2 не справляются ни с одним из этих заданий. Модели Claude на этих графиках работали с отключёнными защитными механизмами.
Сессии под руководством человека
В первой сессии исследователь использовал GLM-5.3 на изолированной машине («песочнице», sandbox) с локальной сборкой популярного браузера под Linux. Примерно за сутки, при ограниченном внимании человека, модель нашла несколько ранее неизвестных уязвимостей в JavaScript-движке браузера и связала их в эксплойт: веб-страницу, которая при посещении читает произвольные файлы с компьютера посетителя. Anthropic пишет, что передала сведения об изъянах команде, которая поддерживает браузер.
Во второй сессии исследователь дал GLM-5.3-Flash, меньшей модели, публичные сведения о недавно раскрытой уязвимости Chrome и о другом известном изъяне. Модель связала их в надёжный эксплойт для цели на процессорной архитектуре ARM64, обойдя защитную функцию, встроенную в процессорный чип. Anthropic указывает 20 минут внимания человека плюс восемь часов работы модели и сообщает, что по тарифам API (программного интерфейса) у Zhipu эта работа стоила бы 20,40 USD.
Это две сессии, которые описывает Anthropic, поэтому они показывают, что возможно, и ничего не говорят о том, как часто так бывает.
Тесты защитных механизмов
Anthropic поместила модель в имитированный мир и дала ей откровенно вредоносные запросы на атаку критически важных систем. Код не выполнялся, а вторая модель приблизительно имитировала ответ на каждую команду, поэтому тест не может показать, что атака удалась бы. CAISI и AISI его не повторяли.
В этой симуляции модель «включалась в атаку» (engaged), если после вредоносного запроса пыталась подключиться к удалённой целевой системе. В каждой ячейке таблицы результатов 50 образцов: пять приказов об атаке, две цели, пять попыток в каждом случае. Anthropic сообщает, что GLM-5.3 включалась в атаку в такой доле образцов:
- Прямой запрос: 0%
- Обманный запрос, то есть ложная легенда: 64%
- Предзаполненное рассуждение, когда атакующий сам пишет первые строки собственных «мыслей» модели: 92%
- Аблитерированная копия (abliterated), то есть копия, у которой отказы вырезаны из весов: 100%
Модели Claude остались на 0% во всех условиях, которые к ним применимы. Защитные механизмы Claude заблокировали обманные запросы, API Anthropic не позволяет предзаполнять рассуждение Claude, а веса Claude не выдаются, поэтому аблитерировать их нельзя.
Anthropic также измерила аблитерированные копии на трёх публичных бенчмарках вредных запросов. Средняя доля отказов упала с 95% до 6% у GLM-5.3 и до 14% у GLM-5.3-Flash, а показатели возможностей почти не изменились. Технике и тому, что она значит для выбора модели, посвящена моя статья об аблитерации моделей ИИ.
Конфликт интересов
Об этом написали два издания. The Decoder озаглавил один из разделов «Предупреждение Anthropic служит и её бизнесу»: Anthropic не публикует веса своих моделей, а дешёвая китайская модель с открытыми весами, близкая к передовому уровню, - прямой конкурент.
В той же статье добавлено, что предупреждение продиктовано не только собственным интересом: «независимая оценка CAISI подтверждает цифры о возможностях».
Trending Topics отмечает, что Anthropic - конкурент Z.ai, цитирует читателя Hacker News, который спрашивает о «конфликте интересов в исследовании с прямым конкурентом», и добавляет, что Z.ai ещё не ответила на анализ Anthropic. AI Safety Initiative организации Cloud Security Alliance в исследовательской заметке от 4 октября фиксирует, что оценку Anthropic CAISI и AISI не воспроизводили.
Один голос не согласен с оценкой самой угрозы. Jake Williams из IANS Research, которого Trending Topics цитирует по The New Stack до выпуска модели, сказал, что ждёт её использования злоумышленниками, но на вопрос, станет ли она «значительным изменением ландшафта угроз», ответил: «Абсолютно нет».
Я читаю это так: у оценки уровня возможностей есть второй источник, CAISI. Проценты по защитным механизмам опираются на собственную симуляцию Anthropic, поэтому я воспринимаю их как утверждение, которое ещё ждёт второго теста. Направление частично подтверждено: на более ранней странице CAISI о GLM-5.2 сказано, что защитные механизмы модели «допускают помощь в разработке киберэксплойтов в агентном режиме».
Почему цифры не сходятся
Если поставить три источника в одну таблицу, различия видны ещё до появления любых цифр:
| CAISI | UK AISI | Anthropic | |
|---|---|---|---|
| Кто | Государственный институт США при NIST | Государственный институт Великобритании | Компания, конкурирующая с Z.ai |
| Проверенная модель | GLM-5.3 | GLM-5.2 и DeepSeek V4-Pro | GLM-5.3 и GLM-5.3-Flash |
| Что считается успехом | Доля решённых заданий; на ExploitBench - балл по шкале до 16 за задание | Доля решённых узких заданий из 70; пройденные шаги в учебной сети | Число полных эксплойтов от начала до конца из 410 попыток; доля испытаний на 100 заданиях |
| Попытки | Лучшая из трёх на ExploitBench | Пять на узкое задание; 10 прогонов на The Last Ones | Подсчёт по 410 попыткам |
| Главный вывод | Самая мощная модель с открытыми весами; значительно ниже передового американского уровня; отставание около четырёх месяцев | Модели с открытыми весами отстают на 4-7 месяцев | Выводы о возможностях в целом совпадают с выводами CAISI; в собственной симуляции, не повторённой CAISI и AISI, защитные механизмы обойдены в 64-100% образцов |
Возьмём ExploitBench, единственный бенчмарк, который запускали и CAISI, и Anthropic. CAISI ставит за каждое задание балл по шкале до 16 и берёт лучшую из трёх попыток, так что модель, прошедшая часть пути, получает часть баллов. Anthropic считает только полный результат: эксплойт, который работает от начала до конца.
Эти два числа отвечают на разные вопросы, поэтому я не ставлю их в одну строку. Одно измеряет, как далеко модель в среднем продвигается, другое - как часто она доходит до конца.
Различаются и эталоны сравнения. CAISI сравнивает GLM-5.3 с лучшей американской моделью, которую протестировал на каждом бенчмарке (в эту группу входят и релизы с доступом для доверенных пользователей, и публичные), а Anthropic сравнивает её со своей Claude Mythos Preview. Заметка Cloud Security Alliance видит напряжение между подачей Anthropic и оценкой CAISI «значительно ниже» и говорит, что разница сильно зависит от того, какой бенчмарк и какой американский образец для сравнения взяты.
Кибератаки ИИ: шесть вопросов к любому заголовку
Вот вопросы, которые я теперь задаю, прежде чем повторить какую-либо цифру.
- Кто измерял? Государственный институт, лаборатория, поставщик или создатель модели? CAISI и AISI - государственные структуры; Anthropic - компания, а собственная таблица бенчмарков Z.ai - заявление создателя.
- Каким методом? Смотрите на тип заданий, единицу измерения результата и число попыток. Балл по шкале до 16 и число полных эксплойтов - разные вещи.
- При каких защитных механизмах? CAISI тестировал американские модели с отключёнными защитными механизмами (где это применимо), а Anthropic для графиков возможностей запускала свои модели Claude без защиты. Результат с отключённой защитой показывает, на что модель способна, и мало говорит о том, что она станет делать.
- Что осталось за рамками? CAISI исключил невыпущенные модели, на полигонах AISI нет активных защитников, а AISI тестировал предшественницу модели из заголовка.
- Кому выгоден ответ? Компании, которая продаёт закрытые модели, выгодно, когда модели с открытыми весами выглядят рискованными. Создателю выгодно, когда его модель выглядит сильной. Есть мандат и у государственного института: отчёт CAISI по замыслу сравнивает модели США и КНР, а часть его метода, бенчмарк OSS-Fuzz, не публикуется.
- Что можно сравнивать? Только цифры по одним и тем же заданиям, с теми же попытками и теми же защитными механизмами. Если единицы измерения различаются, сравнивайте направление вывода, а проценты оставьте в покое.
О чём тесты не говорят
Отчёты оставляют открытыми три вопроса.
- Реальные атаки. Цифр о реальных атаках с использованием GLM в этих отчётах я не нашёл. Тесты проводятся в лабораториях, песочницах и симуляциях.
- Собственные цифры создателя. Z.ai публикует таблицу бенчмарков для GLM-5.3, в том числе киберпоказатели. Я считаю её заявлением создателя и не использую её цифры здесь.
- Будущее. Разрыв AISI не предсказывает скачки, которые закрытые передовые модели совершили в апреле 2026 года, поэтому измеренные им от четырёх до семи месяцев, как и четыре месяца CAISI, описывают прошлое и не являются прогнозом.
Что это значит для компании вне сферы безопасности
Выдуманный пример: в компании 40 человек, у неё есть сайт, интернет-магазин и список клиентов в CRM (системе, где хранятся данные о клиентах). Заголовок сообщает, что ИИ теперь может сам атаковать браузеры.
Выводы отчётов для такой компании скромны. Вывод AISI - окно возможностей для защитников, а совет NCSC, на который он ссылается, - вкладываться в базовые меры кибербезопасности (cybersecurity baselines), то есть минимальный набор мер для любой организации, и в защиту, усиленную ИИ.
Остальное - мои собственные выводы, а не выводы отчётов. Во второй сессии Anthropic публичные сведения о раскрытой уязвимости и ещё одном известном изъяне за короткое время превратились в работающий эксплойт, и это заставляет меня спрашивать, как быстро устанавливаются обновления. Я предлагаю четыре небольших шага, а какие из них подходят, решаете вы:
- Спросите ИТ-подрядчика, как быстро устанавливаются обновления программ, и как вы узнаете, если они запаздывают.
- Составьте список ИИ-инструментов и агентов, у которых есть доступ к вашим аккаунтам, и того, что каждый из них может делать с этим доступом. Моя статья об ИИ-агентах для маркетинга описывает схему, которой пользуюсь я.
- Оставьте человека в цепочке согласования всего, что агент отправляет за пределы компании. Эту практику я описываю в статье о проверке ИИ человеком (human-in-the-loop), а средства контроля вокруг агента - в статье о безопасности ИИ-агентов.
- Просите у поставщиков доказательства по шести вопросам выше и считайте утверждение без метода маркетингом.
Сколько это стоит
В отчётах есть несколько цифр о стоимости, и у каждой должен быть свой источник.
- Оценка AISI для моделей с открытыми весами. Прогон киберполигона на 100 миллионов токенов обошёлся примерно в 85 USD для Opus 4.5 и Opus 4.6, по оценке в 46 USD для GLM-5.2 и в 1,19 USD для DeepSeek V4-Pro. Это цены по прейскуранту, поэтому реальные затраты на вычисления могут отличаться.
- Оценка Anthropic для аблитерации. Anthropic сообщает, что при первом применении техники ушло около 2 200 GPU-часов (часов работы графических процессоров), примерно 4 400 USD, а для команды, знакомой с ней, оценивает затраты ближе к 600 GPU-часам, 1 200 USD. Обе цифры принадлежат самой Anthropic, и ни один независимый тест их не подтвердил.
- Стоимость реальной атаки. Данных нет. Ни один прочитанный мной источник её не приводит.
Для маркетинговой команды самая важная цифра, на мой взгляд, не входит в этот список. Это стоимость одного ошибочного одобрения со стороны агента, у которого есть доступ к вашим аккаунтам, а она зависит от средств контроля, которые вы настроите.
Таблица для чтения следующего заголовка
Эта таблица применяет шесть вопросов к случаю GLM-5.3, и вы можете использовать её для следующего заголовка.
| Вопрос | Где искать ответ | Пример из случая GLM-5.3 |
|---|---|---|
| Кто измерял? | Первый абзац и страница «О нас» | CAISI (правительство США), AISI (правительство Великобритании), Anthropic (конкурент Z.ai) |
| Каким методом? | Примечания о методе и подписи к рисункам | Агент с bash и python; балл по шкале до 16 против полных эксплойтов из 410 |
| При каких защитных механизмах? | Раздел о настройке | Американские модели тестировались с отключёнными защитными механизмами, где это применимо |
| Что осталось за рамками? | Раздел об ограничениях | Невыпущенные модели исключены; полигоны без активных защитников; AISI тестировал GLM-5.2 |
| Кому выгодно? | Кто публикует, кто продаёт, кого называют | Anthropic не публикует свои веса; Z.ai продаёт GLM; отчёт CAISI сравнивает модели США и КНР |
| Что можно сравнивать? | Единица каждой цифры | Сравнивайте вывод о том, что GLM-5.3 - самая сильная модель с открытыми весами, а проценты держите раздельно |
Частые вопросы
Что такое CAISI?
CAISI - это Center for AI Standards and Innovation, государственная структура США при NIST. Он оценивает передовые модели ИИ, в том числе китайские, и публикует свои выводы.
Что такое британский AI Security Institute?
Это государственная структура Великобритании, которая тестирует передовой ИИ. Он проводит киберпроверки на узких заданиях и на имитированных сетях, а его июльский анализ оценил разрыв между моделями с открытыми весами и закрытыми моделями.
Что такое ИИ в кибербезопасности?
Это два применения: модели, которые помогают защитникам, например читают журналы событий или находят изъяны раньше атакующих, и модели, которые помогают атакующим делать ту же работу быстрее. Тесты в этой статье измеряют второе применение, чтобы оценить риск.
Может ли ИИ провести кибератаку самостоятельно?
В учебной сети AISI из 32 шагов GLM-5.2 дошла примерно до 11-го шага и остановилась, а активных защитников в сети не было. Anthropic описывает две сессии, в которых модели GLM строили работающие эксплойты при ограниченном внимании человека. Цифр о реальных атаках я не нашёл.
Опаснее ли GLM-5.3, чем американские модели?
CAISI находит её кибервозможности значительно ниже передового американского уровня, причём в этот уровень входят и релизы с доступом для доверенных пользователей, а не только публичные модели. Разница в способе развёртывания: AISI объясняет, что когда веса публичны, мониторинг нельзя применять повсеместно, а обучение отказам часто легко обратимо.
Чем бенчмарк отличается от реальной атаки?
Бенчмарк - это фиксированный набор заданий с оценкой в лаборатории. Реальная атака сталкивается с мониторингом, обновлениями и людьми, которые реагируют, а в учебных сетях из этих отчётов их нет.
Почему разные тесты дают разные цифры?
У них разные задания, разные единицы оценки, разное число попыток и разные настройки защитных механизмов. Цифры можно сравнивать, только если всё это совпадает.
Стоит ли маркетинговой команде беспокоиться?
Я советую спокойную реакцию: проверьте, как быстро у вас устанавливаются обновления, узнайте, у каких ИИ-инструментов есть доступ к вашим аккаунтам, и пусть человек одобряет всё, что уходит за пределы компании. Отчёты измеряют кибервозможности и ничего не говорят о маркетинговой работе.
Мой вывод
Результат любого теста на кибератаки ИИ - это измерение, сделанное кем-то, по определённому методу, в определённых условиях. Метод говорит больше, чем заголовок, а шесть вопросов легко применить.
По GLM-5.3 из этих отчётов у меня складывается такая картина: модель лидирует среди моделей с открытыми весами и на месяцы отстаёт от закрытого передового уровня, а её защитные механизмы зависят от того, как её развёртывают. У оценки уровня возможностей два источника, CAISI и Anthropic, которые по-разному описывают расстояние до передового уровня. У процентов по защитным механизмам источник один, и это компания, заинтересованная в результате.
Бизнесу, который использует ИИ-агентов, я бы советовал сосредоточить внимание на том, до чего агенты могут дотянуться и кто утверждает их действия, потому что эта часть в ваших руках.