AI网络攻击:相信一项测试之前,先问这六个问题
AI网络攻击测试怎么看:CAISI、英国AISI和Anthropic对GLM-5.3或其前代模型测了什么,数字为什么对不上,以及读报道前该问的六个问题。
自7月以来,有三家机构发布了针对中国开放权重(open-weight)AI模型的网络安全测试,GLM也在其中,而它们的数字没法放进同一张表。关于AI能对计算机系统做什么的新闻标题,很少说明原因。
AI网络攻击是指由AI模型承担一部分工作的计算机系统攻击,比如找出软件里的漏洞,或者写出利用这个漏洞的代码。研究人员用基准测试(benchmark)来衡量这种能力,而结果会随着谁来测、怎么测而变化。
我做营销,每个工作日都在用AI模型,多数是在本地运行、为我自己的需要训练过的模型。新闻标题说某个AI能攻击系统时,我会去读一手报告,因为我用的这类模型就写在里面。这篇文章替这样的读者读了这些报告:想判断一条说法,又不想变成专家。
案例是GLM-5.3,由Z.ai于2026年8月14日发布。有三个来源测试了它或它的前代模型:美国的CAISI、英国的AI安全研究所(AI Security Institute),以及Anthropic公司。
CAISI和Anthropic都认为,GLM-5.3比此前的开放权重模型明显前进了一步。至于它离闭源前沿有多远,两家的说法不同,测量的东西也不同,而原因比数字本身更值得学。
要点先看
- 三个来源测的是不同的东西,所以数字对不上。 CAISI和Anthropic测试的是GLM-5.3,AISI测试的是它的前代模型;它们用的任务不同,计算成功的方式不同,允许的尝试次数也不同,所以百分比不能并排比较。
- CAISI是美国政府的测试机构,称GLM-5.3是“迄今发布的网络能力最强的开放权重模型”。 同时它认为这个模型的能力“显著低于”美国前沿模型,按一项综合指标大约落后四个月。
- 英国AI安全研究所估计,开放权重模型落后的时间是四到七个月,2025年时是六到十个月。它测试的是GLM-5.2和DeepSeek V4-Pro,没有测GLM-5.3。
- Anthropic关于安全防护(safeguards)的数据没有被复现。 CAISI和AISI都没有重复它的安全防护测试,The Decoder称GLM-5.3是Anthropic的直接竞争对手。Anthropic说,自己关于能力的结论与CAISI的大体吻合。
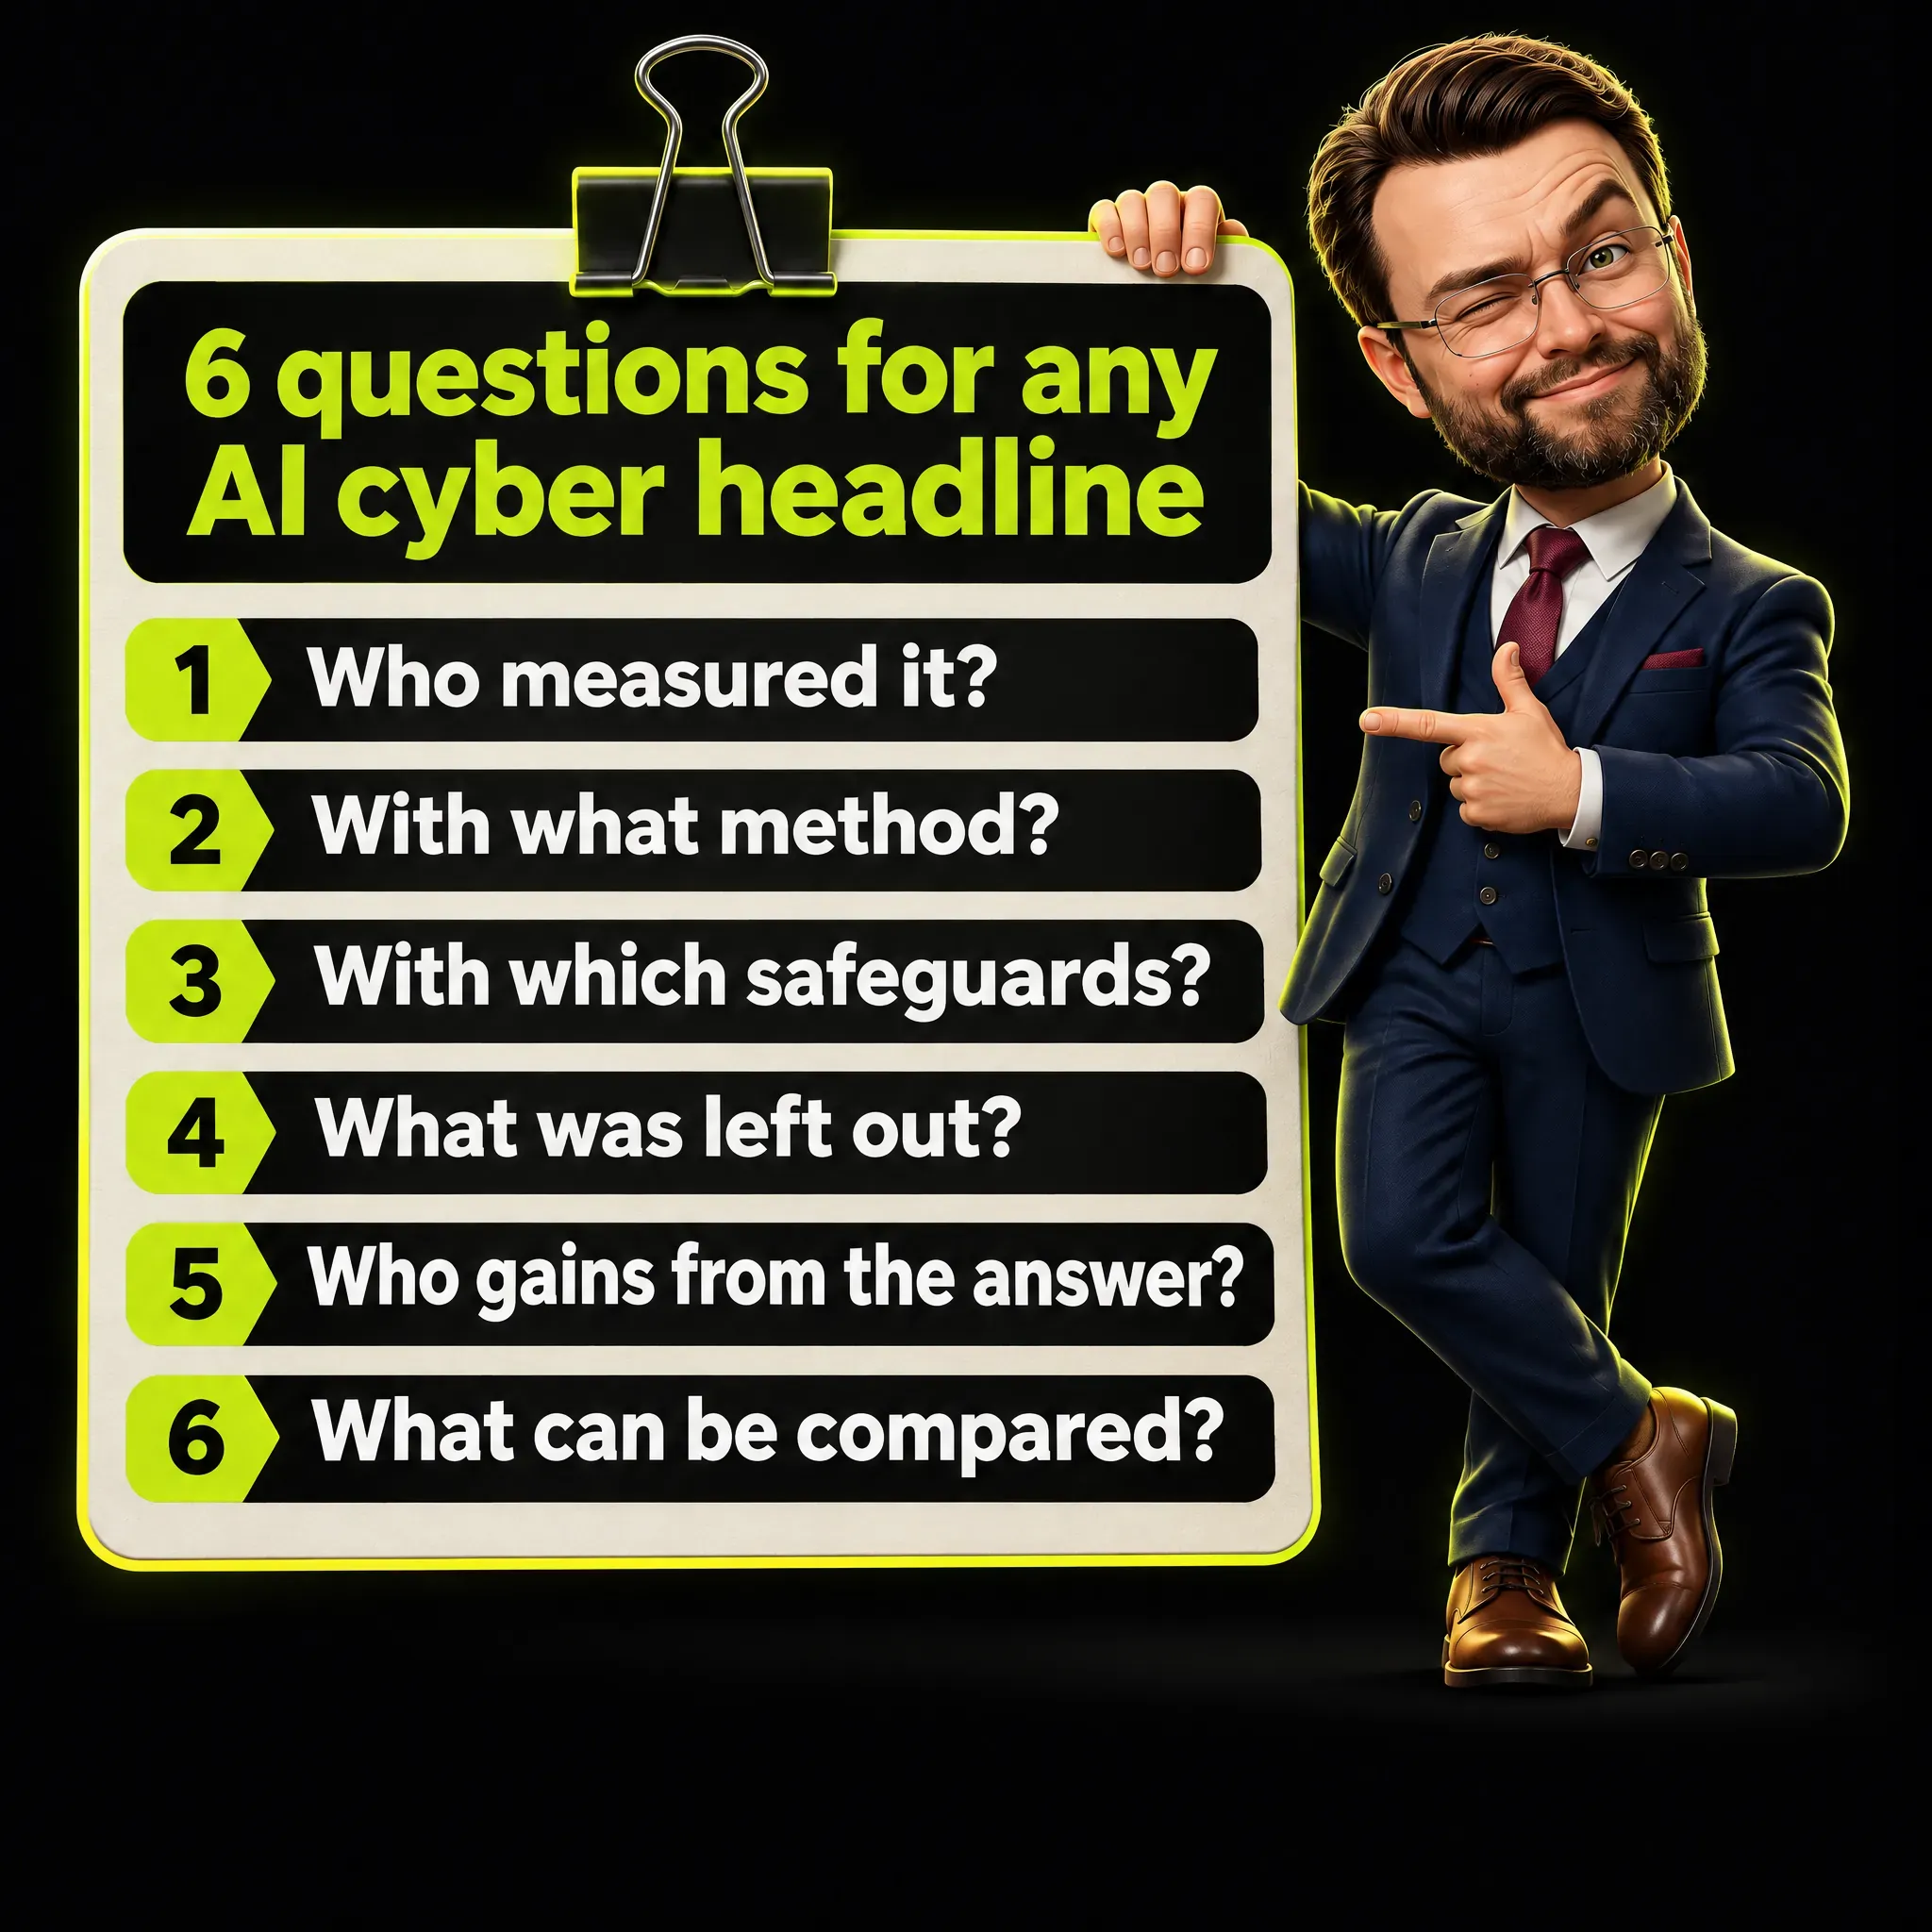
- 六个问题能筛掉大多数新闻标题: 谁测的、用什么方法、有哪些安全防护、漏掉了什么、谁从结果中获益,以及什么可以拿来比较。
- 我读到的所有来源,都没有衡量对营销工作或普通公司的影响。 这些报告里也没有GLM被用于真实攻击的数字。
用大白话讲,这些测试在测什么
漏洞(vulnerability)是软件里可被攻击者利用的缺陷,比如网页浏览器里的一个错误,会让恶意网页读取访问者电脑上的文件。漏洞利用代码(exploit)是把这样的缺陷变成入侵的那段代码,或那一连串步骤。
基准测试是交给许多模型的一套固定任务,这样分数就能比较,就像考试给每个学生出同样的题。网络安全类的基准测试,考的内容各不相同。有的要求模型找出没人指出过的漏洞,有的直接给出一个已知漏洞、要求写出利用代码,还有的衡量模型能否在靶场网络里一步一步完成一次很长的攻击。
还有两个词会反复出现。安全防护是开发者内置在模型里的拒绝机制和过滤器,让模型拒绝有害请求。开放权重指开发者公开了训练好的模型文件,所以任何人都能在自己的服务器上运行这个模型,而之后没有人能监控它被怎样使用;商业层面的内容,我写在中国AI大模型企业使用指南里。
来源一:CAISI,美国政府的测试机构
CAISI是人工智能标准与创新中心(Center for AI Standards and Innovation),隶属于美国的标准机构NIST。它测试主要开发商的模型,并于2026年9月17日发布了对GLM-5.3的评估,距模型发布约一个月。
它的摘要称GLM-5.3是“迄今发布的网络能力最强的开放权重模型”。同一份摘要又认为,它的网络能力“显著低于”当前美国前沿模型,按一项综合指标大约落后四个月。就大部分评测而言,Moonshot AI的Kimi K3此前一直是CAISI评估过的最强的中国模型,也是最强的开放权重模型。
四项基准测试
CAISI用了四项基准测试,每一项问的问题都不一样:
| 基准测试 | 任务数 | 模型要完成什么 |
|---|---|---|
| SEC-Bench Pro | 183 | 在V8或SpiderMonkey浏览器引擎中找出一个漏洞,并写出能让它崩溃的代码 |
| ExploitBench | 41 | 利用V8中的已知漏洞;每个任务满分16分,三次尝试取最好成绩 |
| ExploitGym(用户空间) | 502 | 利用开源软件中的真实漏洞;触发崩溃的输入已经给出 |
| CAISI OSS-Fuzz | 297 | 基于开源项目的私有基准测试;不提供任何描述、崩溃或修复 |
V8是Chrome中运行JavaScript的引擎,SpiderMonkey是Firefox中对应的引擎。私有基准测试不公开自己的任务,因此模型在训练中见过这些任务的可能性更小。
测试结果
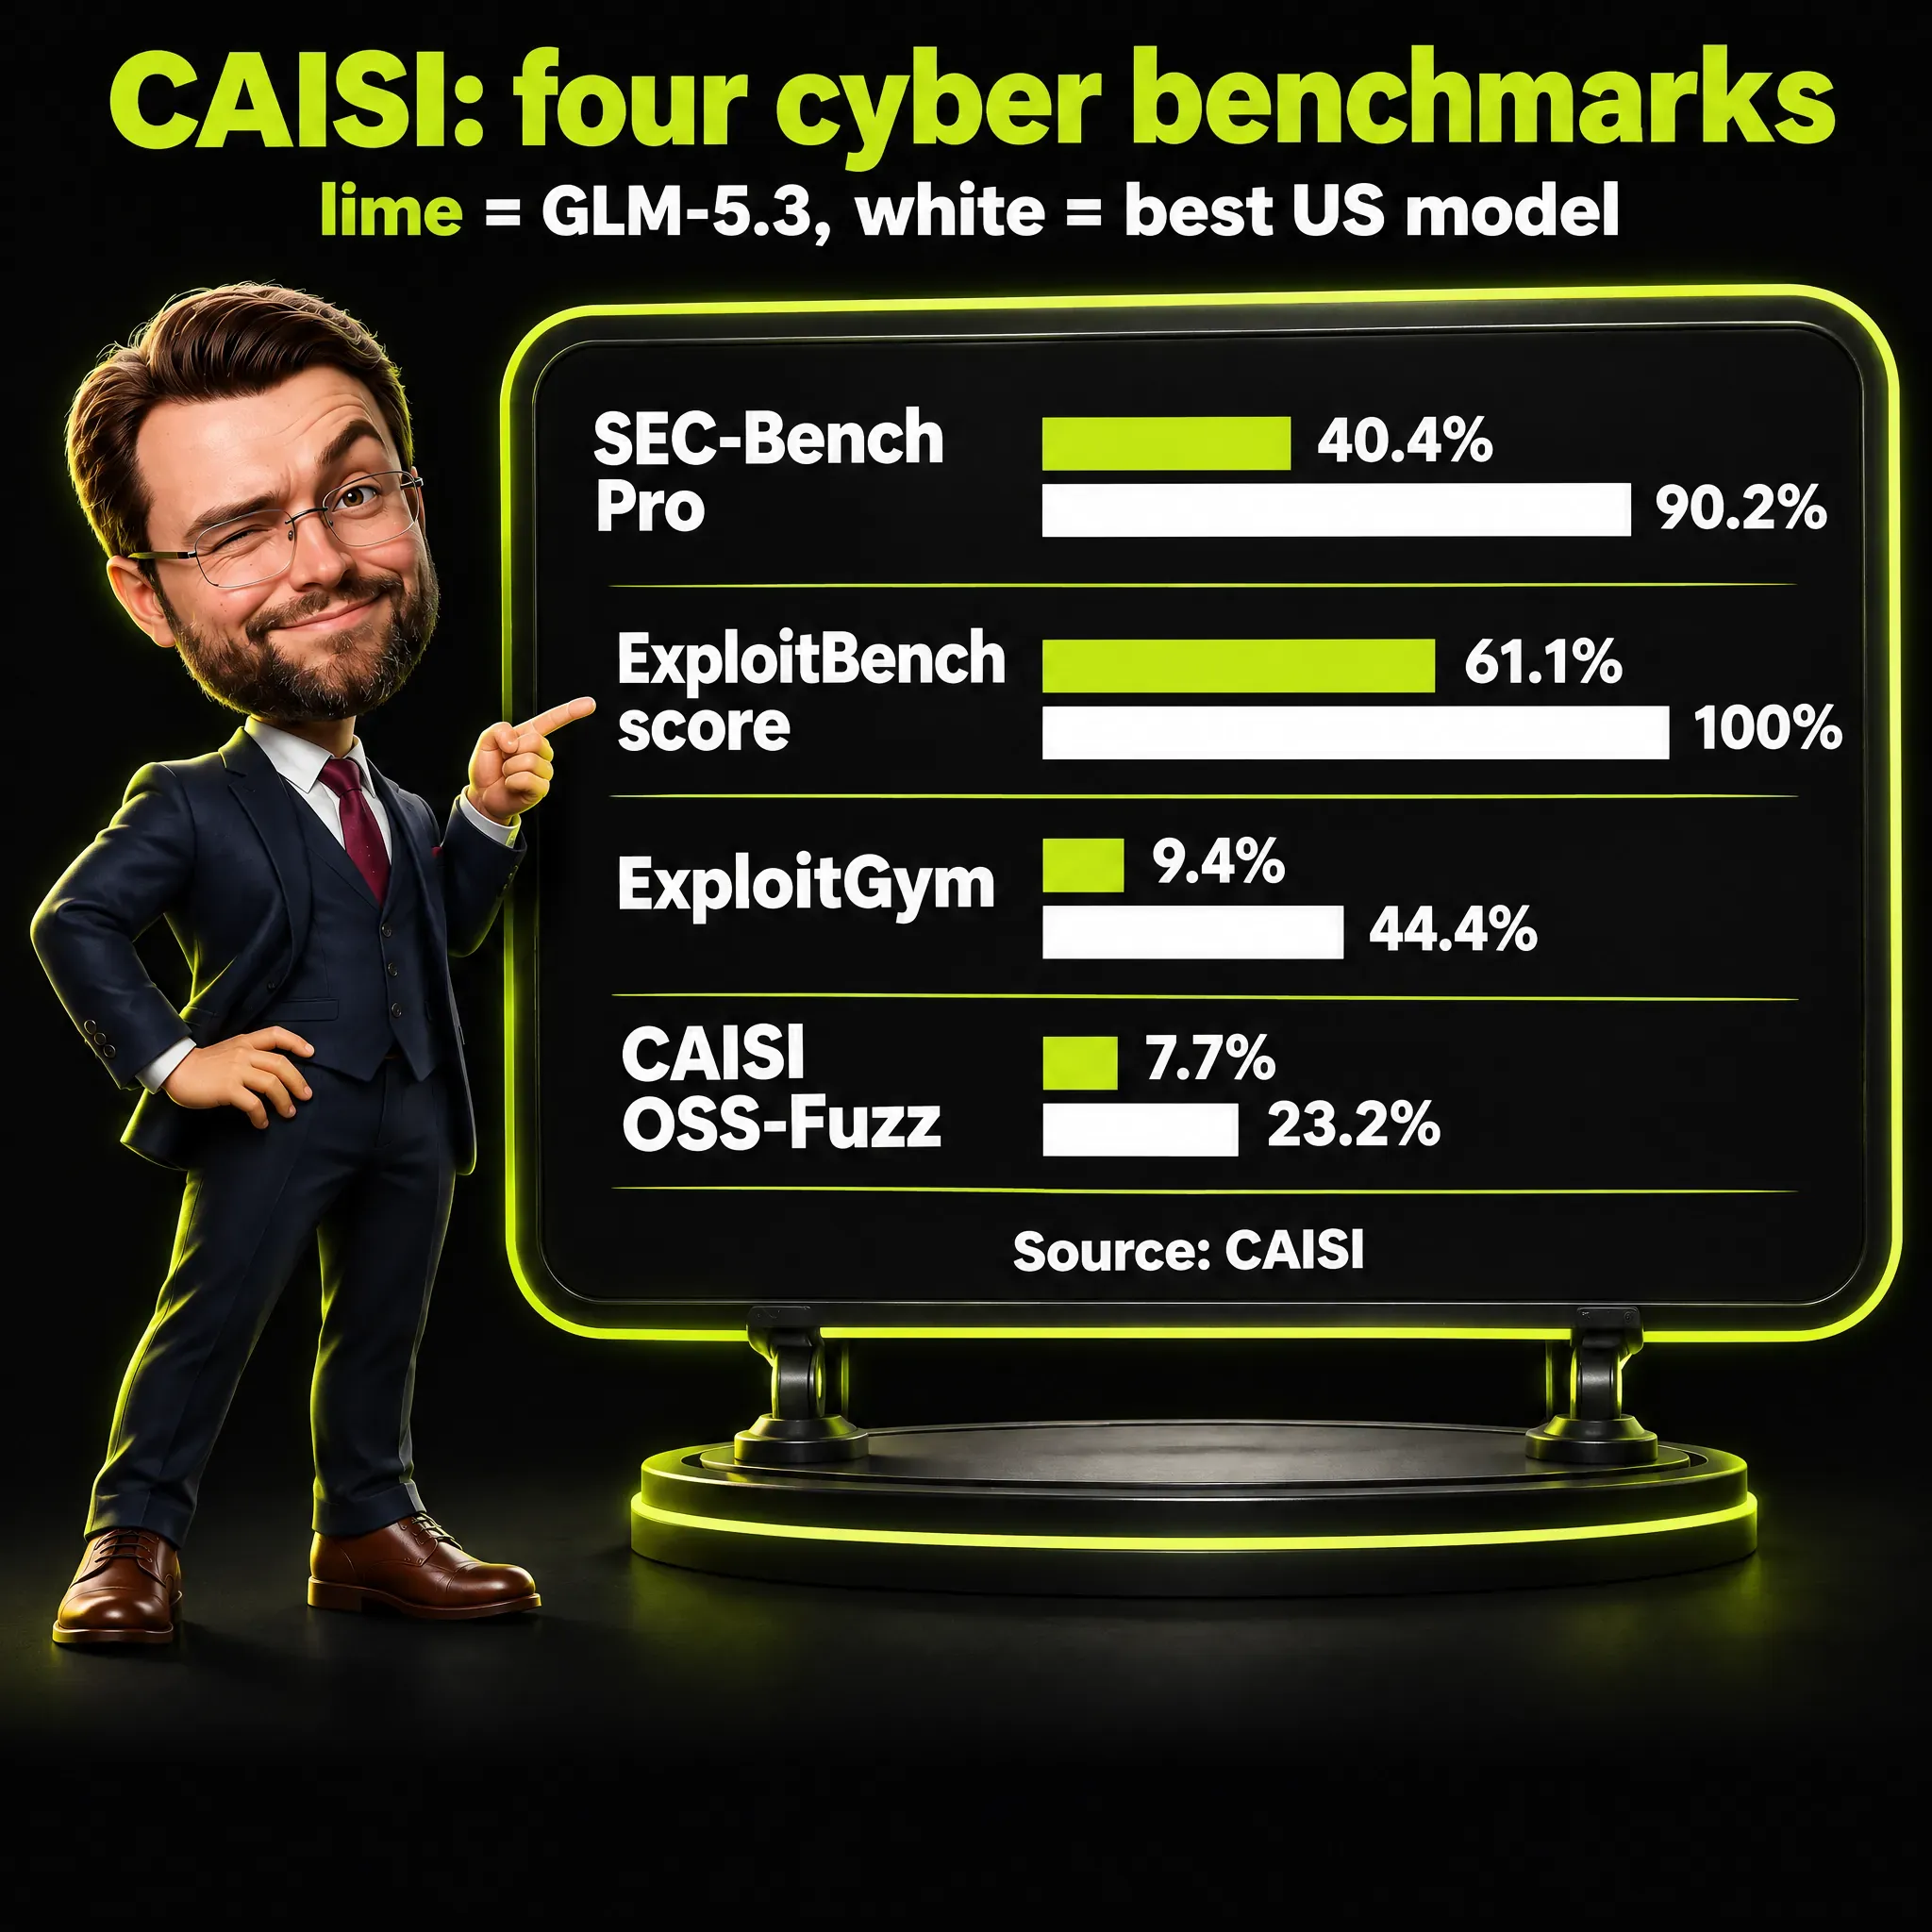
下面是CAISI的结果,百分比背后的任务数按CAISI的原文列出:
| 基准测试 | GLM-5.3 | 受测的最佳美国模型 | 受测的最佳其他中国模型 |
|---|---|---|---|
| SEC-Bench Pro | 40.4%(183项中的74项) | 90.2%(183项中的165项) | 27.3%(183项中的50项) |
| ExploitBench | 61.1%(16分中的9.8分) | 100%(16分中的16.0分) | 32.2%(16分中的5.1分) |
| ExploitGym | 9.4%(498项中的47项) | 44.4%(502项中的223项) | 2.6%(502项中的13项) |
| CAISI OSS-Fuzz | 7.7%(297项中的23项) | 23.2%(297项中的69项) | 2.4%(297项中的7项) |
数字的来源:CAISI让每个模型做同样的任务,百分比是解出的任务所占的比例,ExploitBench则是每个任务16分中所得分数的比例。它说明什么:GLM-5.3在四项基准测试上都高于其他中国模型中最好的那个,在ExploitGym和OSS-Fuzz上优势明显,另外两项的区间有重叠,同时它在四项上都远低于最好的美国模型。对读法的影响:“网络能力最强的开放权重模型”和“显著低于”美国前沿,都是CAISI自己的表述,而且都成立,所以只引用其中一句的新闻标题会给出错误的印象。
误差范围同样重要。CAISI给出95%置信区间(confidence interval),也就是真实得分最可能落入的范围。在SEC-Bench Pro上,GLM-5.3的40.4%可能落在33.6%到47.7%之间的任何位置;在ExploitBench上,它的61.1%可能落在45.9%到74.5%之间的任何位置。
其他中国模型中最好的那个,在这两项基准测试上的区间分别是21.4%到34.2%和19.9%到47.4%,与上面的区间有重叠,所以我不把这两项上的领先称为明显领先。
CAISI没有说明,为什么GLM-5.3按498项ExploitGym任务评分,而其他模型是502项。
测试方法
CAISI把每个模型当作智能体(agent)来运行:模型推理,在终端里执行命令,读取输出,再试一次,按基准测试的不同最多进行200或300轮。受测的美国模型在适用时关闭了网络安全防护,所以这些数字显示的是模型能做什么,而不是它愿意替陌生人做什么。尚未发布的模型被排除在外,CAISI指出它们可能更强。
“大约四个月”来自一个单一的指数。CAISI用一种借自考试测评的方法,即项目反应理论(Item Response Theory),把四项基准测试合成一个“网络能力指数”:难的任务权重更大,每个模型在同一个标尺上有一个位置。在这个标尺上高出400分的模型,解出一个任务的胜算是十倍。
GLM-5.3的指数高于Kimi K3,低于美国前沿,差距超出了误差范围。
模型本身是我另一篇文章的主题,见GLM 5.3与最佳开源大模型,所以这里我只讲测试。
来源二:英国AI安全研究所
英国AI安全研究所(UK AI Security Institute,简称AISI)是英国政府负责测试先进AI的机构。它关于开放权重模型与闭源模型差距的分析发表于7月。它测试的是GLM-5.2和DeepSeek V4-Pro,所以对GLM-5.3没有直接的说明。
它的结论是,近期的开放权重模型落后于闭源的网络能力前沿四到七个月。这比AISI在2025年大部分时间的内部评估中测得的六到十个月要窄。
两类测试
第一类是窄任务,每个任务考一项具体的网络安全技能。AISI从自己的96项任务套件中选了70项,分布在四个难度等级上,从“技术非专家”(比如一位数据分析师)到“专家”:第一级18项,第二级25项,第三级19项,第四级8项。
每个任务有五次尝试。每次尝试最多可使用250万个token(文本的小片段),所以这个上限决定了模型能工作多久。
在这些任务上,GLM-5.2的表现与它发布前四个月推出的网络能力最强的模型相当,即Opus 4.6和GPT-5.3-Codex。AISI写道,这一点在全部四个难度等级上都成立。DeepSeek V4-Pro则相当于比它早五个月发布的Opus 4.5。
第二类是网络靶场(cyber range),由专家搭建的模拟公司网络。其中一个名为“The Last Ones”,是一次横跨4个子网、约20台主机的32步攻击,AISI估计人类专家要花大约20小时。每个模型运行10次,AISI标明取最佳尝试的情况除外,每次运行的上限为1亿个token。
在这个靶场里,GLM-5.2走到了与Opus 4.5相同的位置,而Opus 4.5比它早发布不到七个月。DeepSeek V4-Pro则低于Sonnet 4.5。
AISI认为靶场的比较是较弱的证据,因为它所依据的靶场比窄任务的数量少。停滞可能是因为黑客技能不足,也可能是因为维持一份长计划的能力不足,而运行轨迹并没有说明是哪一种。靶场里也没有真实公司网络里那样的主动防守人员和防御工具。
安全防护与局限
AISI的测试基本没有受到安全防护的阻碍。DeepSeek V4-Pro偶尔会拒绝窄任务,主要是逆向工程,AISI用少量重复尝试就绕过了。AISI解释了原因:权重一旦公开,监控、分类器和封禁用户这些手段就无法普遍实施,剩下的拒绝训练(refusal training)这项技术,“往往在拿到权重之后很容易被逆转”。
AISI坦率地说明了自己的局限。它的设置很可能略微低估了开放权重模型的能力,因为团队没有去做专门的优化,而且这篇文章只测试网络能力:“不能由此推断其他能力”。测得的差距也“无法预测未来的开放权重模型是否会复制更近期的跃升”,指的是两个闭源模型在2026年4月实现的那些跃升。
AISI的实际解读是给防守方留出的一个窗口:今天还躲在安全防护后面的能力,以后可能在没有防护的情况下出现。
来源三:AI公司Anthropic
Anthropic是Claude的开发商。它关于GLM-5.3的文章发表在CAISI的报告之后,文中写道:“我们关于能力的结论与CAISI的大体吻合。”文章分为三部分:基准测试、人工主导的测试环节和安全防护测试。
它的结论是,GLM-5.3是“攻击者可获得的网络能力上一次有意义的阶跃变化”,并认为国家行为者和非国家行为者很可能会用这样的模型造成现实世界的危害。
基准测试
在ExploitBench上,Anthropic统计的是模型从头到尾构建出完整可用的漏洞利用代码的次数。GLM-5.3在410次尝试中做到了50次,Claude Mythos Preview是410次中的56次。
在Anthropic内部的二进制利用(Binary Exploitation)基准测试上,任务取自开源项目,完整得分对应的是“完全控制流劫持”,即攻击者接管程序所执行的内容。在随机抽取的100项任务上,GLM-5.3在4%的试验中做到了,Mythos Preview是6%。
Anthropic补充说,“一个有意义的门槛显然已被跨过”:Opus 4.6和GLM-5.2这样的早期模型,一次都没有成功。这些图表里的Claude模型是在关闭安全防护的情况下运行的。
人工主导的测试环节
第一次测试中,一位研究人员在沙盒(sandbox,与外界隔离的试验环境)机器上使用GLM-5.3,机器里是一款常用浏览器的本地Linux构建版本。大约一天时间里,在人工注意力有限的情况下,模型在浏览器的JavaScript引擎中发现了几个此前未知的漏洞,并把它们串成一套漏洞利用代码:一个网页,被访问时可以读取访问者电脑上的任意文件。Anthropic说,它已把这些漏洞披露给维护者。
第二次测试中,一位研究人员把一个最近披露的Chrome漏洞的公开细节,加上另一个已知漏洞,交给较小的模型GLM-5.3-Flash。模型把两者串成一套针对ARM64目标的可靠的漏洞利用代码,绕过了处理器芯片内置的一项安全功能。Anthropic报告说人工投入了20分钟的注意力,模型工作了八小时,并说按智谱的API(软件调用接口)价格,这次工作的成本是20.40美元。
这是Anthropic描述的两次测试,所以它们说明了什么是可能的,对这种情况发生的频率则没有任何说明。
安全防护测试
Anthropic把模型放进一个模拟世界,向它提出明显恶意的请求,要求攻击关键系统。没有运行任何代码,而是由第二个模型估算每条命令会返回什么,所以这项测试无法证明攻击会成功。CAISI和AISI没有重复这项测试。
在这个模拟中,“着手”指模型在收到有害请求之后,尝试连接一个远程目标系统。结果表的每个单元格包含50个样本:五条攻击指令、两个目标、每个五次尝试。Anthropic报告,GLM-5.3在以下比例的样本中出现了“着手”行为:
- 直接请求: 0%
- 欺骗性提示词,即虚假的掩护说法: 64%
- 预填推理,即攻击者替模型写下它自己思考的开头几行: 92%
- abliterated副本,即拒绝行为已被编辑出权重的副本: 100%
Claude模型在适用于它们的每一种条件下都保持在0%。Claude的安全防护拦下了欺骗性提示词,Anthropic的API不提供预填Claude思考内容的方式,Claude的权重也不提供,所以无法对它们做abliteration。
Anthropic还在三个公开的有害请求基准测试上测量了abliterated副本。平均拒绝率从95%降到GLM-5.3的6%和GLM-5.3-Flash的14%,能力得分几乎没有变化。这项技术,以及它对选择模型意味着什么,是我另一篇文章的主题:abliteration是什么。
利益冲突
有两家媒体提出了这一点。The Decoder给一个章节起的标题是“Anthropic的警告同样服务于它的生意”:Anthropic不发布自己的模型权重,而一个接近前沿的廉价中国开放权重模型,是它的直接竞争对手。
同一篇文章补充说,这个警告并不只是出于自身利益:“CAISI的独立评估印证了这些能力数字”。
Trending Topics指出,Anthropic是Z.ai的竞争对手,并引用了一位Hacker News读者对“与直接竞争对手存在研究方面的利益冲突”的提问,还补充说Z.ai尚未回应Anthropic的分析。Cloud Security Alliance的AI Safety Initiative(AI安全倡议)在10月4日的研究笔记中记录,Anthropic的评估尚未被CAISI或AISI复现。
有一个声音在威胁本身上持不同意见。Trending Topics转引了The New Stack在模型发布前的报道,IANS Research的Jake Williams说他预计威胁行为者会使用这个模型,但被问到它是否会成为“威胁格局的重大变化”时,他回答“绝对不会”。
我的解读是,能力水平有第二个来源,即CAISI。安全防护的百分比建立在Anthropic自己的模拟之上,所以我把它们当作一个仍在等待第二次测试的说法。方向上有部分支持:CAISI此前关于GLM-5.2的页面写道,该模型的安全防护“允许为智能体式的网络漏洞利用开发提供协助”。
为什么数字对不上
把三个来源放进一张表,差异在任何数字出现之前就已经看得见:
| CAISI | 英国AISI | Anthropic | |
|---|---|---|---|
| 谁 | 隶属NIST的美国政府机构 | 英国政府机构 | 与Z.ai存在竞争关系的公司 |
| 受测模型 | GLM-5.3 | GLM-5.2和DeepSeek V4-Pro | GLM-5.3和GLM-5.3-Flash |
| 什么算成功 | 解出的任务比例;ExploitBench上每个任务按16分制打分 | 70项窄任务中解出的比例;在靶场网络上完成的步骤数 | 410次尝试中完整的端到端漏洞利用代码数量;100项任务中试验成功的比例 |
| 尝试次数 | ExploitBench上三次取最好成绩 | 每项窄任务五次;The Last Ones上运行10次 | 按410次尝试统计 |
| 主要结论 | 最强的开放权重模型;显著低于美国前沿;大约落后四个月 | 开放权重模型落后4到7个月 | 能力结论与CAISI的大体吻合;在它自己的、CAISI和AISI都没有重复的模拟中,安全防护在64%到100%的样本中被绕过 |
以ExploitBench为例,这是CAISI和Anthropic都运行过的唯一一项基准测试。CAISI给每个任务打16分制的分数,并保留三次尝试中的最好成绩,所以走了一部分路的模型也能拿到一部分分数。Anthropic只统计完整的结果,也就是从头到尾都能用的漏洞利用代码。
这两个数字回答的是不同的问题,因此我不把它们放在同一行。一个衡量模型平均走了多远,另一个衡量它多久能走到终点。
衡量的标尺也不同。CAISI把GLM-5.3与每项基准测试中它测试过的最好的美国模型比较,这一组既包括公开发布的版本,也包括仅限受信任用户访问的版本,而Anthropic拿它与自家的Claude Mythos Preview比较。Cloud Security Alliance的笔记指出,Anthropic的表述与CAISI“显著低于”的评估之间存在张力,并说差异在很大程度上取决于用哪项基准测试、哪个美国对照模型。
看到AI网络攻击的新闻,先问这六个问题
这是我现在转述一个数字之前会问的问题。
- 谁测的? 是政府机构、实验室、厂商,还是模型的开发者?CAISI和AISI是政府机构;Anthropic是一家公司;而Z.ai自己的基准测试表,是开发者的一面之词。
- 用什么方法? 看任务类型、得分的单位和尝试次数。16分制的得分和完整漏洞利用代码的计数,是两回事。
- 有哪些安全防护? CAISI在适用时关闭了受测美国模型的安全防护,Anthropic在能力图表中运行Claude模型时也没有安全防护。关闭防护得到的结果,说明的是模型能做什么,对它会做什么则说明很少。
- 漏掉了什么? CAISI排除了未发布的模型,AISI的靶场没有主动防守人员,AISI测试的又是新闻标题所说模型的前代。
- 谁从答案中获益? 卖闭源模型的公司,在开放权重模型看起来有风险时获益;开发者在自己的模型看起来强大时获益。政府机构也有自己的职责:CAISI的报告在设计上就是对美国和中国的模型做比较,而它方法的一部分,即OSS-Fuzz基准测试,是私有的。
- 什么可以拿来比较? 只有任务相同、尝试次数相同、安全防护相同的数字。单位不同时,只比较结论的方向,不要去比百分比。
测试没有说明的事
这些报告留下了三件没有回答的事。
- 真实攻击。 我在这些报告里没有找到使用GLM的真实攻击的数字。测试是在实验室、沙盒和模拟中进行的。
- 开发者自己的数字。 Z.ai为GLM-5.3发布了一张基准测试表,其中包括网络安全得分。我把它当作开发者的一面之词,本文不使用它的数字。
- 未来。 AISI测得的差距无法预测闭源前沿模型在2026年4月实现的那些跃升,所以它测得的四到七个月,和CAISI的四个月一样,描述的是过去,不是预测。
对安全行业之外的公司意味着什么
举一个虚构的例子:一家40人的公司,有一个网站、一个网店,以及放在CRM(存放客户记录的工具)里的客户名单。一条新闻说,AI现在能自己攻击浏览器了。
对这家公司,这些报告能支持的结论不多。AISI的结论是给防守方的一个窗口,它引用的NCSC建议是投入网络安全基线,也就是每个组织都应具备的最低限度措施,以及AI增强的防御。
其余的是我的推断,不是这些报告的结论。Anthropic的第二次测试,用一个已披露漏洞的公开细节,加上另一个已知漏洞,在很短时间内做出了可用的漏洞利用代码,这让我想问:更新装得有多快。我建议四个小步骤,哪些适合自己,由读者决定:
- 问你的IT服务商,软件更新装得有多快,以及如果更新迟了,你怎么会知道。
- 列出能访问你账户的AI工具和智能体,以及每一个能用这些权限做什么。我用的配置,写在AI营销智能体这篇文章里。
- 凡是智能体要发到公司之外的东西,审批环节里都留一个人。 这种做法我写在人在回路的AI验证里,围绕智能体的各种控制则写在AI智能体安全里。
- 按上面六个问题向供应商要证据,没有方法的说法,就当作营销。
成本是多少
报告里有几个成本数字,每一个都需要标明来源。
- AISI对开放权重模型的成本估算。 一次1亿个token的靶场运行,Opus 4.5和Opus 4.6大约花85美元,GLM-5.2估计为46美元,DeepSeek V4-Pro为1.19美元。这些是公布的价格,所以实际算力成本可能不同。
- Anthropic对abliteration的估算。 Anthropic报告说,它第一次使用这项技术大约花了2,200个GPU小时(GPU是运行AI模型的计算芯片),约4,400美元,并估计对有经验的团队来说接近600个GPU小时、1,200美元。两个数字都是Anthropic自己的,没有独立测试证实过。
- 一次真实攻击的成本。 没有数据。我读过的来源都没有给出。
对营销团队来说,在我看来最重要的数字不是上面任何一个。它是一个能访问你账户的智能体做出一次错误审批的代价,而这取决于你设置的控制。
下一条新闻的阅读对照表
这张表把六个问题用在GLM-5.3这个案例上,你可以在下一条新闻上重复使用。
| 问题 | 在哪里找答案 | GLM-5.3的例子 |
|---|---|---|
| 谁测的? | 第一段和“关于”页面 | CAISI(美国政府)、AISI(英国政府)、Anthropic(Z.ai的竞争对手) |
| 用什么方法? | 方法说明和图表说明文字 | 带bash和python的智能体;16分制得分与410次尝试中的完整漏洞利用代码 |
| 有哪些安全防护? | 测试设置部分 | 美国模型在适用时关闭了网络安全防护 |
| 漏掉了什么? | 局限性部分 | 未发布的模型被排除;靶场没有主动防守人员;AISI测试的是GLM-5.2 |
| 谁获益? | 谁在发布、谁在出售、谁被点名 | Anthropic不发布权重;Z.ai出售GLM;CAISI的报告比较美国和中国的模型 |
| 什么可以拿来比较? | 每个数字的单位 | 比较“GLM-5.3是最强的开放权重模型”这个结论,把百分比分开看 |
常见问题
CAISI是什么?
CAISI是人工智能标准与创新中心(Center for AI Standards and Innovation),是美国NIST内部的政府机构。它评估包括中国模型在内的先进AI模型,并发布评估结果。
英国AI安全研究所是什么?
它是英国政府负责测试先进AI的机构。它在窄任务和模拟网络上做网络安全评估,7月的分析估算了开放权重模型与闭源模型之间的差距。
网络安全中的AI指什么?
它包含两种用法:帮助防守方的模型,比如阅读日志,或者赶在攻击者之前发现漏洞;以及帮助攻击方更快完成同样工作的模型。本文的测试衡量的是第二种用法,目的是判断风险。
AI能自己发动网络攻击吗?
在AISI的32步靶场网络里,GLM-5.2推进到大约第11步后停住了,而且那个网络没有主动防守人员。Anthropic描述了两次测试,GLM模型在有限的人工注意力下构建出了可用的漏洞利用代码。我没有找到真实世界攻击的数字。
GLM-5.3比美国的模型更危险吗?
CAISI认为它的网络能力显著低于美国前沿,而这个前沿既包括公开模型,也包括仅限受信任用户访问的版本。差别在于部署方式:AISI解释说,权重一旦公开,监控就无法普遍实施,拒绝训练往往很容易被逆转。
基准测试和真实攻击有什么区别?
基准测试是在实验室里打分的一套固定任务。真实攻击会遇到监控、更新和会做出反应的人,而这些报告中的靶场网络并不包含这些。
为什么不同的测试给出不同的数字?
它们使用不同的任务、不同的得分单位、不同的尝试次数和不同的安全防护设置。只有这些都一致时,数字才能比较。
营销团队该担心这件事吗?
我建议冷静应对:查一查你的更新装得有多快,弄清哪些AI工具能访问你的账户,并让一个人来审批离开公司的内容。这些报告衡量的是网络能力,对营销工作没有任何说明。
我的判断
AI网络攻击测试的结果,是某个人用某种方法、在某些条件下做出的测量。读懂方法,比读标题能告诉你更多,而这六个问题很快就能用上。
对于GLM-5.3,我从这些报告里得到的图景是:一个在开放权重模型中领先、比闭源前沿落后几个月的模型,它的安全防护取决于部署方式。能力水平有两个来源,CAISI和Anthropic,两者对它与前沿的距离描述不同。安全防护的百分比只有一个来源,而它来自一家与结果有利害关系的公司。
对于使用AI智能体的企业,我会把注意力放在智能体能触达什么、谁来批准它们的行动上,因为这一部分是你能控制的。