AI营销智能体:怎样确认它没有漏掉什么
AI营销智能体出错时往往悄无声息。我的设计是:脚本收集全部内容,AI通读全部内容,再用一项不依赖AI的检查来证明结果,并有意去破坏这些检查来测试它们。
AI营销智能体(AI marketing agent)很少会靠报错暴露问题。它出错的方式,是汇报说一切正常。
AI营销智能体是这样一种程序:由AI模型自己选择步骤和工具,去完成一个目标,比如盯着广告账户,或者阅读评论。这种自由是它的卖点,也是错误藏身的地方。
对任何智能体,我都会问同一个问题:我要怎样才能发现它错了?
我为自己的工作和咨询工作搭建这类工具,最后定下来的答案是一套三步设计。脚本收集全部内容,AI通读全部内容,再由一项不依赖AI的检查来证明结果。
本文依次讲智能体怎样悄悄出错、这三步、建立在这三步上的四项营销工作,以及我怎样测试这些测试。
要点先看
- 评判AI营销智能体,要看你怎样发现它的错误,而不是看它能做多少事。
- 固定规则只能找到你预料到的东西。 让脚本收集全部内容,让AI通读全部内容。阈值只用来排序,绝不用来决定看不看。
- AI检查AI,可能在不对的时候说“一切正常”。 要再加一道不依赖AI的证明。
- 有意去破坏自己的检查。 我测试过的一项检查,它的测试漏掉了我植入的缺陷中的大约四分之一。
- 成本按套餐用量的百分比来算,不按美元算。 智能体读写的内容,远比一次聊天多。
- 你常常需要的是工作流,不是智能体。 用能解决问题的最简单的办法。
AI营销智能体是什么,以及多数厂商卖的其实是什么
Anthropic(Claude背后的公司)划了一条值得借用的线。在指南《Building effective agents》里,它先写道:“工作流是通过预先定义的代码路径来编排LLM和工具的系统”,接着又写道:“而智能体是这样的系统:LLM动态地指挥自己的流程和工具使用,并保持对任务完成方式的控制”。本文中Anthropic的英文引文,均由我翻译。
说白了,工作流(workflow)是预先写好的食谱:来了X,就做Y;智能体则自己决定步骤。市面上当作智能体卖的东西,很多其实是食谱,而食谱没有问题,只要一项工作必须每次都以同样的方式运行,比如我的邮件通讯自动化流水线。按这个定义,我运行的大部分东西,是在中间加了一个AI阅读步骤的工作流,当光靠食谱看不到你没预料到的东西时,这就是正确的选择。
同一份指南里还有一条容易被略过的建议:“我们建议找到尽可能简单的方案,只在必要时才增加复杂度。这可能意味着根本不去构建智能体系统。”
它还警告:“智能体的自主性意味着更高的成本,以及错误不断累积的可能。”这里要紧的是累积,因为第二步里的一个错误,到第三步就会被当作事实来读。
这份指南写于2024年12月,讲的是一般意义上的智能体,不是营销工作,所以我借用它的概念,不借用它的任何工具。哪些营销任务应该最先自动化,这张地图在我那篇AI营销自动化的文章里,所以这里我只讲智能体本身。
AI营销智能体悄悄出错的三种方式
这些失败都不会产生报错信息。每一种产生的,都是一份平静而自信的报告。
规则只能找到你预料到的东西
10月24日,我要求做四个每日运行的智能体,分别负责Google Ads、转化率、新闻和社交帖子。AI起草的第一版设计,把阈值放在脚本里,只有被标记的信号才会唤醒AI去阅读。
我的异议很短:脚本分不出哪里出了问题,除非它先把全部内容提取出来,再交给AI去读。阈值只能找到你已经预料到的东西。最终的设计里,阈值和对比用来给清单排序、触发即时告警,但它们永远不是AI去看的前提条件。
下面是一个编出来的例子。假设你设了一条规则:广告花费涨幅超过30%就告警。一个网站不再记录联系请求,而花费保持平稳,什么都不会触发,报告说一切正常。
为了测试这个设计,我给新闻智能体写了一个测试。这个智能体对照一份登记表来读安全和平台新闻,登记表列出了我负责的网站和组件。测试从登记表里拿掉一项,PHP(许多网站运行所用的一种编程语言),然后检查两条关于PHP漏洞的新闻,是否仅凭内容仍然被标记出来。
在一台模拟服务器(只是假装成真服务器的那种)上,这个机制成立。登记表里有PHP时,这两条新闻被标为“登记表:是”,意思是它们涉及我负责的东西,随后发出两条即时告警。
没有它时,这两条新闻留在每日汇总(digest,智能体所读全部内容的编号清单)里,被标为“登记表:否”,不发即时告警,建议被标为“未验证”,严重程度低。从登记表里去掉一项,改变的是标签,绝不是AI读不读这条新闻。用真实模型跑一遍,是下一步。
检查者说“一切正常”
10月11日,一个AI助手审查了另一个AI生成的短片的第一段。它称这个结果是一次巨大的飞跃,还说手看起来没问题,却没有去数手臂:一条多出来的第三条前臂占满画面,持续了4.5秒。完整的经过,见我写的AI垃圾内容与审核瓶颈一文。
教训不是AI检查者没用。Anthropic自己关于测试智能体的建议,见文章《Demystifying evals for AI agents》:“我们建议尽可能选用确定性评分器,必要时或为获得更多灵活性才用LLM评分器,并审慎地使用人工评分器做额外验证。”AI评分器必须对照真人来校准,如果允许它在信息不足时回答“未知”(Unknown),效果会更好。
同一篇评测文章还说明,检查本身可能就是出问题的部分。一个模型在一项公开测试里得了42%,直到一位Anthropic研究员发现了若干问题,其中包括“死板的评分,期望答案为‘96.124991……’时,会把‘96.12’扣分”。评分的错误被修正、测试设置放宽之后,同一个模型得了95%。
数字从哪里来:一项针对AI模型的公开能力测试。意味着什么:很大一部分“失败”出在检查上,不在模型上。该改什么:在相信一个分数之前,先读一读它是怎么打出来的。
怎样读AI网络攻击这类测试的分数,我在AI网络攻击能力测试怎么看里列了六个问题。
Anthropic关于多智能体研究系统的文章,又补充了一条贴近营销的教训:“人工评估能发现自动化漏掉的东西。”人类测试员注意到,早期的智能体“总是选择经过SEO优化的内容农场,而不是权威但排名不那么靠前的来源,比如学术PDF或个人博客”。任何在网上做研究的营销智能体,都可能以同样的方式出错:答案听上去对,来源却是错的。
读到的只是一部分
第三种失败更隐蔽。智能体只读了某条规则标记出来的内容,或者只读了某个工具生成的摘要,而答案恰恰在没人看过的那一部分里。
一位客户的广告只在周一到周五投放,所以28天里广告可能在线的只有20天,不是28天。上一个周期里,广告在这20天中有20天在线,最近一个周期则是20天中只有7天,因为广告为了一次平台检查被暂停过。
只说流量下降的摘要,读起来像是崩盘。按每小时的投放时间表而不是按日历来数在线天数,才看出下降从何而来,也为对比放上了正确的基数。
在一个收集联系请求的网站上,525次会话中有242次,占46%,来自数据中心集中的国家,这些访问几乎全都没有来源网站,只看了一个页面,平均停留0.4秒,这是程序的行为方式,不是人的。这个数字一直就在表格里,没有任何阈值去找它。我怎样把这两个案例做成报告,写在我关于营销报告的文章里。
三步设计:脚本、阅读、证明
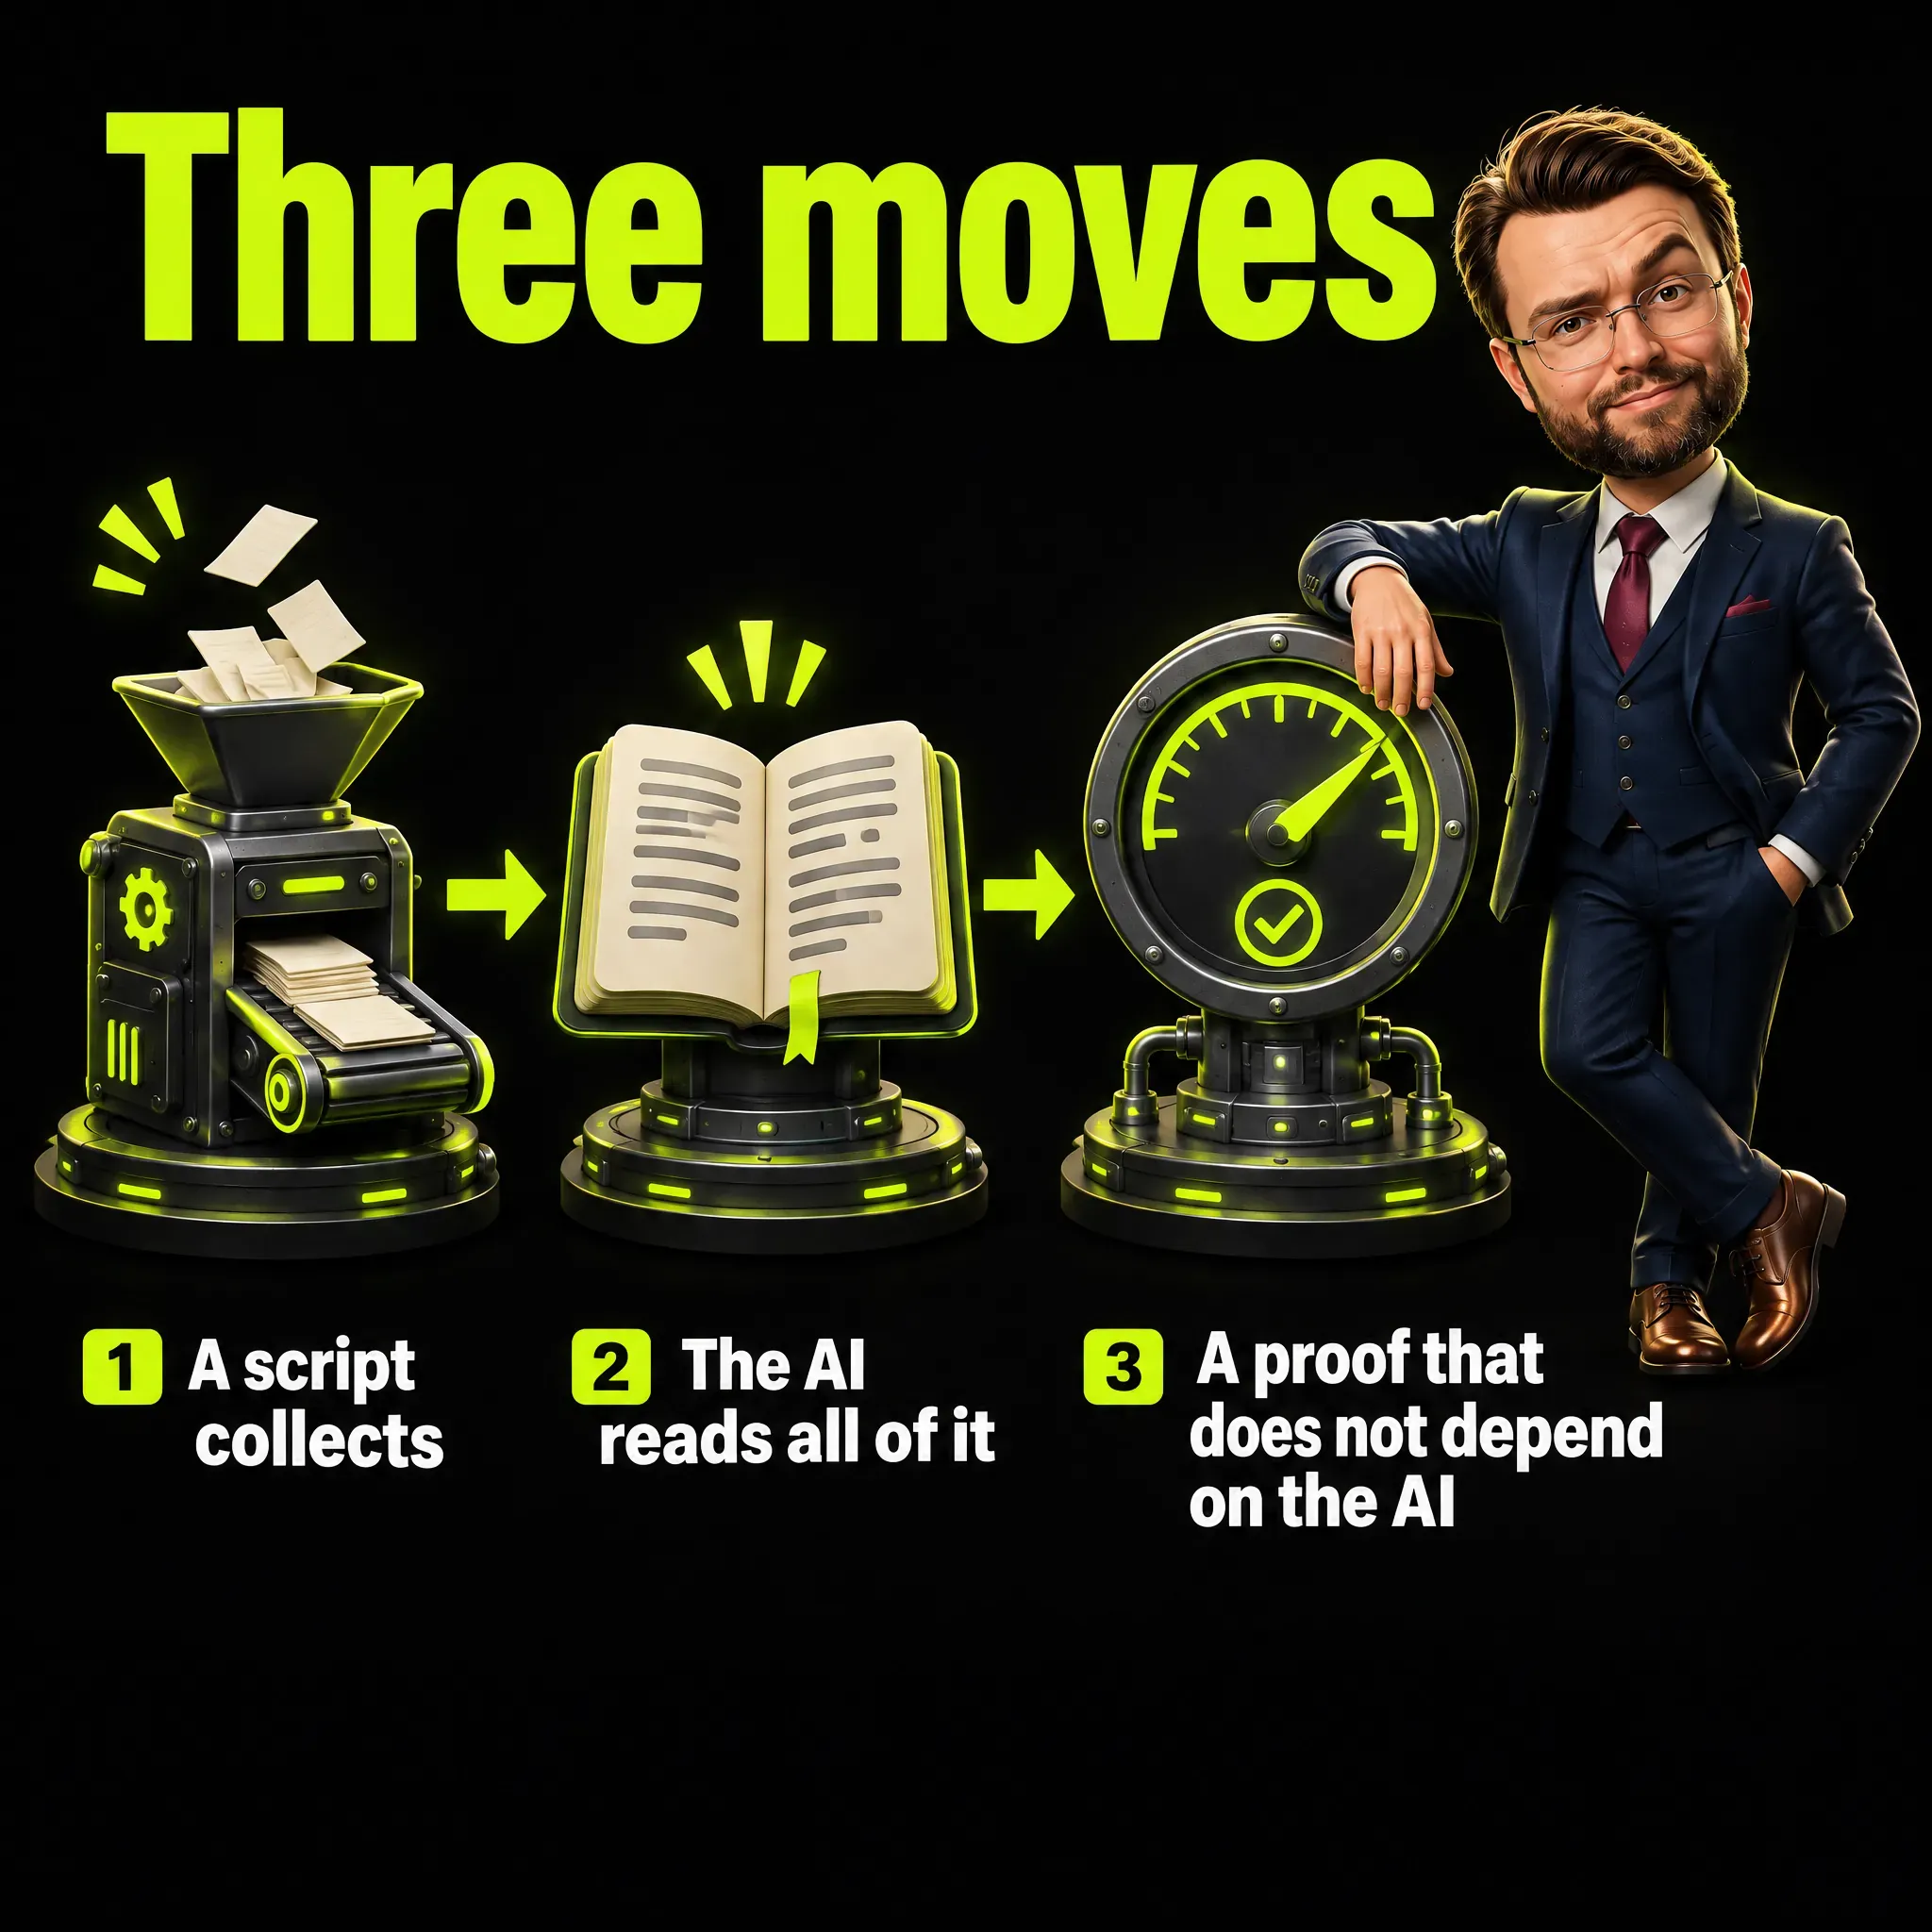
第一步:脚本收集全部内容。不用AI,也不花词元(token,模型读写的一小段文字)。脚本下载智能体要看的所有内容,并去掉重复。
然后它计算各种对比(与昨天比,与7天和28天的平均值比),给每一条打上标签,写成一份编号清单。我把它叫作汇总。
第二步:AI通读整份汇总。每逢有新内容的日子,模型就读完整份清单。它没有工具,不能上网,没有任何连接:它只读,然后返回结构化的建议。
别人写的文本,比如订阅源和网页,一律当作不可信的数据。严重程度、链接和代码由程序计算,AI按编号挑选条目,所以它编不出一个链接。网页和邮件里藏的指令怎样劫持智能体,见AI智能体安全与提示词注入。
第三步:一项不依赖AI的证明。Anthropic的指南写道:“对智能体来说,在每一步从环境中获得‘ground truth’(事实依据),例如工具调用的结果或代码执行的结果,以评估自己的进展,这一点至关重要。”
Anthropic用这个词指智能体在每一步从工具得到的结果,并补充说,智能体可以在检查点暂停,等待人工反馈。我把这个想法延伸到循环之外的检查。在营销里,事实依据是一项可能失败、又来自别处的检查:广告投放时间表、第二个数据源、一个迫使系统表现得和生产环境里一样的测试,或者一个批准花费的人。
为什么是这个顺序?脚本做不需要智能的那部分工作,成本低,每次都一样。AI只调用一次,去读已经整理好的材料。
Claude里也有同样的分工:一个技能可以装着写好的步骤和小程序,任务匹配时由Claude运行。哪些工作值得做成技能、带代码的技能为什么要先检查,见Claude Skills的风险。
四项营销工作,各用三步
下面是建立在这套设计上的四项工作,以及各自的状态。客户报告在运行,其中的Google Ads阅读也在报告里运行。追踪检查是一套经过测试的流程,还不是每日运行的智能体;评论阅读器的评分工具已经做好,每日运行的智能体还只是计划。
Google Ads监测
脚本为每个广告系列收集这些内容:花费、点击、转化、单次联系成本、展示次数份额(impression share,广告本可展示时实际展示的频率)、人们输入的搜索词、按每小时时间表算出的广告在线天数,以及与昨天、7天和28天平均值的对比。AI通读整份清单,返回的建议里带着数字、时间窗口和对比,从不返回操作。
证明如下:脚本按时间表数在线天数;转化与第二个数据源核对(网站分析里的联系请求,商店里的订单);未经我明确同意,不花钱,也不改任何东西,连暂停也一样。只读的阅读,已经在我的每周客户报告里运行。每日运行的智能体计划分两步:先给建议,再从一份封闭的清单里执行单独批准的操作,比如添加否定关键词(negative keyword,一个让广告不再对某类搜索展示的词),或暂停一个关键词或广告,绝不碰预算和出价。
追踪检查
脚本统计事件数,以及每个事件对应的不同人数,按国家和来源分开,再加上每次会话的时长、页面数和互动情况。它还会发送一条带测试参数的测试提交。AI通读整张表(国家、来源、互动三个维度交叉),以及重复出现的事件。
证明是一个浏览器测试:对网站服务器的每次调用都得到一个假的“ok”,对分析工具的每次调用都被记录下来,然后被拦截。这个测试在一位客户的网站上重现了一个表单事件到达两次、间隔50毫秒的情况。它解释了为什么数据里的四个“线索”事件,其实是两个人的三次表单提交,全是客户团队自己的测试联系。
早先版本的测试拦截了对网站服务器的调用,所以事件第二次触发的情况从未显现。我在10月11日修复了标签配置,并用同一个测试重新检查。同意方面的内容,见我的瑞士追踪同意检查清单(英文)。
客户报告
脚本以只读模式读取分析、搜索和广告数据,加上商店的订单总额(不含个人数据),以及一组网站检查,比如服务器响应、证书、安全标头、邮件认证、站点地图,还有按真实访客测得的速度。AI读本周为客户所做工作的日志,写出叙述部分的草稿,任何内容发出之前,我都会先读一遍。
证明:数字和总结句来自公式,所以没有哪个模型写过数字。缺失的值显示“n/a”,绝不显示零,对比用的是相同的天数。
有一道语气关卡(tone gate):当已经造成的真实损失还没有告诉客户时,它会拦下草稿,每个周期只发出一条消息。报告在运行,每条消息发给客户之前都由我批准。相关阅读:营销运营。
阅读评论
脚本从导出文件或截图里收集24小时和7天时的数据(展示次数、反应、评论、分享、收藏、主页访问),评论的文字和写评论的人,以及草稿的一个机械评分。AI读真实的评论,把它们归成主题和反复出现的问题,提出内容选题,并且每发四篇帖子,就给出一份总结和一条新规则。
证明:一个12项的评分,检查代码能验证的部分,其余交给我自己的判断,比如是否只有一个精确的想法,以及文字的口吻。我看的是数量级,不是10%的差异。
这个智能体从不自己回复或评论,帖子下的第一条评论由我手写。评分和导入器已经有了,配有44个自动化测试,每日运行的智能体还只是计划。
我如何测试AI营销智能体周围的那些检查
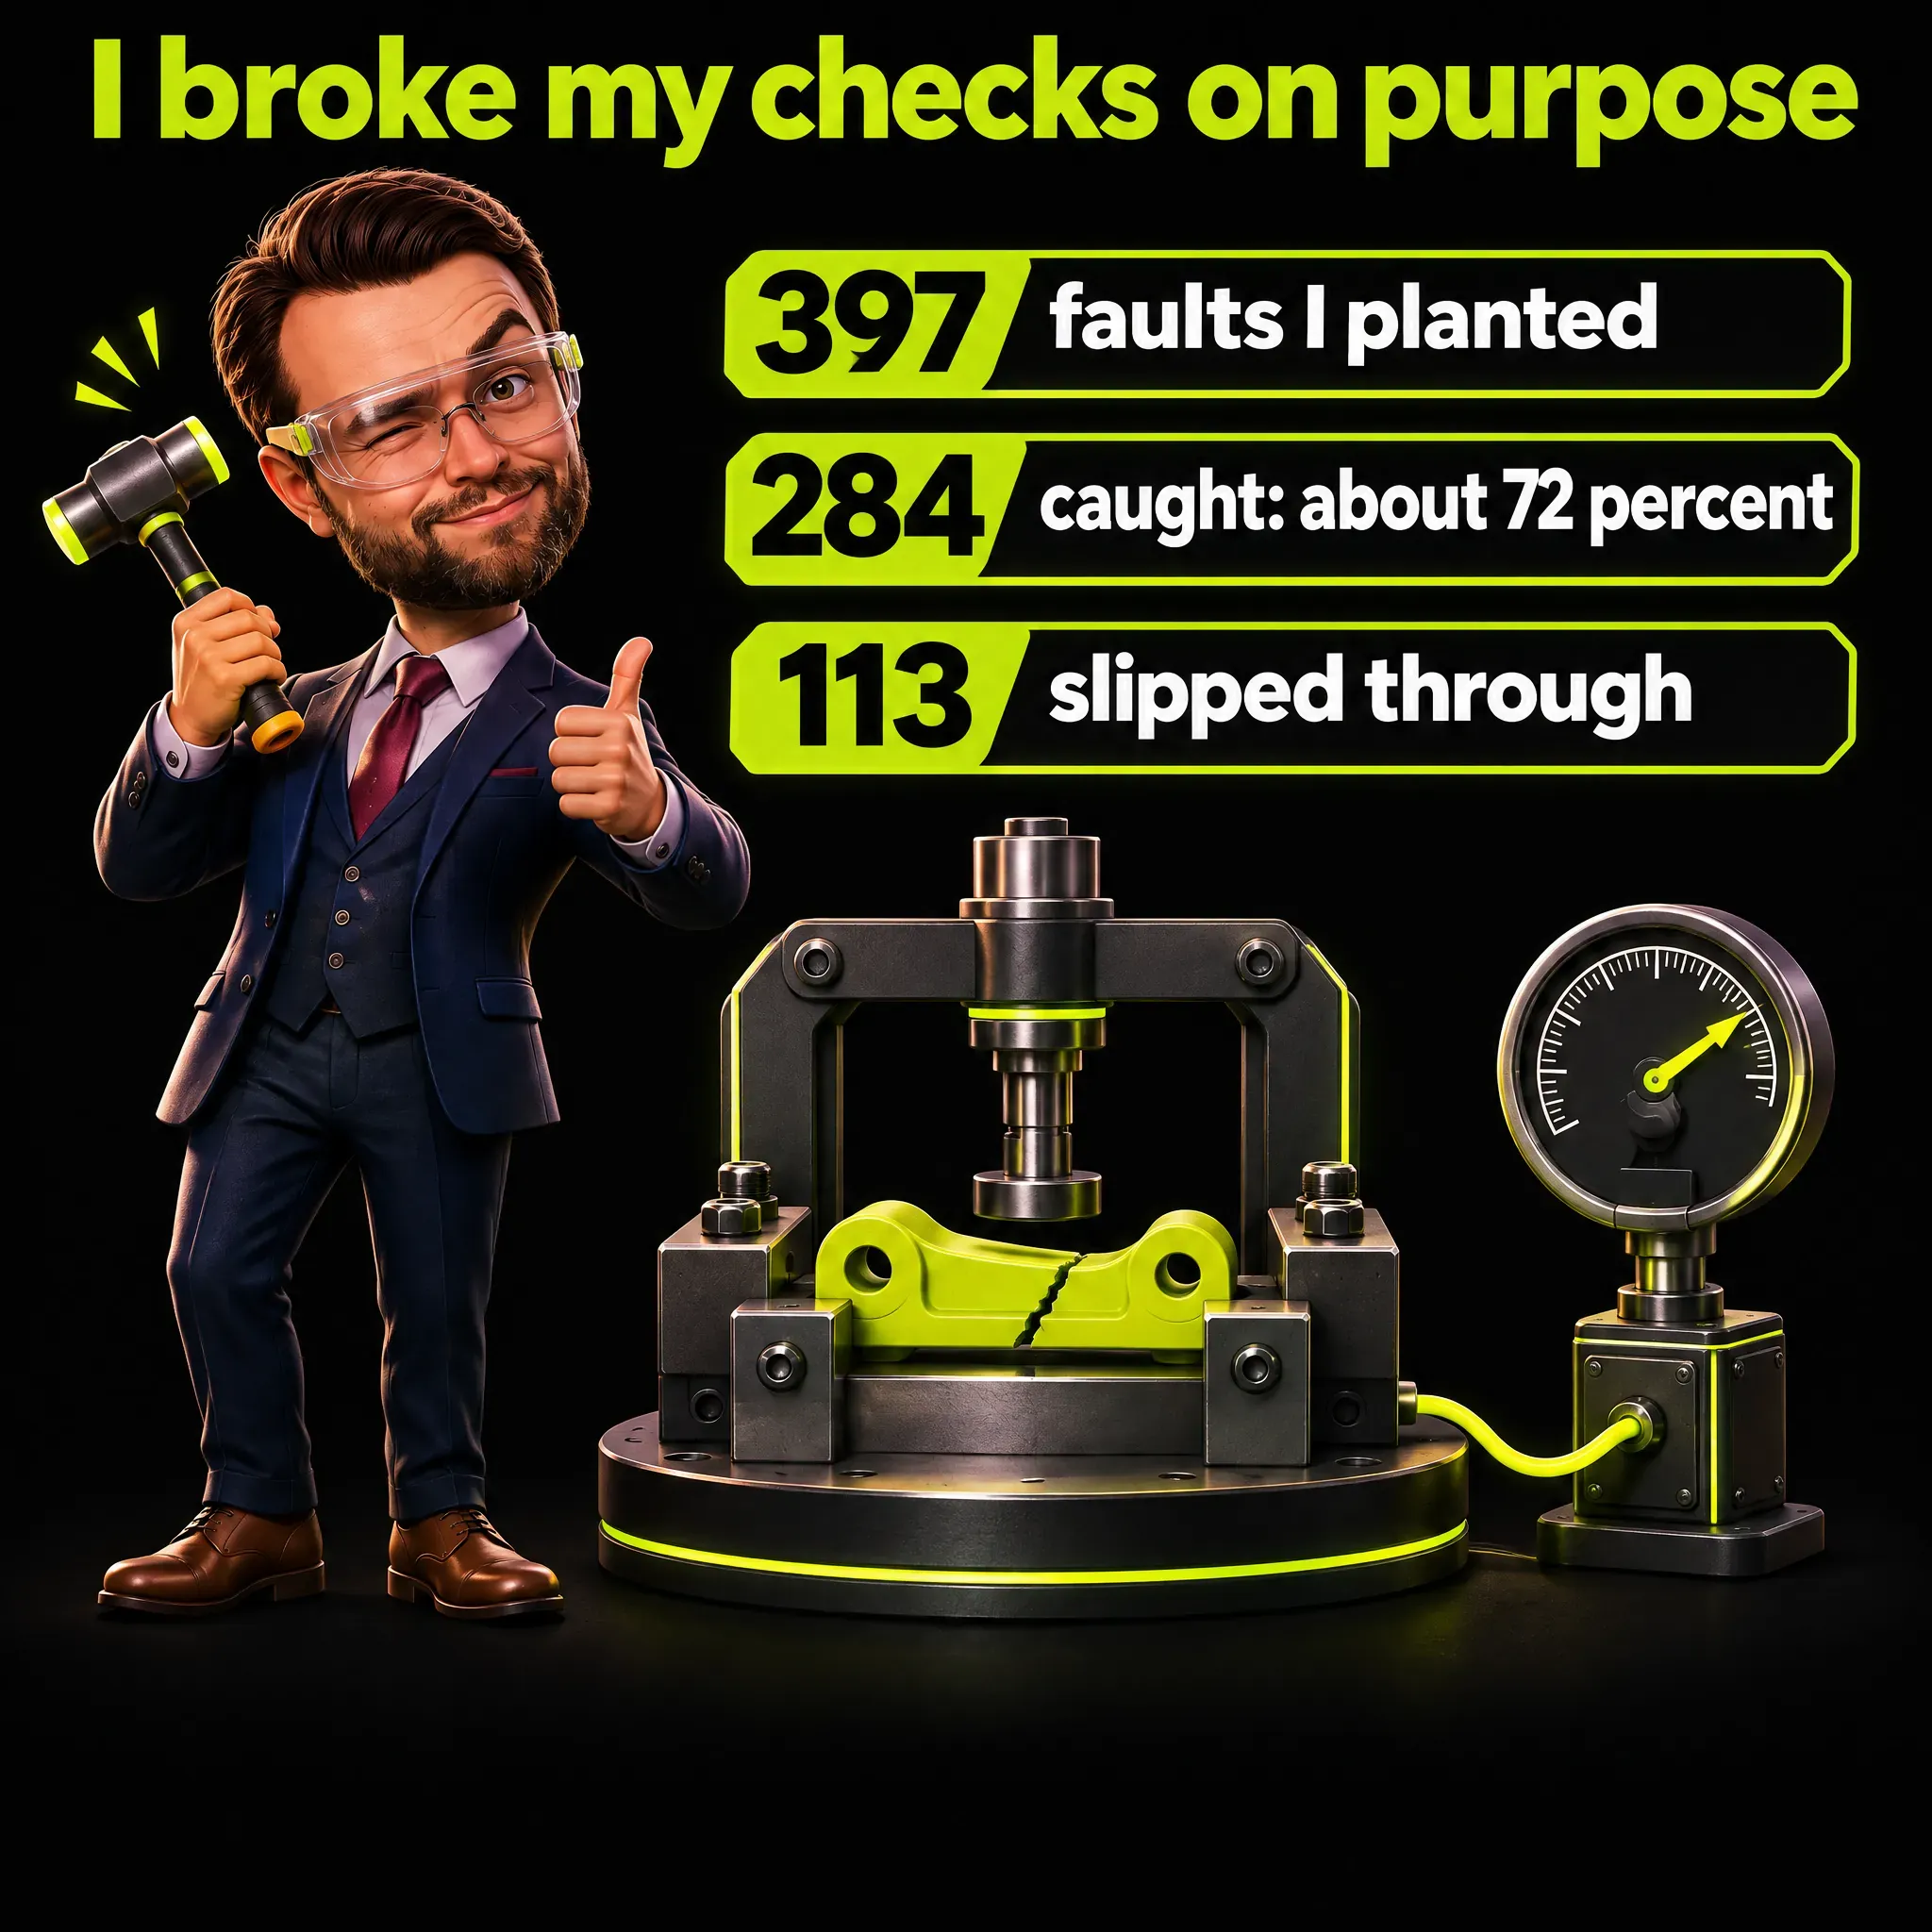
测试全绿说明不了什么,除非你试过让它们失败。我的方法是编造缺陷,一次一个放进代码的副本里,数测试抓到了多少。
这件事我做了三次。针对校验客户网站和组件清单的那项检查,我编造了399个缺陷,其中397个可以运行。测试当场抓住了284个,约占72%,另有113个漏网。
这113个里,12个是等效的,也就是没有改变行为,101个是真正的漏洞,我用新的检查补上了。真正的漏洞约占397个的25%。
数字从哪里来:往一项检查的副本里植入的编造缺陷。意味着什么:我植入最敏感的那项检查里的缺陷,大约每四个就有一个会被它自己的测试放过。该改什么:“全绿”不再是证明,而成了一个问题:这个测试试着去破坏过什么?
对于把文件发到服务器的那个脚本,我试了84个缺陷。测试抓住了78个,漏掉6个,其中补上了2个真正的漏洞,记录了4个等效缺陷。我在测试本身里发现一个漏洞之后,又加了4个缺陷,这次测试全部抓住。
更早的一轮是56个编造的缺陷,针对一套我当时认为不错的测试,结果是加入了新的检查,56个中抓到了56个。这个故事见AI垃圾内容与审核瓶颈一文。
第二件工具是第二个AI,当作一位没有听过我结论的审查者来用。它拿到的是代码,不是我对代码的说法,而且只能读。这使它在影片故事里的检查者失灵的地方依然有用:它没有可以附和的结论。
在新闻智能体上,我用了这样一位审查者:全新启动,对这项工作没有任何记忆,并设为高强度思考,它给出了9条发现。我修复了6条,每一条都先写了一个会失败的测试,因为没有先失败的测试,修复什么也证明不了。关于核查AI输出的更广泛习惯,见我关于人在回路的AI验证的文章。
AI营销智能体的成本:看套餐用量的百分比,不看美元
订阅制下,美元成本只是理论上的。真正要紧的数字,是套餐被用掉的比例,按5小时窗口和套餐报告的每周窗口来看。
让我真正体会到这一点的案例:10月17日和18日,一夜之间跑了三次长时间的智能体任务,一共约1500万词元(1110万加100万加310万),把每周额度在工作做到一半时用完了。智能体和其他所有事情在争同一个上限。
Anthropic给出了方向:“智能体通常比聊天多用约4倍的词元,多智能体系统比聊天多用约15倍的词元。”这些倍数来自Anthropic自己的研究系统,不是来自营销任务,所以我把它们当作警告,不当作测量。
我自己的数字,以及它们各自是什么:
- 校准,一个数量级。根据我10月18日的对话记录,每周的1%大约是64万个输出词元,也就是模型写出的文字。上面的1500万还包括智能体读的所有内容,所以这两个数字不能互相相除。
- 估算,不是实测。一次阅读大约消耗8,000至25,000个输入词元和1,000至2,000个输出词元。新闻智能体加上检查它建议的第二个AI,最多应该用掉每周约0.1%;一个每天读一个网站的智能体,应该用掉每周约0.2%至0.5%。
这一切针对的是我的整个账户,不是某一次运行,而套餐百分比只对按订阅付费的人适用。改变的是工作的顺序:先估算,分批启动,让脚本去做一切不需要阅读的事。
什么时候不需要AI营销智能体
- 做法已知。如果你能写出“如果X,就Y”,工作流成本更低,出错的方式也可以预料。我的客户报告正是因为这个原因,才用固定公式来运行。
- 走错一步代价高,又很难看出来。Anthropic警告过错误会累积。凡是出错会损失金钱或信任的地方,我都把花费、发给客户的消息和评论放在人工点头之后,并倾向于用工作流。
- 你说不出证明是什么。如果没有人能说出哪项检查会显示智能体错了,我建议不要开始。
如果你经营一家企业,而有人向你推荐一个智能体,我建议只问一个问题:哪项检查会告诉我们它错了?好的回答会点出第二个数据源、一张时间表或一个测试,糟糕的回答是“AI自己审查自己”。整个项目的失败是另一个话题,见为什么AI营销项目会失败;本文讲的是另一种更安静的失败:一个一直在运行的智能体所犯的错。
让AI营销智能体独立运行之前的检查清单
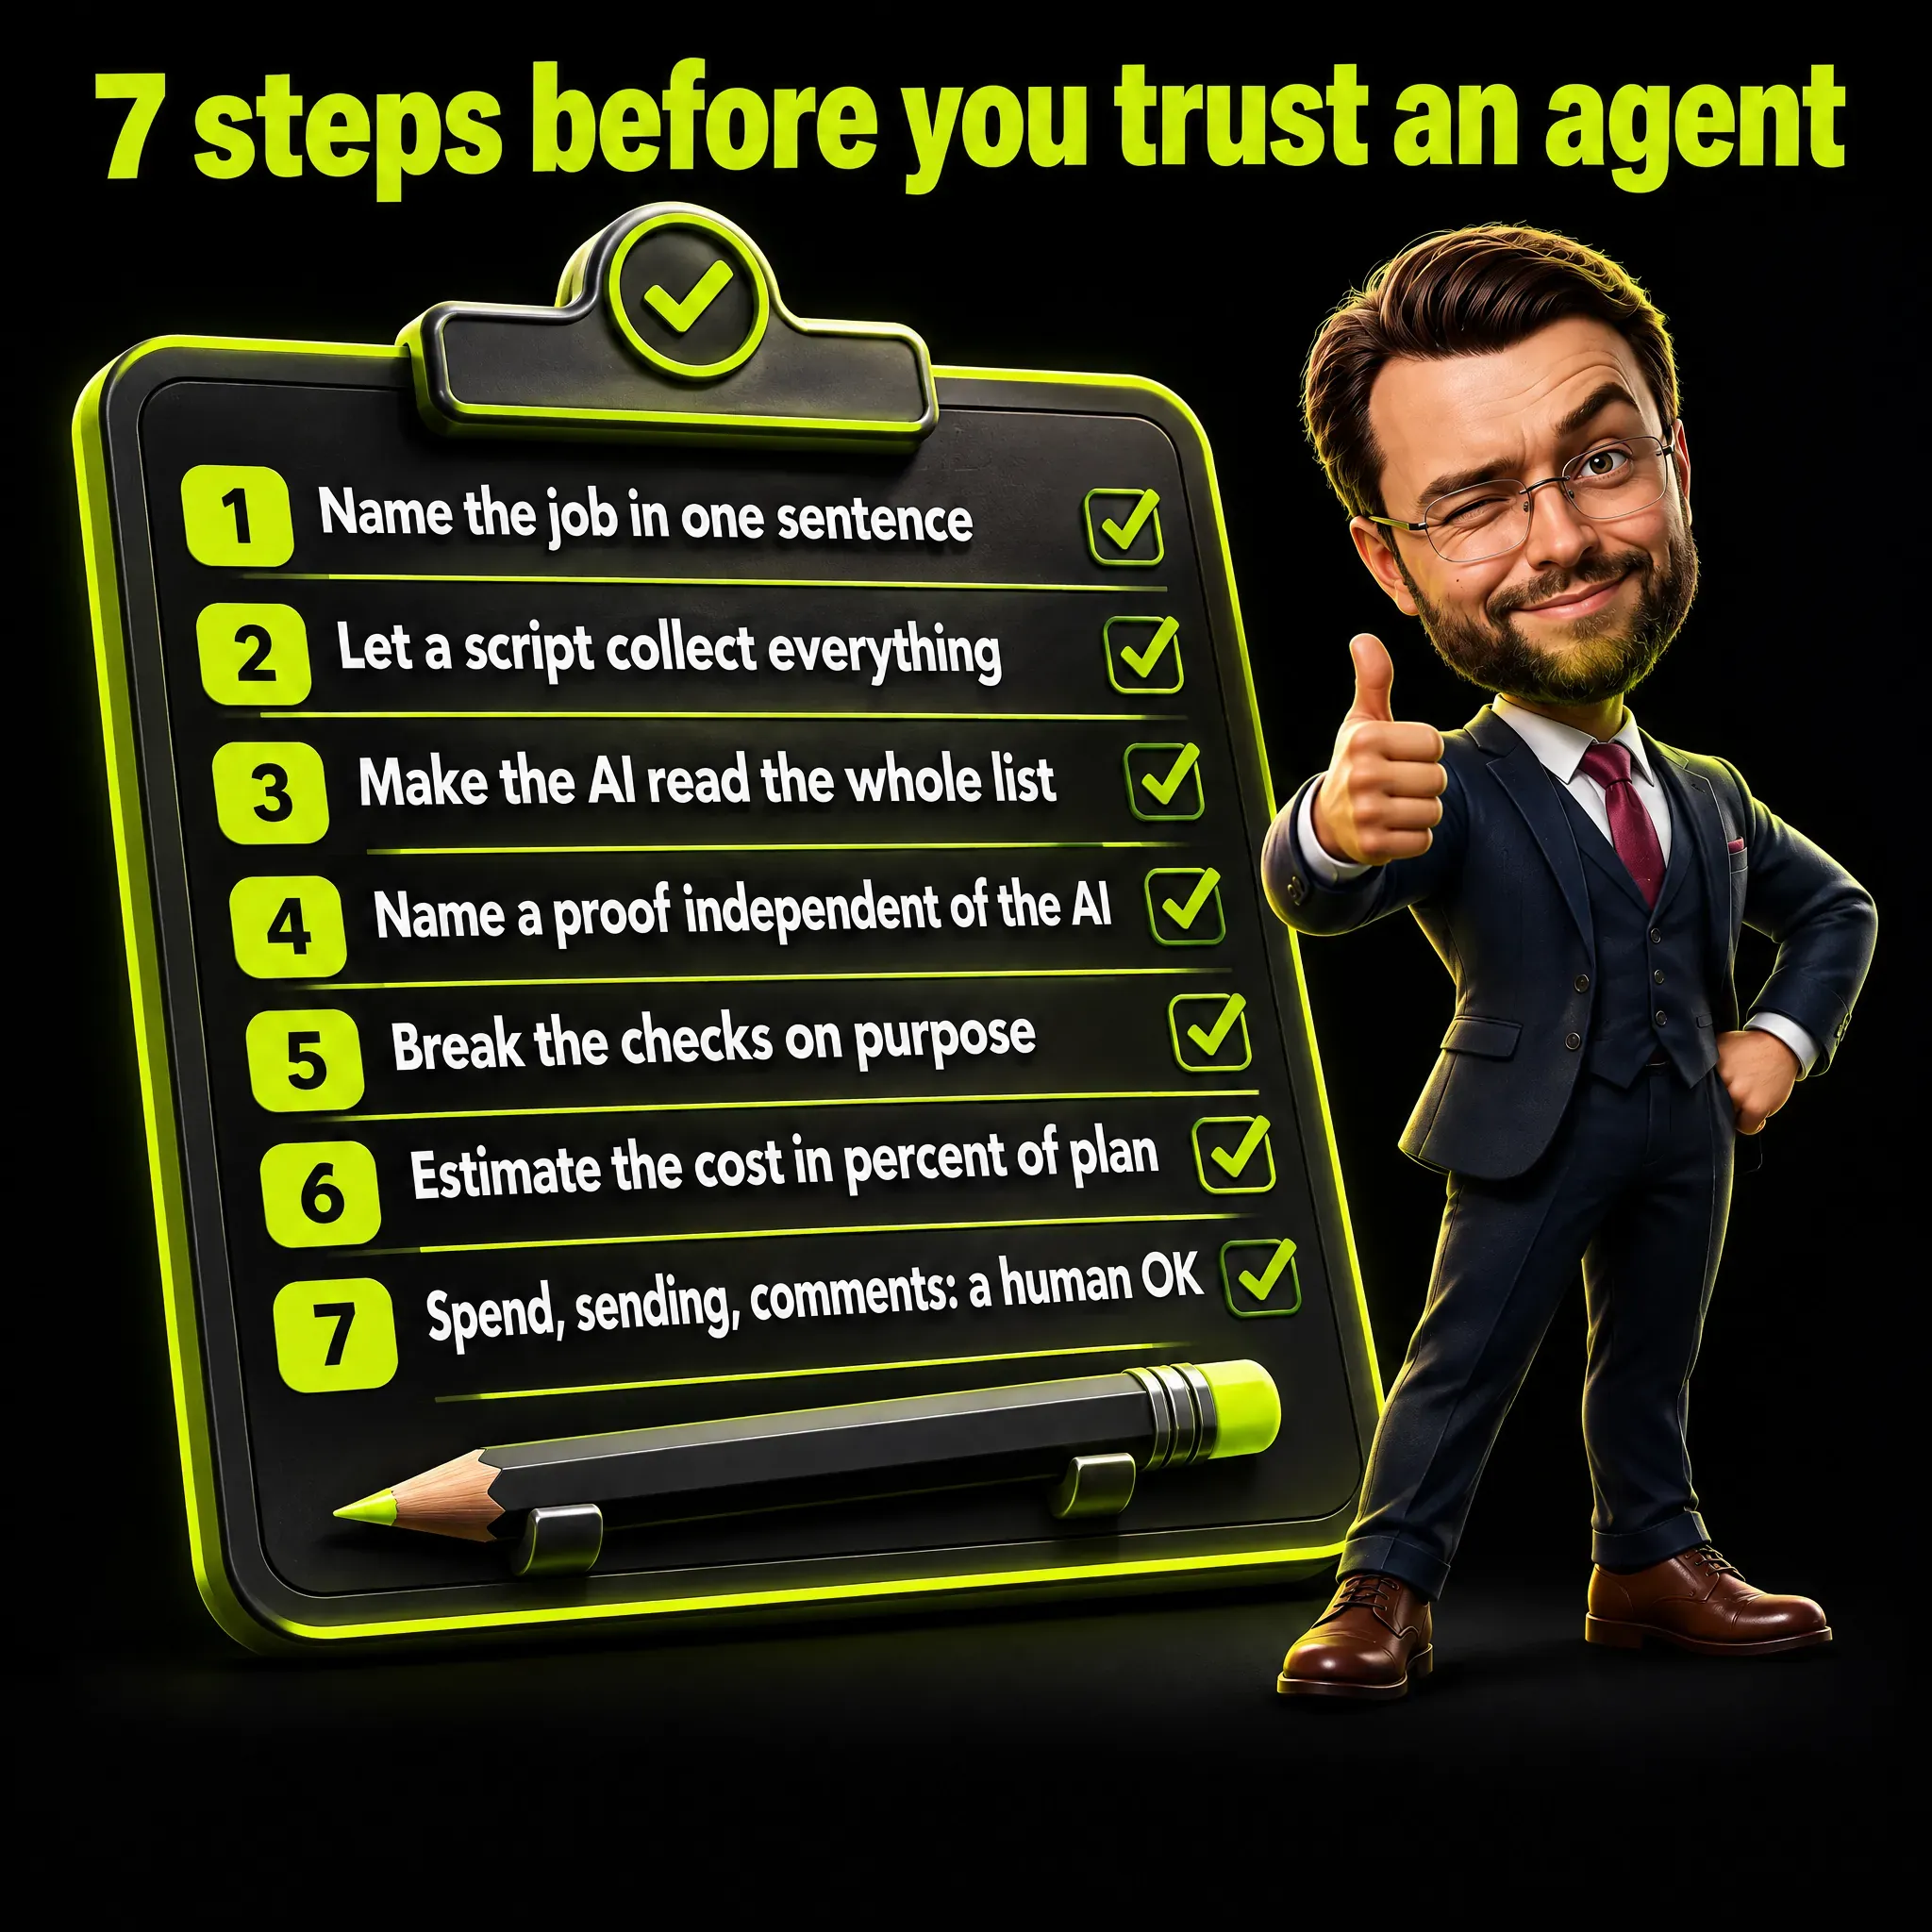
我建议按这个顺序:
- 用一句话说清这项工作,以及它帮助做的决定。
- 让脚本收集全部内容。阈值只当作排序和告警的标签,绝不当作去看的条件。
- 让AI通读整份清单,并允许它回答“未知”。
- 指明一项不依赖AI的证明:第二个数据源、一张时间表,或一个迫使系统按生产环境行为运行的测试。
- 在相信绿色结果之前,有意去破坏这些检查。
- 按套餐用量的百分比估算成本,并分批启动。
- 把花费、发送和评论放在人工点头之后。
当脚本、阅读和证明都有了名字,AI营销智能体仍然可能出错,但它藏不住错误。更大的图景,即AI在营销方案里该放在哪里,见我关于AI营销策略的文章,以及AI营销应用。
常见问题
什么是AI营销智能体?
由AI模型自己决定步骤和工具,去实现营销目标的软件,与按预先写好的食谱运行的工作流相对。实际上,很多当作智能体来卖的产品其实是工作流。
什么是智能体营销(agentic marketing)?
把一部分工作交给能自己选择步骤的智能体去做的营销。我采用Anthropic对智能体的定义,不另外发明一个行业说法。
AI智能体和营销自动化有什么区别?
工作流按代码里设定的路径运行,智能体则自己指挥自己的流程。先自动化什么,这张地图在我关于AI营销自动化的文章里。
AI营销智能体有哪些例子?
我自己工作中的四项:监测Google Ads广告系列、检查追踪、准备客户报告,以及阅读帖子下的评论。每一项都是同样的三步:脚本收集,AI阅读,AI之外的证明来检查。
最好的营销AI智能体有哪些?
最适合你的,是你能看到它错在哪里的那一个。买任何智能体之前,先问它收集什么、读什么,有哪项独立的证明在检查它。
怎么知道AI智能体没有漏掉什么?
不能靠阈值。让脚本收集全部内容,让AI通读全部内容,再加上一项不依赖AI的证明,以及一个没听过你的结论、专门审查代码的第二个AI。
我真的需要智能体吗?
常常不需要。如果做法已知,工作流更便宜,出错的方式也可以预料。Anthropic是这样说的:“这可能意味着根本不去构建智能体系统。”
智能体会用掉我的AI套餐的多少?
按套餐用量的百分比来算,不按美元算。智能体用得比聊天多,所以我先估算,再让脚本去做一切不需要阅读的事。