Agenti AI per il marketing: capire se si sono persi qualcosa
Gli agenti AI per il marketing sbagliano in silenzio. Il mio schema: uno script raccoglie, l'AI legge tutto e una prova fuori dall'AI controlla il risultato.
Un agente AI per il marketing raramente fallisce con un messaggio di errore: fallisce riferendo che va tutto bene. Gli agenti AI per il marketing sono programmi in cui un modello AI sceglie da solo i passi e gli strumenti per raggiungere un obiettivo, come sorvegliare gli account pubblicitari o leggere i commenti. Quella libertà è ciò che li rende vendibili, ed è anche il punto in cui si nascondono gli errori.
La domanda che faccio a qualsiasi agente è come mi accorgerei che sta sbagliando.
Costruisco questi strumenti per il mio lavoro e per le mie consulenze, e la risposta a cui sono arrivato è uno schema in tre mosse. Uno script raccoglie tutto, l’AI legge tutto e un controllo che non dipende dall’AI prova il risultato.
In questo articolo vedi come falliscono in silenzio gli agenti, le tre mosse, quattro lavori di marketing costruiti su di esse e come metto alla prova i test.
In sintesi
- Giudica un agente AI per il marketing da come ti accorgi dei suoi errori, non da quanto sa fare.
- Una regola fissa trova solo ciò che hai previsto. Lascia che uno script raccolga tutto e che l’AI legga tutto. Usa le soglie per ordinare, mai per decidere se guardare.
- Un’AI che controlla un’AI può dire «va tutto bene» quando non è vero. Aggiungi una prova che non dipende dall’AI.
- Rompi i tuoi controlli di proposito. Un controllo che ho messo alla prova aveva test che non vedevano circa un quarto dei difetti che gli avevo inserito.
- Misura il costo in percentuale del tuo piano, non in dollari. Un agente legge e scrive molto più di una chat.
- Spesso serve un workflow, non un agente. Usa la cosa più semplice che funziona.
Cosa sono gli agenti AI per il marketing e cosa vendono al loro posto quasi tutti i fornitori
Anthropic, l’azienda che sta dietro a Claude, traccia una distinzione che vale la pena prendere in prestito. Nella sua guida Building effective agents scrive: «I workflow sono sistemi in cui gli LLM e gli strumenti sono orchestrati tramite percorsi di codice predefiniti.» Poi: «Gli agenti, invece, sono sistemi in cui gli LLM dirigono dinamicamente i propri processi e l’uso degli strumenti, mantenendo il controllo su come portano a termine i compiti.»
In parole semplici, un workflow è una ricetta scritta in anticipo: se arriva X, fai Y. Un agente decide i passi da solo. Molto di ciò che il mercato vende come agente è una ricetta, e una ricetta va bene quando un lavoro deve girare sempre allo stesso modo, come la mia pipeline di automazione della newsletter.
Con questa definizione, buona parte di ciò che faccio girare è un workflow con un solo passo di lettura dell’AI nel mezzo, ed è la scelta giusta quando una ricetta da sola non vede ciò che non hai previsto.
La stessa guida dà un consiglio che è facile saltare: «consigliamo di cercare la soluzione più semplice possibile e di aumentare la complessità solo quando serve. Questo potrebbe significare non costruire affatto sistemi agentici.» Avverte anche che «la natura autonoma degli agenti comporta costi più alti e il rischio di errori che si accumulano.» A contare qui è l’accumulo, perché un errore al secondo passo viene letto come un fatto al terzo.
La guida è di dicembre 2024 e riguarda gli agenti in generale, non il lavoro di marketing, quindi ne prendo i concetti e nessuno degli strumenti. Le citazioni di Anthropic in questo articolo sono traduzioni mie. La mappa dei compiti di marketing da automatizzare per primi è nel mio articolo sull’automazione del marketing con l’AI, quindi qui resto sull’agente stesso.
Tre modi in cui un agente AI per il marketing sbaglia senza dirtelo
Nessuno di questi errori produce un messaggio di errore. Ognuno produce un report calmo e sicuro di sé.
La regola trova solo ciò che hai previsto
Il 24 ottobre ho chiesto quattro agenti giornalieri, per Google Ads, tassi di conversione, notizie e post social. Nel primo progetto abbozzato dall’AI le soglie stavano nello script, e l’AI veniva chiamata a leggere solo quando scattava un segnale.
La mia obiezione è stata breve: uno script non può sapere che qualcosa non va, a meno che non estragga tutto e poi lasci leggere l’AI. Una soglia trova solo ciò che avevi già previsto. Nel progetto finale soglie e confronti ordinano la lista e fanno partire gli avvisi immediati, ma non sono mai la condizione perché l’AI guardi.
Ecco un esempio inventato. Immagina una regola che ti avvisa quando la spesa pubblicitaria sale di oltre il 30%. Un sito che smette di registrare le richieste di contatto mentre la spesa resta piatta non fa scattare nulla, e il report dice che va tutto bene.
Per mettere alla prova il progetto ho scritto un test per l’agente delle notizie, che legge le novità su sicurezza e piattaforme confrontandole con un registro dei siti e dei componenti di cui mi occupo. Il test toglie da quel registro una voce, PHP (un linguaggio di programmazione su cui girano molti siti), e verifica che due notizie su una vulnerabilità di PHP vengano segnalate comunque in base al solo contenuto.
Su un server di prova, cioè uno che finge soltanto di essere quello vero, il meccanismo regge. Con PHP nel registro le due notizie vengono marcate «registro: sì», cioè riguardano qualcosa di cui mi occupo, e partono due avvisi immediati. Senza PHP nel registro le notizie restano nel digest giornaliero, la lista numerata di tutto ciò che l’agente legge, con l’etichetta «registro: no».
Non scatta nessun avviso immediato e il consiglio esce etichettato «non verificato», con gravità bassa. Togliere una voce dal registro cambia le etichette, mai il fatto che l’AI legga le notizie. La prova con il modello vero è il passo successivo.
Il controllore dice «va tutto bene»
L’11 ottobre un assistente AI ha rivisto la prima clip di un cortometraggio generato da un’altra AI, definendo il risultato un enorme passo avanti e dicendo che le mani sembravano a posto. Non aveva contato le braccia: un terzo avambraccio riempiva l’inquadratura per 4,5 secondi. La storia completa è nel mio articolo su AI slop e il collo di bottiglia della revisione.
La lezione non è che un controllore AI sia inutile. Il consiglio di Anthropic sul collaudo degli agenti, nell’articolo Demystifying evals for AI agents, è: «Consigliamo di scegliere valutatori deterministici dove possibile, valutatori LLM dove necessario o per maggiore flessibilità, e di usare con giudizio valutatori umani per una validazione ulteriore.» Un valutatore AI va calibrato sulle persone e funziona meglio se gli è permesso rispondere «Non so» quando non ha informazioni sufficienti.
Lo stesso articolo sulle valutazioni mostra che a rompersi può essere il controllo. Un modello ha ottenuto il 42% in un test pubblico, finché un ricercatore di Anthropic ha trovato, tra gli altri problemi, una «valutazione rigida che penalizzava ‘96.12’ quando si aspettava ‘96.124991…’». Dopo la correzione dei bug di valutazione e un’impostazione meno vincolante, lo stesso modello ha ottenuto il 95%.
Da dove viene il numero: un test pubblico sulle capacità dei modelli AI. Cosa significa: gran parte del «fallimento» stava nei controlli, non nel modello. Cosa cambia: prima di fidarti di un punteggio, leggi come è stato assegnato.
Se vuoi usare questo metodo sui test di sicurezza informatica, leggi cosa dicono i test su IA e attacchi informatici.
L’articolo di Anthropic sul sistema di ricerca multi-agente aggiunge una lezione a misura di marketing: «La valutazione umana coglie ciò che l’automazione non vede.» I tester umani hanno notato che i primi agenti «sceglievano sistematicamente content farm ottimizzate per la SEO rispetto a fonti autorevoli ma posizionate meno in alto, come PDF accademici o blog personali.» Qualsiasi agente di marketing che fa ricerche sul web può sbagliare allo stesso modo: la risposta suona giusta e le fonti sono quelle sbagliate.
La lettura è parziale
Il terzo errore è ancora più silenzioso. Un agente legge solo ciò che una regola ha segnalato, o solo il riassunto prodotto da uno strumento, e la risposta sta nella parte che nessuno ha guardato.
Gli annunci di un cliente girano solo dal lunedì al venerdì, quindi su 28 giorni solo 20 sono quelli in cui possono essere online, non 28. Nel periodo precedente erano online in 20 giorni su 20, nell’ultimo in 7 su 20, perché gli annunci erano stati messi in pausa per un controllo della piattaforma.
Un riassunto che dice solo «il traffico è calato» sembra un crollo. Contare i giorni online dalla programmazione oraria, e non dal calendario, ha mostrato da dove veniva il calo e ha messo la base giusta sotto il confronto.
Su un sito che raccoglie richieste di contatto, 242 sessioni su 525, il 46%, arrivavano da paesi in cui si trovano i data center. Quasi tutte quelle visite non avevano un sito di provenienza, vedevano una sola pagina e restavano in media 0,4 secondi, come si comporta un programma e non una persona. Il numero era nella tabella da sempre e nessuna soglia lo cercava.
Come ho trasformato questi due casi in un report è nel mio articolo sul report di marketing.
Lo schema in tre mosse: script, lettura, prova
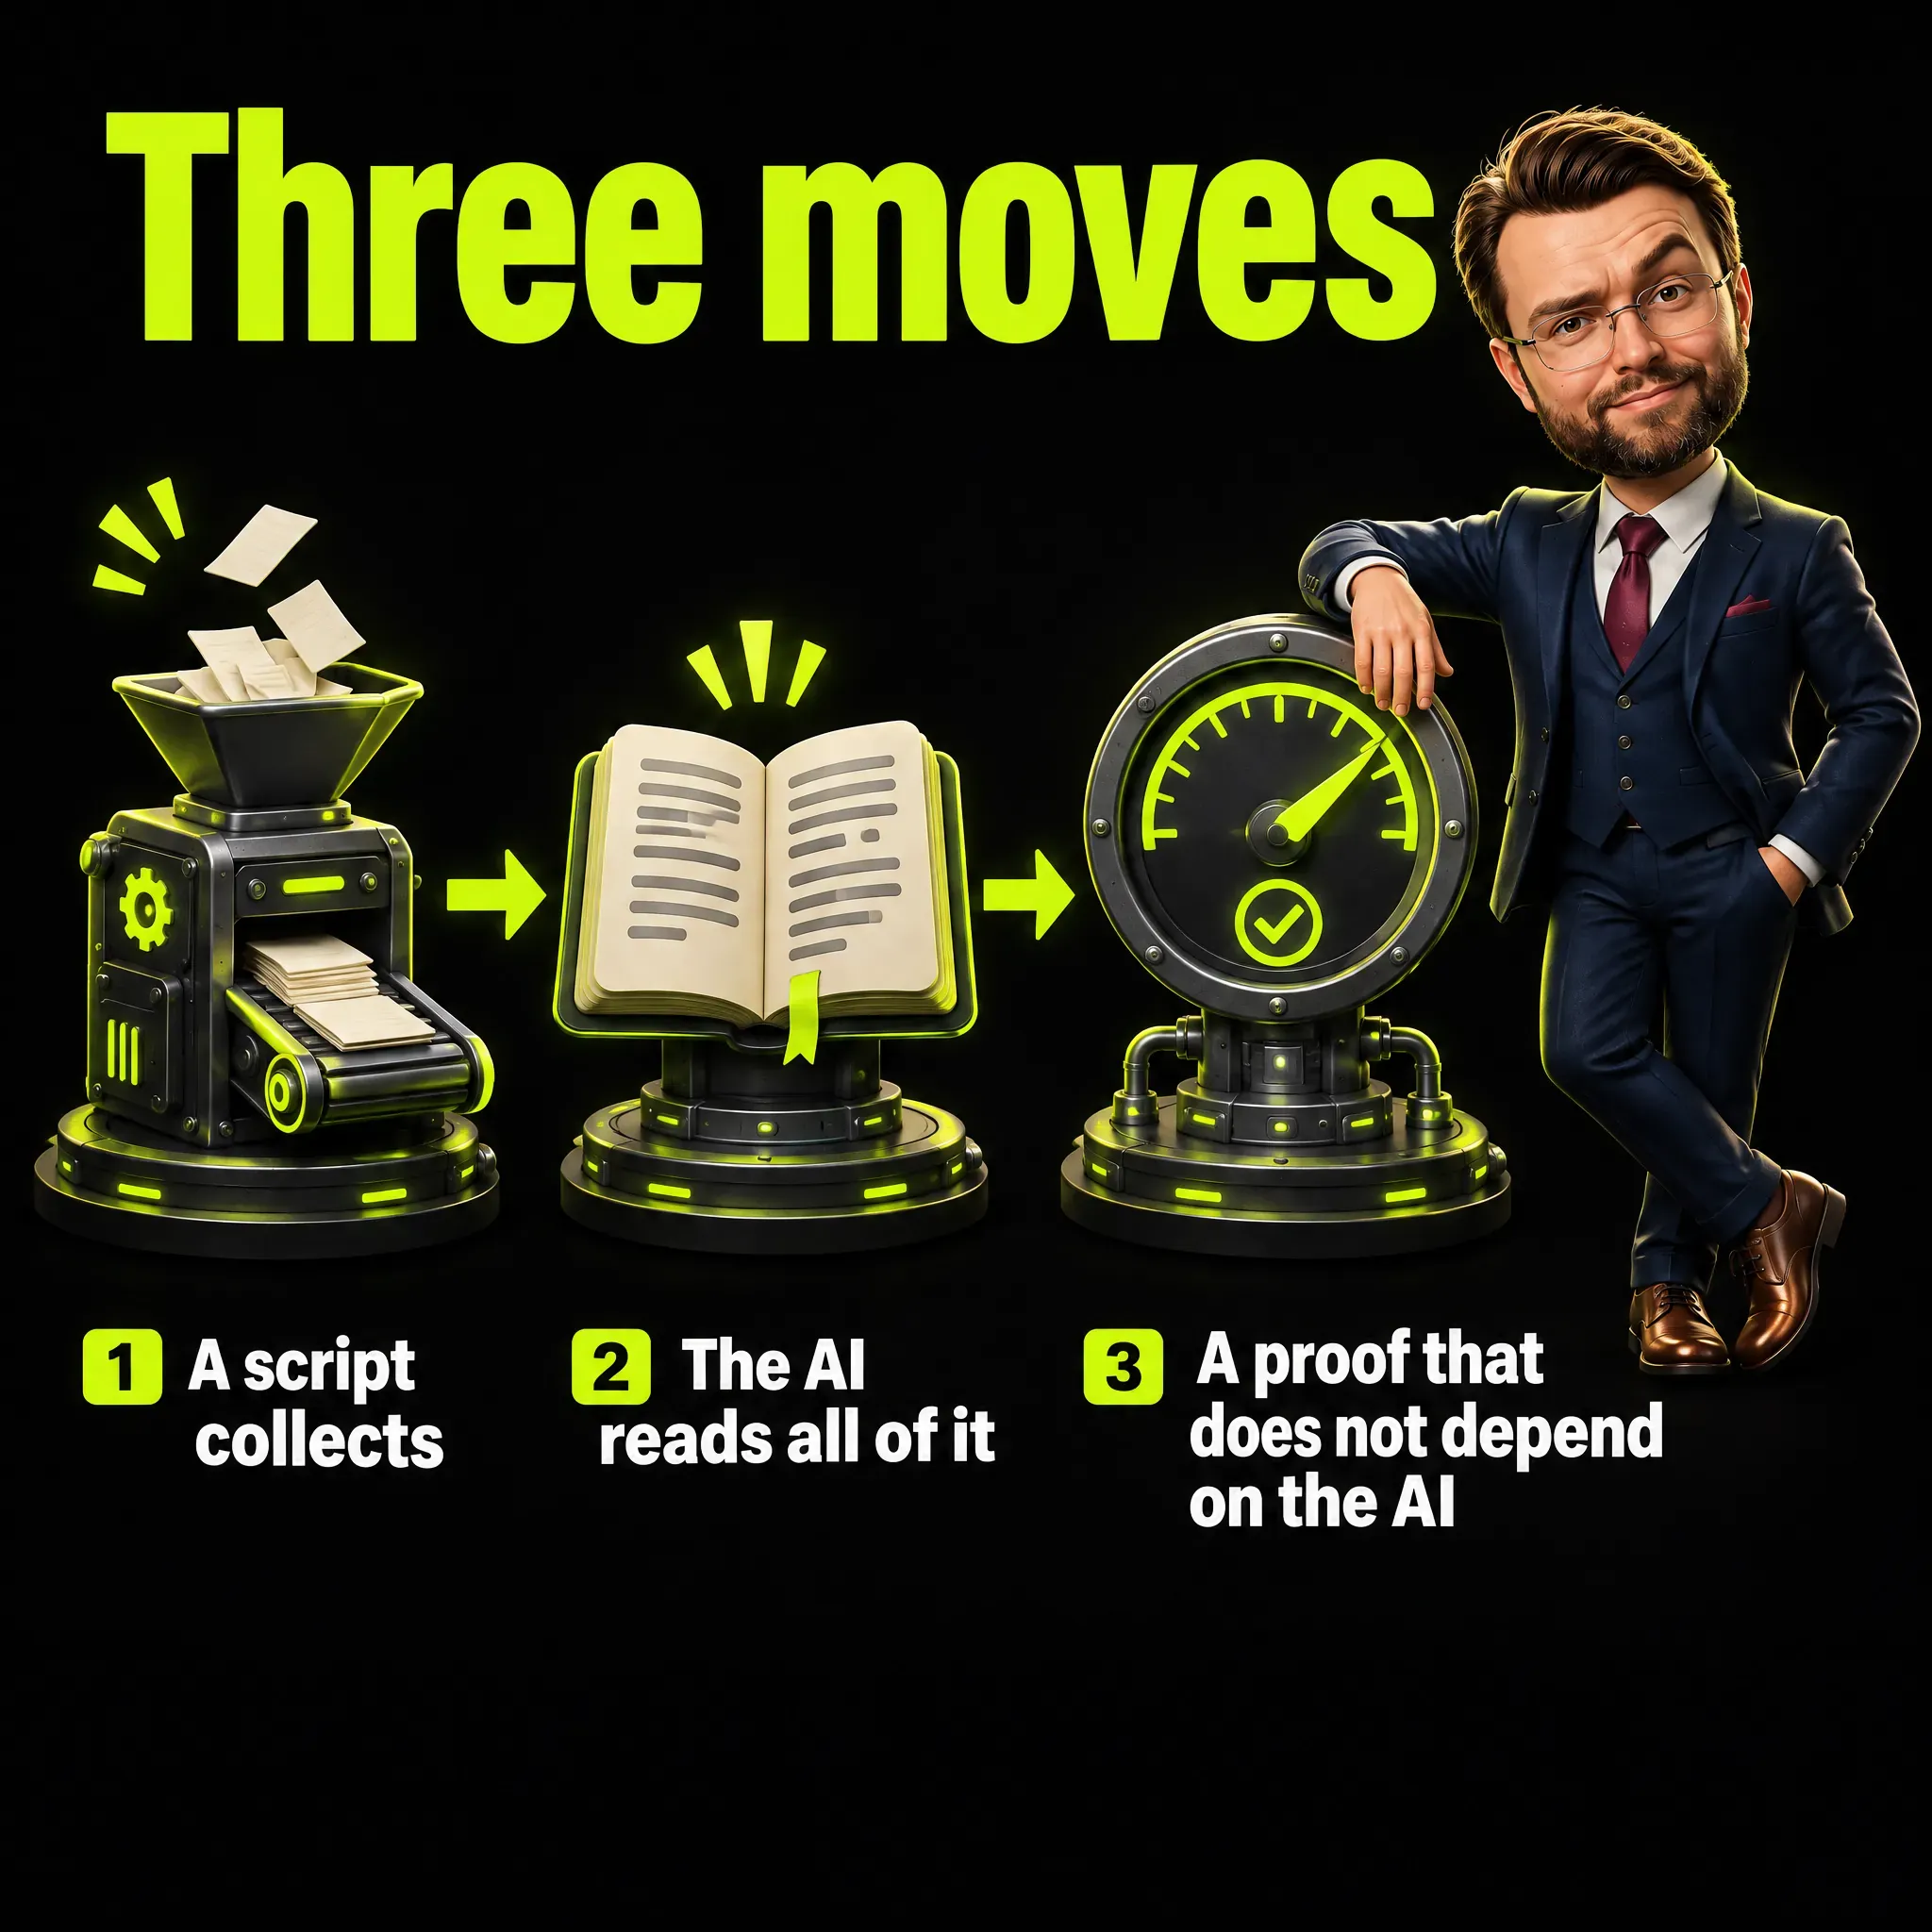
Prima mossa: uno script raccoglie tutto. Nessuna AI e nessun costo in token, i piccoli pezzi di testo che un modello legge e scrive. Lo script scarica tutto ciò che l’agente guarderà e toglie i duplicati.
Poi calcola i confronti (con ieri e con le medie a 7 e a 28 giorni), etichetta ogni voce e scrive un’unica lista numerata. La chiamo digest.
Seconda mossa: l’AI legge tutto il digest. Nei giorni in cui c’è qualcosa di nuovo il modello legge l’intera lista. Non ha strumenti, né accesso al web, né connessioni: legge e restituisce proposte strutturate.
I testi scritti da altri, come feed e pagine web, vengono trattati come dati non affidabili. Gravità, link e codici sono calcolati dal codice e l’AI sceglie le voci per numero, quindi non può inventare un link. Perché i testi altrui sono un rischio per un agente lo spiego in prompt injection e sicurezza degli agenti IA.
Terza mossa: una prova che non dipende dall’AI. La guida di Anthropic dice: «è fondamentale che gli agenti ottengano la “ground truth” dall’ambiente a ogni passo (come i risultati delle chiamate agli strumenti o l’esecuzione del codice) per valutare i propri progressi.» Anthropic usa il termine per i risultati che l’agente riceve dai suoi strumenti a ogni passo, e aggiunge che un agente può fermarsi ad aspettare un riscontro umano ai punti di controllo.
Io estendo l’idea ai controlli fuori dal ciclo. Nel marketing la ground truth è un controllo che può fallire e viene da un’altra fonte: la programmazione degli annunci, una seconda fonte di dati, un test che costringe il sistema a comportarsi come in produzione, una persona che approva la spesa.
Perché questo ordine? Lo script fa il lavoro che non richiede intelligenza, a poco prezzo e sempre allo stesso modo. L’AI viene chiamata una volta, per leggere un materiale già in ordine.
La stessa divisione esiste dentro Claude: una skill può contenere passi scritti e piccoli script che Claude esegue quando un compito corrisponde. Quale lavoro merita una skill, e perché una con del codice va controllata prima, lo trovi in Claude Skills e i loro rischi.
Quattro lavori di marketing, tre mosse ciascuno
Ecco quattro lavori costruiti su questo schema, con lo stato di ciascuno. Il report per i clienti è in funzione e la lettura di Google Ads gira al suo interno.
Il controllo del tracciamento è una procedura collaudata, non ancora un agente giornaliero. Il lettore di commenti ha lo strumento di punteggio già costruito, mentre l’agente giornaliero è ancora un progetto.
Monitoraggio di Google Ads
Per ogni campagna lo script raccoglie spesa, clic, conversioni, costo per contatto, quota di impressioni (quanto spesso gli annunci sono stati mostrati quando potevano esserlo), i termini di ricerca digitati dalle persone, i giorni in cui gli annunci erano online secondo la programmazione oraria e il confronto con ieri e con le medie a 7 e a 28 giorni. L’AI legge tutta la lista e restituisce consigli con il numero, il periodo e il confronto, mai azioni.
La prova: lo script conta i giorni online dalla programmazione, le conversioni vengono confrontate con una seconda fonte (i contatti negli analytics del sito, gli ordini nel negozio) e nulla viene speso o modificato senza il mio via libera esplicito, nemmeno una pausa. La lettura di sola consultazione gira già dentro il mio report settimanale per i clienti. L’agente giornaliero è previsto in due passi: prima il consiglio, poi un’azione separata e approvata, scelta da una lista chiusa, come aggiungere una keyword negativa (una parola che impedisce agli annunci di comparire per una ricerca) o mettere in pausa una singola keyword o un singolo annuncio, e mai budget od offerte.
Controlli del tracciamento
Lo script conta gli eventi e le persone distinte per evento, per paese e fonte, più durata, pagine e coinvolgimento per sessione. Esegue anche un invio di prova con un parametro di test. L’AI legge l’intera tabella, paese per fonte per coinvolgimento, e gli eventi ripetuti.
La prova è un test nel browser in cui ogni chiamata al server del sito riceve un finto «ok» e ogni chiamata ad analytics viene registrata e poi bloccata. Quel test ha riprodotto un evento del modulo che arrivava due volte, a 50 millisecondi di distanza, sul sito di un cliente. Ha spiegato perché quattro eventi «lead» nei dati erano tre invii del modulo di due persone, tutti contatti di prova del team del cliente stesso.
Una versione precedente del test bloccava le chiamate al server del sito, quindi il secondo scatto dell’evento non compariva mai. Ho corretto la configurazione dei tag l’11 ottobre e l’ho ricontrollata con lo stesso test. Il lato consenso è nella mia checklist sul consenso al tracciamento in Svizzera (in inglese).
Report per i clienti
Lo script legge in sola lettura i dati di analytics, ricerca e annunci, più i totali degli ordini del negozio senza dati personali e una serie di controlli sul sito, come risposta del server, certificato, intestazioni di sicurezza, autenticazione delle email, sitemap e velocità misurata su visitatori reali. L’AI legge il registro della settimana con ciò che è stato fatto per il cliente e scrive la bozza della parte narrativa, che leggo io prima che esca qualsiasi cosa.
La prova: numeri e frasi di sintesi vengono da formule, quindi nessun modello scrive una cifra. Un valore mancante viene stampato come «n/a», mai come zero, e i confronti usano gli stessi giorni.
Un filtro sul tono blocca la bozza quando un danno reale non viene detto al cliente, e per ogni periodo esce un solo messaggio. Il report è in funzione e approvo ogni messaggio prima che arrivi al cliente. Per approfondire: marketing operations.
Lettura dei commenti
Lo script raccoglie i numeri a 24 ore e a 7 giorni (impression, reazioni, commenti, condivisioni, salvataggi, visite al profilo) da un’esportazione o da screenshot, il testo dei commenti e chi li ha scritti, e un punteggio meccanico della bozza. L’AI legge i commenti veri, li raggruppa in temi e domande ricorrenti e propone idee di contenuto, con un riepilogo e una nuova regola ogni quattro post.
La prova: un punteggio di 12 controlli per ciò che il codice può verificare, e il mio giudizio per il resto, come una sola idea precisa e la voce. Guardo gli ordini di grandezza, non le differenze del 10%.
Questo agente non risponde e non commenta mai da solo, e il primo commento a un post viene scritto a mano. Il punteggio e l’importatore esistono, con 44 test automatici, e l’agente giornaliero è ancora un progetto.
Come metto alla prova i controlli attorno a un agente AI per il marketing
I test verdi dicono poco finché non provi a farli fallire. Il mio metodo è inventare difetti, inserirli uno alla volta in una copia del codice e contare quanti ne scoprono i test.
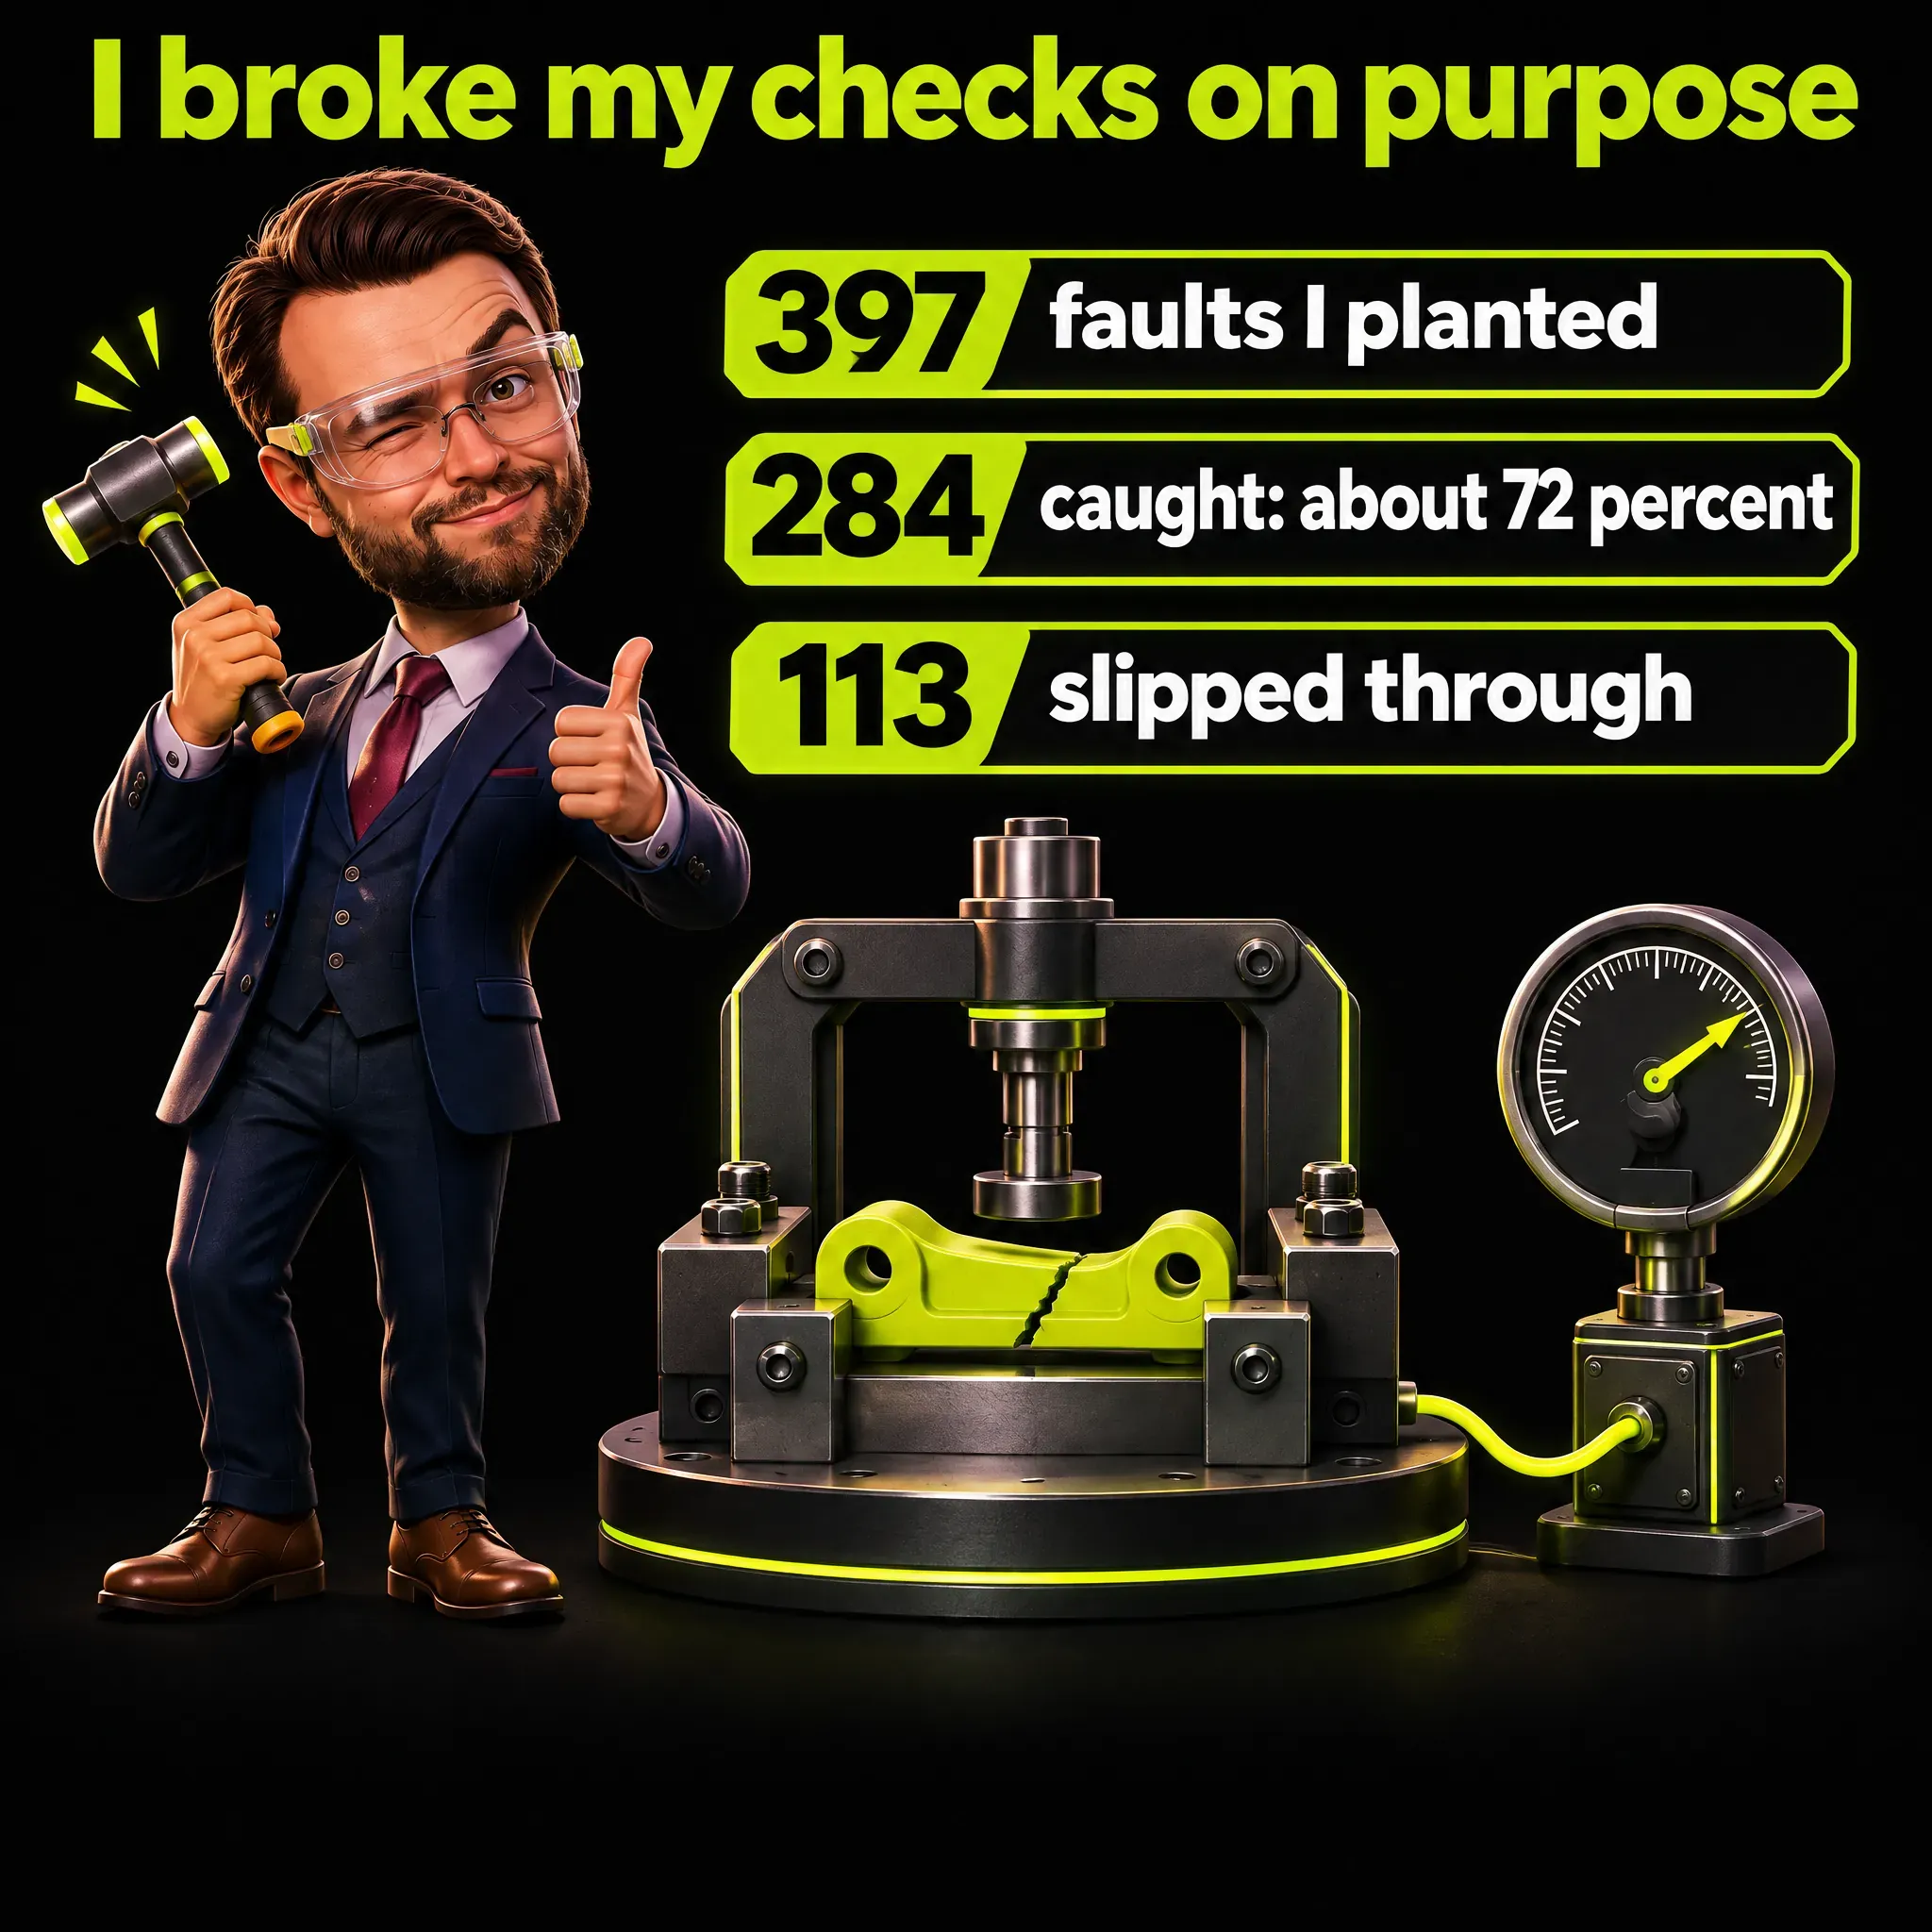
L’ho fatto tre volte. Sul controllo che convalida la lista dei siti e dei componenti dei clienti ho inventato 399 difetti, di cui 397 eseguibili. I test ne hanno colti subito 284, circa il 72%, e 113 sono passati.
Di quei 113, 12 erano equivalenti, cioè non cambiavano il comportamento, e 101 erano buchi veri che ho chiuso con nuovi controlli. I buchi veri sono circa il 25% dei 397.
Da dove viene il numero: difetti inventati in una copia del controllo. Cosa significa: circa un difetto su quattro, tra quelli che ho inserito nel mio controllo più delicato, sarebbe passato inosservato ai suoi stessi test. Cosa cambia: «verde» smette di essere una prova e diventa una domanda, che cosa ha provato a rompere questo test?
Sullo script che invia un file al server ho provato 84 difetti. I test ne hanno colti 78 e 6 sono passati, con 2 buchi veri chiusi e 4 equivalenti documentati. Dopo aver trovato un buco nel test stesso ho aggiunto altri 4 difetti, e i test li hanno colti tutti.
Un giro precedente di 56 difetti inventati, contro una suite di test che consideravo buona, si è chiuso con nuovi controlli e 56 difetti su 56 colti. Quella storia è nell’articolo su AI slop.
Il secondo strumento è una seconda AI, usata come revisore che non ha sentito le mie conclusioni. Riceve il codice, non il mio racconto, e può solo leggere. È questo a renderla utile dove non lo era il controllore della storia del cortometraggio: non ha nessuna conclusione con cui essere d’accordo.
Sull’agente delle notizie un revisore di questo tipo, avviato da zero senza memoria del lavoro e impostato per ragionare a fondo, ha dato 9 rilievi. Ne ho corretti 6, ciascuno con un test che prima falliva, perché una correzione senza un test che fallisce non prova nulla. Per l’abitudine più ampia di verificare l’output dell’AI, vedi il mio articolo sulla verifica human-in-the-loop dell’AI.
Quanto costa un agente AI per il marketing: percentuale del piano, non dollari
Con un abbonamento, un costo in dollari è solo teorico. Il numero che conta è la quota del piano che viene usata, nella finestra di 5 ore e in quella settimanale che il piano riporta.
Il caso che me lo ha fatto toccare con mano: il 17 e il 18 ottobre tre lunghe esecuzioni di agenti in una sola notte, circa 15 milioni di token in tutto (11,1 più 1,0 più 3,1 milioni), hanno esaurito il limite settimanale a metà del lavoro. Gli agenti competono con tutto il resto per lo stesso tetto.
Anthropic indica la direzione: «gli agenti di solito usano circa 4 volte più token delle interazioni in chat, e i sistemi multi-agente circa 15 volte più token delle chat.» Quei moltiplicatori vengono dal sistema di ricerca di Anthropic, non da compiti di marketing, quindi li leggo come un avvertimento e non come una misura.
I miei numeri, e che tipo di numeri sono:
- Calibrazione, un ordine di grandezza. Dalle mie trascrizioni del 18 ottobre, l’1% della settimana corrisponde a circa 0,64 milioni di token in uscita, il testo che il modello scrive. I 15 milioni qui sopra contano anche tutto ciò che gli agenti leggono, quindi le due cifre non si possono dividere l’una per l’altra.
- Stime, non misure. Una lettura costa tra 8.000 e 25.000 token in ingresso e tra 1.000 e 2.000 in uscita. L’agente delle notizie più la seconda AI che ne controlla le proposte dovrebbe usare al massimo circa lo 0,1% della settimana. Un agente giornaliero che legge un sito dovrebbe usare tra lo 0,2% e lo 0,5% della settimana.
Tutto questo vale per il mio intero account, non per una singola esecuzione, e la percentuale di un piano ha senso solo per chi paga un abbonamento. Cambia l’ordine del lavoro: prima stimare, poi lanciare a lotti, e lasciare allo script tutto ciò che non richiede lettura.
Quando non ti serve un agente AI per il marketing
- La ricetta è nota. Se puoi scrivere «se X, allora Y», un workflow costa meno e fallisce in modi prevedibili. I miei report per i clienti girano su formule fisse proprio per questo motivo.
- Un passo sbagliato costa caro ed è difficile da vedere. Anthropic avverte degli errori che si accumulano. Dove un errore costa denaro o fiducia, tengo spesa, messaggi ai clienti e commenti dietro il via libera di una persona e preferisco un workflow.
- Non sai indicare la prova. Se nessuno sa dire quale controllo mostrerebbe che l’agente ha sbagliato, ti suggerisco di non cominciare.
Se gestisci un’azienda e qualcuno ti propone un agente, ti suggerisco di fare una domanda: quale controllo ci direbbe che ha sbagliato? Una buona risposta nomina una seconda fonte, una programmazione o un test, mentre una risposta debole è «l’AI si rivede da sola». Il fallimento di interi progetti è un altro tema, trattato in perché i progetti di AI marketing falliscono; qui parlo dell’errore più silenzioso di un agente che continua a girare.
Una checklist prima che un agente AI per il marketing giri da solo
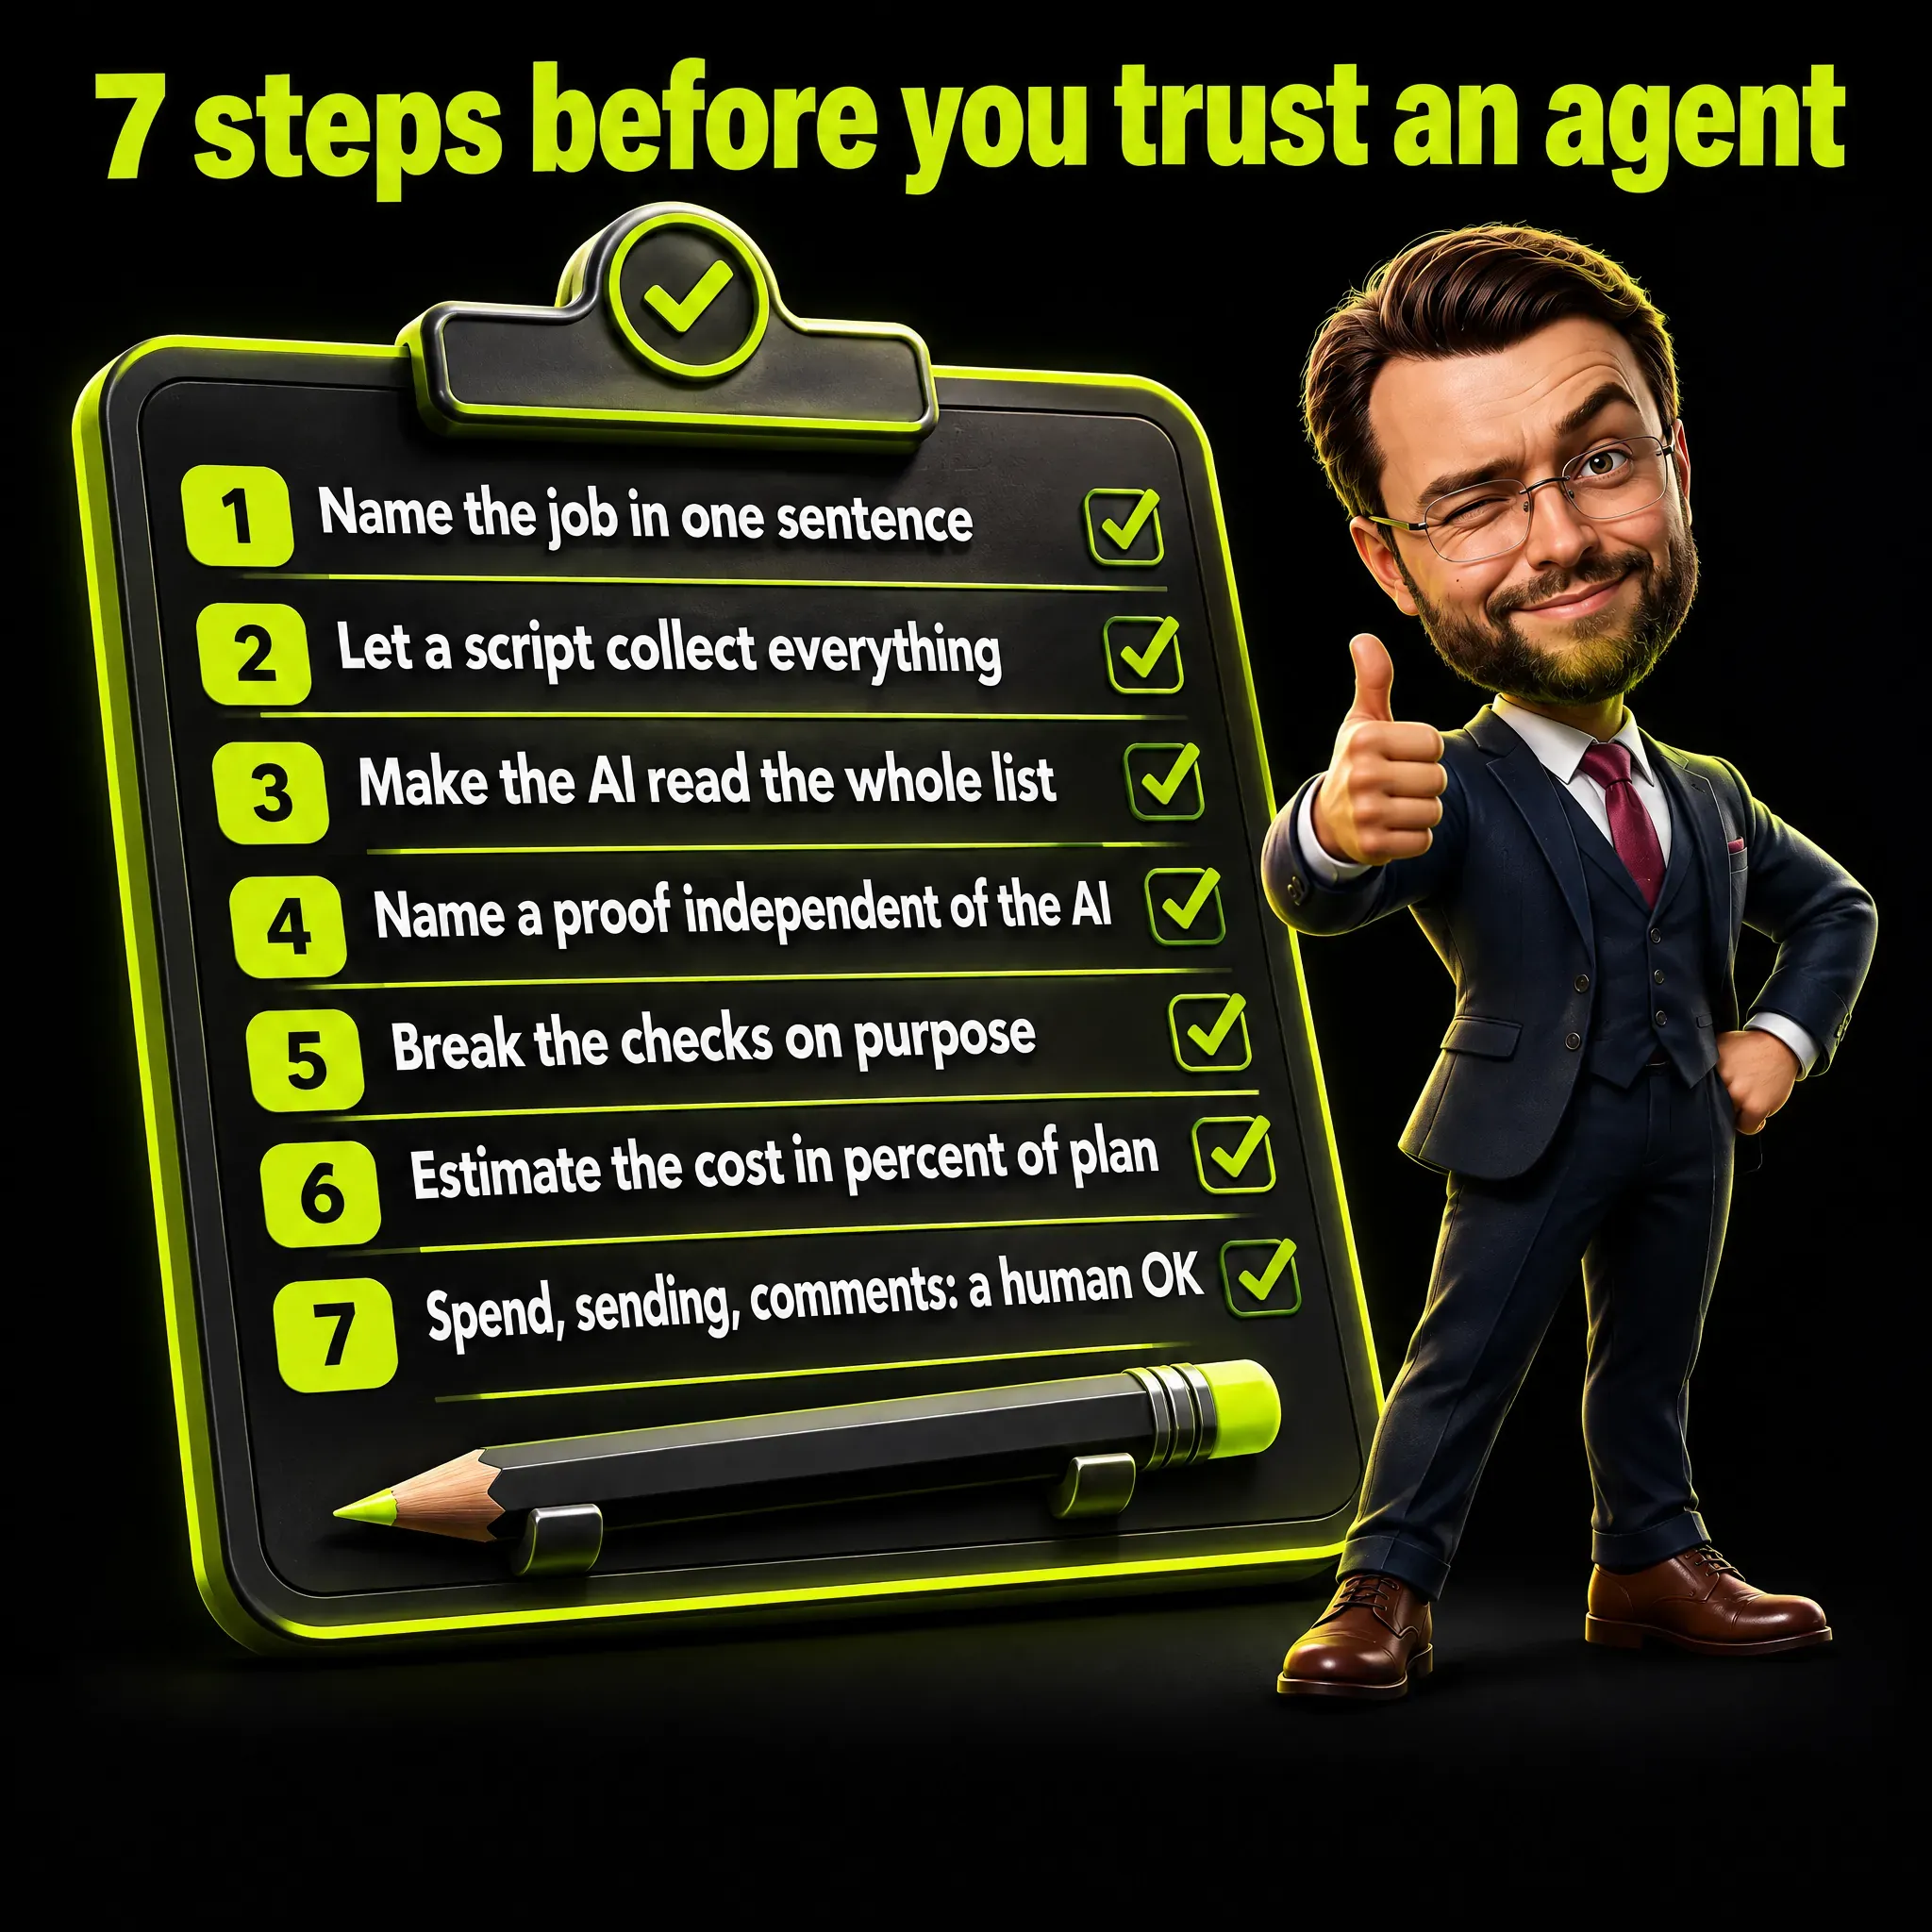
Ti suggerisco quest’ordine:
- Descrivi il lavoro in una frase e la decisione a cui serve.
- Lascia che sia uno script a raccogliere tutto. Tieni le soglie come etichette per ordinare e per gli avvisi, mai come condizione per guardare.
- Fai leggere all’AI tutta la lista e permettile di rispondere «Non so».
- Indica una prova che non dipende dall’AI: una seconda fonte, una programmazione o un test che forza il comportamento di produzione.
- Rompi i controlli di proposito prima di fidarti di un risultato verde.
- Stima il costo in percentuale del piano e lancia a lotti.
- Tieni spesa, invii e commenti dietro il via libera di una persona.
Quando lo script, la lettura e la prova sono tutti definiti, gli agenti AI per il marketing possono ancora sbagliare, ma non possono nasconderlo. Il quadro più ampio di dove l’AI trova posto in un piano di marketing è nel mio articolo sulla strategia di AI marketing e in quello su come usare l’AI nel marketing.
Domande frequenti
Cosa sono gli agenti AI per il marketing?
Software in cui un modello AI decide da solo i propri passi e i propri strumenti per raggiungere un obiettivo di marketing, a differenza di un workflow che segue una ricetta scritta in anticipo. Nella pratica molti prodotti venduti come agenti sono workflow.
Cos’è l’agentic marketing?
Marketing in cui una parte del lavoro è affidata a un agente che sceglie da solo i propri passi. Uso la definizione di agente di Anthropic e non ne invento una a parte per il settore.
Qual è la differenza tra un agente AI e l’automazione del marketing?
Un workflow segue percorsi fissati nel codice, un agente dirige il proprio processo. La mappa di cosa automatizzare per primo è nel mio articolo sull’automazione del marketing con l’AI.
Quali sono esempi di agenti AI per il marketing?
Quattro compiti che svolgo nel mio lavoro: monitorare le campagne Google Ads, controllare il tracciamento, preparare i report per i clienti e leggere i commenti ai post. Ognuno ha le stesse tre mosse: uno script raccoglie, l’AI legge, una prova fuori dall’AI controlla.
Quali sono i migliori agenti AI per il marketing?
Il migliore per te è quello di cui puoi vedere gli errori. Prima di comprare un agente, chiedi che cosa raccoglie, che cosa legge e quale prova indipendente lo controlla.
Come faccio a sapere che un agente AI non si è perso qualcosa?
Non con una soglia. Lascia che uno script raccolga tutto e che l’AI legga tutto, poi aggiungi una prova che non dipende dall’AI e una seconda AI che rivede il codice senza aver sentito le tue conclusioni.
Mi serve davvero un agente?
Spesso no. Se la ricetta è nota, un workflow costa meno e fallisce in modi prevedibili. Anthropic lo dice così: «Questo potrebbe significare non costruire affatto sistemi agentici.»
Quanta parte del mio piano AI consuma un agente?
Misurala in percentuale del piano, non in dollari. Gli agenti consumano più di una chat, quindi stimo prima e lascio allo script tutto ciò che non richiede lettura.


