KI-Marketing-Agenten: So merken Sie, ob etwas übersehen wurde
KI-Marketing-Agenten scheitern leise. Mein Entwurf: Ein Skript sammelt alles, die KI liest alles, und eine von der KI unabhängige Prüfung belegt das Ergebnis.
KI-Marketing-Agenten scheitern selten mit einer Fehlermeldung. Sie scheitern, indem sie melden, dass alles in Ordnung ist.
KI-Marketing-Agenten sind Programme, in denen ein KI-Modell seine Schritte und seine Werkzeuge selbst wählt, um ein Ziel zu erreichen, etwa Werbekonten zu beobachten oder Kommentare zu lesen. Diese Freiheit ist das Verkaufsargument, und zugleich verstecken sich hier die Fehler.
Die Frage, die ich jedem Agenten stelle, lautet: Woran würde ich merken, dass er falsch lag?
Ich baue solche Werkzeuge für meine eigene Arbeit und für meine Beratung, und die Antwort, bei der ich gelandet bin, ist ein Entwurf in drei Schritten. Ein Skript sammelt alles, die KI liest alles, und eine von der KI unabhängige Prüfung belegt das Ergebnis.
Dieser Artikel behandelt, wie Agenten unbemerkt versagen, die drei Schritte, vier Marketing-Aufgaben, die darauf aufbauen, und wie ich die Tests teste. Zitate aus englischsprachigen Quellen habe ich selbst übersetzt.
Das Wichtigste vorab
- Beurteilen Sie einen KI-Marketing-Agenten danach, wie Sie seine Fehler bemerken, nicht danach, wie viel er kann.
- Eine feste Regel findet nur, was Sie vorhergesehen haben. Lassen Sie ein Skript alles sammeln und die KI alles lesen. Schwellenwerte dienen zum Sortieren, nie zur Entscheidung, ob man hinsieht.
- Eine KI, die eine KI prüft, kann «alles gut» sagen, obwohl es nicht stimmt. Fügen Sie einen Nachweis hinzu, der nicht von der KI abhängt.
- Brechen Sie Ihre eigenen Prüfungen mit Absicht. Bei einer Prüfung, die ich getestet habe, übersahen die Tests etwa ein Viertel der Fehler, die ich eingebaut hatte.
- Messen Sie die Kosten in Prozent Ihres Abos, nicht in Dollar. Ein Agent liest und schreibt weit mehr als ein Chat.
- Oft brauchen Sie einen Workflow, keinen Agenten. Nehmen Sie das Einfachste, das funktioniert.
Was KI-Marketing-Agenten sind und was die meisten Anbieter stattdessen verkaufen
Anthropic, das Unternehmen hinter Claude, zieht eine Linie, die man übernehmen kann. In seinem Leitfaden Building effective agents schreibt es: «Workflows sind Systeme, in denen LLMs und Werkzeuge über vordefinierte Codepfade orchestriert werden.» Dann: «Agenten dagegen sind Systeme, in denen LLMs ihre eigenen Abläufe und ihre Werkzeugnutzung dynamisch steuern und die Kontrolle darüber behalten, wie sie Aufgaben erledigen.»
Einfach gesagt ist ein Workflow ein im Voraus geschriebenes Rezept: Trifft X ein, tue Y. Ein Agent entscheidet die Schritte selbst. Vieles, was der Markt als Agent verkauft, ist ein Rezept, und ein Rezept ist in Ordnung, wenn eine Aufgabe jedes Mal gleich ablaufen muss, wie bei meiner Pipeline zur Newsletter-Automatisierung.
Nach dieser Definition ist vieles von dem, was ich betreibe, ein Workflow mit einem KI-Lesemoment in der Mitte. Das ist die richtige Wahl, wenn ein Rezept allein nicht sieht, was man nicht vorhergesehen hat.
Derselbe Leitfaden gibt einen Rat, den man leicht überliest: «Wir empfehlen, die einfachstmögliche Lösung zu finden und die Komplexität nur bei Bedarf zu erhöhen. Das kann bedeuten, überhaupt keine agentischen Systeme zu bauen.»
Er warnt ausserdem: «Die autonome Natur von Agenten bedeutet höhere Kosten und das Potenzial für sich aufsummierende Fehler.» Das Aufsummieren ist hier der entscheidende Punkt, denn ein Fehler in Schritt zwei wird in Schritt drei als Tatsache gelesen.
Der Leitfaden ist im Dezember 2024 erschienen und behandelt Agenten im Allgemeinen, nicht Marketingarbeit, deshalb übernehme ich seine Konzepte und keines seiner Werkzeuge. Die Übersicht, welche Marketingaufgaben man zuerst automatisieren sollte, steht in meinem Artikel zur KI-Marketing-Automatisierung, hier bleibe ich beim Agenten selbst.
Drei Arten, wie KI-Marketing-Agenten versagen, ohne es zu melden
Keiner dieser Fehler erzeugt eine Fehlermeldung. Jeder erzeugt einen ruhigen, selbstsicheren Bericht.
Die Regel findet nur, was Sie vorhergesehen haben
Am 24. Oktober bat ich um vier tägliche Agenten für Google Ads, Conversion-Raten, Nachrichten und Social-Media-Beiträge. Der erste Entwurf der KI legte Schwellenwerte ins Skript, und nur ein markiertes Signal weckte die KI zum Lesen.
Mein Einwand war kurz: Ein Skript kann nicht erkennen, dass etwas nicht stimmt, es sei denn, es extrahiert alles und lässt die KI das Ganze lesen. Ein Schwellenwert findet nur, was man schon vorhergesehen hatte. Im endgültigen Entwurf sortieren Schwellenwerte und Vergleiche die Liste und lösen sofortige Warnungen aus, sind aber nie die Bedingung dafür, dass die KI hinsieht.
Hier ein erfundenes Beispiel. Angenommen, eine Regel warnt Sie, wenn die Werbeausgaben um mehr als 30 Prozent steigen. Eine Website, die keine Kontaktanfragen mehr erfasst, während die Ausgaben gleich bleiben, löst nichts aus, und der Bericht sagt, es sei alles in Ordnung.
Um den Entwurf zu testen, schrieb ich einen Test für den Nachrichten-Agenten, der Sicherheits- und Plattformnachrichten im Abgleich mit einem Register der Websites und Komponenten liest, die ich betreue. Der Test nimmt einen Eintrag aus diesem Register, PHP (eine Programmiersprache, auf der viele Websites laufen), und prüft, dass zwei Meldungen über eine PHP-Sicherheitslücke allein aufgrund ihres Inhalts weiterhin markiert werden.
Auf einem Stellvertreter-Server, der nur vorgibt, der echte zu sein, hält der Mechanismus. Steht PHP im Register, werden die beiden Meldungen mit «register: yes» markiert, das heisst, sie betreffen etwas, das ich betreue, und es gehen zwei sofortige Warnungen raus.
Fehlt PHP, bleiben die Meldungen im täglichen Digest, der nummerierten Liste von allem, was der Agent liest, und sind mit «register: no» markiert. Es geht keine sofortige Warnung raus, und der Rat erscheint als «unverified» mit niedriger Schwere.
Ein Eintrag weniger im Register ändert die Markierungen, nie aber, ob die KI die Nachrichten liest. Der Lauf mit dem echten Modell ist der nächste Schritt.
Der Prüfer sagt «Alles gut»
Am 11. Oktober prüfte ein KI-Assistent das erste Stück eines Kurzfilms, den eine andere KI erzeugt hatte, und nannte das Ergebnis einen riesigen Sprung nach vorn. Er fand die Hände in Ordnung, hatte aber die Arme nicht gezählt: Ein dritter Unterarm füllte 4,5 Sekunden lang das Bild.
Die ganze Geschichte steht in meinem Artikel über AI Slop und den Engpass der menschlichen Prüfung.
Die Lehre daraus ist nicht, dass ein KI-Prüfer nutzlos wäre. Anthropics eigener Rat zum Testen von Agenten, in seinem Artikel Demystifying evals for AI agents, lautet: «Wir empfehlen, deterministische Prüfer zu wählen, wo es möglich ist, LLM-Prüfer, wo es nötig ist oder um zusätzlich flexibel zu sein, und menschliche Prüfer mit Augenmass für zusätzliche Validierung einzusetzen.» Ein KI-Prüfer muss an Menschen kalibriert werden und arbeitet besser, wenn er «Unbekannt» sagen darf, sobald ihm die Informationen fehlen.
Derselbe Evals-Artikel zeigt, dass auch eine Prüfung der defekte Teil sein kann. Ein Modell erreichte in einem öffentlichen Test 42 Prozent, bis ein Anthropic-Forscher unter anderem auf «starre Bewertung, die ‹96.12› bestrafte, wenn ‹96.124991…› erwartet wurde» stiess. Nachdem die Bewertungsfehler behoben und der Aufbau weniger einschränkend gestaltet worden waren, erreichte dasselbe Modell 95 Prozent.
Woher die Zahl kommt: ein öffentlicher Test der Fähigkeiten von KI-Modellen. Was sie bedeutet: Ein grosser Teil des «Versagens» lag in den Prüfungen, nicht im Modell. Was sich ändert: Bevor Sie einer Punktzahl trauen, lesen Sie, wie sie vergeben wurde.
Wie sich die Ergebnisse von Cybertests bei KI-Modellen lesen lassen, zeige ich in KI-Cyberangriffe: was die Tests zeigen.
Anthropics Bericht zum Multi-Agenten-Forschungssystem bringt eine Lehre mit, die ins Marketing passt: «Menschliche Bewertung erkennt, was die Automatisierung übersieht.» Menschliche Tester bemerkten, dass die frühen Agenten «durchweg SEO-optimierte Content-Farmen massgeblichen, aber weniger hoch platzierten Quellen wie akademischen PDFs oder persönlichen Blogs vorzogen». Jeder Marketing-Agent, der im Web recherchiert, kann auf dieselbe Weise scheitern: Die Antwort klingt richtig, und die Quellen sind die falschen.
Gelesen wird nur ein Teil
Der dritte Fehler ist leiser. Ein Agent liest nur, was eine Regel markiert hat, oder nur die Zusammenfassung, die ein Werkzeug erzeugt hat, und die Antwort liegt in dem Teil, den niemand angesehen hat.
Die Anzeigen eines Kunden laufen nur von Montag bis Freitag, also enthalten 28 Tage 20 Tage, an denen sie aktiv sein können, nicht 28. In der Vorperiode waren sie an 20 von diesen 20 Tagen aktiv, in der letzten an 7 von 20, weil die Anzeigen für eine Plattformprüfung pausiert worden waren. Eine Zusammenfassung, die nur sagt, der Traffic sei gefallen, liest sich wie ein Einbruch.
Die aktiven Tage aus dem stündlichen Anzeigenplan zu zählen und nicht aus dem Kalender, zeigte, woher der Rückgang kam, und gab dem Vergleich die richtige Basis.
Auf einer Website, die Kontaktanfragen sammelt, kamen 242 von 525 Sitzungen, also 46 Prozent, aus Ländern, in denen Rechenzentren stehen. Fast alle dieser Besuche hatten keine verweisende Website, sahen sich eine Seite an und blieben im Schnitt 0,4 Sekunden, so verhält sich ein Programm und kein Mensch. Die Zahl stand die ganze Zeit in der Tabelle, und kein Schwellenwert suchte nach ihr.
Wie ich aus diesen beiden Fällen einen Bericht gemacht habe, steht in meinem Artikel zum Marketing-Report.
Der Entwurf in drei Schritten: Skript, Lesen, Nachweis
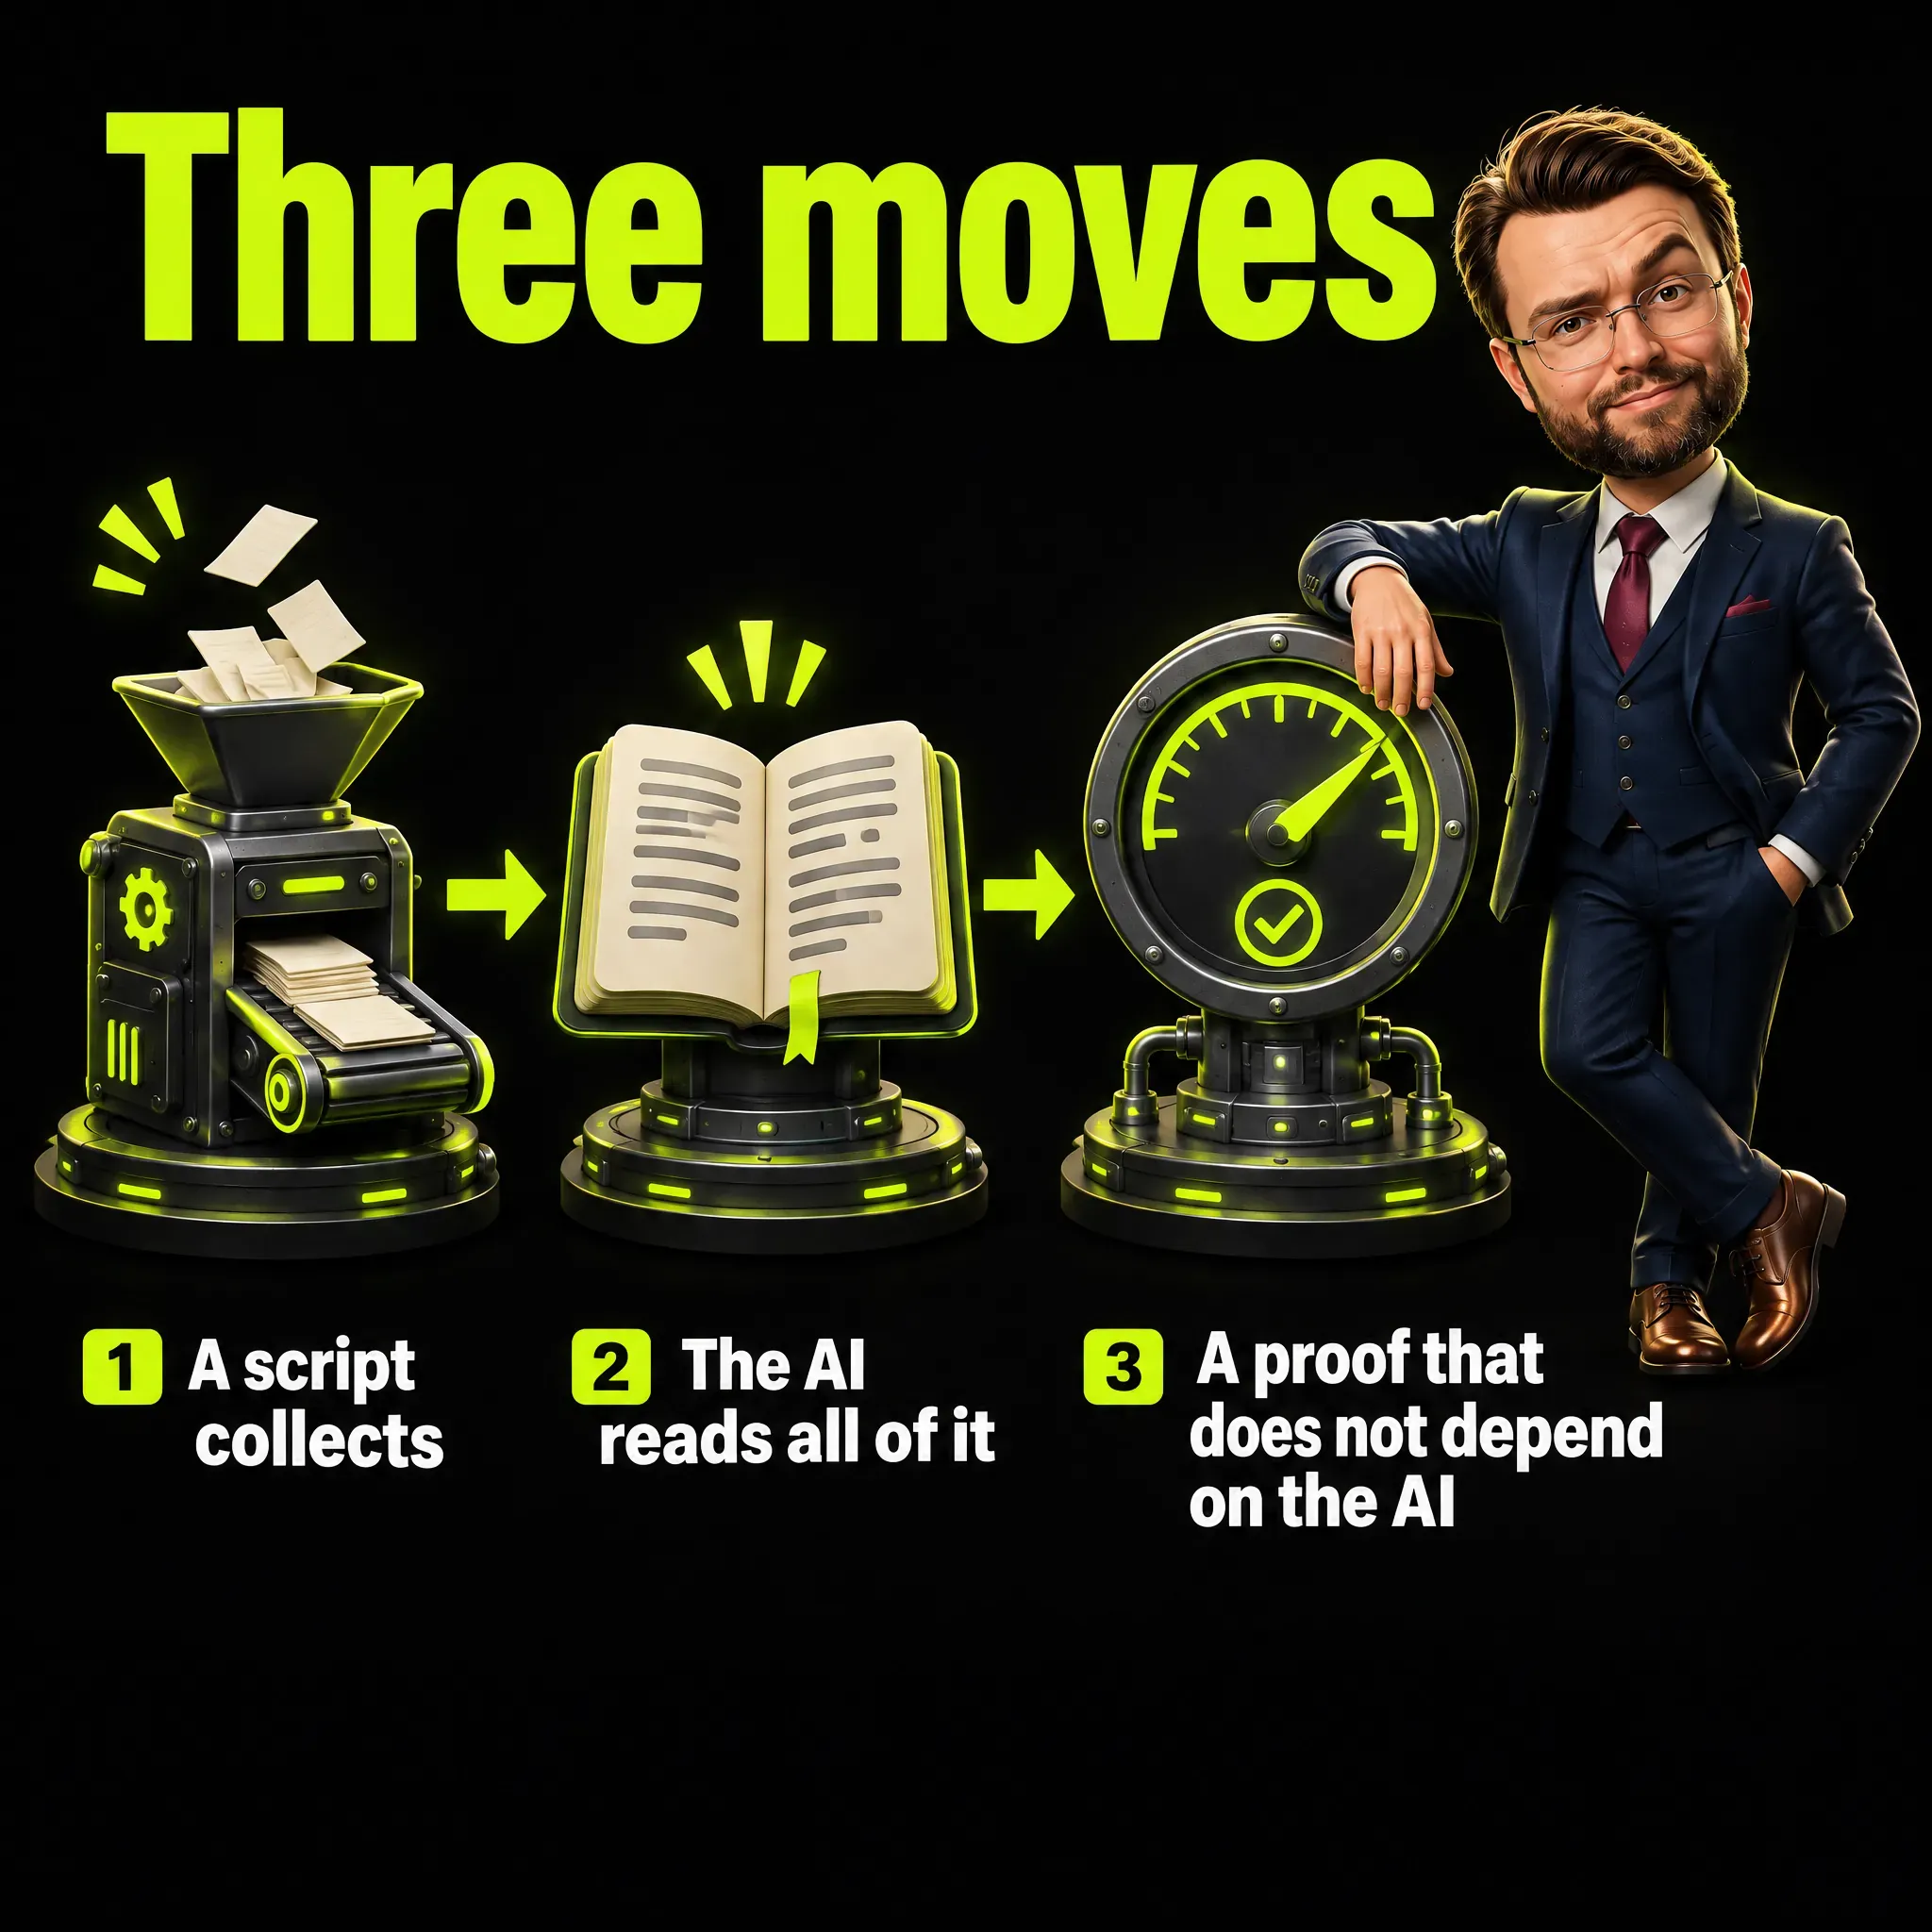
Schritt eins: Ein Skript sammelt alles. Keine KI und keine Kosten in Tokens, den kleinen Textstücken, die ein Modell liest und schreibt. Das Skript lädt alles herunter, was der Agent ansehen wird, und entfernt Duplikate.
Dann berechnet es die Vergleiche (mit gestern und mit den Durchschnitten der letzten 7 und 28 Tage), kennzeichnet jeden Eintrag und schreibt eine nummerierte Liste. Ich nenne sie den Digest.
Schritt zwei: Die KI liest den ganzen Digest. An jedem Tag mit Neuigkeiten liest das Modell die gesamte Liste. Es hat keine Werkzeuge, keinen Webzugang und keine Verbindungen: Es liest und gibt strukturierte Vorschläge zurück.
Texte von Dritten, etwa Feeds und Webseiten, werden als nicht vertrauenswürdige Daten behandelt. Schweregrad, Links und Codes berechnet der Code, und die KI wählt Einträge anhand der Nummer, sie kann also keinen Link erfinden. Wie sich ein Agent gegen eingeschleuste Anweisungen in solchen Texten absichern lässt, beschreibe ich in Prompt Injection und KI-Agenten absichern.
Schritt drei: Ein Nachweis, der nicht von der KI abhängt. Anthropics Leitfaden sagt: «Es ist entscheidend, dass die Agenten bei jedem Schritt ‹Ground Truth› aus der Umgebung gewinnen (etwa Ergebnisse von Werkzeugaufrufen oder Codeausführung), um ihren Fortschritt zu beurteilen.» Anthropic verwendet den Begriff für Ergebnisse, die der Agent bei jedem Schritt von seinen Werkzeugen bekommt, und ergänzt, dass ein Agent an Kontrollpunkten innehalten kann, um menschliches Feedback einzuholen.
Ich weite die Idee auf Prüfungen ausserhalb der Schleife aus. Im Marketing ist Ground Truth eine Prüfung, die scheitern kann und von anderswo kommt: der Anzeigenplan, eine zweite Datenquelle, ein Test, der das System zwingt, sich so zu verhalten wie in der Produktion, ein Mensch, der die Ausgaben freigibt.
Warum diese Reihenfolge? Das Skript erledigt die Arbeit, die keine Intelligenz braucht, günstig und jedes Mal gleich. Die KI wird einmal aufgerufen, um Material zu lesen, das bereits geordnet ist.
Dieselbe Aufteilung gibt es in Claude: Ein Skill kann schriftliche Schritte und kleine Skripte enthalten, die Claude ausführt, wenn eine Aufgabe passt. Welche Arbeit einen Skill verdient und warum einer mit Code zuerst geprüft gehört, steht in Claude Skills und ihre Risiken.
Vier Marketing-Aufgaben, je drei Schritte
Hier sind vier Aufgaben, die auf diesem Entwurf aufbauen, mit dem Stand jeder einzelnen. Der Kundenbericht läuft, und das Lesen der Google-Ads-Daten läuft darin mit.
Die Tracking-Prüfung ist ein getestetes Verfahren, noch kein täglicher Agent. Beim Kommentar-Leser ist das Bewertungswerkzeug gebaut, und der tägliche Agent ist noch ein Plan.
Google Ads überwachen
Das Skript sammelt für jede Kampagne die Ausgaben, Klicks, Conversions, Kosten pro Kontakt, den Impressionsanteil (wie oft die Anzeigen ausgespielt wurden, wenn sie es konnten), die Suchbegriffe, die Leute eingegeben haben, die Tage, an denen die Anzeigen laut stündlichem Anzeigenplan aktiv waren, und den Vergleich mit gestern sowie mit den Durchschnitten der letzten 7 und 28 Tage. Die KI liest die ganze Liste und liefert Empfehlungen mit Zahl, Zeitfenster und Vergleich, nie Aktionen.
Der Nachweis: Das Skript zählt die aktiven Tage anhand des Anzeigenplans, die Conversions werden mit einer zweiten Quelle abgeglichen (Kontakte in der Analytics der Website, Bestellungen im Shop), und ohne meine ausdrückliche Freigabe wird nichts ausgegeben oder geändert, nicht einmal eine Pause. Das Lesen ohne Schreibzugriff läuft schon in meinem wöchentlichen Kundenbericht. Der tägliche Agent ist in zwei Stufen geplant: zuerst Empfehlungen, dann eine separate, freigegebene Aktion aus einer geschlossenen Liste, etwa ein Negativ-Keyword hinzufügen (ein Wort, das verhindert, dass die Anzeigen bei einer Suche erscheinen) oder ein Keyword oder eine Anzeige pausieren, und nie Budgets oder Gebote.
Tracking-Prüfungen
Das Skript zählt Ereignisse und verschiedene Personen pro Ereignis, nach Land und Quelle, dazu Dauer, Seiten und Engagement pro Sitzung. Es schickt ausserdem eine Testübermittlung mit einem Testparameter. Die KI liest die ganze Tabelle, Land mal Quelle mal Engagement, und die wiederholten Ereignisse.
Der Nachweis ist ein Browsertest, in dem jeder Aufruf an den Server der Website ein vorgetäuschtes «ok» erhält und jeder Aufruf an Analytics aufgezeichnet und dann blockiert wird. Dieser Test hat auf einer Kundenwebsite ein Formularereignis reproduziert, das zweimal im Abstand von 50 Millisekunden eintraf. Er erklärte, warum vier «Lead»-Ereignisse in den Daten drei Formularübermittlungen von zwei Personen waren, allesamt Testkontakte aus dem eigenen Team des Kunden.
Eine frühere Version des Tests hatte die Aufrufe an den Server der Website blockiert, sodass das zweite Auslösen des Ereignisses nie sichtbar wurde. Ich habe die Tag-Konfiguration am 11. Oktober korrigiert und mit demselben Test erneut geprüft.
Die Einwilligung behandelt meine Checkliste zur Tracking-Einwilligung in der Schweiz (auf Englisch).
Kundenberichte
Das Skript liest Daten aus Analytics, Suche und Werbung im Nur-Lese-Modus, dazu die Bestellsummen aus dem Shop ohne personenbezogene Daten und eine Reihe von Website-Prüfungen, etwa Serverantwort, Zertifikat, Sicherheits-Header, E-Mail-Authentifizierung, Sitemap und die bei echten Besuchern gemessene Geschwindigkeit. Die KI liest das Wochenprotokoll dessen, was für den Kunden getan wurde, und schreibt den Entwurf des Textteils, den ich lese, bevor etwas hinausgeht.
Der Nachweis: Zahlen und zusammenfassende Sätze stammen aus Formeln, also schreibt kein Modell eine Zahl. Ein fehlender Wert erscheint als «n/a», nie als Null, und Vergleiche verwenden dieselben Tage.
Eine Tonprüfung sperrt den Entwurf, solange echter Schaden dem Kunden nicht mitgeteilt wurde, und pro Zeitraum geht nur eine Nachricht raus. Der Bericht läuft, und ich genehmige jede Nachricht, bevor sie zum Kunden geht. Dazu passend: Marketing Operations.
Kommentare lesen
Das Skript sammelt die Zahlen nach 24 Stunden und nach 7 Tagen (Impressionen, Reaktionen, Kommentare, Shares, Speicherungen, Profilbesuche) aus einem Export oder aus Screenshots, dazu den Text der Kommentare und wer sie geschrieben hat sowie eine mechanische Bewertung des Entwurfs. Die KI liest die echten Kommentare, gruppiert sie in Themen und wiederkehrende Fragen und schlägt Inhaltsideen vor, mit einer Zusammenfassung und einer neuen Regel alle vier Beiträge.
Der Nachweis: eine Bewertung mit 12 Prüfpunkten für das, was Code verifizieren kann, und mein eigenes Urteil für den Rest, etwa eine präzise Idee und die Stimme. Ich schaue auf Grössenordnungen, nicht auf Unterschiede von 10 Prozent.
Dieser Agent antwortet oder kommentiert nie von selbst, und der erste Kommentar unter einem Beitrag wird von Hand geschrieben. Die Bewertung und das Importwerkzeug existieren, mit 44 automatisierten Tests, und der tägliche Agent ist noch ein Plan.
Wie ich die Prüfungen rund um einen KI-Marketing-Agenten teste
Grüne Tests sagen wenig, solange man nicht versucht hat, sie scheitern zu lassen. Meine Methode: Ich erfinde Fehler, baue sie einzeln in eine Kopie des Codes ein und zähle, wie viele die Tests fangen.
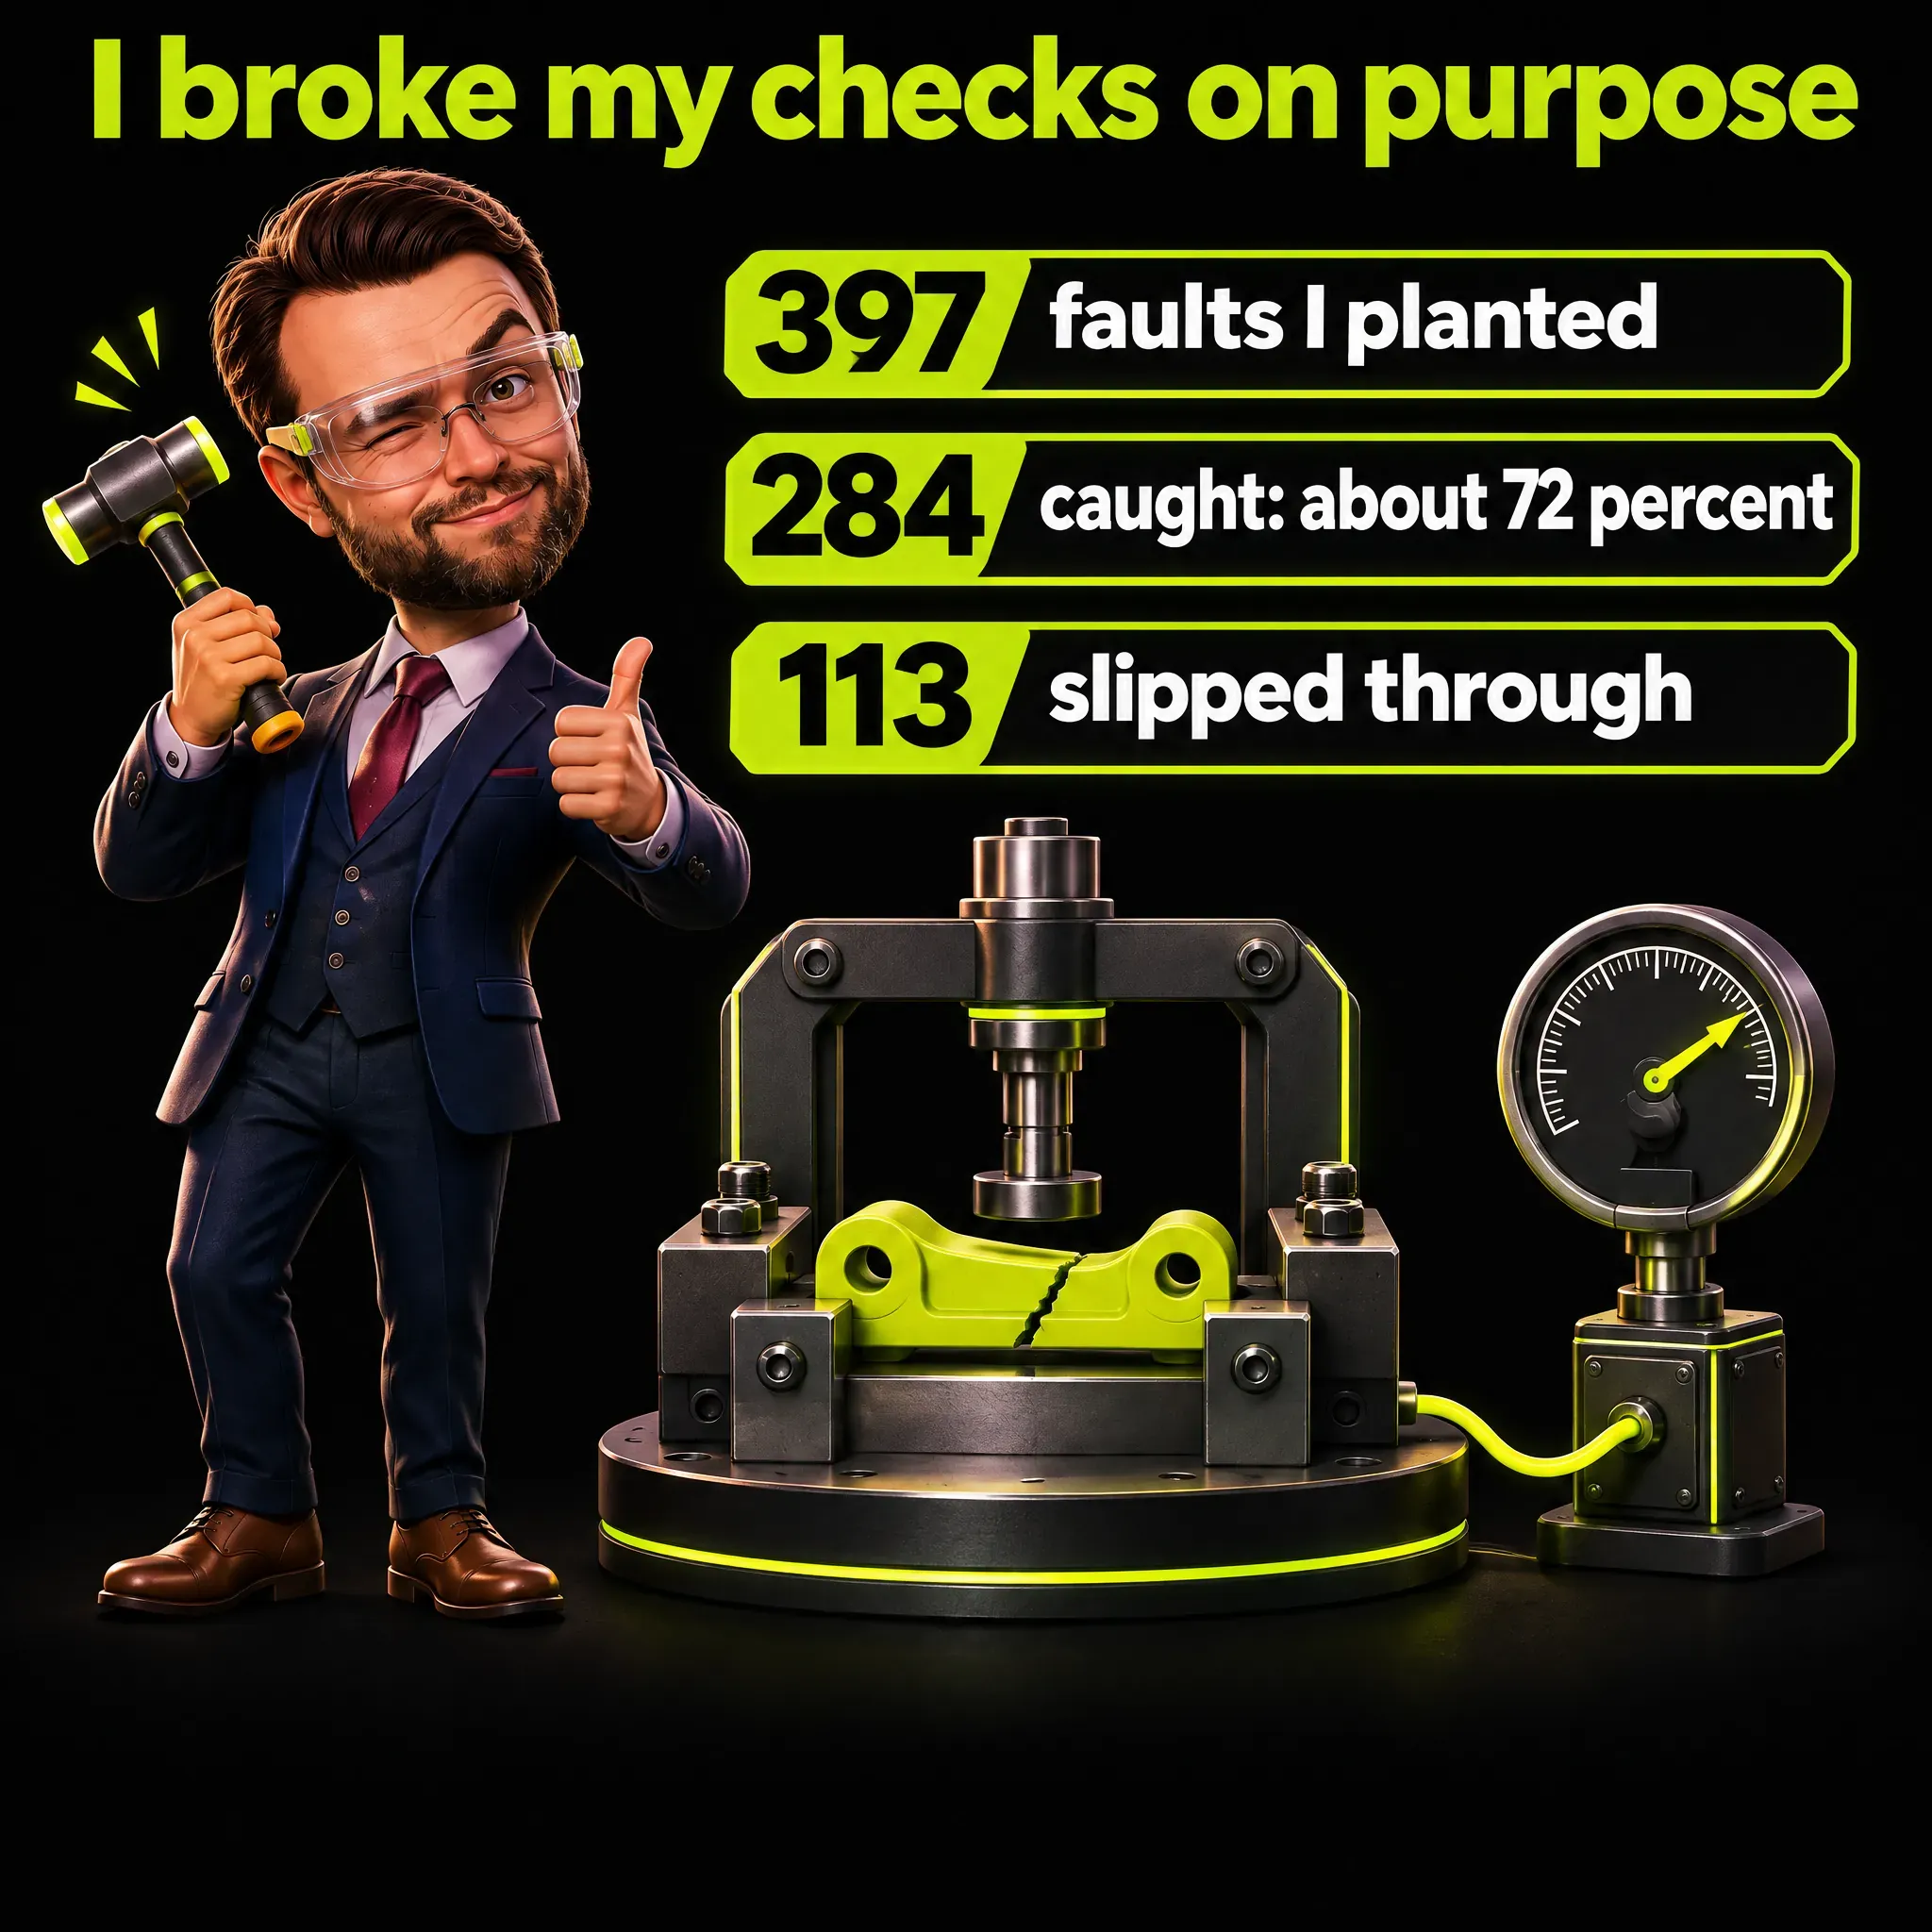
Ich habe das dreimal gemacht. Bei der Prüfung, die die Liste der Kundenwebsites und Komponenten validiert, habe ich 399 Fehler erfunden, von denen sich 397 ausführen liessen. Die Tests fingen 284 sofort, etwa 72 Prozent, und 113 rutschten durch.
Von diesen 113 waren 12 äquivalent, das heisst, sie veränderten das Verhalten nicht, und 101 waren echte Lücken, die ich mit neuen Prüfungen geschlossen habe. Die echten Lücken machen etwa 25 Prozent der 397 aus.
Woher die Zahl kommt: erfundene Fehler in einer Kopie der Prüfung. Was sie bedeutet: Etwa ein Fehler von vier, die ich in meine heikelste Prüfung eingebaut habe, wäre von deren eigenen Tests unbemerkt geblieben. Was sich ändert: «Grün» ist kein Beweis mehr, sondern eine Frage: Was hat dieser Test zu brechen versucht?
Beim Skript, das eine Datei an den Server schickt, habe ich 84 Fehler ausprobiert. Die Tests fingen 78, und 6 rutschten durch, davon schloss ich 2 echte Lücken und dokumentierte 4 äquivalente. Nachdem ich im Test selbst eine Lücke gefunden hatte, fügte ich 4 weitere Fehler hinzu, und die Tests fingen alle.
Eine frühere Runde mit 56 erfundenen Fehlern gegen eine Testsuite, die ich für gut hielt, endete mit neuen Prüfungen und 56 von 56 gefangenen Fehlern. Diese Geschichte steht im AI-Slop-Artikel.
Das zweite Werkzeug ist eine zweite KI, die als Reviewer arbeitet und meine Schlussfolgerungen nicht kennt. Sie bekommt den Code, nicht meine Geschichte dazu, und sie kann nur lesen. Genau das macht sie dort nützlich, wo der Prüfer in der Filmgeschichte es nicht war: Sie hat keine Schlussfolgerung, der sie zustimmen könnte.
Beim Nachrichten-Agenten gab ein solcher Reviewer, frisch gestartet ohne Erinnerung an die Arbeit und auf intensives Nachdenken eingestellt, 9 Befunde. Ich habe 6 behoben, jeweils mit einem Test, der zuerst scheiterte, denn eine Korrektur ohne scheiternden Test beweist nichts. Zur breiteren Gewohnheit, KI-Ausgaben zu verifizieren, siehe meinen Artikel zur Human-in-the-Loop-Verifikation bei KI.
Was ein KI-Marketing-Agent kostet: Prozent des Abos, nicht Dollar
Bei einem Abo ist ein Preis in Dollar nur theoretisch. Entscheidend ist der Anteil des Abos, der verbraucht wird, im 5-Stunden-Fenster und im Wochenfenster, die das Abo ausweist.
Der Fall, der das greifbar gemacht hat: In der Nacht vom 17. auf den 18. Oktober verbrauchten drei lange Agentenläufe, zusammen rund 15 Millionen Tokens (11,1 plus 1,0 plus 3,1 Millionen), das Wochenlimit schon in der Mitte der Arbeit.
Die Agenten konkurrieren mit allem anderen um dieselbe Obergrenze. Anthropic nennt die Richtung: «Agenten verbrauchen typischerweise etwa 4-mal so viele Tokens wie Chat-Interaktionen, und Multi-Agenten-Systeme etwa 15-mal so viele Tokens wie Chats.» Diese Multiplikatoren stammen aus Anthropics eigenem Forschungssystem und nicht aus Marketingaufgaben, deshalb lese ich sie als Warnung und nicht als Messung.
Meine eigenen Zahlen, mit dem, was sie sind:
- Kalibrierung, eine Grössenordnung. Nach meinen Transkripten vom 18. Oktober entspricht 1 Prozent der Woche etwa 0,64 Millionen Output-Tokens, dem Text, den das Modell schreibt. Die 15 Millionen oben zählen auch alles mit, was die Agenten lasen, deshalb lassen sich die beiden Zahlen nicht ineinander umrechnen.
- Schätzungen, keine Messungen. Ein Lesevorgang kostet etwa 8.000 bis 25.000 Tokens beim Lesen und 1.000 bis 2.000 beim Schreiben. Der Nachrichten-Agent samt der zweiten KI, die seine Vorschläge prüft, sollte höchstens etwa 0,1 Prozent der Woche brauchen. Ein täglicher Agent, der eine Website liest, sollte etwa 0,2 bis 0,5 Prozent der Woche brauchen.
Das alles gilt für mein ganzes Konto, nicht für einen einzelnen Lauf, und die Prozent eines Abos gelten nur für jemanden, der ein Abo bezahlt. Was sich ändert, ist die Reihenfolge der Arbeit: erst schätzen, in Etappen starten und das Skript alles erledigen lassen, was kein Lesen braucht.
Wann Sie keinen KI-Marketing-Agenten brauchen
- Das Rezept ist bekannt. Wenn Sie «Wenn X, dann Y» hinschreiben können, kostet ein Workflow weniger und scheitert auf vorhersehbare Weise. Meine Kundenberichte laufen aus genau diesem Grund auf festen Formeln.
- Ein falscher Schritt ist teuer und schwer zu sehen. Anthropic warnt vor sich aufsummierenden Fehlern. Wo ein Fehler Geld oder Vertrauen kostet, halte ich Ausgaben, Nachrichten an Kunden und Kommentare hinter einer menschlichen Freigabe und neige zu einem Workflow.
- Sie können den Nachweis nicht benennen. Wenn niemand sagen kann, welche Prüfung zeigen würde, dass der Agent falsch lag, rate ich, gar nicht erst anzufangen.
Wenn Sie ein Unternehmen führen und jemand einen Agenten vorschlägt, empfehle ich eine einzige Frage: Welche Prüfung würde uns zeigen, dass er falsch lag? Eine gute Antwort nennt eine zweite Quelle, einen Zeitplan oder einen Test. Eine schwache Antwort lautet «Die KI prüft sich selbst».
Das Scheitern ganzer Projekte ist ein anderes Thema und steht in warum KI-Marketing-Implementierungen scheitern. Dieser Artikel handelt vom leiseren Scheitern eines Agenten, der einfach weiterläuft.
Checkliste, bevor ein KI-Marketing-Agent allein läuft
Ich schlage diese Reihenfolge vor:
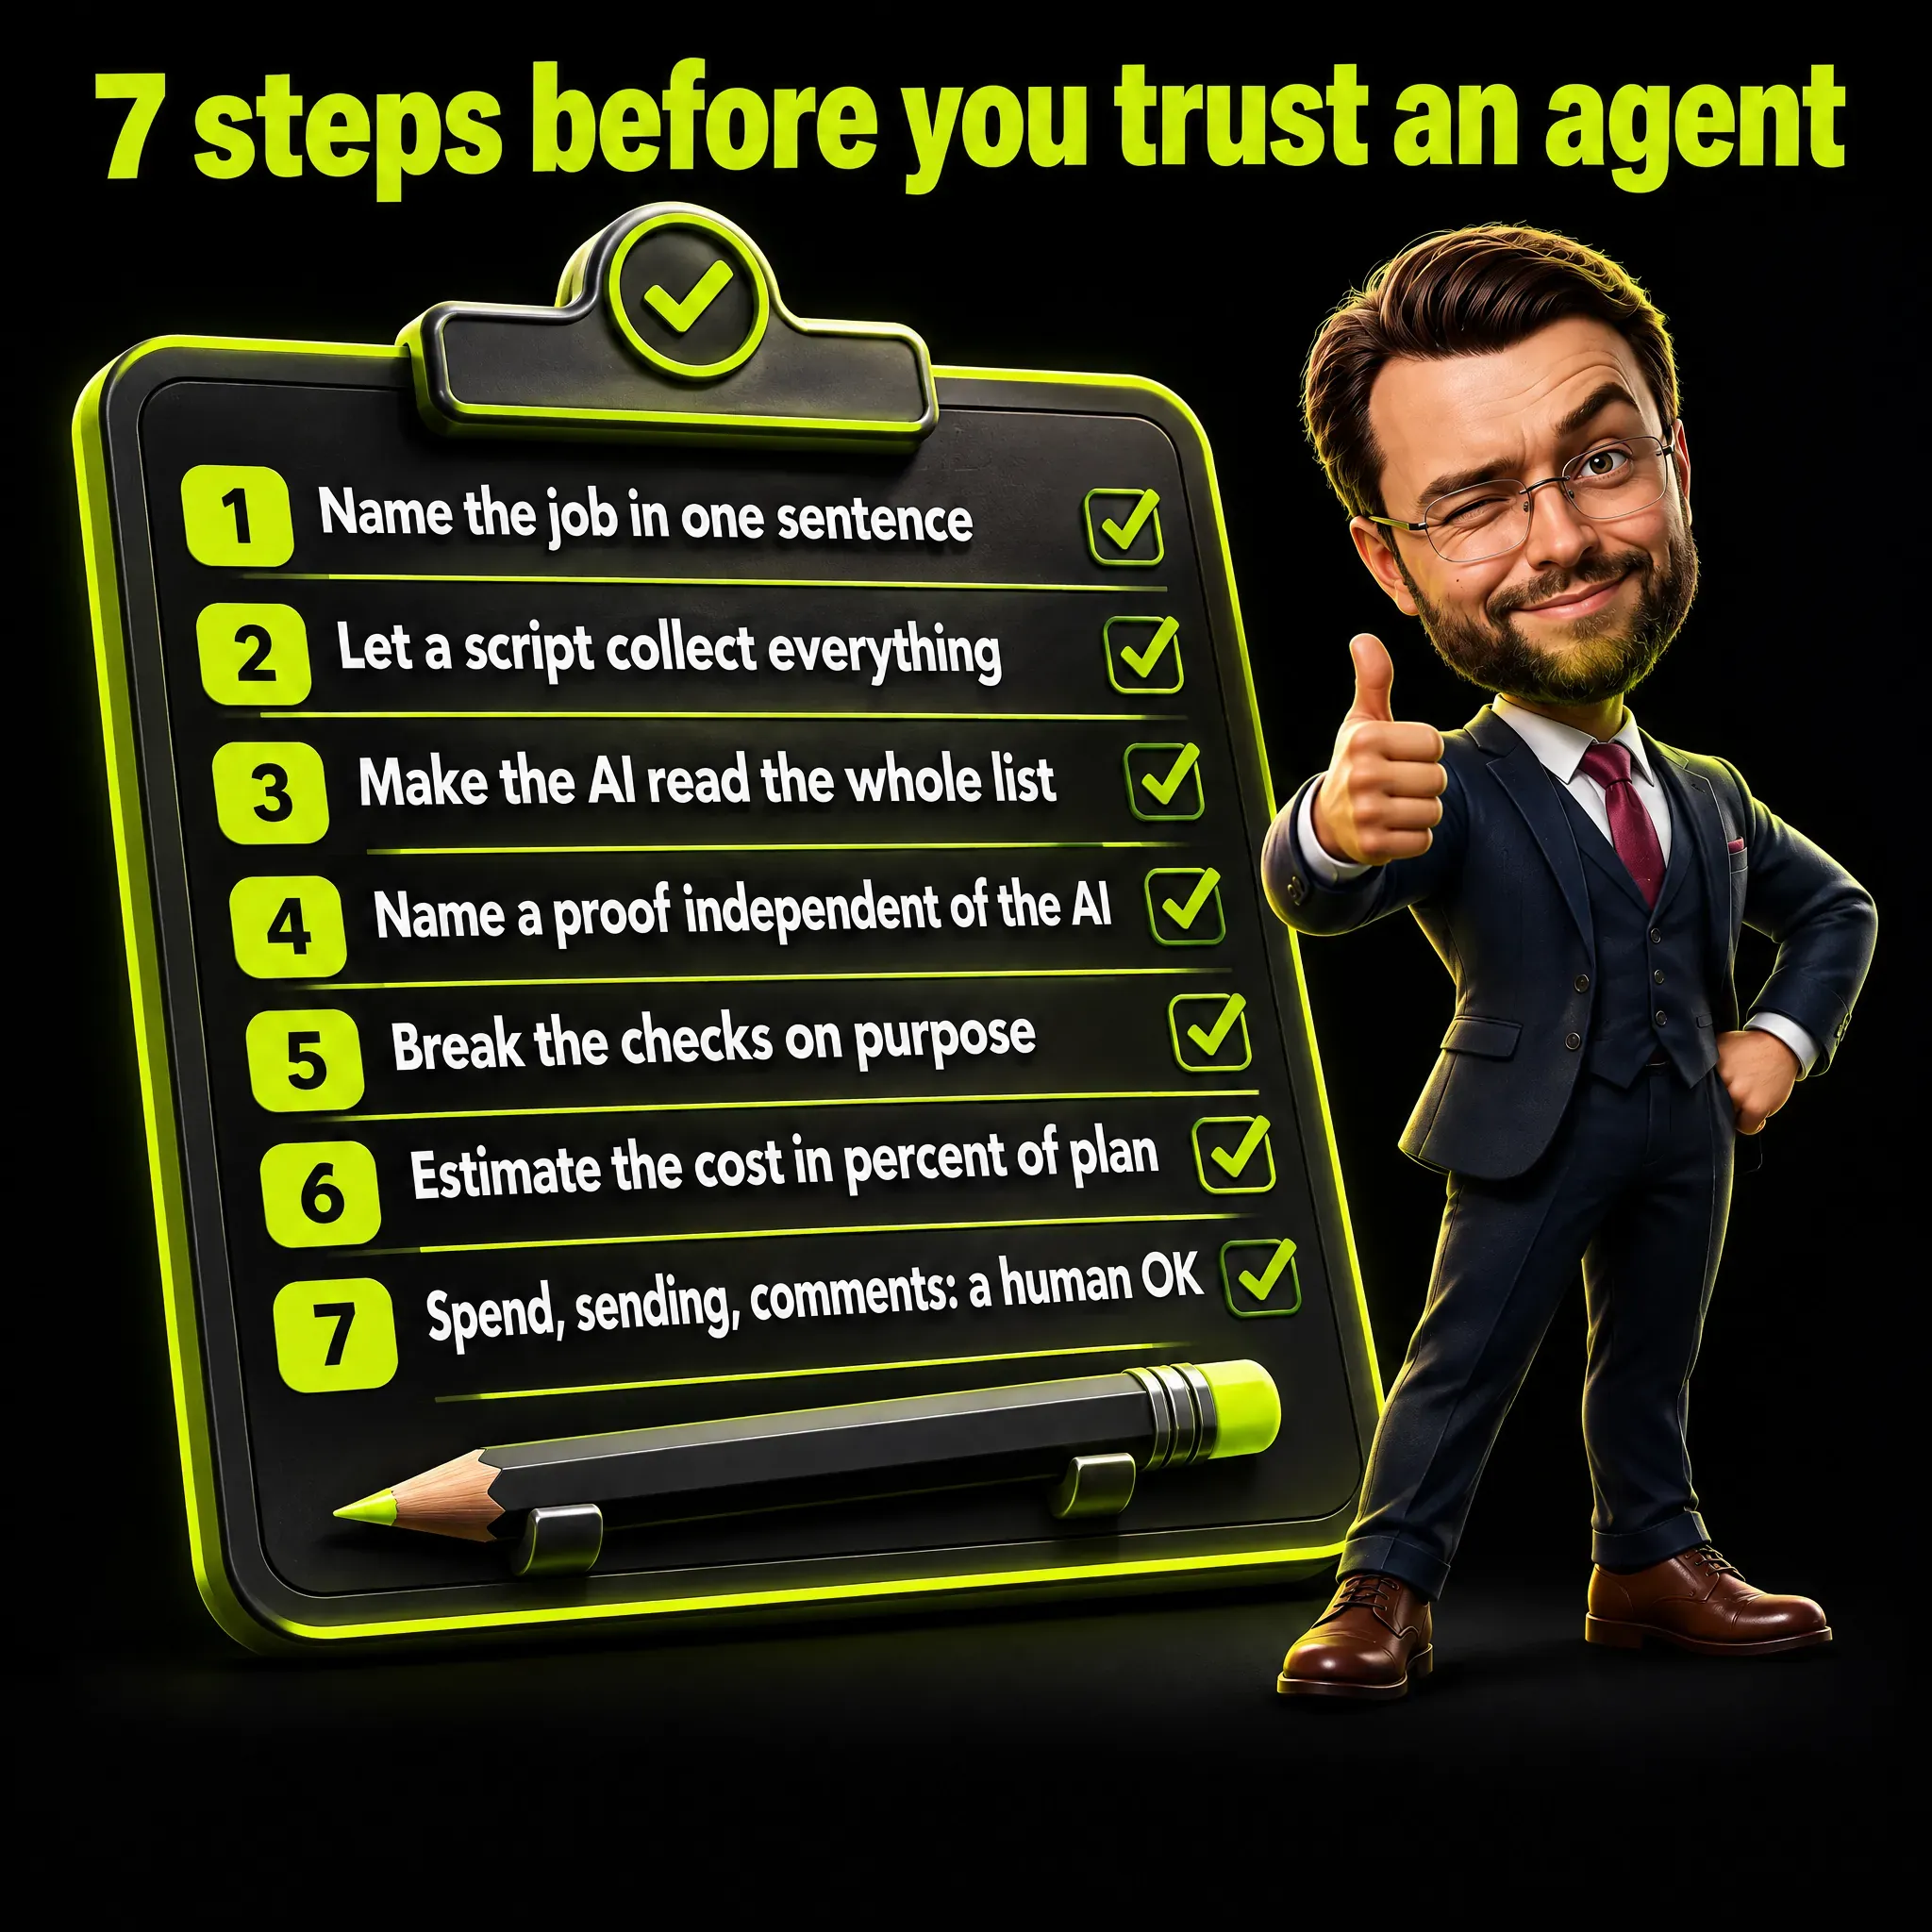
- Benennen Sie die Aufgabe in einem Satz und die Entscheidung, die sie unterstützt.
- Lassen Sie ein Skript alles sammeln. Behalten Sie Schwellenwerte als Markierungen zum Sortieren und für Warnungen, nie als Bedingung, ob man hinsieht.
- Lassen Sie die KI die ganze Liste lesen, und erlauben Sie ihr die Antwort «Unbekannt».
- Benennen Sie einen Nachweis, der nicht von der KI abhängt: eine zweite Quelle, einen Zeitplan oder einen Test, der das Verhalten der Produktion erzwingt.
- Brechen Sie die Prüfungen mit Absicht, bevor Sie einem grünen Ergebnis trauen.
- Schätzen Sie die Kosten in Prozent des Abos und starten Sie in Etappen.
- Halten Sie Ausgaben, Versand und Kommentare hinter einer menschlichen Freigabe.
Wenn Skript, Lesen und Nachweis alle benannt sind, können sich KI-Marketing-Agenten immer noch irren, aber sie können es nicht verbergen. Das grössere Bild, wo KI in einen Marketingplan gehört, steht in meinem Artikel zur KI-Marketing-Strategie und in KI im Marketing nutzen.
Häufige Fragen
Was sind KI-Marketing-Agenten?
Software, in der ein KI-Modell seine Schritte und Werkzeuge selbst wählt, um ein Marketingziel zu erreichen, im Gegensatz zu einem Workflow, der einem im Voraus geschriebenen Rezept folgt. In der Praxis sind viele Produkte, die als Agenten verkauft werden, Workflows.
Was ist Agentic Marketing?
Marketing, bei dem ein Teil der Arbeit an einen Agenten übergeben wird, der seine Schritte selbst wählt. Ich verwende Anthropics Definition eines Agenten und erfinde keine eigene Branchendefinition.
Was ist der Unterschied zwischen einem KI-Agenten und Marketing-Automatisierung?
Ein Workflow folgt Pfaden, die im Code festgelegt sind; ein Agent steuert seinen Ablauf selbst. Die Übersicht, was man zuerst automatisieren sollte, steht in meinem Artikel zur KI-Marketing-Automatisierung.
Welche Beispiele für KI-Marketing-Agenten gibt es?
Vier Aufgaben aus meiner eigenen Arbeit: Google-Ads-Kampagnen überwachen, Tracking prüfen, Kundenberichte vorbereiten und Kommentare unter Beiträgen lesen. Jede hat dieselben drei Schritte: Ein Skript sammelt, die KI liest, ein Nachweis ausserhalb der KI prüft.
Was sind die besten KI-Agenten für Marketing?
Der beste für Sie ist der, dessen Fehler Sie sehen können. Fragen Sie vor dem Kauf eines Agenten, was er sammelt, was er liest und welcher unabhängige Nachweis ihn prüft.
Woran merke ich, dass ein KI-Agent nichts übersehen hat?
Nicht mit einem Schwellenwert. Lassen Sie ein Skript alles sammeln und die KI alles lesen. Fügen Sie dann einen Nachweis hinzu, der nicht von der KI abhängt, und eine zweite KI, die den Code prüft, ohne Ihre Schlussfolgerungen zu kennen.
Brauche ich überhaupt einen Agenten?
Oft nicht. Wenn das Rezept bekannt ist, ist ein Workflow günstiger und scheitert auf vorhersehbare Weise. Anthropic sagt es so: «Das kann bedeuten, überhaupt keine agentischen Systeme zu bauen.»
Wie viel von meinem KI-Abo verbraucht ein Agent?
Messen Sie es in Prozent des Abos, nicht in Dollar. Agenten verbrauchen mehr als ein Chat, deshalb schätze ich zuerst und lasse das Skript alles erledigen, was kein Lesen braucht.


