Der Engpass hat sich verschoben: AI Slop vs. menschliche Prüfung
AI Slop ist billig zu erzeugen und teuer zu prüfen. Warum der Engpass vom Erstellen zum Prüfen wanderte: echte Zahlen, eigene Fehler und ein Prüfbudget.
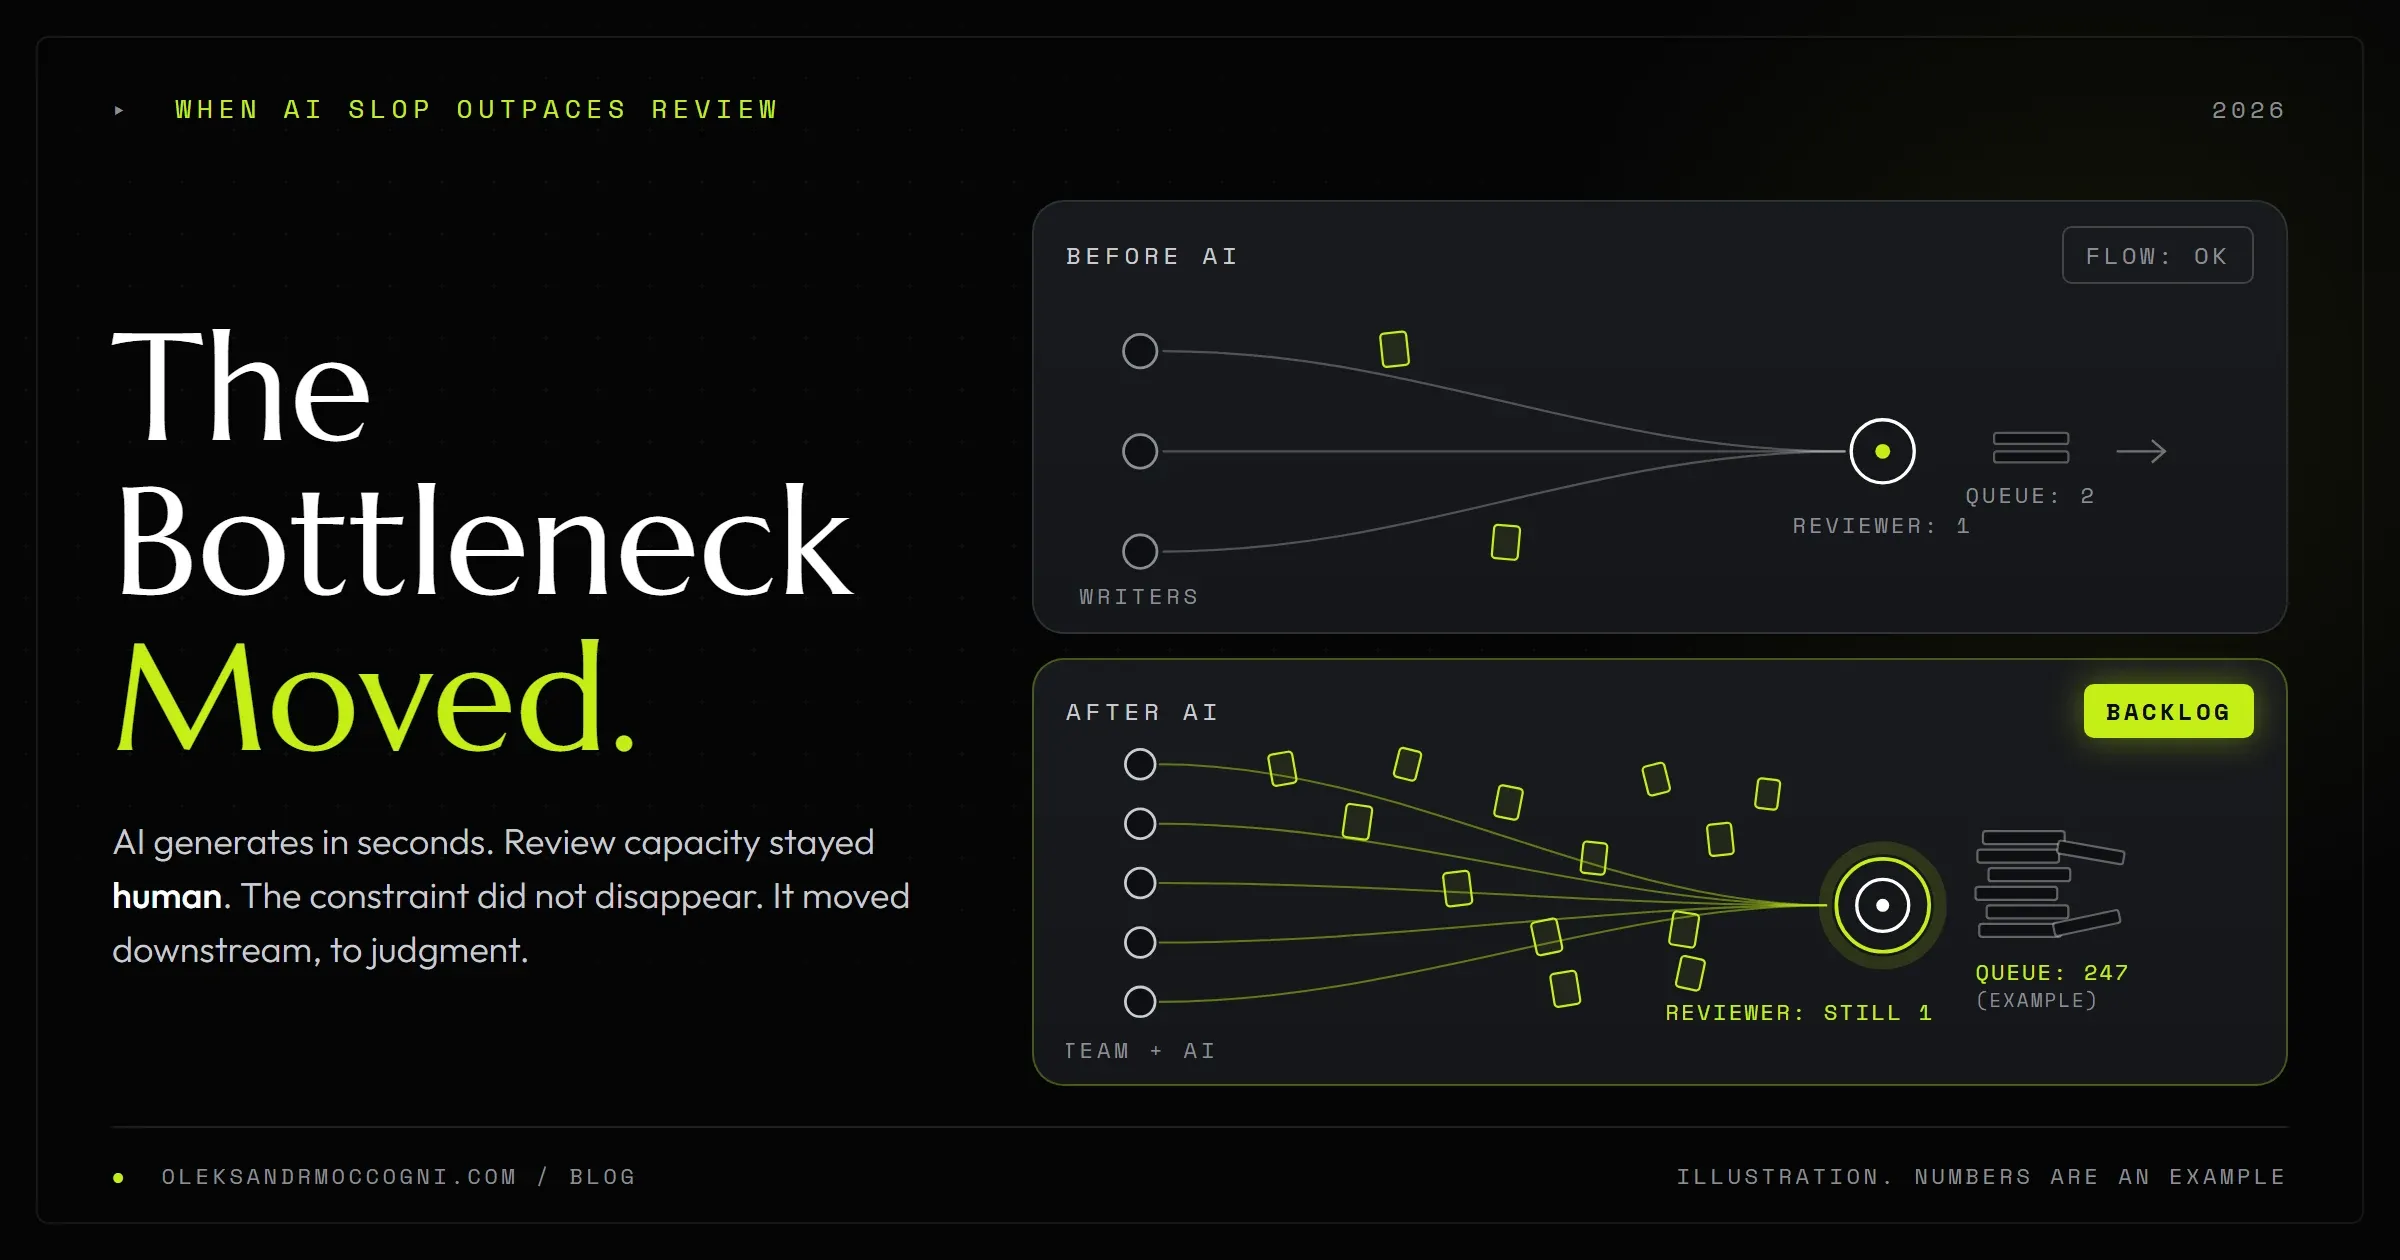
AI Slop ist nicht in erster Linie ein Schreibproblem. Er entsteht, wenn das Erzeugen von Ergebnissen fast nichts mehr kostet, das Prüfen aber nicht billiger wird.
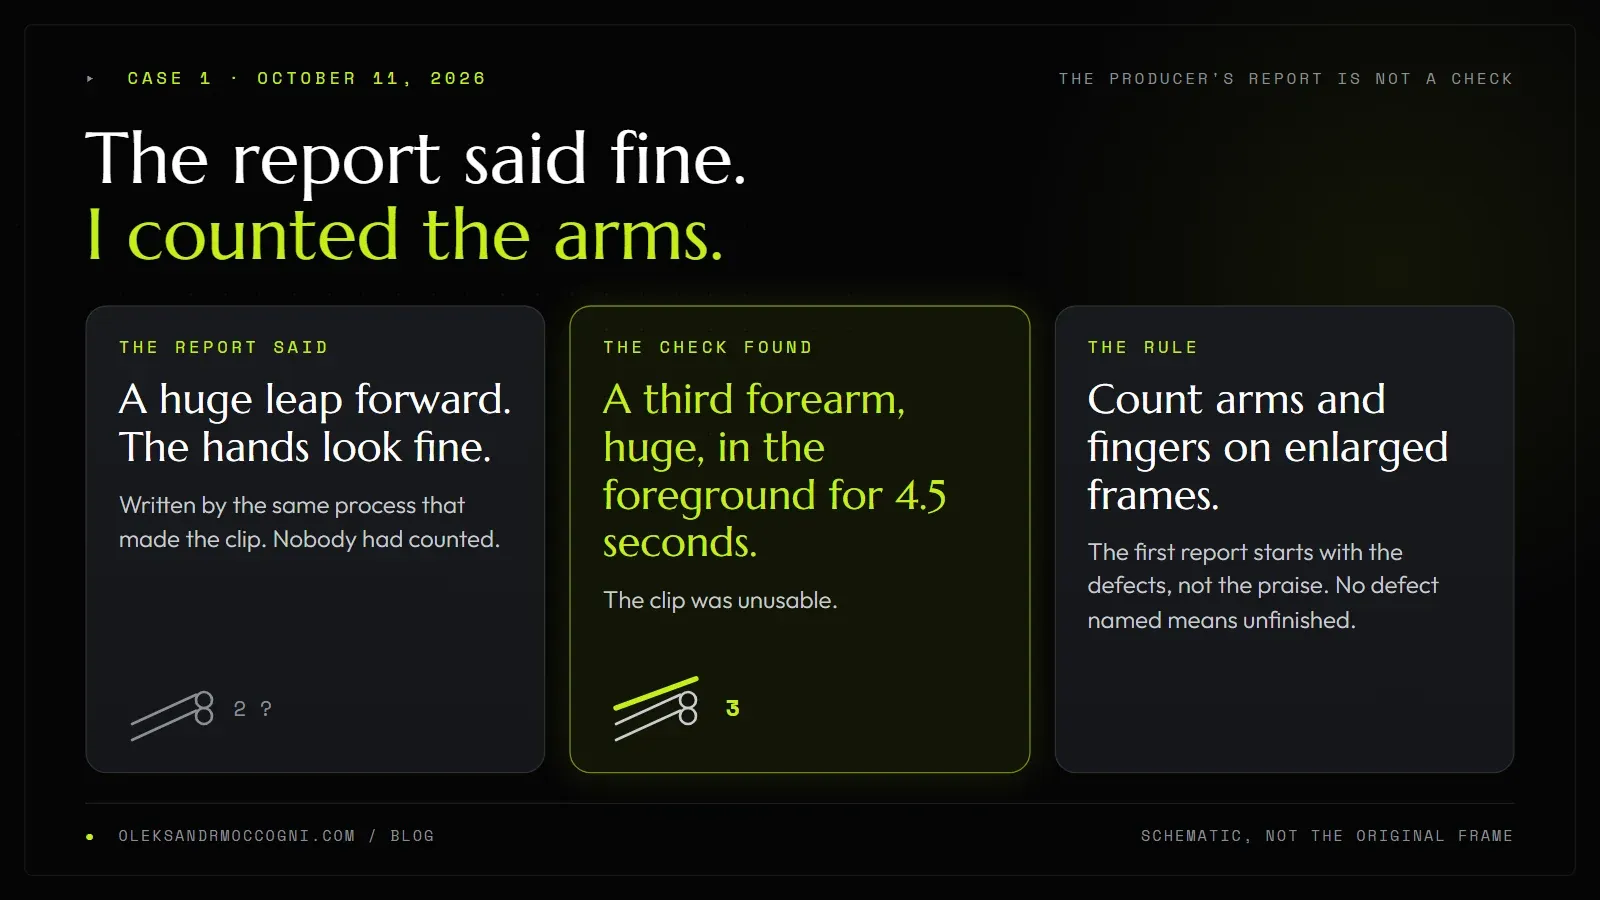
Am 11. Oktober 2026 sagte mir ein KI-Assistent, das erste Segment eines generierten Kurzfilms sei ein riesiger Sprung nach vorn und die Hände sähen gut aus. Er hatte die Arme nicht gezählt.
Ich schon, und ein dritter Unterarm, riesig, hing 4.5 Sekunden lang im Vordergrund. Der Clip war unbrauchbar.
Das Modell war in dieser Geschichte nicht der Bösewicht. Das Problem lag im Schritt nach der Generierung: Jemand muss hinschauen, zählen und Nein sagen. Dieser Schritt wurde nicht schneller, als das Generieren schneller wurde.
Um diese Lücke geht es in diesem Artikel. Ich nenne sie den Prüfengpass: die Stelle in einem Arbeitsablauf, an der fertig aussehende Ergebnisse auf eine Person warten, die sie beurteilen kann. Ich definiere AI Slop (auf Deutsch auch KI-Slop), zeige die einzigen Zahlen zum Engpass, denen ich traue, gehe drei Fälle durch, in denen meine eigene Pipeline mich getäuscht hat, und gebe das Prüfbudget an, mit dem ich heute arbeite.
Das Wichtigste vorab
- AI Slop wird durch die fehlende Prüfung definiert, nicht durch das Modell. Die bekannteste Definition bezeichnet ihn als ungeprüften Inhalt, der jemandem übergeben wird, der ihn nicht verlangt hat.
- Der Engpass hat sich vom Erstellen zum Beurteilen verschoben. In einem grossen Datensatz führten Teams mit hoher KI-Nutzung 98% mehr Pull Requests zusammen, und ihre Prüfzeit stieg um 91%.
- Der Bericht des Erzeugers ist keine Prüfung. In meinen drei Fehlschlägen unten meldete dasselbe System, das die Arbeit gemacht hatte, auch, dass die Arbeit in Ordnung sei.
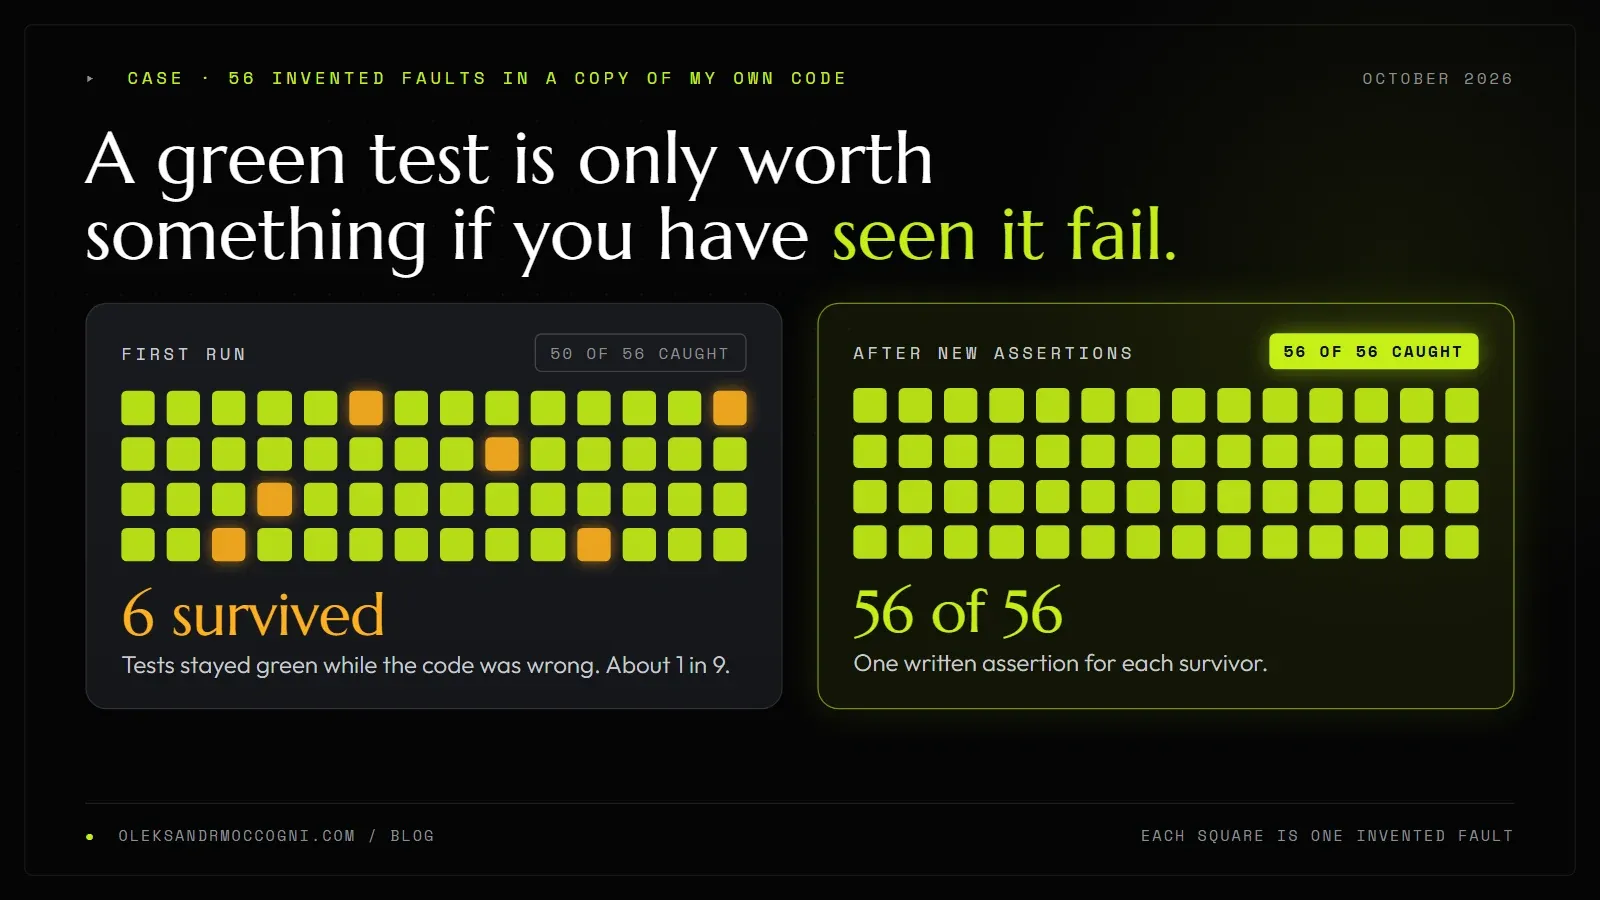
- Zuerst kommt die maschinelle Prüfung. Ich habe in einer Kopie meines eigenen Codes 56 Fehler erfunden: 50 wurden sofort gefunden, 6 überlebten, und heute werden 56 von 56 gefunden.
- Budgetieren Sie die Prüfung, bevor Sie mehr Output erzeugen. Wächst die Warteschlange ungeprüfter Elemente, hören Sie auf zu generieren.
- Vertrauen Sie nie einer Statusmeldung als Verifikation. Listen Sie auf, was läuft, und zählen Sie, was im Bild ist.
Was ist AI Slop? Die Bedeutung hinter dem Wort
Das Wort «Slop» verbreitete sich so schnell, dass Merriam-Webster es zum Wort des Jahres 2025 kürte. Die Definition des Wörterbuchs lautet, wie die Associated Press am 15. Dezember 2025 berichtete, «digitale Inhalte von geringer Qualität, die üblicherweise in grosser Menge mithilfe künstlicher Intelligenz hergestellt werden» (meine Übersetzung). Ihr Präsident Greg Barlow nannte Beispiele: absurde Videos, seltsame Werbebilder, Falschmeldungen, die echt aussehen, und minderwertige, von KI geschriebene digitale Bücher.
Das ist die Bedeutung laut Wörterbuch. Die schärfere kam früher. Am 8. Mai 2024 erklärte der Entwickler Simon Willison in einem kurzen Beitrag, was Slop bedeutet. Er sei «zunehmend der Meinung, dass es unhöflich ist, ungeprüfte, künstlich erzeugte Inhalte mit anderen Menschen zu teilen» (meine Übersetzung), und nannte Slop «den idealen Namen für dieses Anti-Pattern» (meine Übersetzung). Dazu setzte er eine Grenze, die zählt: «Nicht alle KI-generierten Inhalte sind Slop. Aber wenn sie gedankenlos erzeugt und jemandem aufgedrängt werden, der nicht danach gefragt hat, ist Slop der perfekte Begriff dafür.» (meine Übersetzung)
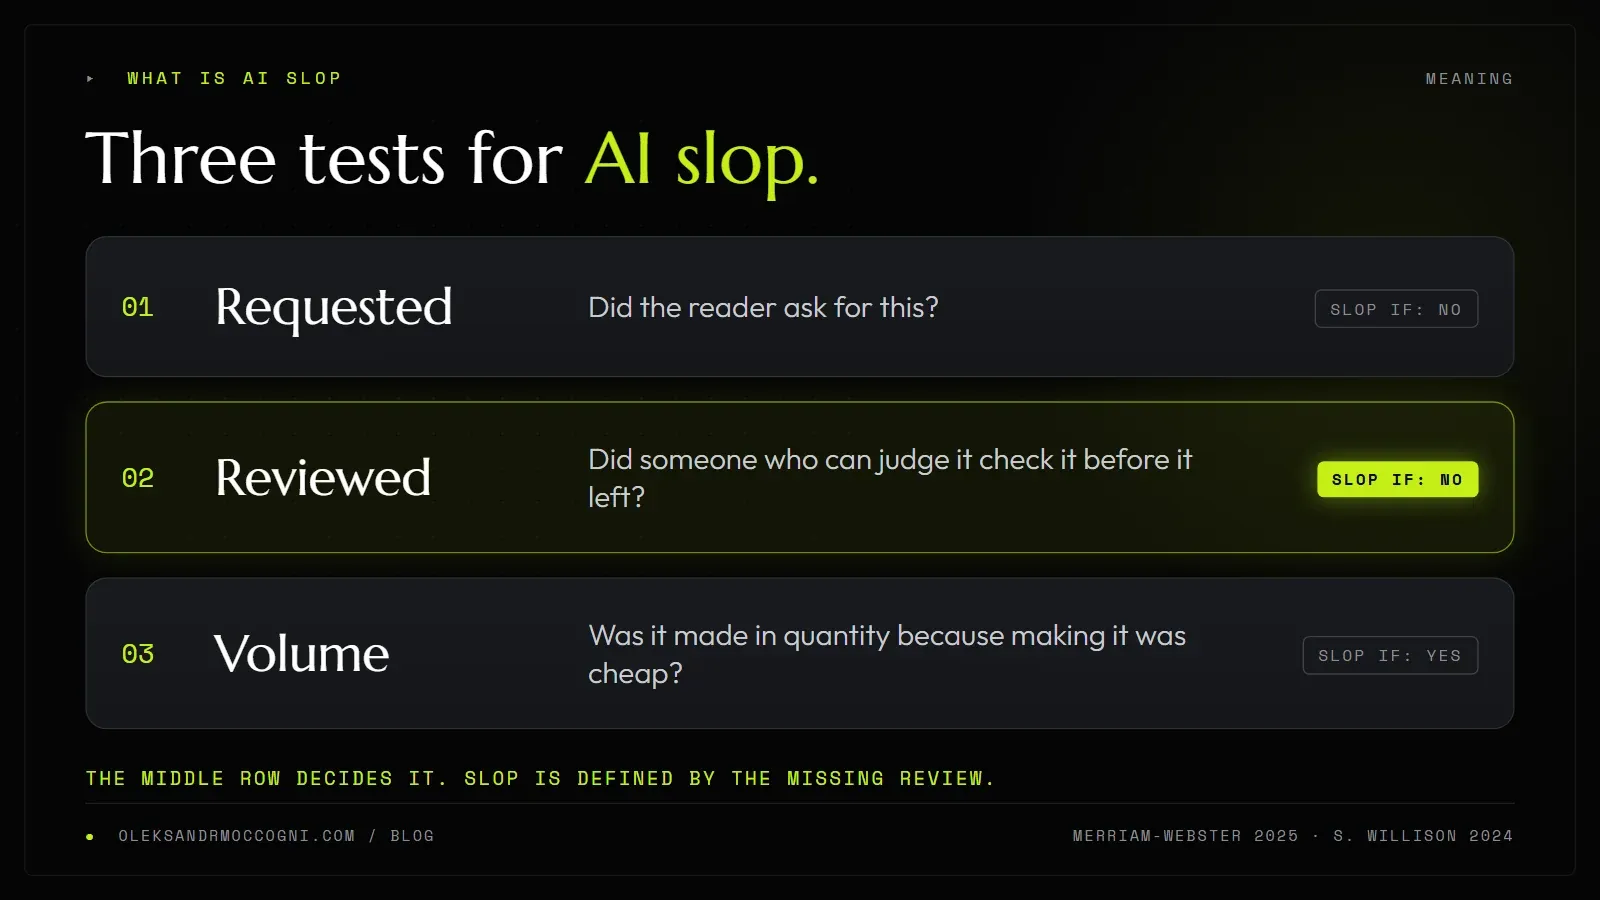
Zusammengenommen hat AI Slop drei Teile:
| Test | Frage | Slop, wenn |
|---|---|---|
| Verlangt | Hat der Leser danach gefragt? | Nein |
| Geprüft | Hat eine Person, die es beurteilen kann, es geprüft, bevor es rausging? | Nein |
| Menge | Wurde es in Menge hergestellt, weil das Herstellen billig war? | Ja |
Sehen Sie sich die mittlere Zeile an. Slop wird nicht dadurch definiert, wie der Text klingt oder wie das Bild aussieht. Er wird durch die fehlende Prüfung definiert. Derselbe Absatz ist Slop, wenn ihn niemand geprüft hat, und in Ordnung, wenn es jemand getan hat.
Deshalb ist die nützliche Frage meiner Meinung nach nicht «Wie verhindere ich, dass KI Slop produziert?». Sie lautet: «Wer prüft, wie viel kann diese Person prüfen, und was passiert, wenn das Ergebnis schneller eintrifft, als sie prüfen kann?» Meine Antwort für die Arbeit mit Agenten steht in KI-Marketing-Agenten.
Der KI-Engpass hat sich vom Erstellen zum Beurteilen verschoben
Vor der generativen KI brauchte es Zeit, ein Dokument, einen Bericht oder ein Stück Code zu erstellen. Diese Zeit war eine natürliche Bremse. Ein Team konnte einem Prüfer nicht mehr übergeben, als es schreiben konnte, und so wuchsen Prüfkapazität und Erstellungskapazität ungefähr gemeinsam.
Heute skaliert das Erstellen mit der Rechenleistung. Die Prüfung skaliert mit menschlicher Aufmerksamkeit, und Aufmerksamkeit ist seriell: Eine Person liest eine Sache nach der anderen. Steigt die erste Zahl und bleibt die zweite stehen, rechnet die Warteschlange.
Ich verwende dafür den Ausdruck «Prüfengpass». Im Bild unten sehen Sie dasselbe Team mit demselben einen Prüfer, vor und nach dem Einsatz von KI. Die Zahlen im Bild sind eine Illustration, keine Daten.
Ein Datensatz, der es zeigt
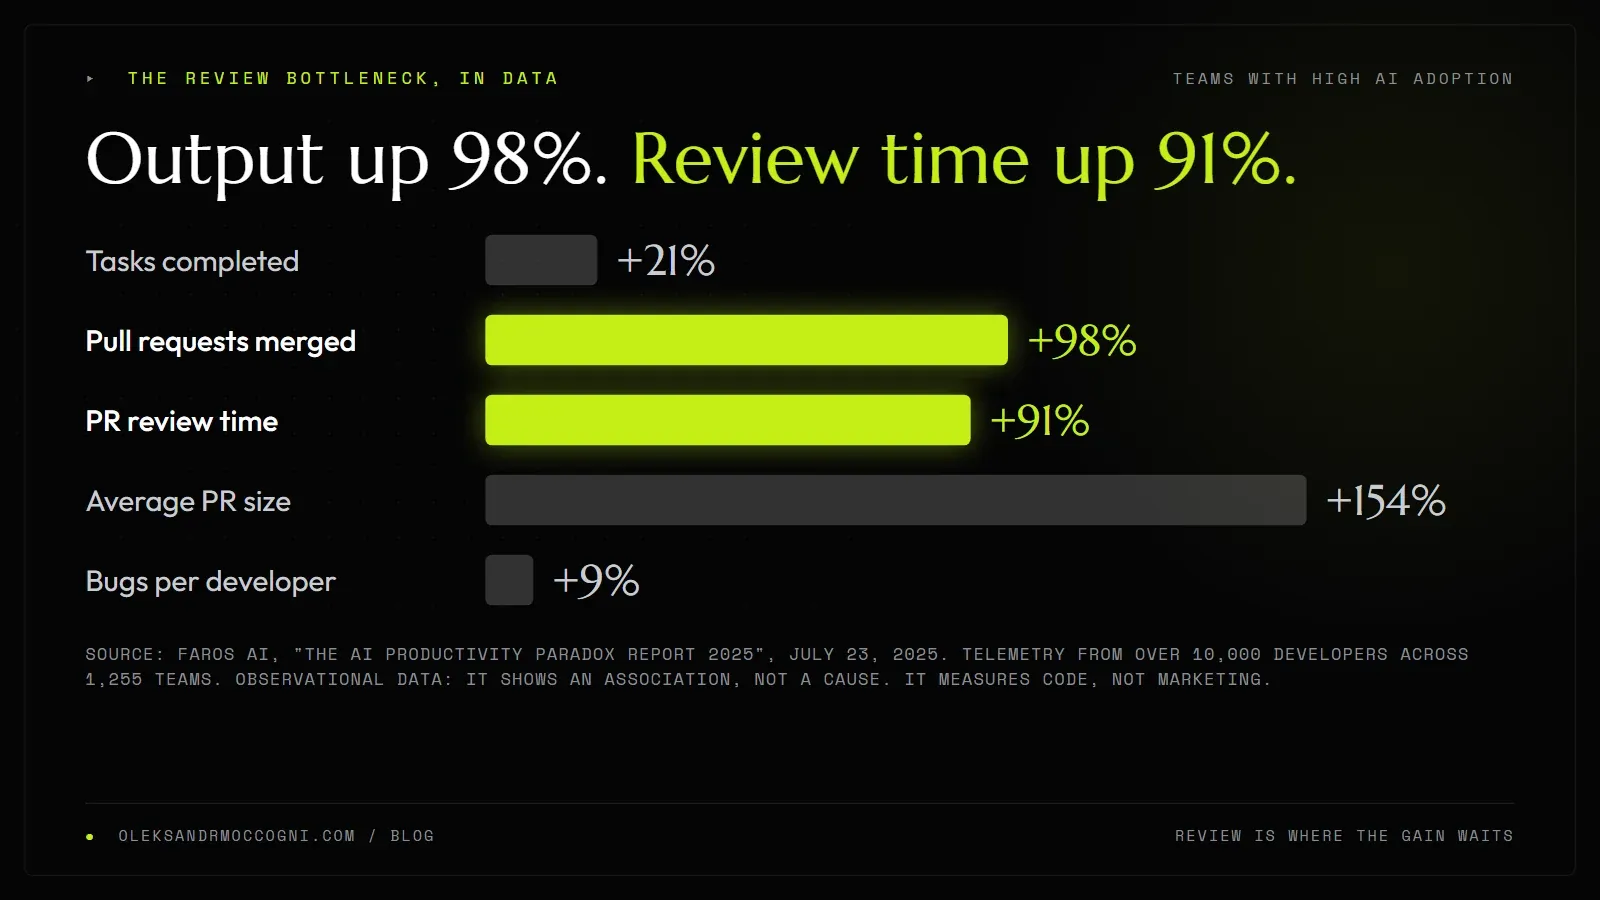
Die besten Zahlen, die ich kenne, stammen aus Softwareteams, in denen Pull Requests die Prüfung sichtbar machen. In einem Bericht vom 23. Juli 2025 stützte sich Faros AI, das Software für Engineering-Verantwortliche verkauft, auf Telemetriedaten von über 10’000 Entwicklern in 1’255 Teams.
Es fand, dass Entwickler in Teams mit hoher KI-Nutzung «21% mehr Aufgaben abschliessen und 98% mehr Pull Requests mergen, aber die Prüfzeit pro Pull Request um 91% steigt» (meine Übersetzung).
Derselbe Bericht bringt die KI-Nutzung mit einem Anstieg der durchschnittlichen Pull-Request-Grösse um 154% und einem Anstieg der Fehler pro Entwickler um 9% in Verbindung. Faros selbst nennt das Muster «einen kritischen Engpass: die menschliche Freigabe» (meine Übersetzung).
Lesen Sie das genau. Es sind beobachtende Telemetriedaten, kein kontrolliertes Experiment, sie zeigen also einen Zusammenhang und keine Ursache. Faros verkauft an Menschen, die dieses Problem beschäftigt, und hat deshalb ein Interesse am Thema. Und sie messen Code, nicht Marketing.
Trotzdem ist die Form genau die, die ich in meiner eigenen Arbeit sehe. Der Output steigt stark, und jede Einheit Output wird zudem grösser. Auch die Zeit, die ein Mensch pro Einheit braucht, steigt. Nichts in dieser Kette macht die Prüfung billiger.
Wenn Sie im Marketing arbeiten, ersetzen Sie «Pull Request» durch «Kampagnenbericht», «Artikel», «Anzeigenvariante» oder «Landingpage». Die Struktur ist identisch. Jemand muss es freigeben, bevor es live geht, und dieser Jemand sind Sie.
Warum die Prüfung nicht wie die Generierung skaliert
Ich habe vier Gründe, und sie stammen aus meiner eigenen Arbeit, nicht aus einer Studie:
- Urteilen ist seriell. Ich kann zehn Generierungen gleichzeitig starten. Zehn gleichzeitig beurteilen kann ich nicht.
- Flüssige Ausgabe versteckt ihre Fehler. Eine falsche Zahl in einer polierten Tabelle fällt schwerer auf als eine falsche Zahl in einer rohen Notiz. Je besser die Oberfläche, desto schwächer wird meine Prüfung, wenn ich sie nicht gezielt stärke.
- Das Prüfen braucht Kontext, den das Generieren nicht braucht. Das Modell kann einen Clip oder einen Bericht erzeugen, ohne zu wissen, wofür das Projekt da ist. Wer prüft, muss genau das wissen.
- Niemand spürt die Kosten einer übersprungenen Prüfung sofort. Der Output geht raus, die Warteschlange schrumpft, und der Fehler taucht später auf, an anderer Stelle, unter anderem Namen.
Meine eigene Schätzung, keine Messung: Wenn ich etwas genau so baue, wie ich es will, Funktion für Funktion, brauche ich etwa viermal so viel Zeit fürs Debugging wie ein üblicher, rein menschlicher Ablauf.
Insgesamt spare ich trotzdem Zeit, aber es dauert länger und ist schwieriger, als der KI einfach zu sagen, sie solle es «einfach machen». Eines meiner Projekte wuchs innerhalb von Stunden, nicht Tagen, von einem kleinen Umfang auf Enterprise-Grösse. Code zu schreiben war nicht mehr der langsame Teil. Das Prüfen wurde nicht schneller.
Dreimal hat meine eigene Pipeline mich getäuscht
Ich arbeite jeden Tag mit KI-Agenten und zeige Ihnen lieber, wo sie versagt haben, als ein Versprechen zu wiederholen. Diese drei Fälle sind echt, und jeder hat dieselbe Form: Das System, das die Arbeit gemacht hat, meldete auch, dass die Arbeit in Ordnung sei.
1. Der dritte Unterarm (11. Oktober)
Ich erzeugte einen Kurzfilm in Segmenten. Das erste Segment kam zurück, und der Bericht des Assistenten nannte es einen riesigen Sprung und sagte, die Hände seien in Ordnung. Ich hatte die Arme nicht gezählt. Als ich hinschaute, hing ein riesiger dritter Unterarm 4.5 Sekunden lang im Vordergrund.
Der Bericht war keine Lüge im Sinne einer Absicht. Er war eine Zusammenfassung, geschrieben vom selben Prozess, der den Clip erzeugt hatte, und dieser Prozess hatte keinen Schritt, in dem er einen Mangel finden musste.
Die Regel, die ich danach aufschrieb: Arme und Finger auf vergrösserten Einzelbildern zählen, und den ersten Bericht mit den Mängeln beginnen lassen, nicht mit dem Lob. Kann der erste Bericht keinen Mangel nennen, behandle ich ihn als unfertig.
2. «Successfully stopped.» (17. Oktober)
Ich stoppte eine Shell-Aufgabe, in der Tests liefen. Das Werkzeug antwortete «Successfully stopped.» Die Shell und der Python-Prozess liefen noch. Als ich einen von beiden beendete, startete die Shell den nächsten Schritt.
Eine Statusmeldung ist eine Behauptung. Sie ist keine Prüfung. Ein Stopp, den Sie nicht verifiziert haben, ist ein Stopp, auf den Sie hoffen.
Die Regel: Nach dem Stoppen von irgendetwas die laufenden Prozesse auflisten und wiederholen, bis die Liste leer ist. Erst dann weitermachen.
3. Ein Test, der nicht scheitern konnte (23. September bis 11. Oktober)
Ein End-to-End-Test für das Tracking eines Lead-Formulars, datiert auf den 23. September, blockierte die API-Aufrufe, auf die der Tag hört. Der Listener feuerte nie, und der Test bestand jedes Mal.
Am 11. Oktober fand ich zwei Lead-Events im Abstand von 50 Millisekunden, wo es eines hätte sein sollen. Der Test, dem ich wochenlang vertraut hatte, hätte das nie sehen können. Hätte ich diese Daten mit Anzeigen-Conversions verknüpft, ohne es zu bemerken, wären die Conversions doppelt gezählt worden.
Die Regel: Ein Tracking-Test muss die API mit einer gefälschten Erfolgsantwort antworten lassen, damit der Listener etwas hat, worauf er reagieren kann. Ein Test, der nicht scheitern kann, ist kein Test, sondern Dekoration.
Zuerst kommt die maschinelle Prüfung
Code oder Text sorgfältig zu lesen ist die letzte Verteidigungslinie, nicht die erste. Wenn eine Maschine etwas prüfen kann, soll sie es tun, und der Mensch bleibt für das, was eine Maschine nicht beurteilen kann. Wie sich die in ein offenes Modell eingebauten Ablehnungen nachträglich entfernen lassen, erkläre ich in Abliteration erklärt.
Hier ist das Experiment, das meine Sicht verändert hat. Ich habe ein Werkzeug, mit dem ich KI-Agenten ausführe und überwache, samt einer Test-Suite, die ich für gut hielt. Um das herauszufinden, erfand ich 56 Fehler, pflanzte sie in eine Kopie des Codes und liess die Tests laufen.
- 50 Fehler wurden sofort gefunden.
- 6 Fehler überlebten. Die Test-Suite blieb grün, obwohl der Code falsch war.
- Ich schrieb neue Assertions für die 6. Das Endergebnis lautete 56 von 56.
Sechs Überlebende von 56 sind etwa 11%. Eine Suite, die ich solide genannt hätte, liess etwa jeden neunten Fehler durch. Es geht nicht darum, dass das Werkzeug schlecht gebaut wäre. Es geht darum, dass ich es durch Lesen der Tests nie erfahren hätte, und ein grünes Häkchen ist nur etwas wert, wenn Sie es schon einmal scheitern gesehen haben.
Über die menschliche Seite habe ich in meinem Beitrag zu Human in the Loop bei KI geschrieben. Die Kurzfassung: Eine Schleife, die nicht ablehnen kann, ist Theater. Zuerst eine maschinelle Prüfung, dann eine Person, dann ein Protokoll.
So erkennen Sie AI Slop, bevor Sie ihn veröffentlichen
Die meisten betrachten Slop zuerst mit den Augen, und das scheitert, weil Slop flüssig ist. Stattdessen prüfe ich diese Merkmale, jeweils mit einem Test, den Sie in einer Minute durchführen können:
- Er behauptet Dinge, die er nicht belegen kann. Test: Jede Zahl, jeder Name und jedes Datum lässt sich zu einer Seite zurückverfolgen, die Sie selbst geöffnet haben, nicht zum Entwurf.
- Er ist generisch. Test: Könnte der Absatz unverändert auf der Website irgendeines anderen Unternehmens stehen? Wenn ja, sagt er nichts über Ihres.
- Er enthält Details, die nicht stimmen können. Test: Zählen Sie Gliedmassen und Finger in Bildern, lesen Sie den Text auf Schildern, rechnen Sie die Summen nach, prüfen Sie die Einheiten.
- Er füllt auf. Test: Streichen Sie ein Drittel. Geht nichts verloren, war das Drittel Füllmaterial.
- Niemand kann sagen, wer ihn freigegeben hat. Test: ein Name und ein Datum neben der Datei.
Nichts davon braucht ein Spezialwerkzeug. Es braucht die Zeit, die die eingesparten Produktionsstunden eigentlich kaufen sollten.
Manche Plattformen prüfen inzwischen selbst: LinkedIn meldet, dass Inhalte, die es als AI Slop einstuft, Stand August 2026 40 % weniger Aufrufe bekommen. Was hinter dieser Zahl steht, erkläre ich in meinem Leitfaden dazu, wie der LinkedIn Algorithmus Beiträge sortiert.
Das Prüfbudget: So arbeite ich heute
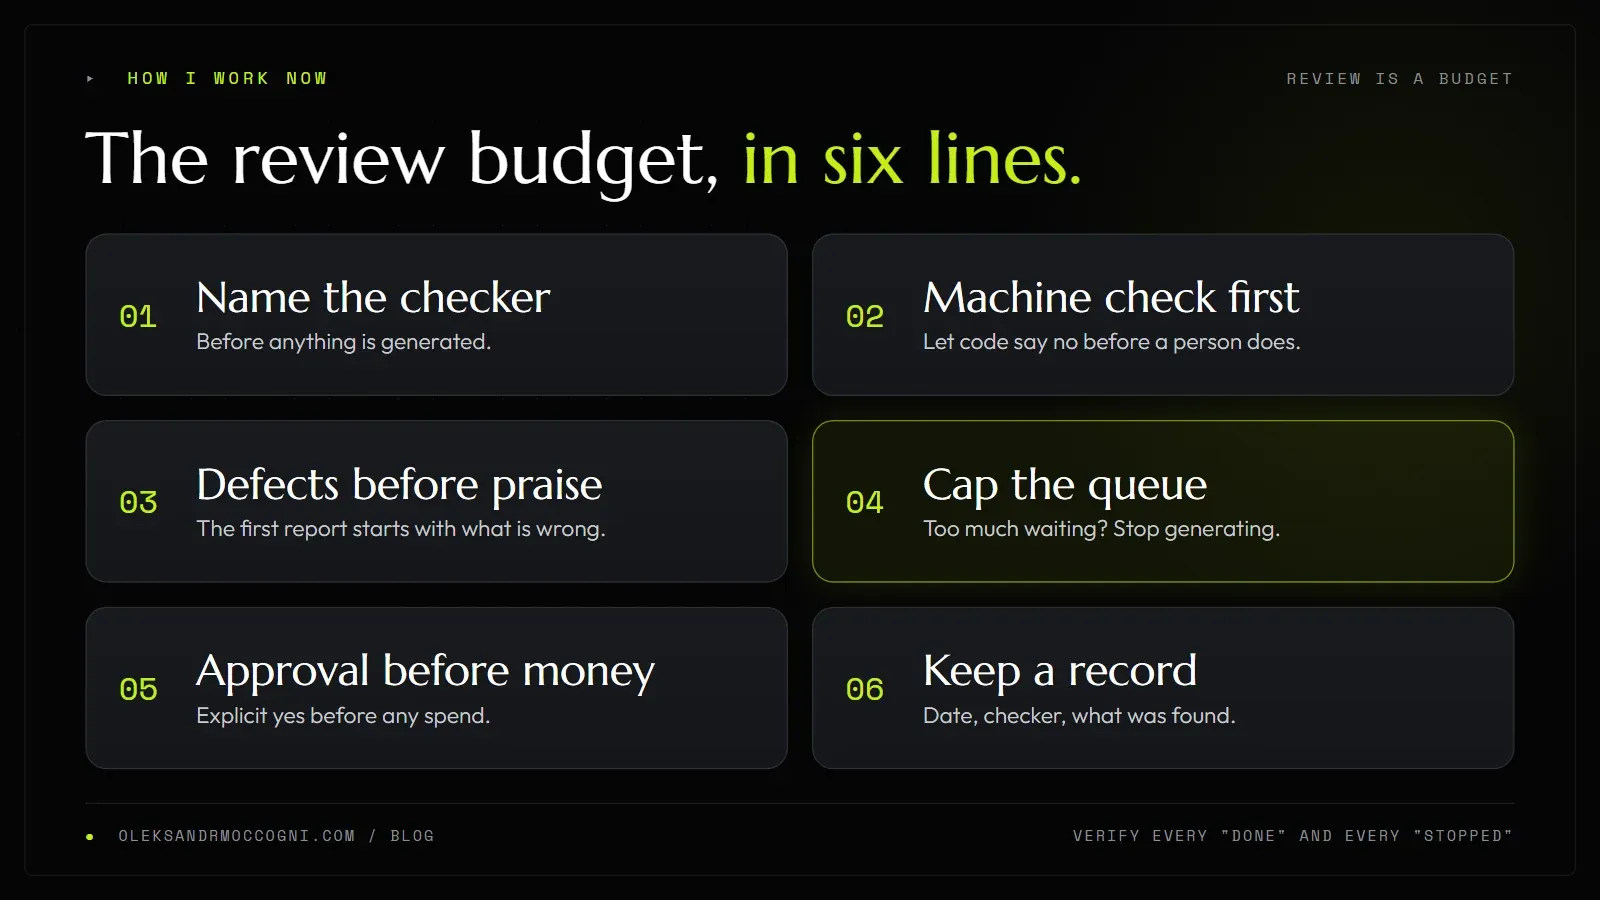
Die Lösung heisst nicht «gründlicher prüfen». Gründlicher prüfen skaliert ebenfalls nicht. Die Lösung ist, die Prüfung als Budget zu behandeln, mit derselben Disziplin wie bei Geld.
1. Für jede Art von Output den Prüfer benennen
Schreiben Sie für jeden Output-Typ auf, wer oder was ihn prüft, bevor Sie etwas erzeugen. Ein Output ohne benannten Prüfer ist nicht bereit, erzeugt zu werden.
2. Die günstigste maschinelle Prüfung zuerst
| Output | Das kann eine Maschine prüfen | Das muss eine Person beurteilen |
|---|---|---|
| Code | Tests, Typen, ein Build | Design und Passung zum Produkt |
| Tracking | ein Test mit gefälschter Erfolgsantwort, eine Zählung der Events | ob die Daten eine Geschäftsfrage beantworten |
| Video oder Bild | Einzelbild-Extraktion, eine Zählung von Gliedmassen und Text | ob es zur Marke passt und zeigenswert ist |
| Bericht oder Artikel | Zahlen gegen die Quelle, Links, Daten | ob das Argument stimmt |
| Anzeigenänderung | Kontolimits, ein Diff | ob das Geld ausgegeben wird |
3. Den Erzeuger zuerst die Mängel melden lassen
Bitten Sie den erzeugenden Prozess, seinen Bericht mit dem zu beginnen, was falsch ist, was er nicht verifizieren konnte und was er angenommen hat. Einem Bericht, der mit Lob beginnt, traue ich am wenigsten.
4. Die Warteschlange begrenzen
Übersteigt die Zahl der Elemente, die auf Prüfung warten, eine im Voraus festgelegte Grenze, hören Sie auf zu generieren, bis sie wieder sinkt. Das ist dieselbe Idee wie ein Work-in-Progress-Limit auf einem Kanban-Board, angewendet auf KI-Output. Ein wachsender Haufen ungeprüften Outputs ist keine Produktivität. Er ist eine Verbindlichkeit, die noch nicht in Rechnung gestellt wurde.
5. Die ausdrückliche Freigabe einer Person vor das Geld stellen
Das sind Regeln, mit denen ich meine Agenten bereits betreibe. Eine Werbekampagne wird nur mit meiner ausdrücklichen Freigabe geändert oder gibt nur damit Geld aus, selbst für eine Pause. Lesen und Berichten sind frei.
Bei bezahlten Generierungen erhalte ich zuerst einen Preflight mit dem Modell, der Anzahl der Elemente und den Kosten. Dann beurteile ich ein Ergebnis, bevor ein Batch läuft. Wird dieses erste Ergebnis abgelehnt, stoppt jeder folgende Schritt.
6. Ein Protokoll führen
Eine Zeile pro Durchlauf: Datum, wer geprüft hat, was gefunden wurde, was sich geändert hat. In einem Monat zeigt das Protokoll, welche manuelle Prüfung Sie in Code verschieben sollten. Den fünfteiligen Ablauf beschreibe ich ausführlicher im Artikel über Human in the Loop bei KI.
Was das für Marketingteams bedeutet
Kauft ein Team die Output-Seite der KI (mehr Entwürfe, mehr Varianten, mehr Berichte) und budgetiert die Prüfseite nicht, ist das Ergebnis vorhersehbar. Der Prüfer, meist eine Führungskraft, wird zum Engpass, und seine Freigabe wird zum Gummistempel, weil die Warteschlange nie endet.
Eine einfache Art, die Warteschlange zu sehen
Nehmen Sie die Zahl der Elemente, die Ihre Werkzeuge pro Woche erzeugen können, und ziehen Sie die Zahl ab, die eine Person pro Woche ordentlich prüfen kann. Ist das Ergebnis positiv, wächst die Warteschlange jede Woche um diese Zahl.
Hier ein Beispiel mit erfundenen Zahlen, keine Daten. Ihre Werkzeuge erzeugen 120 Elemente pro Woche, und eine Person kann 40 ordentlich prüfen. Die Warteschlange wächst um 80 Elemente pro Woche, und nach einem Monat warten 320 Elemente.
Niemand prüft 320 Elemente. Man überfliegt, stempelt oder ignoriert sie, und so verlässt Slop ein Unternehmen, das nie vorhatte, welchen zu veröffentlichen.
Drei Messgrössen
Kommt Ihnen das bekannt vor, empfehle ich drei Messungen, bevor Sie irgendetwas anderes kaufen:
- Grösse der Warteschlange: Wie viele KI-erzeugte Elemente warten gerade auf eine menschliche Entscheidung?
- Prüfzeit pro Element: Wie lange dauert eine echte Prüfung, nicht ein Überfliegen?
- Durchrutschquote: Wie viele der freigegebenen Elemente brauchten nach der Veröffentlichung eine Korrektur?
Wächst die Warteschlange, während die Durchrutschquote gleich bleibt, finden Sie keine Probleme, Sie geben blind frei. Steigt die Durchrutschquote, ist der Slop schon draussen.
Die Prüfung ist nur ein Grund, warum KI-Projekte ins Stocken geraten. Mein Beitrag darüber, warum KI-Marketing-Projekte scheitern, behandelt die breitere Palette von Ursachen, und KI im Marketing beschreibt, was mich zweieinhalb Jahre tägliche Nutzung darüber gelehrt haben, wo die KI noch Fehler macht.
Nichts davon spricht gegen den Einsatz von KI. Ich nutze sie für den Grossteil meiner Arbeit. Es spricht dafür, die eingesparte Produktionszeit in den Teil zu stecken, der sich nicht automatisieren lässt: zu entscheiden, was gut genug zum Versenden ist, und bereit zu sein, weniger zu versenden, wenn die Prüfung nicht mithalten kann.
Häufig gestellte Fragen
Was ist AI Slop?
AI Slop (auch KI-Slop) sind minderwertige digitale Inhalte, die mit KI und meist in grosser Menge hergestellt und ohne echte Prüfung weitergegeben werden. Merriam-Webster definiert ihn als «digitale Inhalte von geringer Qualität, die üblicherweise in grosser Menge mithilfe künstlicher Intelligenz hergestellt werden» (meine Übersetzung). Der entscheidende Test ist, ob jemand ihn geprüft hat, bevor er einen Leser erreichte, der nicht danach gefragt hat.
Was bedeutet das Wort «Slop»?
Die Bedeutung hat zwei Ebenen. Die Wörterbuchebene ist minderwertiger, massenhaft hergestellter KI-Inhalt. Die Arbeitsebene, aus Simon Willisons Definition von 2024, ist ungeprüfter KI-Inhalt, der Menschen aufgedrängt wird, die ihn nicht verlangt haben. Nicht jeder KI-generierte Inhalt ist Slop.
Wie vermeidet man AI Slop?
Prüfen Sie vor der Veröffentlichung, und begrenzen Sie, wie viel Sie erzeugen, auf das, was Sie prüfen können. Benennen Sie für jeden Output-Typ einen Prüfer, lassen Sie zuerst maschinelle Prüfungen laufen, bitten Sie das erzeugende System, Mängel vor dem Lob zu melden, und begrenzen Sie die Warteschlange ungeprüfter Elemente.
Warum heisst es AI Slop?
«Slop» bedeutete ursprünglich weichen Schlamm und später etwas von geringem Wert, laut dem Bericht der Associated Press über die Wahl von Merriam-Webster. Auf KI-Ergebnisse wurde das Wort wegen der Menge angewandt: ein stetiger, billiger Strom von Inhalten, nach denen niemand gefragt hat.
Ist jeder KI-generierte Inhalt Slop?
Nein. Ein Inhalt, nach dem eine Person gefragt hat, den sie geprüft hat und zu dem sie steht, ist kein Slop, egal mit welchem Werkzeug er entstanden ist. Willison macht denselben Punkt in seinem Beitrag von 2024.
Was ist der Prüfengpass?
Es ist mein Begriff für die Stelle in einem Arbeitsablauf, an der fertig aussehende Ergebnisse auf eine Person warten, die sie beurteilen kann. Macht KI das Erstellen billig, wird diese Stelle zur Grenze dafür, wie viel gute Arbeit ausgeliefert wird.
Kann KI ihre eigenen Ergebnisse prüfen?
Sie kann einige Fehler finden, neigt aber dazu, ihre eigene Arbeit wohlwollend zu bewerten, wie mein dritter Unterarm gezeigt hat. Nutzen Sie einen getrennten Prüfer, ein Bewertungsraster und maschinelle Prüfungen, die scheitern können.
Mein Urteil
AI Slop ist ein Symptom. Die Ursache ist ein Ungleichgewicht: Die Kosten des Herstellens sind fast auf null gefallen, die Kosten des Beurteilens haben sich nicht bewegt. Das lösen Sie nicht mit besseren Prompts. Sie lösen es, indem Sie der Prüfung ein Budget, einen benannten Verantwortlichen und eine maschinelle Prüfung geben, die Nein sagen kann.
Die Karte:
- Nennen Sie den Prüfer, bevor Sie etwas erzeugen.
- Lassen Sie zuerst die maschinelle Prüfung laufen.
- Verlangen Sie die Mängel vor dem Lob.
- Begrenzen Sie die Warteschlange ungeprüfter Ergebnisse.
- Stellen Sie die ausdrückliche Freigabe vor das Geld.
- Verifizieren Sie jedes «erledigt» und jedes «gestoppt».
- Führen Sie ein Protokoll, und verschieben Sie die manuellen Prüfungen mit der Zeit in Code.
Die Faros-Zahlen entsprechen dem Stand vom 23. Juli 2025 und die Definition des Wörterbuchs dem Bericht vom 15. Dezember 2025. Die Fälle und Zählungen aus meiner eigenen Arbeit sind im Text datiert.
Möchten Sie eine zweite Meinung dazu, wie Ihr Team KI-Output prüft, mit einer auf Ihre Abläufe abgestimmten Checkliste? Sprechen Sie mit mir über Ihren Prüfprozess.


