Узкое место сместилось: AI slop и человеческая проверка
AI slop дёшево делать и дорого проверять. Почему узкое место сместилось с создания на проверку: реальные цифры, мои собственные ошибки и бюджет проверки.
AI slop не сводится к проблеме письма. Это то, что получается, когда выпуск результата становится почти бесплатным, а его проверка нет.
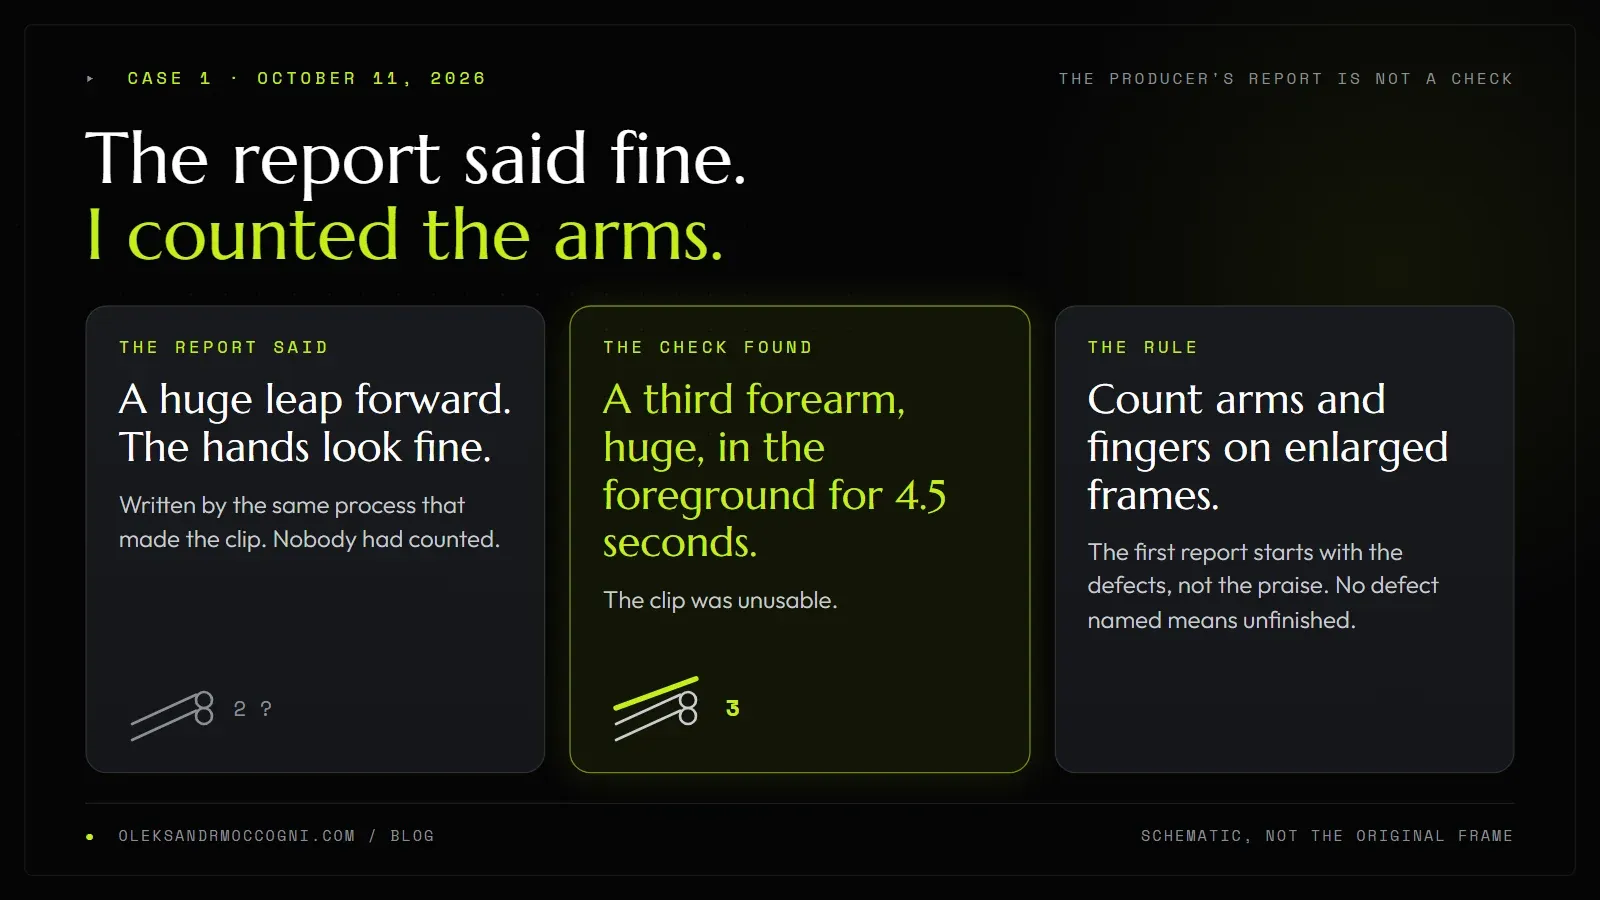
11 октября 2026 года AI-ассистент сказал мне, что первый сегмент сгенерированного короткометражного фильма стал огромным шагом вперёд и что руки выглядят нормально. Он не пересчитывал руки. Я пересчитал, и огромное третье предплечье висело на переднем плане 4,5 секунды. Ролик было невозможно использовать.
Модель в этой истории не была злодеем. Проблема в шаге после генерации: кто-то должен посмотреть, сосчитать и сказать нет. Этот шаг не ускорился, когда ускорилась генерация.
Эта статья об этом разрыве. Я называю его узким местом проверки: точка рабочего процесса, где результат, выглядящий готовым, ждёт человека, который может его оценить. Я определю AI slop, покажу единственный набор цифр про узкое место, которому я доверяю, разберу три случая, когда мой собственный конвейер меня обманул, и дам бюджет проверки, которым пользуюсь сейчас.
Главное коротко
- AI slop определяется отсутствием проверки, а не моделью. Самое известное определение описывает его как непроверенный материал, подсунутый тому, кто о нём не просил.
- Узкое место сместилось с создания на оценку. В одном большом наборе данных команды с высоким внедрением AI вливали на 98% больше pull request, а время их проверки выросло на 91%.
- Отчёт самого исполнителя не является проверкой. В трёх моих ошибках ниже система, сделавшая работу, сама же сообщала, что с работой всё в порядке.
- Сначала проверка машиной. Я придумал 56 дефектов в копии своего кода: 50 нашлись сразу, 6 уцелели, а теперь находятся 56 из 56.
- Закладывайте бюджет на проверку, прежде чем наращивать выпуск. Если очередь непроверенного растёт, остановите генерацию.
- Никогда не принимайте сообщение о статусе за проверку. Перечислите, что работает, посчитайте, что в кадре.
Что такое AI slop? Смысл слова
Слово «slop» разошлось настолько быстро, что Merriam-Webster назвал его словом 2025 года. Определение словаря, как сообщило агентство Associated Press 15 декабря 2025 года, звучит так: «цифровой контент низкого качества, который обычно производится в большом количестве с помощью искусственного интеллекта» (перевод мой). Президент словаря Грег Барлоу перечислил примеры: абсурдные видео, странные рекламные изображения, фейковые новости, которые выглядят настоящими, дешёвые цифровые книги, написанные AI.
Это значение из словаря. Более острое появилось раньше. 8 мая 2024 года разработчик Simon Willison в коротком посте объяснил, что значит slop, и сказал, что он «всё больше считает невежливым делиться с другими людьми непроверенным, искусственно созданным контентом» (перевод мой), а slop назвал «идеальным названием для этого антипаттерна» (перевод мой).
Он добавил важное ограничение: «Не весь контент, созданный AI, это slop. Но если его создали бездумно и навязали тому, кто о нём не просил, лучшего слова, чем slop, не найти.» (перевод мой)
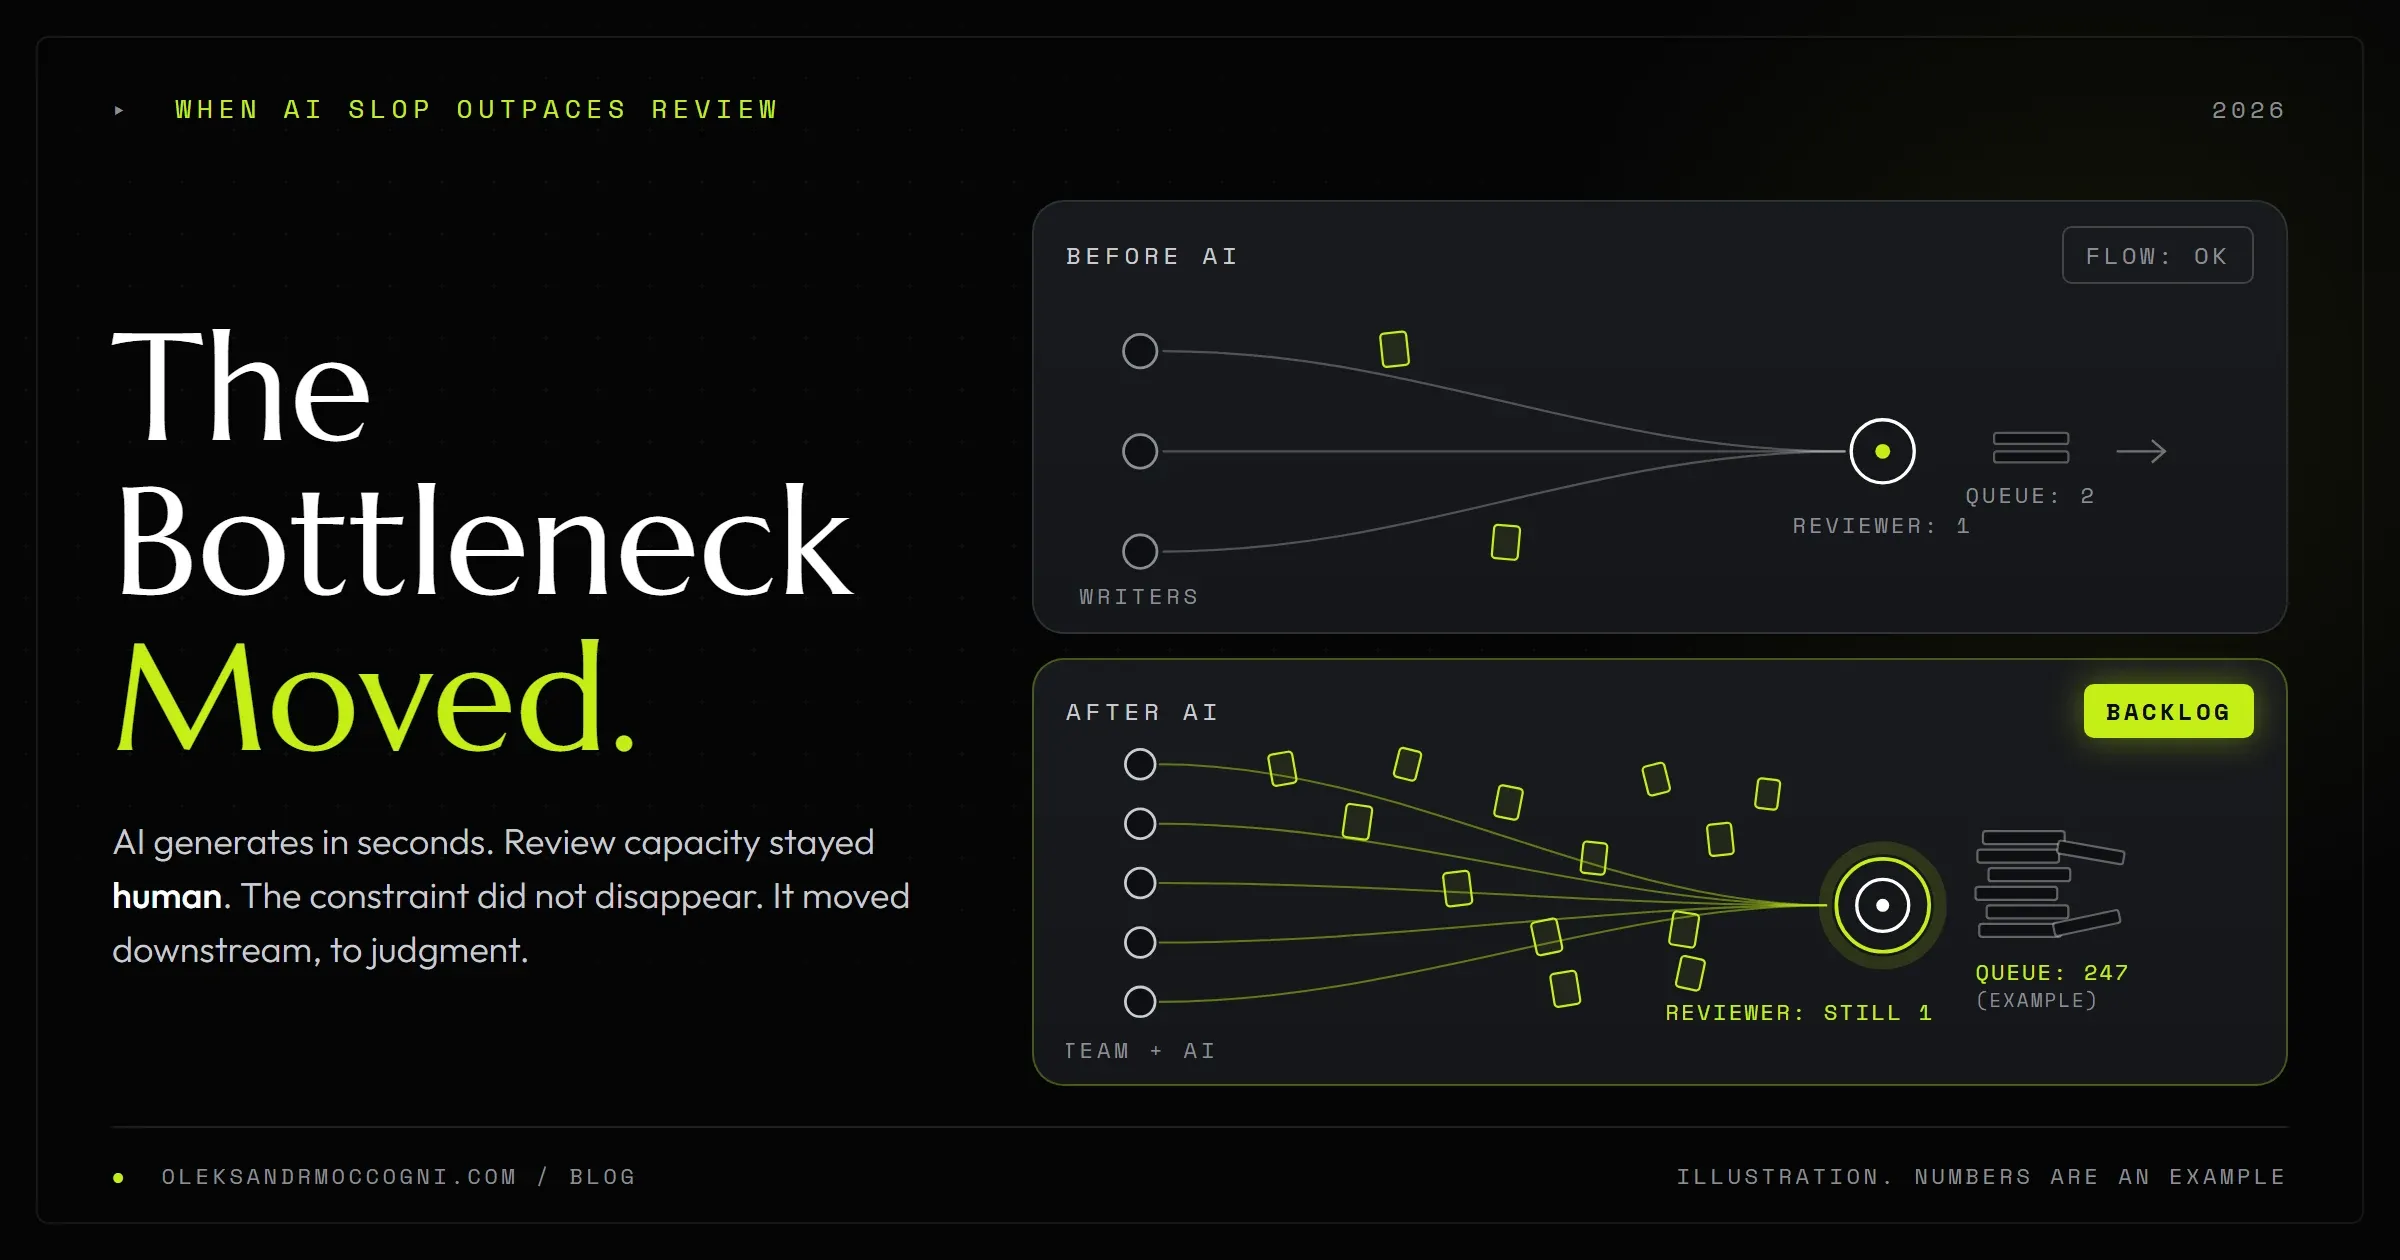
Если соединить оба определения, у AI slop три составляющие:
| Тест | Вопрос | Это slop, если |
|---|---|---|
| Запрошено | Просил ли читатель об этом? | Нет |
| Проверено | Проверил ли это перед выпуском человек, способный оценить результат? | Нет |
| Объём | Сделано ли это в большом количестве, потому что делать было дёшево? | Да |
Посмотрите на среднюю строку. Slop определяется не тем, как звучит текст или как выглядит изображение. Он определяется отсутствием проверки. Один и тот же абзац становится slop, если его никто не проверил, и остаётся нормальным, если проверил.
Поэтому полезный вопрос, как мне кажется, не «как не дать AI производить slop?». Он такой: «кто проверяет, сколько он может проверить и что происходит, когда результат поступает быстрее, чем он успевает?» Мой ответ для работы с агентами разобран в статье про AI-агентов для маркетинга.
Узкое место AI сместилось с создания на оценку
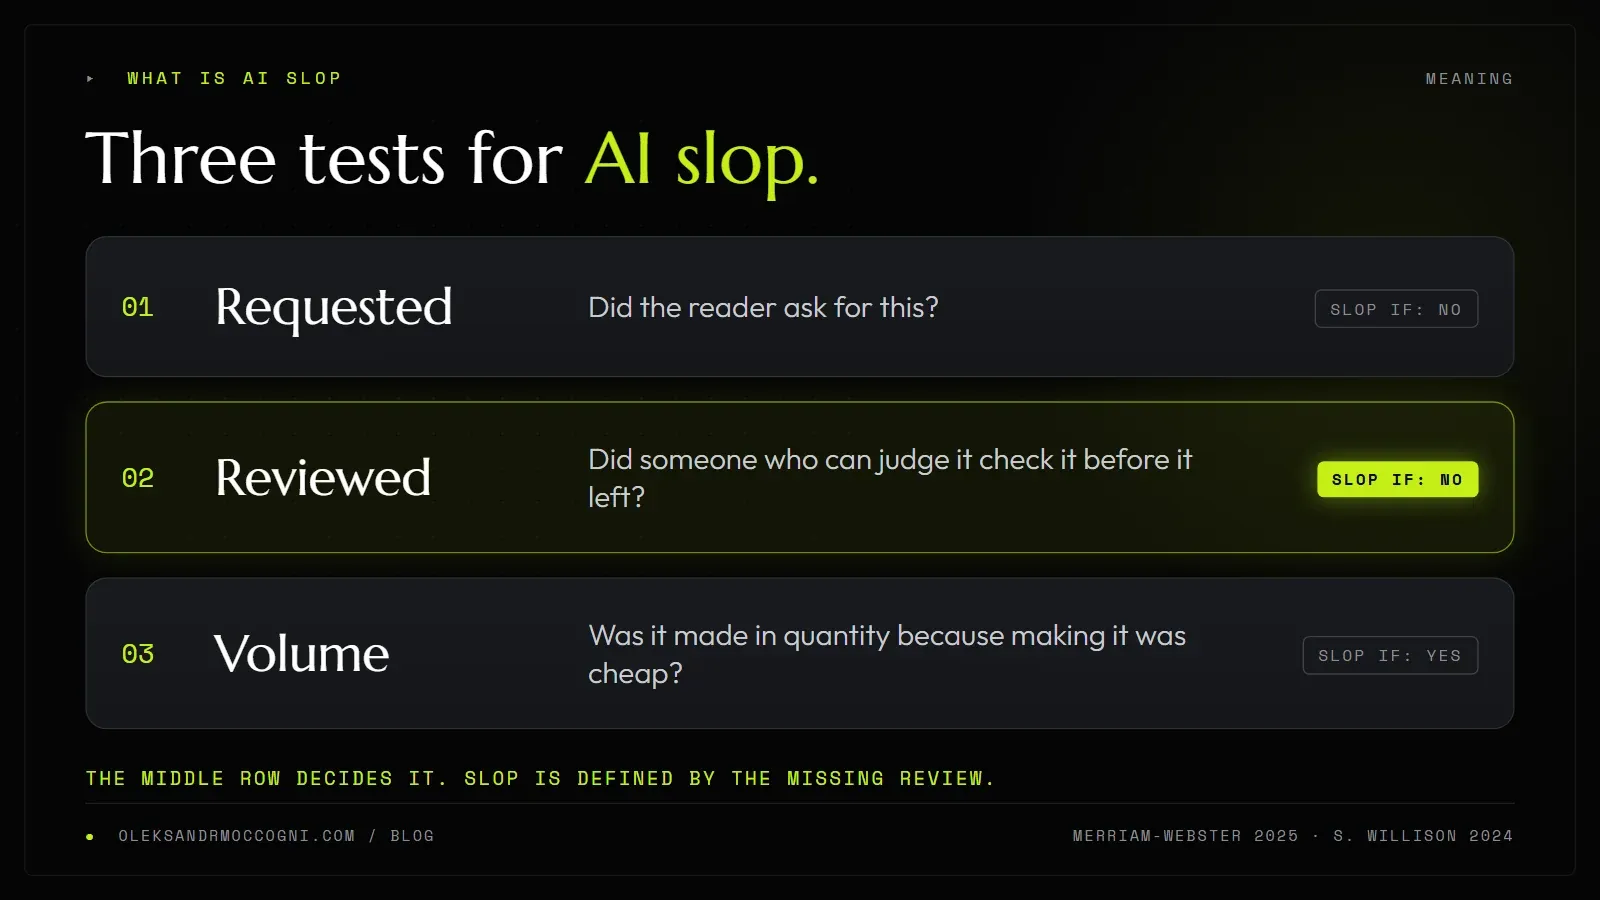
До генеративного AI на создание документа, отчёта или фрагмента кода уходило время. Это время работало как естественный ограничитель. Команда не могла передать проверяющему больше, чем успевала написать, поэтому возможности проверки и создания росли примерно вместе.
Теперь создание масштабируется вместе с вычислительной мощностью. Проверка масштабируется вместе с вниманием человека, а внимание последовательно: один человек читает одну вещь за раз. Когда первое число растёт, а второе стоит на месте, арифметику делает очередь.
Для этого я использую выражение «узкое место проверки». Его видно на картинке ниже: одна и та же команда и один и тот же единственный проверяющий до и после добавления AI. Числа на картинке служат иллюстрацией, это не данные.
Один набор данных, который это показывает
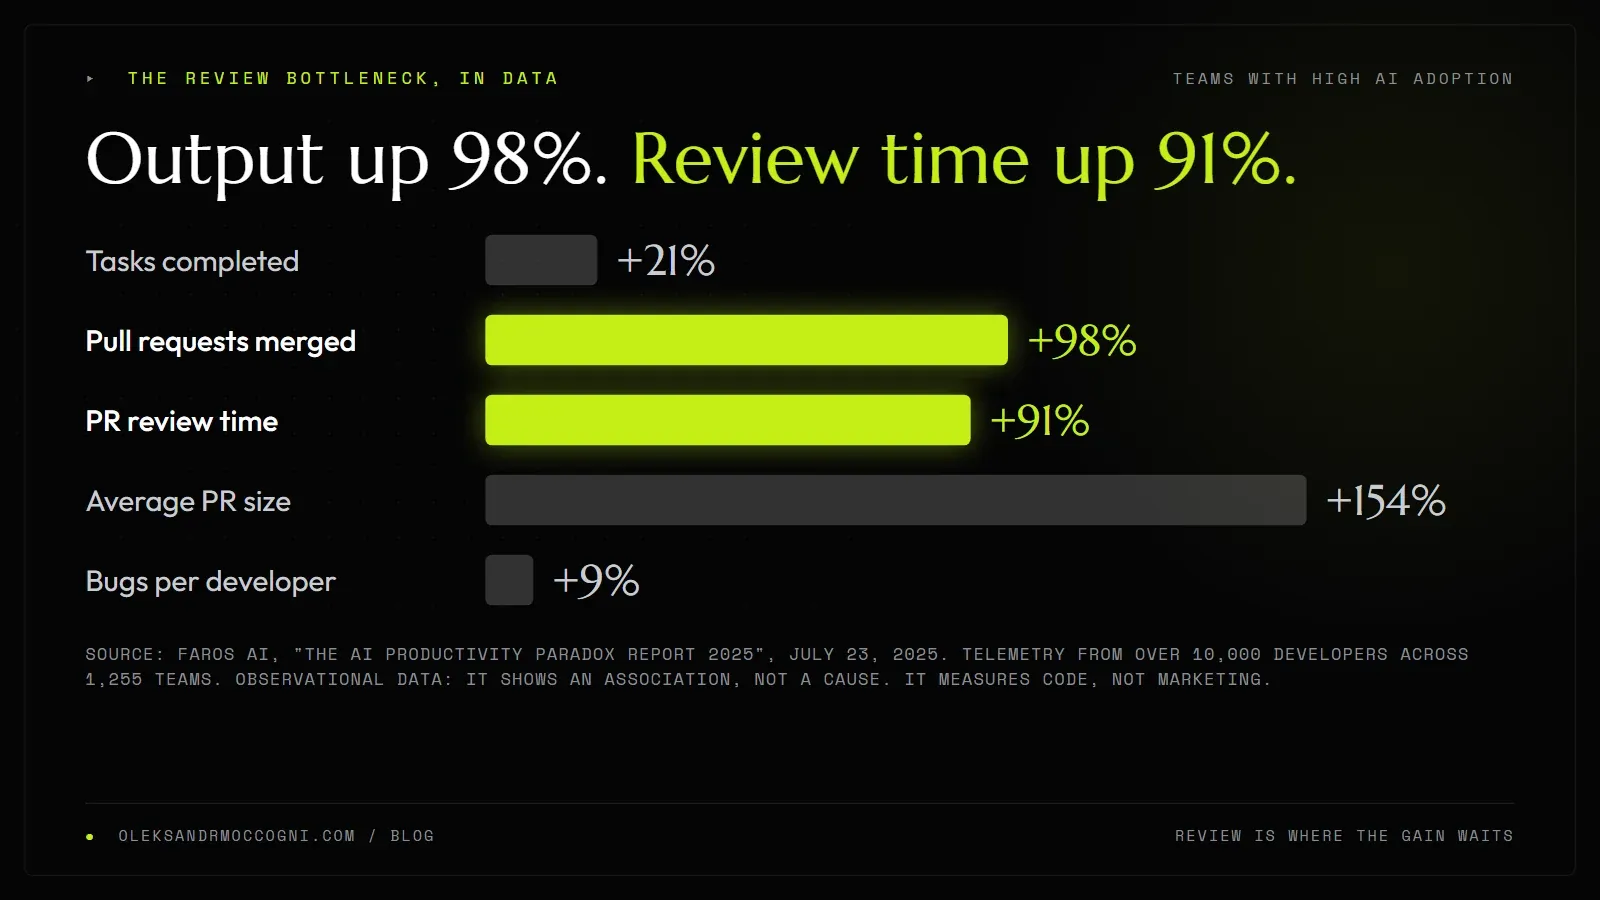
Лучшие цифры, какие я знаю, получены в программных командах, где pull request делают проверку видимой. В отчёте, опубликованном 23 июля 2025 года, Faros AI, которая продаёт программное обеспечение руководителям инженерных команд, использовала телеметрию более 10 000 разработчиков из 1 255 команд. Она обнаружила, что разработчики в командах с высоким внедрением AI «выполняют на 21% больше задач и вливают на 98% больше pull request, но время проверки PR растёт на 91%» (перевод мой).
Тот же отчёт связывает внедрение AI с ростом среднего размера pull request на 154% и с ростом числа багов на разработчика на 9%. Сама Faros называет эту картину «критическим узким местом: одобрением человеком» (перевод мой).
Читайте это внимательно. Это наблюдательная телеметрия, а не контролируемый эксперимент, поэтому она показывает связь, а не причину. Faros продаёт тем, кого эта проблема волнует, так что у неё есть интерес к теме. И она измеряет код, а не маркетинг.
И всё же форма та же, что я вижу в собственной работе. Объём резко растёт. Каждая единица результата к тому же становится больше. Время, которое нужно человеку на одну единицу, тоже растёт. Ничто в этой цепочке не делает проверку дешевле.
Если вы работаете в маркетинге, замените «pull request» на «отчёт по кампании», «статью», «вариант объявления» или «посадочную страницу». Структура та же. Кто-то должен одобрить материал до выхода, и этот кто-то вы.
Почему проверка не масштабируется как генерация
У меня четыре причины, и они взяты из моей работы, а не из исследования:
- Оценка последовательна. Я могу запустить десять генераций сразу. Оценить десять сразу я не могу.
- Гладкий результат прячет свои ошибки. Неверное число в аккуратной таблице заметить труднее, чем неверное число в черновой заметке. Чем лучше поверхность, тем слабее моя проверка, если я намеренно её не усилю.
- Для проверки нужен контекст, который не нужен для генерации. Модель может выдать ролик или отчёт, не зная, для чего нужен проект. Человек, который проверяет, должен знать именно это.
- Цену пропущенной проверки никто не чувствует сразу. Материал выходит, очередь сокращается, а ошибка проявляется позже, в другом месте и под другим названием.
Моя собственная оценка, не измерение: когда я строю что-то ровно так, как хочу, по одной функции за раз, я трачу примерно в четыре раза больше времени на отладку, чем потребовал бы обычный процесс только с участием человека.
В целом я всё равно экономлю время, но это дольше и труднее, чем сказать AI «просто сделай». Один из моих проектов за несколько часов, а не дней, вырос из небольшого в проект корпоративного масштаба. Писать код перестало быть медленной частью. Проверка быстрее не стала.
Три раза, когда мой собственный конвейер меня обманул
Я каждый день работаю с AI-агентами и предпочитаю показывать, где они подвели, а не повторять обещание. Эти три случая настоящие, и у каждого одна и та же форма: система, сделавшая работу, сама же сообщила, что с работой всё в порядке.
1. Третье предплечье (11 октября)
Я генерировал короткометражный фильм по сегментам. Вернулся первый сегмент, и в отчёте ассистента он назван огромным шагом вперёд, а руки названы нормальными. Я не пересчитывал руки.
Когда я посмотрел, огромное третье предплечье висело на переднем плане 4,5 секунды.
Отчёт не был ложью в умышленном смысле. Это была сводка, написанная тем же процессом, который сделал ролик, а в этом процессе не было шага, где он обязан найти дефект.
Правило, которое я записал потом: считайте руки и пальцы на увеличенных кадрах и начинайте первый отчёт с дефектов, а не с похвалы. Если первый отчёт не может назвать ни одного дефекта, я считаю работу незаконченной.
2. «Успешно остановлено» (17 октября)
Я остановил задачу в оболочке, которая запускала тесты. Инструмент ответил: «Успешно остановлено.» Оболочка и процесс Python были ещё живы. Когда я завершил один из них, оболочка запустила следующий шаг.
Сообщение о статусе является утверждением. Проверкой оно не является. Остановка, которую вы не проверили, остаётся надеждой.
Правило: после остановки чего угодно выведите список запущенных процессов и повторяйте, пока список не опустеет. Только потом продолжайте.
3. Тест, который не мог провалиться (с 23 сентября по 11 октября)
Сквозной тест отслеживания формы заявки, датированный 23 сентября, блокировал вызовы API, которые слушает тег. Слушатель никогда не срабатывал, и тест проходил каждый раз.
11 октября я обнаружил два события заявки, сработавшие с разницей в 50 миллисекунд там, где должно было быть одно. Тест, которому я доверял неделями, не мог этого увидеть. Если бы я связал эти данные с конверсиями рекламы, не заметив ошибки, конверсии считались бы дважды.
Правило: тест отслеживания должен позволять API отвечать поддельным успешным ответом, чтобы у слушателя было на что реагировать. Тест, который не может провалиться, не тест, а украшение.
Сначала проверка машиной
Внимательное чтение кода или текста является последней линией обороны, а не первой. Если машина может что-то проверить, пусть проверяет, а человека оставьте для того, что машина оценить не способна. Заменить проверку встроенными отказами модели тоже не получится: у открытой модели их можно убрать правкой файлов, об этом мой материал про аблитерацию моделей ИИ.
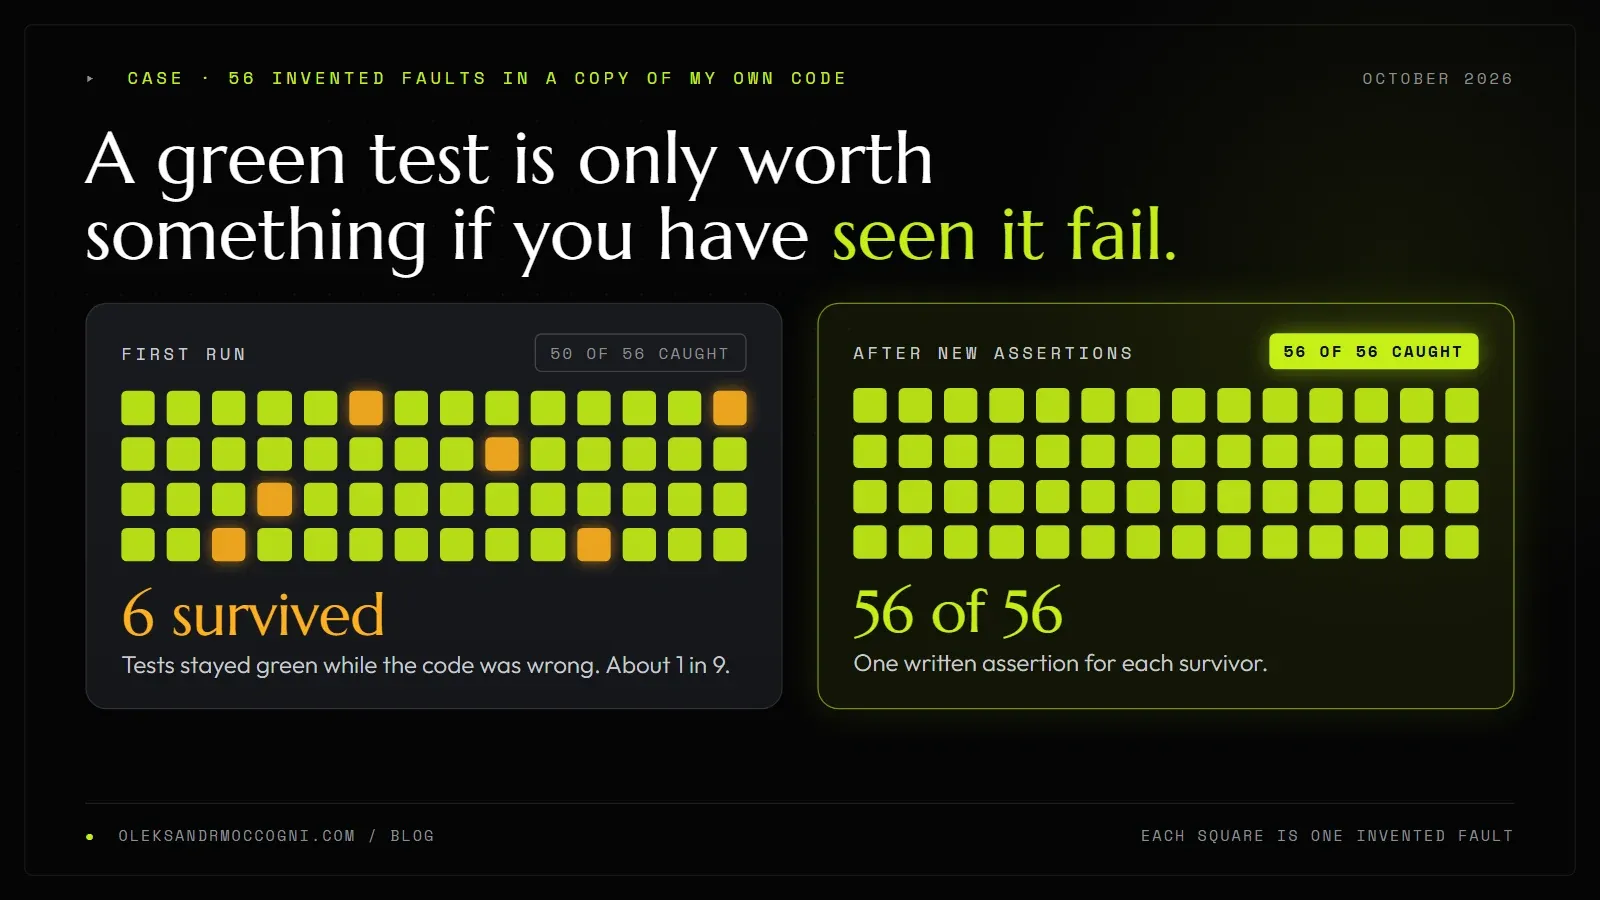
Вот эксперимент, который изменил мой взгляд. У меня есть инструмент, с помощью которого я запускаю и контролирую AI-агентов, с набором тестов, который я считал хорошим. Чтобы выяснить, так ли это, я придумал 56 дефектов, внедрил их в копию кода и запустил тесты.
- 50 дефектов нашлись сразу.
- 6 дефектов уцелели. Набор тестов оставался зелёным, пока код был неверным.
- Я написал новые проверки для этих 6. Итоговый результат: 56 из 56.
Шесть уцелевших из 56 составляют около 11%. Набор тестов, который я назвал бы надёжным, пропускал примерно одну ошибку из девяти.
Дело не в том, что инструмент плохо сделан. Дело в том, что, читая тесты, я бы этого никогда не узнал, а зелёная галочка чего-то стоит, только если вы хоть раз видели, как она проваливается.
О человеческой стороне этого я писал в материале про human in the loop. Коротко: цикл, который не может отклонить, это театр. Сначала добавьте проверку машиной, затем человека, затем запись.
Как распознать AI slop до публикации
Большинство людей смотрят на slop сначала глазами, и это не работает, потому что slop гладкий. Вот признаки, которые проверяю я, каждый с тестом, который можно выполнить за минуту:
- Он утверждает то, чему не может назвать источник. Тест: каждое число, имя и дата ведут к странице, которую вы открыли сами, а не к черновику.
- Он шаблонный. Тест: мог бы этот абзац без изменений появиться на сайте любой другой компании? Если да, о вашей он ничего не говорит.
- В нём есть детали, которые не могут быть правдой. Тест: посчитайте конечности и пальцы на изображениях, прочитайте текст на вывесках, пересчитайте итоги, проверьте единицы.
- Он раздут. Тест: вырежьте треть. Если ничего не потеряно, эта треть была водой.
- Никто не может сказать, кто его одобрил. Тест: имя и дата рядом с файлом.
Ни для одного из этих тестов не нужен особый инструмент. Нужно время, которое должны были купить сэкономленные часы производства.
Некоторые платформы теперь проверяют это сами: LinkedIn сообщает, что по состоянию на август 2026 года то, что он классифицирует как AI slop, получает на 40% меньше просмотров. Откуда эта цифра, я объясняю в гайде о том, как алгоритм LinkedIn ранжирует посты.
Бюджет проверки: как я работаю сейчас
Решение не в том, чтобы «проверять усерднее». Усерднее проверять тоже не масштабируется. Решение в том, чтобы относиться к проверке как к бюджету, с той же дисциплиной, какую вы применяете к деньгам.
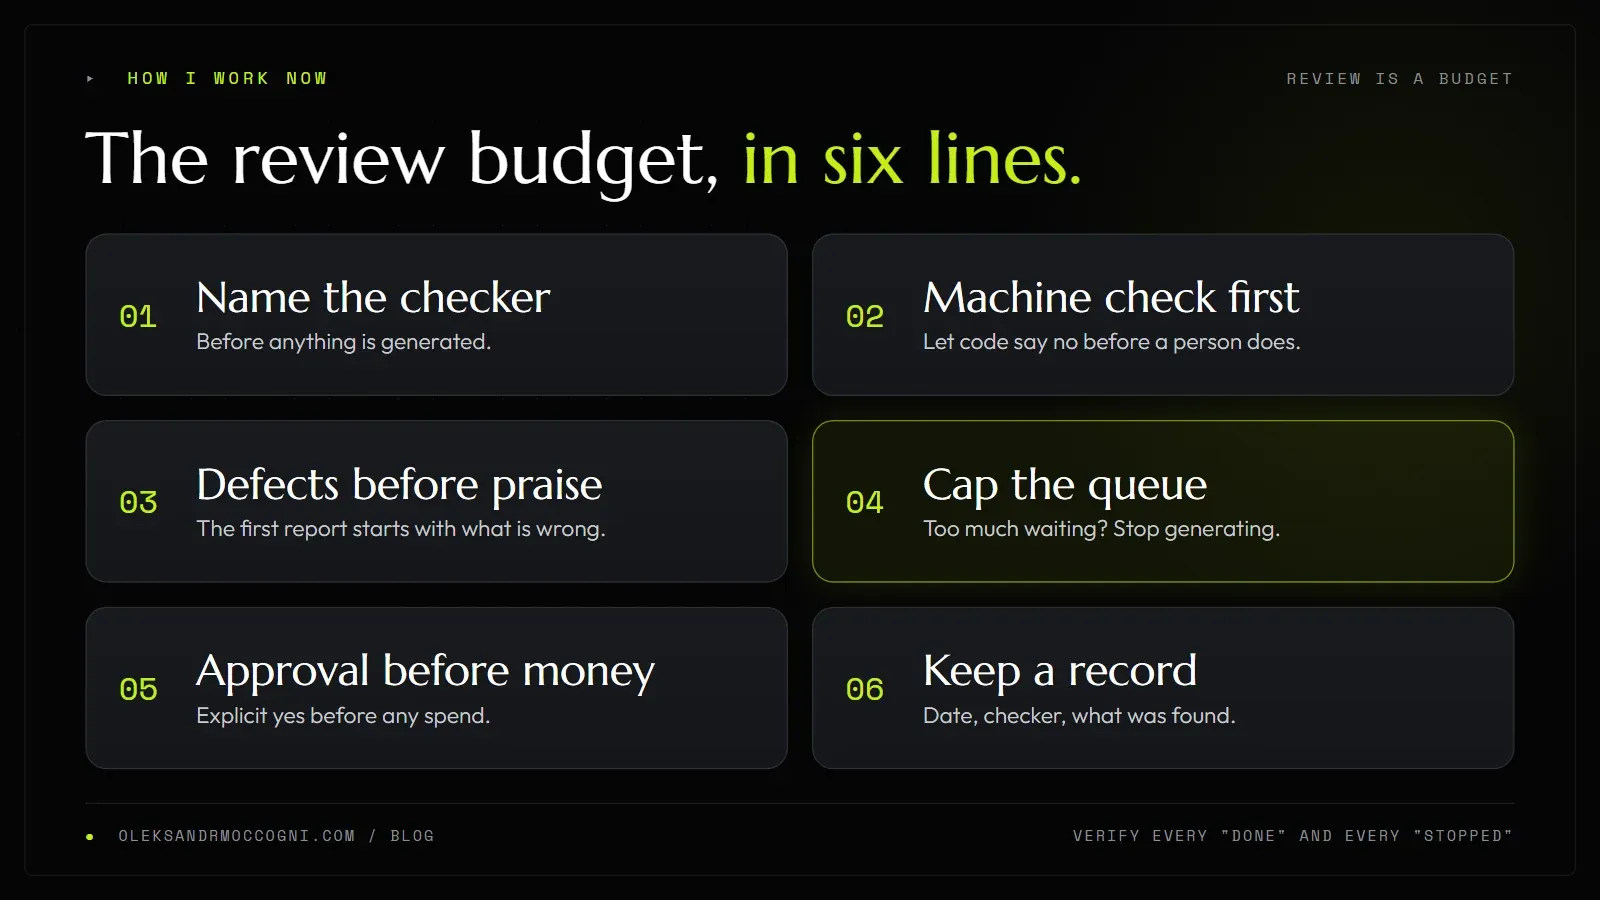
1. Назначьте проверяющего для каждого вида результата
Для каждого вида результата запишите, кто или что его проверяет, до того как вы что-либо сгенерируете. Результат без назначенного проверяющего не готов к производству.
2. Сначала самая дешёвая проверка машиной
| Результат | Машина может проверить | Человек должен оценить |
|---|---|---|
| Код | тесты, типы, сборка | дизайн и соответствие продукту |
| Отслеживание | тест с поддельным успешным ответом, подсчёт событий | отвечают ли данные на бизнес-вопрос |
| Видео или изображение | извлечение кадров, подсчёт конечностей и текста | соответствует ли бренду и стоит ли это показывать |
| Отчёт или статья | числа по источнику, ссылки, даты | верна ли аргументация |
| Изменение рекламы | лимиты аккаунта, diff | стоит ли тратить деньги |
3. Пусть производитель сначала сообщает о дефектах
Попросите генерирующий процесс начинать отчёт с того, что не так, что он не смог проверить и что принял на веру. Отчёт, который открывается похвалой, вызывает у меня наименьшее доверие.
4. Ограничьте очередь
Если число материалов, ожидающих проверки, превышает заранее заданный предел, остановите генерацию, пока оно не снизится. Это та же идея, что лимит незавершённой работы на доске Kanban, применённая к результатам AI.
Растущая куча непроверенного не является продуктивностью. Это обязательство, по которому ещё не выставлен счёт.
5. Поставьте явное одобрение человека перед деньгами
Это правила, по которым я уже работаю со своими агентами. Рекламная кампания меняется или тратит деньги только с моего явного одобрения, даже если речь о паузе. Читать и сообщать можно свободно.
Для платных генераций я сначала получаю предварительный расчёт с моделью, числом материалов и стоимостью. Затем я оцениваю один результат, прежде чем запускать партию. Если этот первый результат отклонён, все следующие шаги останавливаются.
6. Ведите запись
Одна строка на запуск: дата, кто проверял, что нашёл, что изменилось. Через месяц журнал покажет, какую ручную проверку перенести в код. Цикл из пяти частей я описываю подробнее в статье про human in the loop.
Что это значит для маркетинговых команд
Когда команда покупает сторону выпуска AI (больше черновиков, больше вариантов, больше отчётов) и не закладывает бюджет на сторону проверки, результат предсказуем. Проверяющий, обычно руководитель, становится узким местом, а его одобрение превращается в формальный штамп, потому что очередь никогда не кончается.
Простой способ увидеть очередь
Возьмите число материалов, которое ваши инструменты способны выпустить за неделю, и вычтите число, которое человек может по-настоящему проверить за неделю. Если результат положительный, очередь растёт на это число каждую неделю.
Вот пример с придуманными числами, не данными. Ваши инструменты выпускают 120 материалов в неделю, а один проверяющий может нормально проверить 40. Очередь растёт на 80 материалов в неделю, и через месяц ждут 320.
Никто не проверяет 320 материалов. Их пролистывают, штампуют или игнорируют, и именно так slop выходит из компании, которая никогда не собиралась его публиковать.
Три измерения
Если это звучит знакомо, я советую три измерения, прежде чем покупать что-либо ещё:
- Размер очереди: сколько созданных AI материалов прямо сейчас ждут решения человека?
- Время проверки на материал: сколько длится настоящая проверка, а не беглый просмотр?
- Доля пропущенных ошибок: сколько из одобренных материалов пришлось исправлять после выхода?
Если очередь растёт, а доля пропущенных ошибок остаётся на месте, вы не ловите проблемы, а одобряете вслепую. Если доля пропущенных ошибок растёт, slop уже вышел.
Проверка лишь одна из причин, по которым AI-проекты останавливаются. Моя статья о том, почему внедрения AI в маркетинге проваливаются, охватывает более широкий набор причин, а материал про использование AI в маркетинге рассказывает, чему меня научили два с половиной года ежедневной работы в том, где AI всё ещё ошибается.
Ничто из этого не довод против использования AI. Я использую его для большей части своей работы. Это довод в пользу того, чтобы потратить сэкономленное время производства на то, что нельзя автоматизировать: решить, что достаточно хорошо для отправки, и быть готовым отправлять меньше, когда проверка не успевает.
Частые вопросы
Что такое AI slop?
Под AI slop понимают цифровой контент низкого качества, созданный с помощью AI, обычно в большом количестве и опубликованный без настоящей проверки. Merriam-Webster определяет его как «цифровой контент низкого качества, который обычно производится в большом количестве с помощью искусственного интеллекта» (перевод мой). Главный тест: проверил ли его кто-нибудь до того, как он дошёл до читателя, который о нём не просил.
Что значит AI slop?
У значения два слоя. Словарный слой: некачественный, массово производимый контент AI. Рабочий слой, из определения Simon Willison 2024 года: непроверенный контент AI, навязанный людям, которые о нём не просили. Не весь контент, созданный AI, является slop.
Как избежать AI slop?
Проверяйте перед публикацией и ограничивайте то, сколько вы генерируете, тем, сколько можете проверить. Назначьте проверяющего для каждого вида результата, сначала запускайте проверки машиной, просите производящую систему сообщать о дефектах прежде, чем хвалить, и ограничьте очередь непроверенного.
Почему это называется AI slop?
«Slop» первоначально означало мягкую грязь, а позже что-то малоценное, по сообщению Associated Press о выборе Merriam-Webster. Люди применили слово к результатам AI из-за количества: постоянного дешёвого потока контента, о котором никто не просил.
Весь ли контент, созданный AI, является slop?
Нет. Контент, о котором человек просил, который проверил и за который отвечает, не является slop, каким бы инструментом он ни был сделан. Willison делает то же замечание в своём посте 2024 года.
Что такое узкое место проверки?
Так я называю точку рабочего процесса, где результат, выглядящий готовым, ждёт человека, способного его оценить. Когда AI удешевляет создание, эта точка становится пределом того, сколько хорошей работы выходит.
Может ли AI проверять собственные результаты?
Часть ошибок он ловит, но свою работу обычно оценивает благосклонно, как показало моё третье предплечье. Используйте отдельного проверяющего, критерии оценки и проверки машиной, которые могут провалиться.
Мой вердикт
AI slop является симптомом. Причина в дисбалансе: стоимость создания упала почти до нуля, а стоимость оценки не изменилась. Лучшими промптами это не исправить. Это исправляется, когда вы даёте проверке бюджет, назначенного ответственного и проверку машиной, которая умеет говорить нет.
Карточка:
- Назначьте проверяющего до того, как что-либо генерировать.
- Сначала запускайте проверку машиной.
- Просите дефекты раньше похвалы.
- Ограничьте очередь непроверенных результатов.
- Ставьте явное одобрение перед деньгами.
- Проверяйте каждое «готово» и каждое «остановлено».
- Ведите запись и со временем переносите ручные проверки в код.
Цифры Faros приведены по публикации от 23 июля 2025 года, а определение словаря по сообщению от 15 декабря 2025 года. Случаи и подсчёты из моей собственной работы датированы в тексте.
Хотите, чтобы кто-то второй посмотрел, как ваша команда проверяет результаты AI, с чек-листом под ваши процессы? Поговорите со мной о вашем процессе проверки.