AI-агенты в маркетинге: как понять, что ничего не упущено
AI-агенты для маркетинга ошибаются молча. Моя схема: скрипт собирает всё, ИИ читает всё целиком, а проверка, не зависящая от ИИ, подтверждает результат.
AI-агенты для маркетинга редко ломаются с сообщением об ошибке. Они ломаются тихо: докладывают, что всё в порядке.
AI-агенты для маркетинга - это программы, в которых модель ИИ сама выбирает шаги и инструменты для достижения цели, например следит за рекламными кабинетами или читает комментарии. Эта свобода и есть главный довод продавцов, и в ней же прячутся ошибки.
Вопрос, который я задаю любому агенту: как я замечу, что он ошибся?
Я строю такие инструменты для своей работы и для консалтинга, и ответ, к которому я пришёл, - схема из трёх ходов. Скрипт собирает всё, ИИ читает всё целиком, а проверка, не зависящая от ИИ, доказывает результат.
В статье разобрано, как агенты молча ошибаются, три хода схемы, четыре маркетинговые задачи на её основе и то, как я проверяю сами проверки.
Главное коротко
- Оценивайте AI-агента для маркетинга по тому, как вы замечаете его ошибки, а не по тому, сколько он умеет.
- Фиксированное правило находит только то, что вы предвидели. Пусть скрипт собирает всё, а ИИ читает всё целиком. Пороги нужны, чтобы сортировать, а не чтобы решать, смотреть или нет.
- ИИ, который проверяет ИИ, может сказать «всё хорошо», когда это не так. Добавьте доказательство, не зависящее от ИИ.
- Ломайте свои проверки нарочно. У одной проверки, которую я испытывал, тесты пропустили около четверти заложенных мной ошибок.
- Считайте стоимость в процентах от тарифа, а не в долларах. Агент читает и пишет намного больше, чем чат.
- Часто нужен рабочий процесс, а не агент. Берите самое простое, что работает.
Что такое AI-агенты для маркетинга и что вместо них продаёт большинство вендоров
Anthropic, компания, создавшая Claude, проводит границу, которую стоит позаимствовать. В руководстве Building effective agents она пишет: «Рабочие процессы - это системы, в которых большие языковые модели (LLM) и инструменты оркестрируются через заранее заданные пути в коде». Затем: «Агенты же - это системы, в которых модели сами динамически управляют своими процессами и использованием инструментов, сохраняя контроль над тем, как они выполняют задачи».
Цитаты Anthropic здесь и дальше даны в моём переводе. Проще говоря, рабочий процесс (workflow) - это рецепт, написанный заранее: если приходит X, сделай Y. Агент сам решает, какие шаги делать.
Большая часть того, что рынок продаёт как агента, - это рецепт, а рецепт хорош там, где работа должна идти одинаково каждый раз, как мой конвейер автоматизации рассылки. По этому определению почти всё, что работает у меня, - рабочий процесс с одним шагом чтения силами ИИ посередине. Это верный выбор, когда рецепт сам по себе не способен увидеть то, чего вы не предусмотрели.
В том же руководстве есть совет, который легко пропустить: «мы рекомендуем искать максимально простое решение и усложнять его только при необходимости. Возможно, это означает вообще не строить агентные системы». Там же предупреждение: «Автономность агентов означает более высокие затраты и возможность накопления ошибок», и важнее всего здесь накопление, потому что ошибка на втором шаге на третьем читается как факт.
Руководство вышло в декабре 2024 года и посвящено агентам вообще, а не маркетингу, поэтому я беру из него понятия, но не инструменты. Карта того, какие маркетинговые задачи автоматизировать первыми, есть в моей статье про автоматизацию маркетинга с помощью ИИ, так что здесь я остаюсь с самим агентом.
Три способа, которыми AI-агент для маркетинга молча ошибается
Ни один из этих сбоев не даёт сообщения об ошибке. Каждый даёт спокойный и уверенный отчёт.
Правило находит только то, что вы предвидели
24 октября я попросил сделать четырёх ежедневных агентов: для Google Ads, конверсий, новостей и постов в соцсетях. В первом наброске схемы, который сделал ИИ, пороги стояли в скрипте, и только отмеченный порогом сигнал будил ИИ для чтения.
Моё возражение было коротким: скрипт не может понять, что что-то не так, если только он не извлекает всё и не передаёт это на чтение ИИ. Порог находит только то, что вы уже предвидели. В итоговой схеме пороги и сравнения сортируют список и запускают немедленные оповещения, но никогда не служат условием, при котором ИИ вообще смотрит.
Пример выдуманный. Допустим, правило оповещает вас, когда расход на рекламу растёт больше чем на 30 процентов. Сайт, который перестал фиксировать заявки, пока расход остался прежним, ничего не запустит, и в отчёте будет написано, что всё хорошо.
Чтобы проверить схему, я написал тест для новостного агента, который читает новости о безопасности и платформах и сверяет их с реестром сайтов и компонентов, за которыми я слежу. Тест убирает из реестра одну позицию, PHP (язык программирования, на котором работают многие сайты), и проверяет, что две новости об уязвимости в PHP всё равно помечаются только по своему содержанию.
На сервере-заглушке, который лишь притворяется настоящим, механизм работает. Когда PHP есть в реестре, обе новости получают пометку «реестр: да», то есть касаются того, за чем я слежу, и уходят два немедленных оповещения.
Без PHP новости остаются в ежедневном дайджесте (пронумерованном списке всего, что читает агент) с пометкой «реестр: нет», немедленных оповещений нет, а совет получает метку «не проверено» и низкую критичность. Если убрать позицию из реестра, меняются метки, но не то, прочтёт ли ИИ новость. Следующий шаг - прогон с настоящей моделью.
Проверяющий говорит «всё хорошо»
11 октября ИИ-помощник проверил первый фрагмент короткого фильма, сгенерированного другим ИИ, назвал результат огромным шагом вперёд и сказал, что кисти рук выглядят нормально. Количество рук он не пересчитал: третье предплечье занимало кадр 4,5 секунды. Полная история изложена в моей статье про AI slop и узкое место проверки.
Урок не в том, что ИИ-проверяющий бесполезен. Совет самой Anthropic по тестированию агентов из статьи Demystifying evals for AI agents такой: «Мы рекомендуем выбирать детерминированные оценщики там, где это возможно, оценщики на основе LLM там, где это необходимо или нужна дополнительная гибкость, а оценщиков-людей привлекать взвешенно, для дополнительной проверки». ИИ-оценщика нужно калибровать по людям, и он работает лучше, если ему разрешено ответить «Не знаю», когда информации не хватает.
Та же статья об оценке показывает, что сломанной может оказаться сама проверка. Модель набрала 42 процента на публичном тесте, пока исследователь Anthropic не нашёл, среди прочего, «жёсткое оценивание, которое штрафовало „96,12“, когда ожидалось „96,124991…“». После того как ошибки в оценивании исправили, а условия теста сделали менее жёсткими, та же модель набрала 95 процентов.
Откуда число: публичный тест возможностей ИИ-моделей. Что оно значит: значительная часть «провала» была в проверках, а не в модели. Что меняется: прежде чем доверять оценке, прочтите, как её выставляли.
То же касается и тестов ИИ на кибератаки: какие вопросы задать, прежде чем верить результату, я разобрал в материале кибератаки ИИ: что показывают тесты.
Разбор мультиагентной исследовательской системы от Anthropic добавляет урок, близкий к маркетингу: «Человеческая оценка ловит то, что упускает автоматика». Тестировщики-люди заметили, что ранние агенты «последовательно выбирали SEO-оптимизированные контент-фермы вместо авторитетных, но менее высоко ранжирующихся источников, таких как академические PDF или личные блоги». Любой маркетинговый агент, который ищет информацию в интернете, может ошибиться так же: ответ звучит правильно, а источники не те.
Чтение получается частичным
Третий сбой тише остальных. Агент читает только то, что отметило правило, или только сводку, которую выдал инструмент, а ответ лежит в той части, на которую никто не смотрел.
У одного клиента реклама идёт только с понедельника по пятницу, поэтому из 28 дней показывать её можно только в 20, а не в 28. В предыдущем периоде она работала в 20 из этих 20 дней, в последнем - в 7 из 20, потому что рекламу приостановили на время проверки со стороны платформы.
Сводка, где сказано лишь, что трафик упал, выглядит как обвал. Подсчёт дней показа по почасовому расписанию, а не по календарю, показал, откуда взялось падение, и дал сравнению правильную основу.
На сайте, который собирает заявки, 242 из 525 сеансов, то есть 46 процентов, пришли из стран, где стоят дата-центры. Почти все эти визиты начались без перехода с другого сайта, ограничились одной страницей и длились в среднем 0,4 секунды. Так ведёт себя программа, а не человек.
Число всё время лежало в таблице, и ни один порог его не искал. Как я превратил эти два случая в отчёт, описано в моей статье про маркетинговый отчёт.
Схема из трёх ходов: скрипт, чтение, доказательство
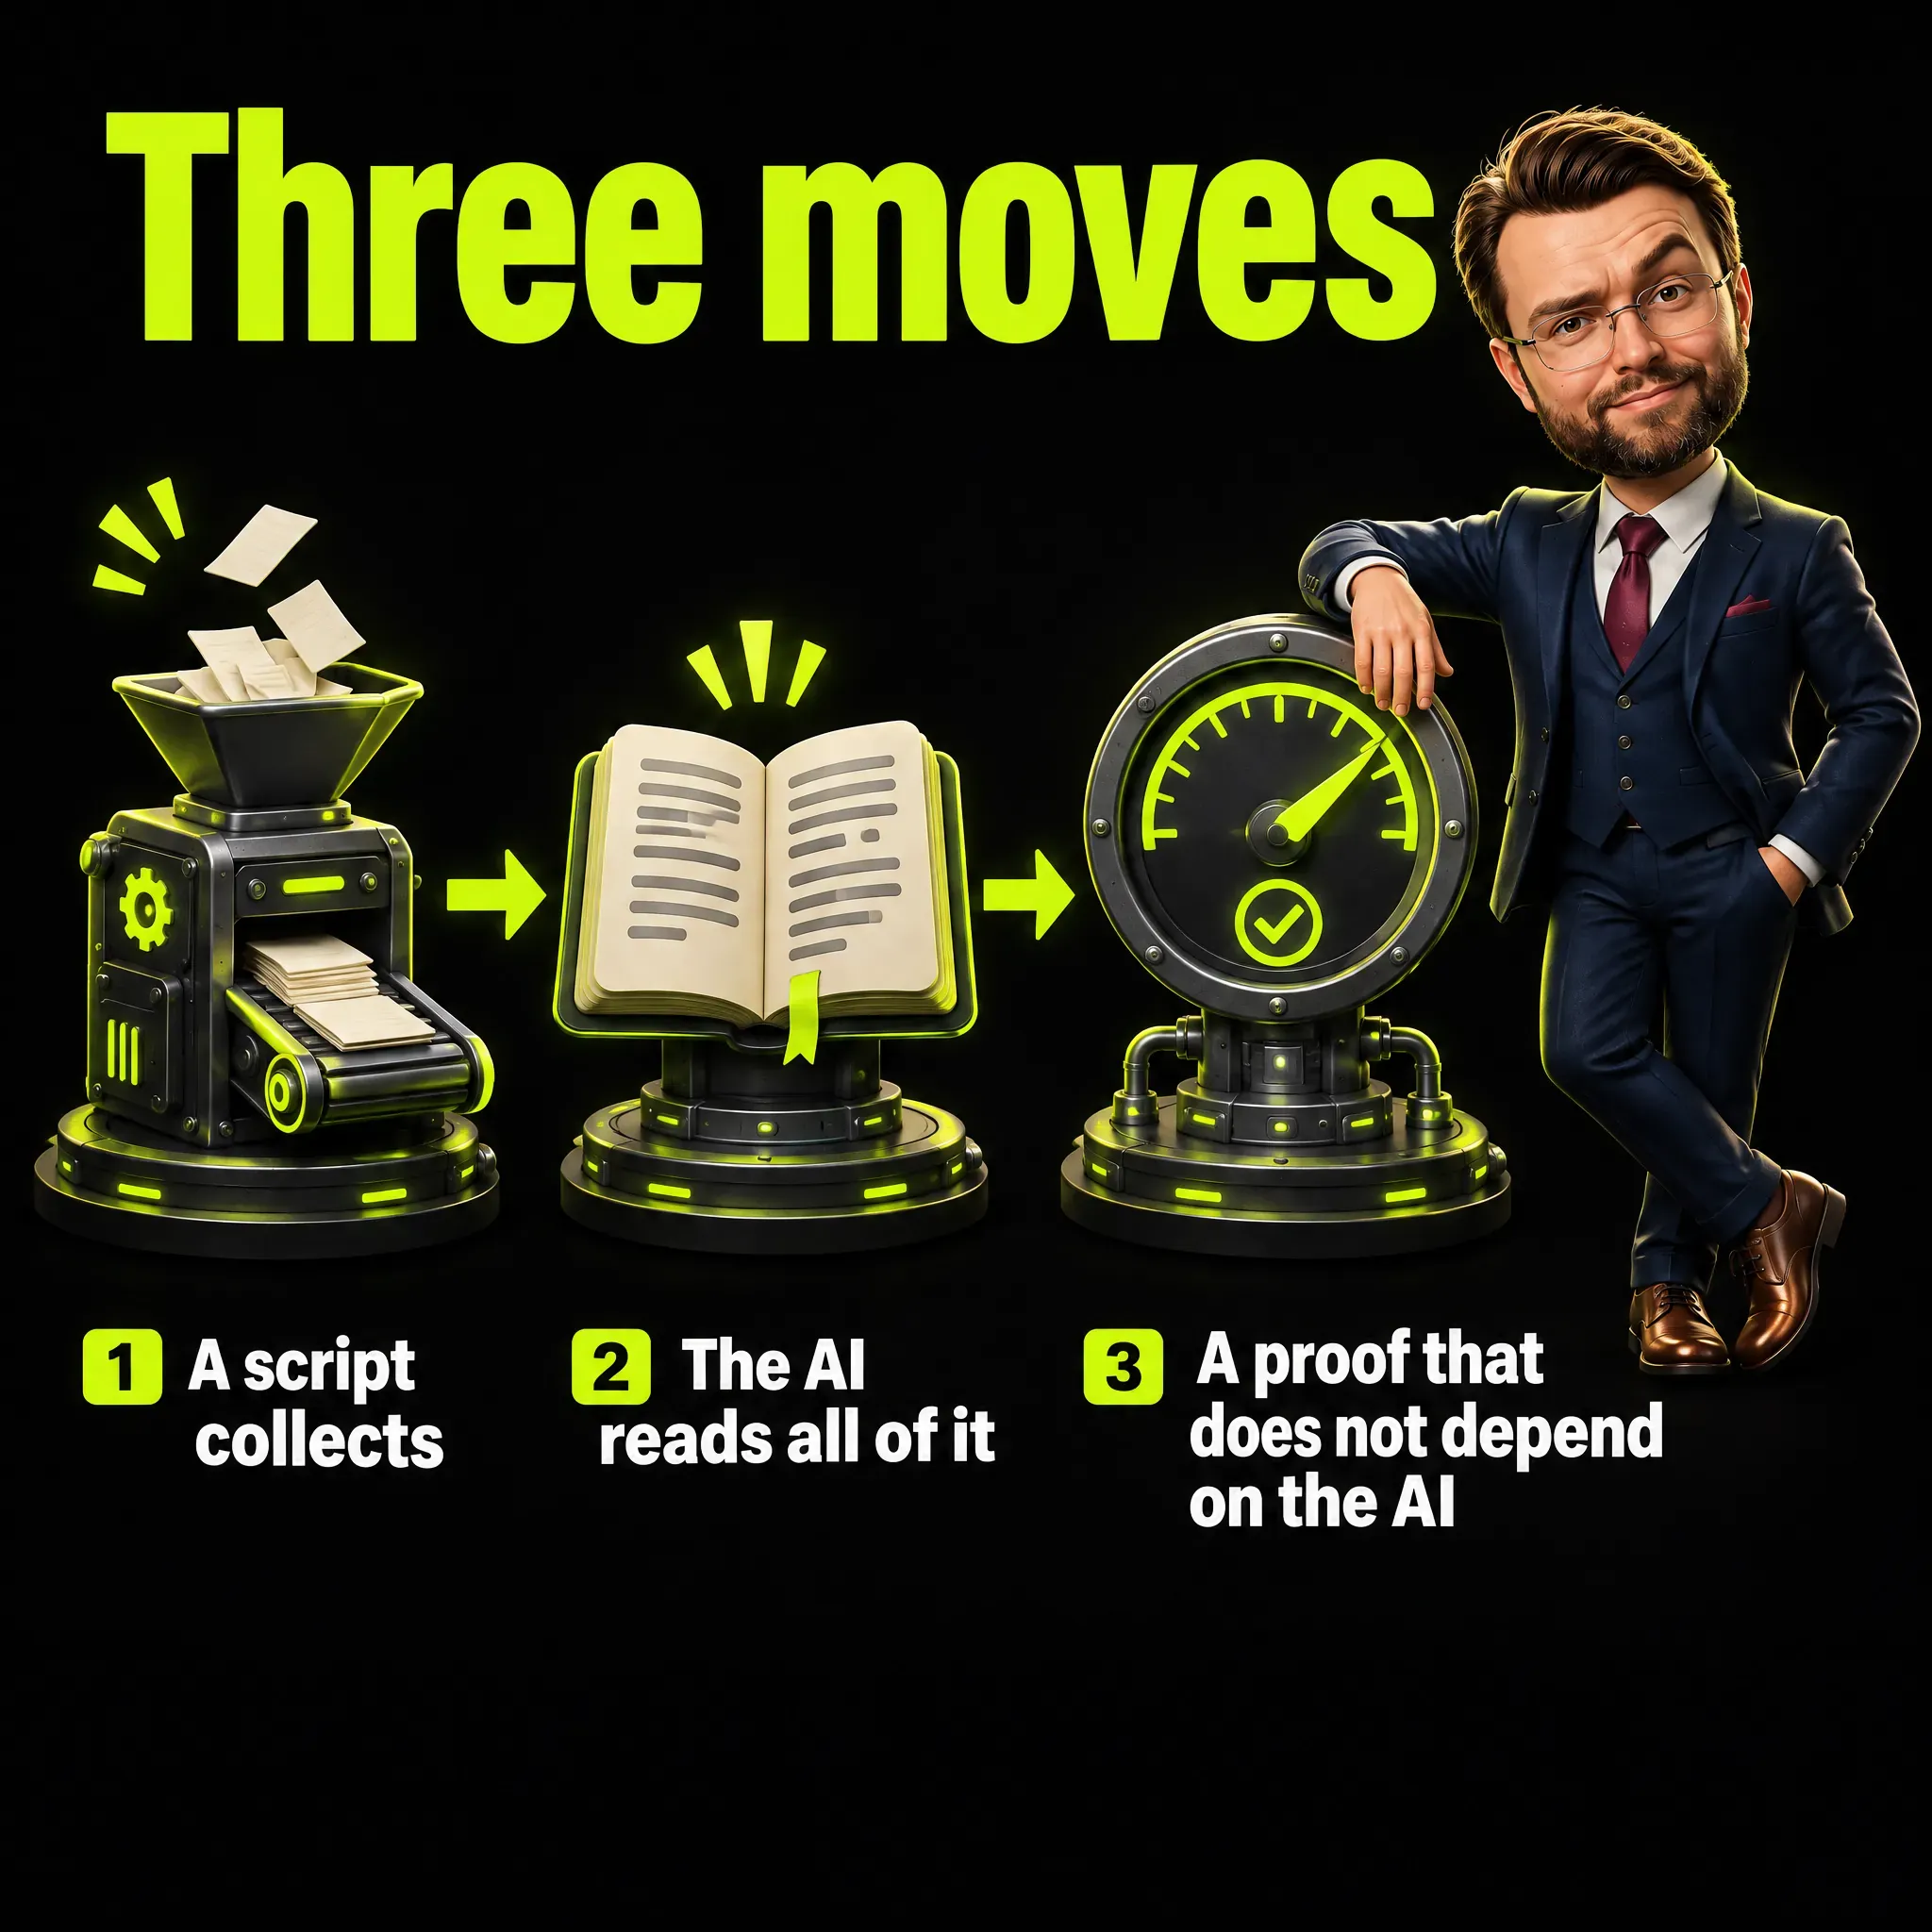
Первый ход: скрипт собирает всё. Здесь нет ИИ и нет расхода токенов, то есть небольших фрагментов текста, которые модель читает и пишет. Скрипт скачивает всё, на что будет смотреть агент, и убирает дубликаты.
Затем он считает сравнения (со вчерашним днём и со средними за 7 и 28 дней), размечает каждую запись и пишет один пронумерованный список. Я называю его дайджестом.
Второй ход: ИИ читает весь дайджест. В каждый день, когда есть что-то новое, модель читает список целиком. У неё нет ни инструментов, ни доступа в интернет, ни подключений: она читает и возвращает структурированные предложения.
Тексты от других людей, например ленты новостей и веб-страницы, считаются недоверенными данными. Критичность, ссылки и коды вычисляет код, а ИИ выбирает записи по номеру, поэтому выдумать ссылку он не может. Почему чужой текст опасен для агента и как от этого защищаться, я разобрал в материале про prompt injection и безопасность AI-агентов.
Третий ход: доказательство, не зависящее от ИИ. В руководстве Anthropic сказано: «агентам крайне важно на каждом шаге получать из среды „эталонные данные“ (ground truth), например результаты вызова инструментов или выполнения кода, чтобы оценивать свой прогресс». Этим термином Anthropic называет результаты, которые агент получает от своих инструментов на каждом шаге, и добавляет, что на контрольных точках агент может остановиться и запросить обратную связь у человека.
Я распространяю идею на проверки вне цикла. В маркетинге такие эталонные данные - это проверка, которая может не пройти и приходит из другого места: расписание рекламы, второй источник данных, тест, который заставляет систему вести себя как в рабочей среде, человек, который одобряет расход.
Почему именно такой порядок? Скрипт делает работу, которой не нужен интеллект, дёшево и одинаково каждый раз. ИИ вызывается один раз, чтобы прочитать материал, который уже приведён в порядок.
Такое же разделение есть внутри Claude: навык может содержать письменные шаги и небольшие скрипты, которые Claude запускает, когда задача подходит. Какой работе нужен навык и почему навык с кодом сначала надо проверить, я разбираю в статье про Claude Skills и их риски.
Четыре маркетинговые задачи, в каждой по три хода
Вот четыре задачи, построенные по этой схеме, и статус каждой. Отчёт для клиентов уже работает. Чтение Google Ads идёт внутри него.
Проверка трекинга - это испытанная процедура, но пока не ежедневный агент. Для чтения комментариев готов инструмент оценки, а ежедневный агент пока в планах.
Мониторинг Google Ads
По каждой кампании скрипт собирает расход, клики, конверсии, стоимость контакта, долю показов (как часто реклама показывалась, когда могла), поисковые запросы, которые вводили люди, дни, когда реклама работала по почасовому расписанию, и сравнение со вчерашним днём и со средними за 7 и 28 дней. ИИ читает весь список и возвращает советы с числом, периодом и сравнением, но не действия.
Доказательство: скрипт считает дни показа по расписанию, конверсии сверяются со вторым источником (контакты в аналитике сайта, заказы в магазине), и ничто не тратится и не меняется без моего прямого согласия, даже пауза. Чтение без права записи уже работает внутри моего еженедельного отчёта для клиентов. Ежедневный агент планируется в два шага: сначала совет, затем отдельное одобренное действие из закрытого списка, например добавление минус-слова (слова, при поиске которого реклама перестаёт показываться) или пауза одного ключевого слова или объявления, а бюджеты и ставки не трогаются никогда.
Проверка трекинга
Скрипт считает события и число разных людей на каждое событие по странам и источникам, а также длительность, страницы и вовлечённость на сеанс. Он также отправляет тестовую заявку с тестовым параметром. ИИ читает всю таблицу - страна, источник, вовлечённость - и повторяющиеся события.
Доказательство - тест в браузере, где каждый запрос к серверу сайта получает поддельный ответ «ок», а каждый запрос к аналитике записывается и затем блокируется. Этот тест воспроизвёл событие формы, пришедшее дважды с разницей в 50 миллисекунд, на сайте клиента. Он объяснил, почему четыре события «лид» в данных оказались тремя отправками формы от двух человек, причём все они были тестовыми контактами из команды самого клиента.
В прежней версии теста блокировались запросы к серверу сайта, поэтому второе срабатывание события не было видно. Настройку тегов я исправил 11 октября и перепроверил тем же тестом. О стороне согласия читайте в чек-листе по согласию на трекинг в Швейцарии (на английском).
Отчёты для клиентов
Скрипт читает данные аналитики, поиска и рекламы в режиме только для чтения, плюс суммы заказов из магазина без персональных данных и набор проверок сайта: ответ сервера, сертификат, заголовки безопасности, аутентификацию почты, карту сайта и скорость, измеренную на реальных посетителях. ИИ читает недельный журнал того, что сделано для клиента, и пишет черновик текстовой части, который я прочитываю до отправки.
Доказательство: числа и итоговые фразы берутся из формул, поэтому ни одну цифру не пишет модель. Отсутствующее значение выводится как «n/a», а не как ноль, и сравнения делаются по одним и тем же дням.
Контроль тона блокирует черновик, если клиенту не сказали о реальном ущербе, и за период уходит только одно сообщение. Отчёт работает, и каждое сообщение я одобряю до отправки клиенту. По теме: операционный маркетинг.
Чтение комментариев
Скрипт собирает цифры через 24 часа и через 7 дней (показы, реакции, комментарии, репосты, сохранения, визиты в профиль) из выгрузки или скриншотов, текст комментариев и имена авторов, а также механическую оценку черновика. ИИ читает настоящие комментарии, группирует их по темам и повторяющимся вопросам и предлагает идеи для контента, а каждые четыре поста подводит итог и предлагает новое правило.
Доказательство: оценка по 12 проверкам для всего, что может проверить код, а для остального - моё собственное суждение, например одна точная мысль и голос автора. Я смотрю на порядки величин, а не на разницу в 10 процентов.
Этот агент никогда сам не отвечает и не комментирует, а первый комментарий к посту пишется вручную. Оценка и импортёр готовы, к ним написано 44 автоматических теста, а ежедневный агент пока в планах.
Как я проверяю проверки вокруг AI-агента для маркетинга
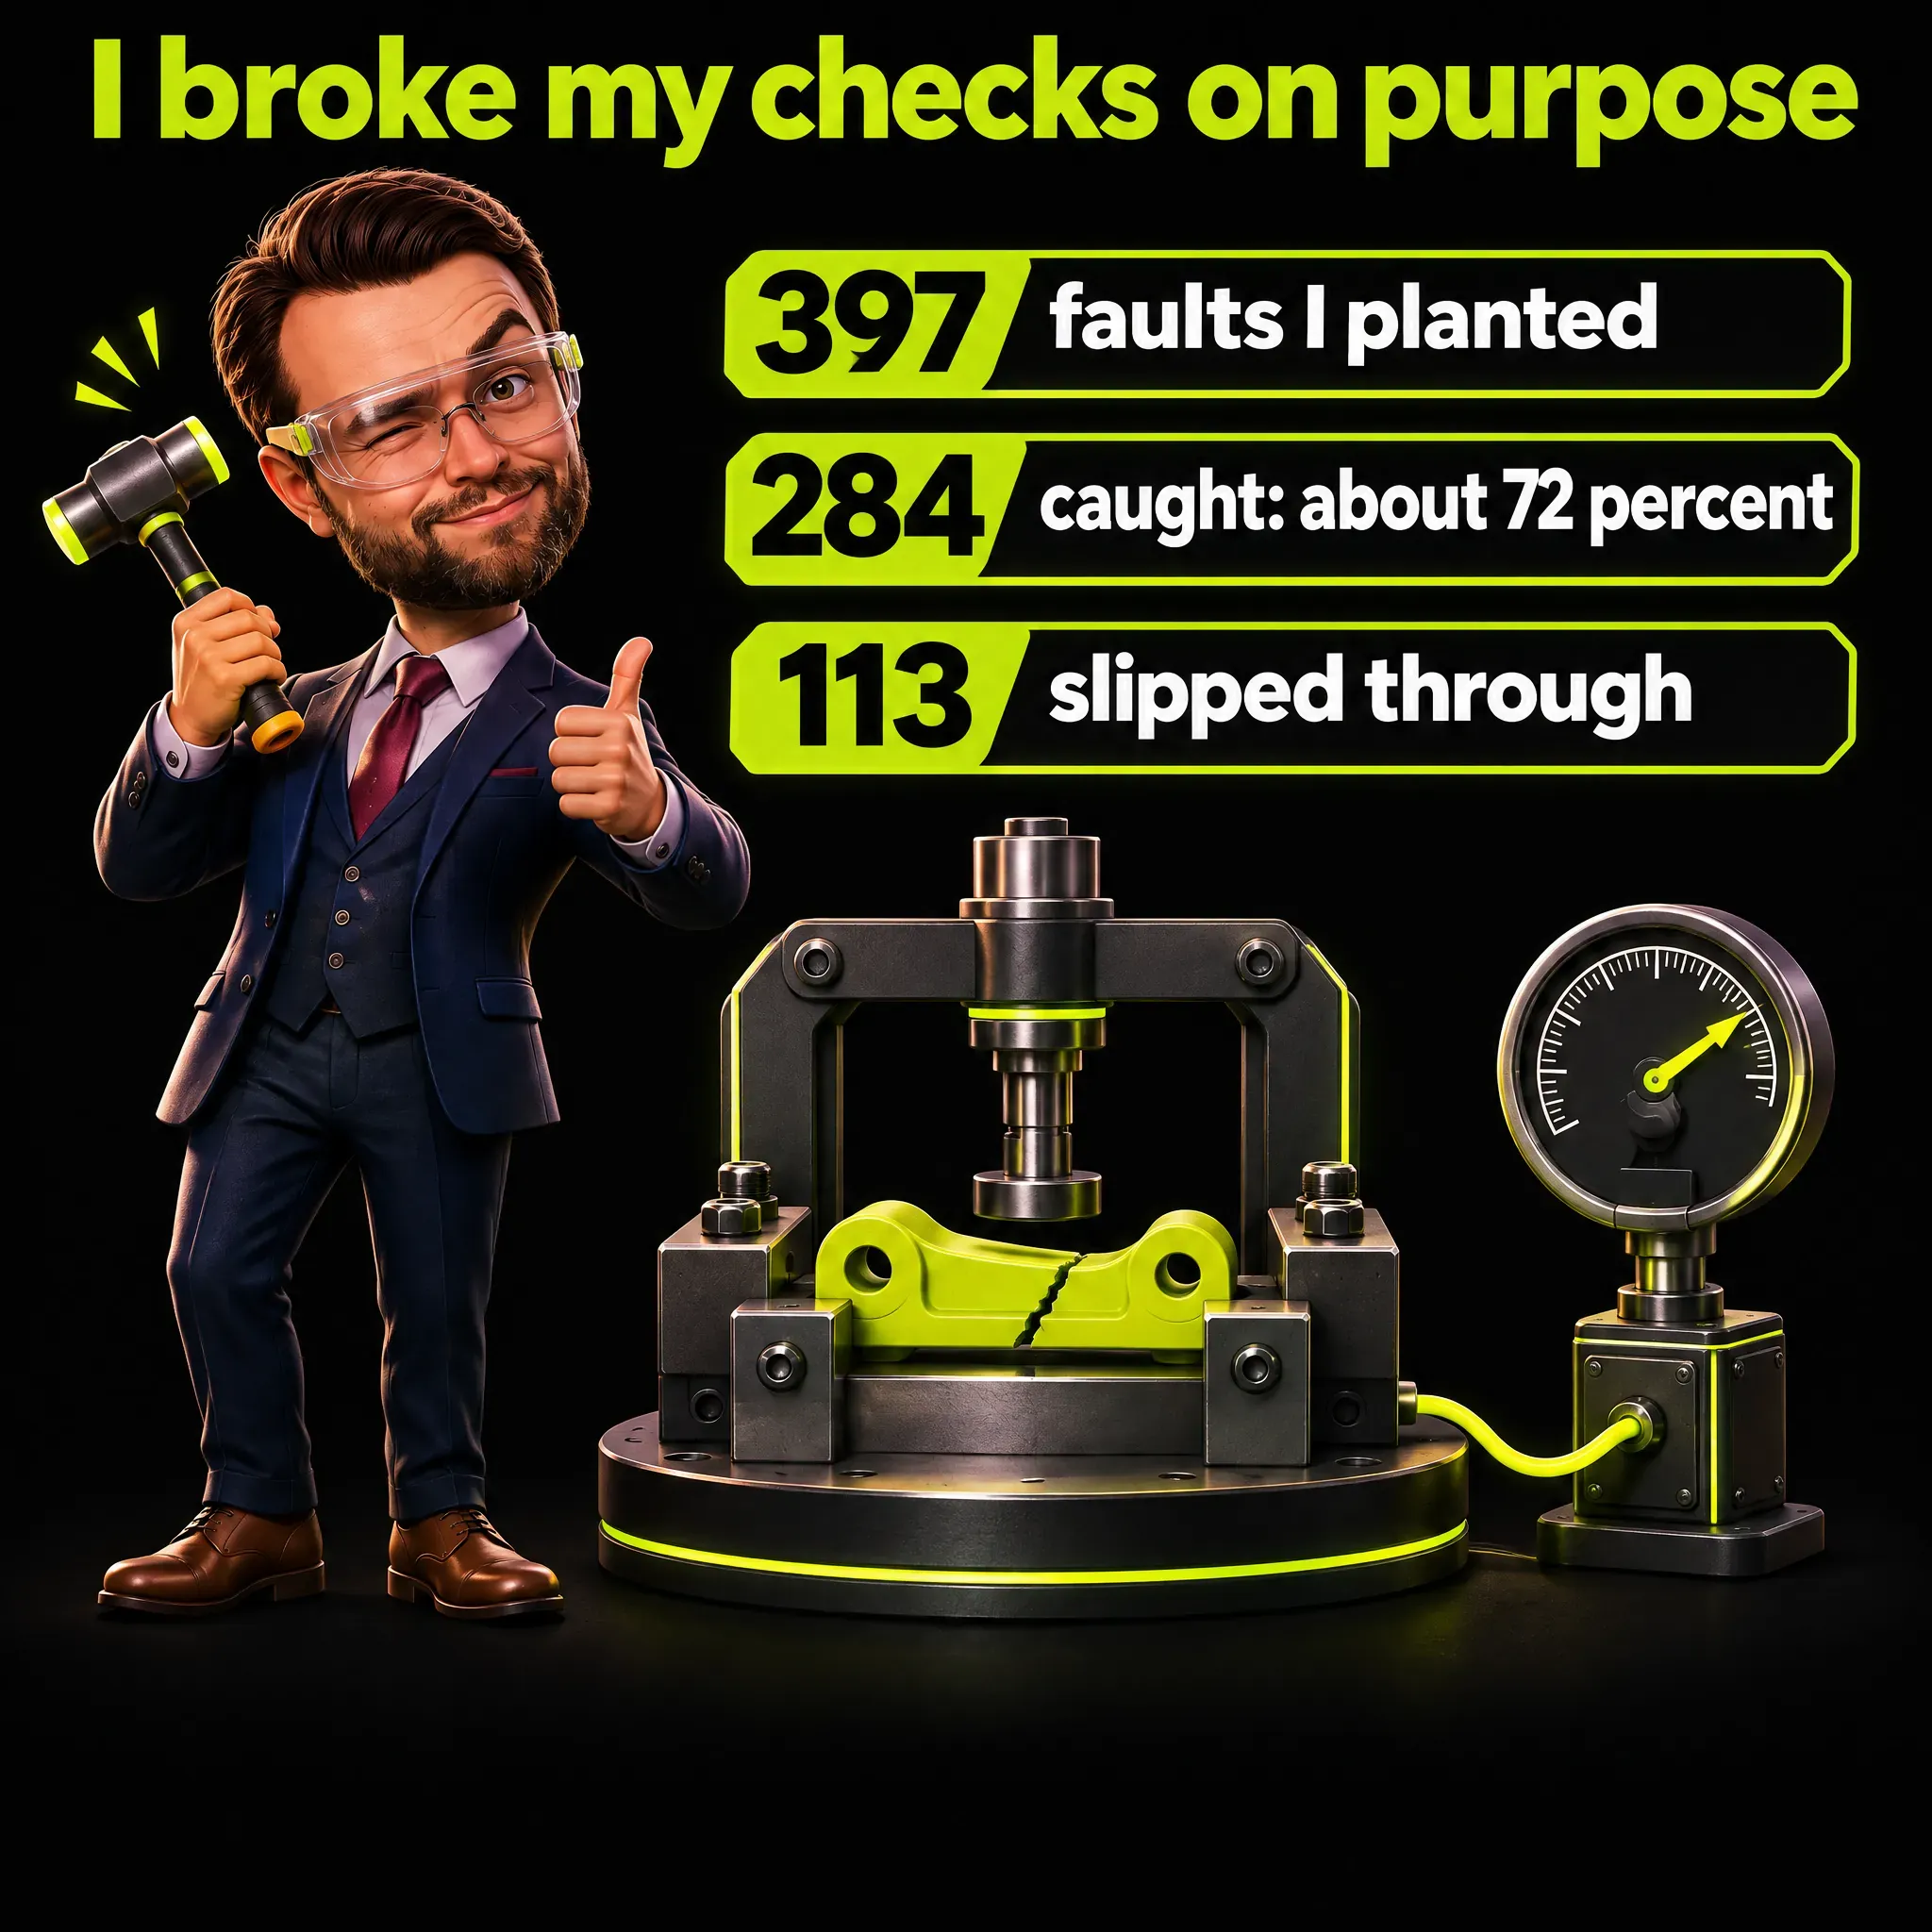
Зелёные тесты мало что говорят, пока вы не попробуете заставить их упасть. Мой метод: выдумывать ошибки, вносить их по одной в копию кода и считать, сколько из них ловят тесты.
Я делал это три раза. На проверке, которая сверяет список клиентских сайтов и компонентов, я выдумал 399 ошибок, из которых запустить удалось 397. Тесты поймали 284 сразу, около 72 процентов, а 113 проскочили.
Из этих 113 ошибок 12 были эквивалентными, то есть не меняли поведения, а 101 оказалась настоящей дырой, и я закрыл их новыми проверками. Настоящие дыры составляют около 25 процентов от 397.
Откуда число: выдуманные ошибки в копии проверки. Что оно значит: примерно одна ошибка из четырёх, которые я заложил в самую тонкую свою проверку, осталась бы незамеченной её собственными тестами. Что меняется: «зелёный» перестаёт быть доказательством и становится вопросом - что именно этот тест пытался сломать?
На скрипте, который отправляет файл на сервер, я заложил 84 ошибки. Тесты поймали 78, а 6 проскочили: 2 настоящие дыры я закрыл, 4 эквивалентные задокументировал. Когда я нашёл дыру в самом тесте, я добавил ещё 4 ошибки, и тесты поймали их все.
Более ранний раунд из 56 выдуманных ошибок против набора тестов, который я считал хорошим, закончился новыми проверками и результатом 56 из 56 пойманных. Эта история изложена в статье про AI slop.
Второй инструмент - второй ИИ в роли рецензента, который не слышал моих выводов. Он получает код, а не мой рассказ о нём, и может только читать. Поэтому он полезен там, где не помог проверяющий из истории с фильмом: ему не с чем соглашаться.
Для новостного агента один такой рецензент, запущенный с чистого листа, без памяти о работе и с установкой думать глубоко, дал 9 замечаний. Я исправил 6, и к каждому написал тест, который сначала падал, потому что исправление без падающего теста ничего не доказывает. О более широкой привычке проверять результаты ИИ читайте в статье про проверку ИИ человеком (human-in-the-loop).
Сколько стоит AI-агент для маркетинга: проценты от тарифа, а не доллары
При подписке стоимость в долларах чисто теоретическая. Важное число - доля тарифа, которая расходуется, в окне на 5 часов и в недельном окне, которые показывает ваш тариф.
Случай, после которого это стало реальным: 17 и 18 октября три долгих прогона агентов за одну ночь, примерно 15 миллионов токенов в сумме (11,1 плюс 1,0 плюс 3,1 миллиона), израсходовали недельный лимит, когда работа была сделана наполовину. Агенты конкурируют со всем остальным за один и тот же потолок.
Направление задаёт Anthropic: «агенты обычно используют примерно в 4 раза больше токенов, чем обычный диалог в чате, а мультиагентные системы - примерно в 15 раз больше, чем чаты». Эти множители взяты из собственной исследовательской системы Anthropic, а не из маркетинговых задач, поэтому я читаю их как предупреждение, а не как измерение.
Мои собственные числа и то, чем они являются:
- Калибровка, порядок величины. По записям моих сессий за 18 октября, 1 процент недели - это примерно 0,64 миллиона выходных токенов, то есть текста, который пишет модель. В те 15 миллионов, о которых шла речь выше, входит и всё, что агенты прочитали, поэтому одно число на другое делить нельзя.
- Оценки, а не измерения. Одно чтение стоит примерно от 8 000 до 25 000 токенов на входе и от 1 000 до 2 000 на выходе. Новостной агент вместе со вторым ИИ, который проверяет его предложения, должен расходовать примерно 0,1 процента недели, не больше. Ежедневный агент, читающий один сайт, должен расходовать примерно от 0,2 до 0,5 процента недели.
Всё это относится к моему аккаунту в целом, а не к одному прогону, а проценты тарифа имеют смысл только для тех, кто платит подписку. Меняется порядок работы: сначала оценить, потом запускать партиями, а всё, что не требует чтения, поручить скрипту.
Когда AI-агент для маркетинга не нужен
- Рецепт известен. Если вы можете написать «если X, то Y», рабочий процесс обходится дешевле и ломается предсказуемо. Мои отчёты для клиентов работают на фиксированных формулах именно поэтому.
- Неверный шаг дорог, и его трудно заметить. Anthropic предупреждает о накоплении ошибок. Там, где ошибка стоит денег или доверия, я оставляю расходы, сообщения клиентам и комментарии за согласием человека и склоняюсь к рабочему процессу.
- Вы не можете назвать доказательство. Если никто не может сказать, какая проверка покажет, что агент ошибся, я советую не начинать.
Если вы управляете бизнесом и вам предлагают агента, советую задать один вопрос: какая проверка подскажет нам, что он ошибся? Хороший ответ называет второй источник, расписание или тест, а слабый звучит как «ИИ проверяет сам себя». Провал целых проектов - другая тема, она разобрана в материале о том, почему проекты AI-маркетинга проваливаются, а эта статья о более тихом сбое агента, который продолжает работать.
Чек-лист перед тем, как AI-агент для маркетинга начнёт работать сам
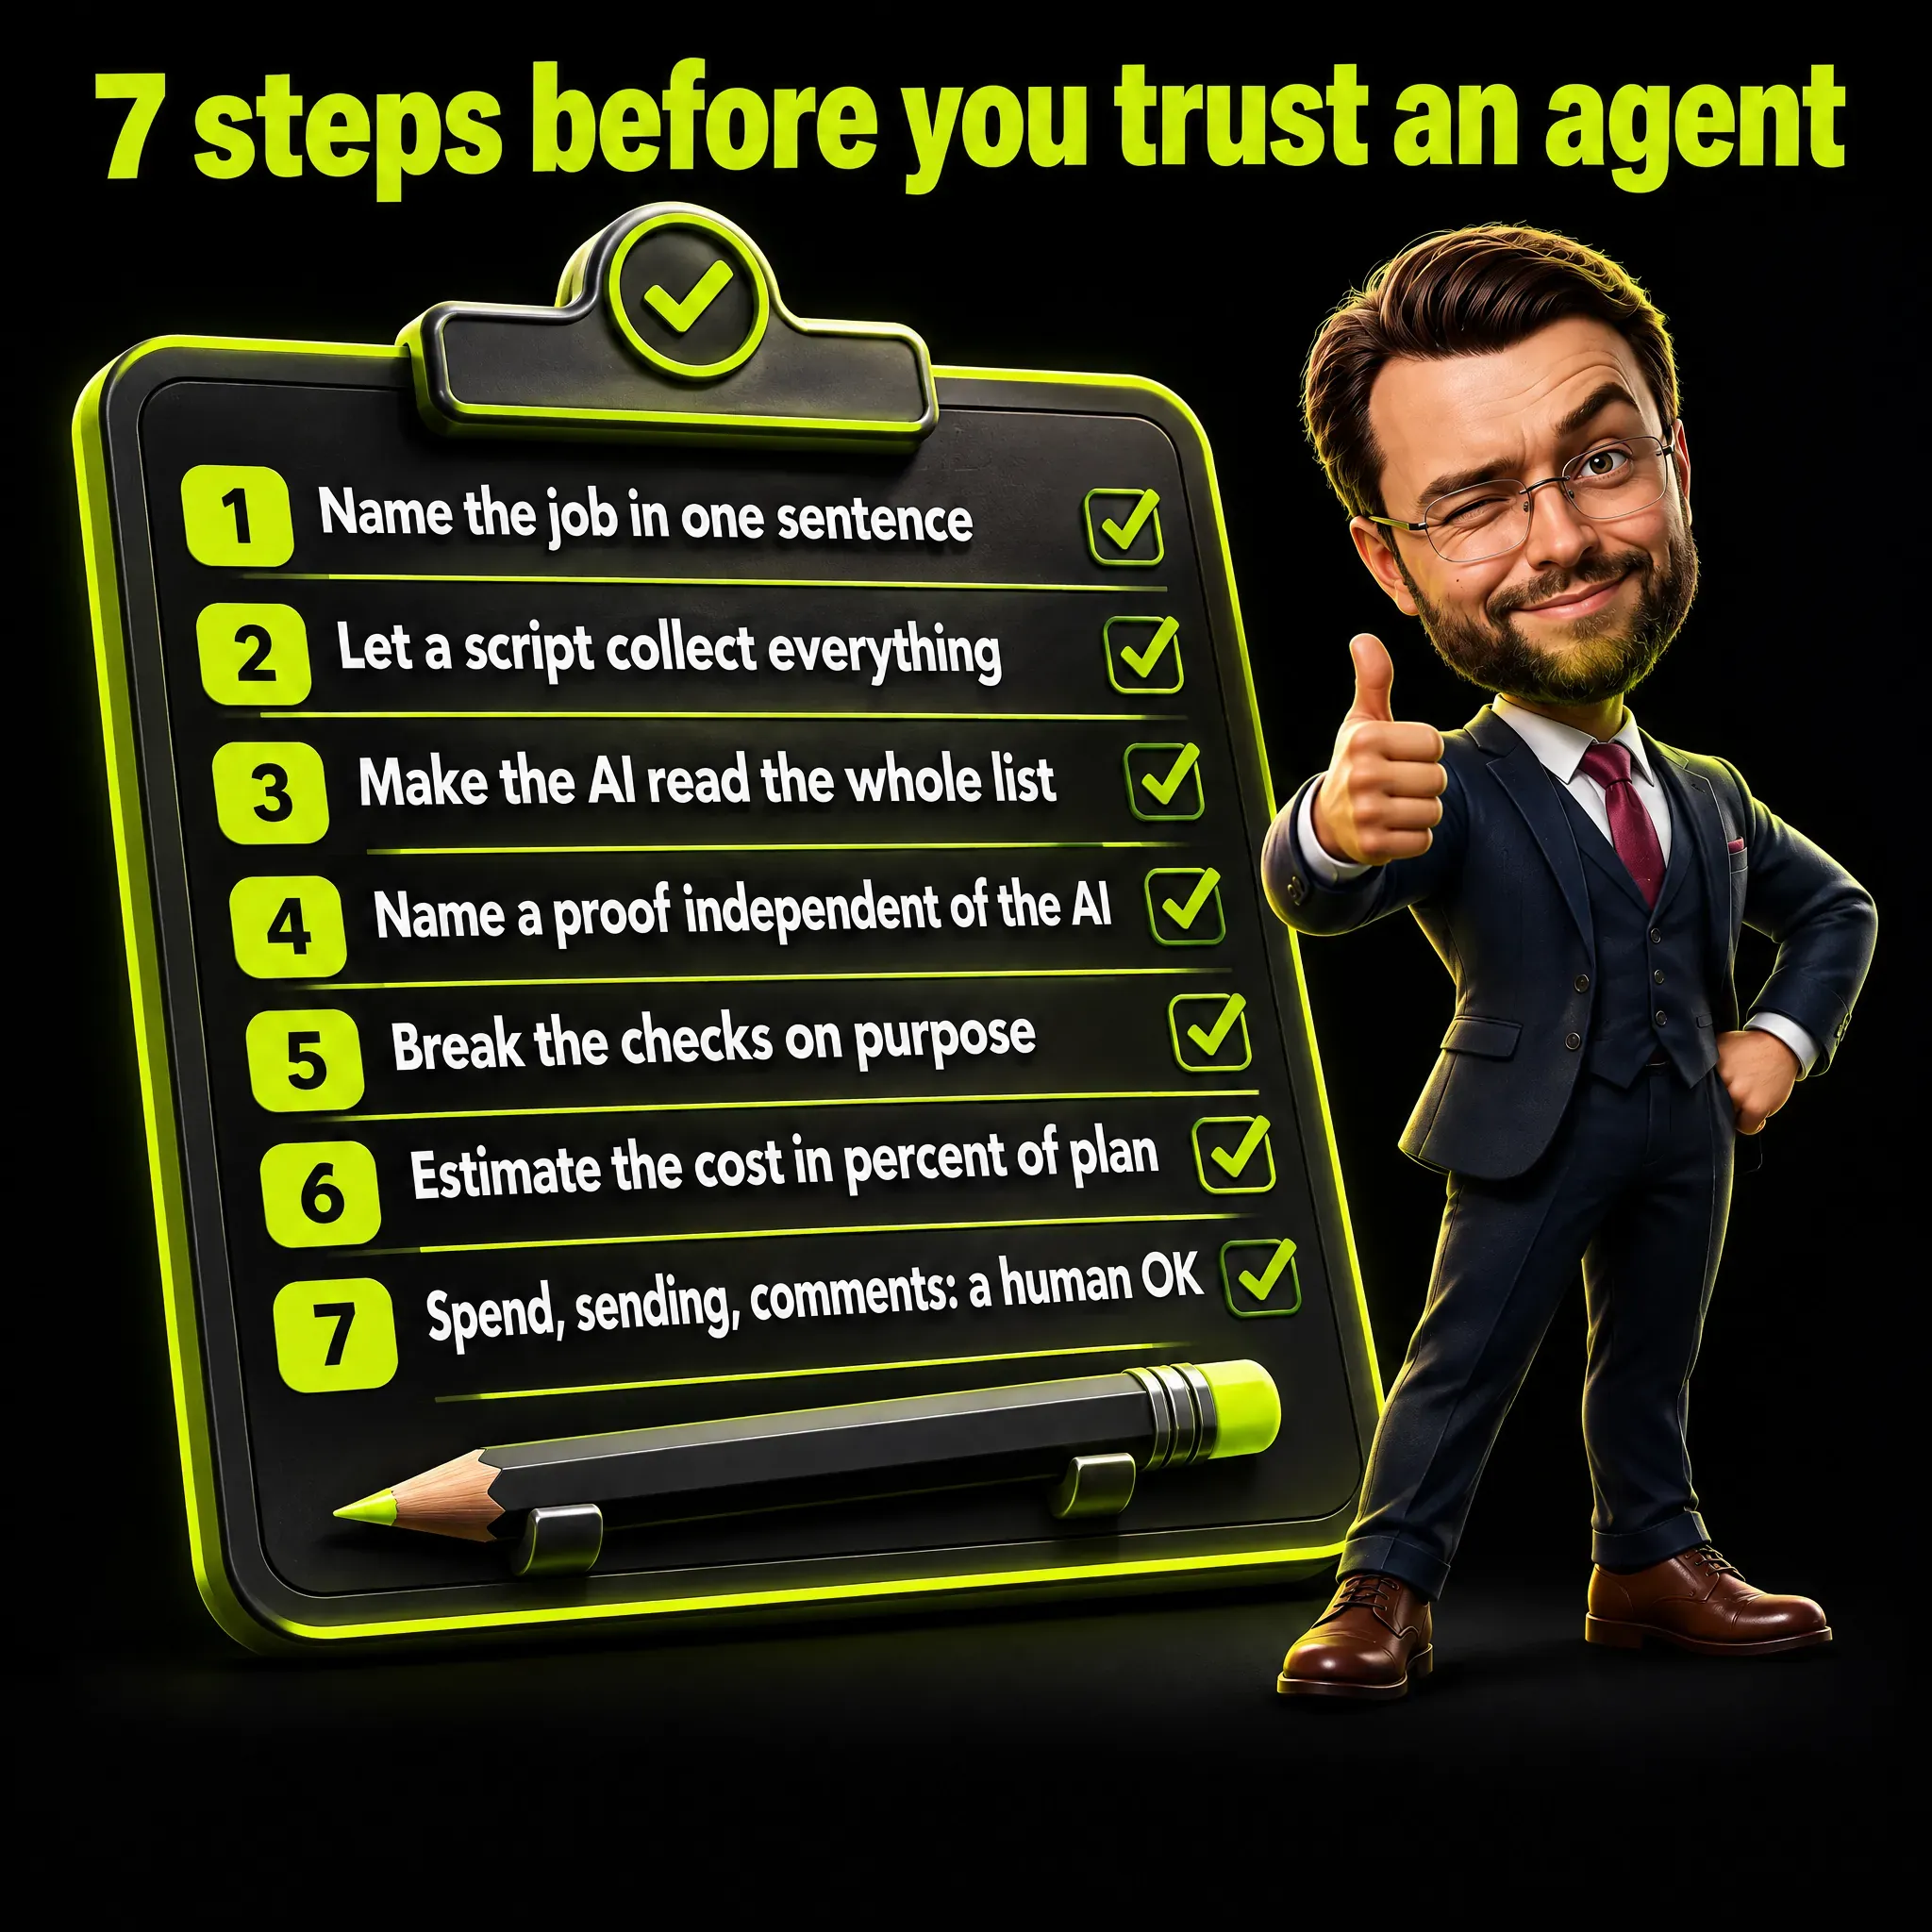
Предлагаю такой порядок:
- Назовите задачу одним предложением и решение, которое она обслуживает.
- Пусть всё собирает скрипт. Оставьте пороги как метки для сортировки и оповещений, но не как условие, при котором стоит смотреть.
- Пусть ИИ читает весь список и разрешите ему отвечать «Не знаю».
- Назовите доказательство, не зависящее от ИИ: второй источник, расписание или тест, который заставляет систему вести себя как в рабочей среде.
- Сломайте проверки нарочно, прежде чем доверять зелёному результату.
- Оцените стоимость в процентах от тарифа и запускайте партиями.
- Оставьте расходы, отправку и комментарии за согласием человека.
Когда названы скрипт, чтение и доказательство, AI-агенты для маркетинга всё равно могут ошибаться, но не могут скрыть ошибку. Более широкая картина того, какое место занимает ИИ в маркетинговом плане, есть в моей статье про стратегию ИИ в маркетинге и в материале про использование AI в маркетинге.
Частые вопросы
Что такое AI-агенты для маркетинга?
Это программы, в которых модель ИИ сама решает, какие шаги и инструменты использовать для достижения маркетинговой цели, в отличие от рабочего процесса, который идёт по рецепту, написанному заранее. На практике многие продукты, которые продают как агентов, на деле рабочие процессы.
Что такое агентный маркетинг?
Маркетинг, в котором часть работы передана агенту, который сам выбирает шаги. Я использую определение агента от Anthropic и не придумываю отдельное отраслевое.
Чем AI-агент отличается от автоматизации маркетинга?
Рабочий процесс идёт по путям, заданным в коде, а агент сам управляет своим процессом. Карта того, что автоматизировать первым, есть в моей статье про автоматизацию маркетинга с помощью ИИ.
Какие есть примеры AI-агентов для маркетинга?
Четыре задачи из моей работы: мониторинг кампаний Google Ads, проверка трекинга, подготовка отчётов для клиентов и чтение комментариев к постам. В каждой одни и те же три хода: скрипт собирает, ИИ читает, доказательство вне ИИ проверяет.
Какие AI-агенты для маркетинга лучшие?
Лучший для вас тот, чьи ошибки вы видите. Прежде чем покупать любого агента, спросите, что он собирает, что читает и какое независимое доказательство его проверяет.
Как понять, что AI-агент ничего не пропустил?
Не с помощью порога. Пусть скрипт собирает всё, ИИ читает всё целиком, а затем добавьте доказательство, не зависящее от ИИ, и второй ИИ, который рецензирует код, не слышав ваших выводов.
Нужен ли мне вообще агент?
Часто нет. Если рецепт известен, рабочий процесс дешевле и ломается предсказуемо. Anthropic формулирует это так: «Возможно, это означает вообще не строить агентные системы».
Какую часть тарифа на ИИ расходует агент?
Считайте в процентах от тарифа, а не в долларах. Агенты расходуют больше, чем чат, поэтому я сначала оцениваю и поручаю скрипту всё, что не требует чтения.