Human in the Loop KI: Was OpenAIs Mathe-Release über die Kontrolle von Maschinenarbeit lehrt
Human in the Loop KI ist Theater, wenn die Prüfung nicht Nein sagen kann. Was OpenAIs Mathe-Release und seine Korrekturen Marketern über KI-Kontrolle lehren.

Human in the Loop KI klingt sicher, bis man fragt, was der Mensch eigentlich prüft. Am 6. Oktober stellte OpenAI Hunderte mathematischer Manuskripte auf GitHub, erzeugt von einem internen Modell.
Am 7. Oktober hielt die Verlaufsdatei fest, dass «ein Vorzeichenfehler ein Argument zur Auslöschung einer Stabilisierungsspur und die Konstruktion, die zwei abhängige Papers verwenden, ungültig macht» (meine Übersetzung). Drei Manuskripte wurden zurückgezogen, vierzehn weitere überarbeitet.
Die Verlaufsdatei zeigt, wie eine sichtbare Korrektur aussieht. Das Protokoll nennt den Fehler, die betroffenen Papers und die Massnahmen.
Ob die übrigen Resultate halten, kann ich nicht sagen. Ich kann sagen: Dieses Protokoll ist der Teil des Prozesses, den ein Marketer kopieren kann.
Fragen Sie sich jetzt, wie Ihre eigene Version aussieht. Ihre KI hat diese Woche einen Kampagnenbericht geschrieben. Wer hat ihn geprüft, womit, und wo steht das Protokoll?
Ich bin kein Mathematiker und kann die Beweise nicht beurteilen. Was ich lesen kann, ist der Prozess um sie herum.
Die folgenden Fakten stammen aus OpenAIs Ankündigung, aus README, Verlaufsdatei, Formalisierungskatalog und Überblick des Repositorys sowie aus einem arXiv-Audit. Zitate und Zahlen habe ich am 14. Oktober 2026 mit gespeicherten Kopien dieser Seiten abgeglichen.
Das Wichtigste vorab
- OpenAI hat am 7. Oktober drei Manuskripte zurückgezogen, einen Tag nach der Veröffentlichung, nachdem ein Vorzeichenfehler ein Argument zerstört hatte, das zwei weitere Papers nutzten. Dazu wurden 14 weitere überarbeitet und die Gründe aufgeschrieben.
- Zwei Formalisierungszahlen passen nicht offensichtlich zusammen. Das README nennt rund 42 % der Hauptresultate als formalisiert, die Verlaufsdatei 300 von 719, während die Katalogdatei 173 Papers auflistet. Das Repository sagt nicht, wie sich diese Zahlen zueinander verhalten.
- Eine Maschinenprüfung verifiziert die Aussage so, wie sie in der Maschine steht. Ob diese Aussage dem entspricht, was das Paper behauptet, bleibt eine menschliche Frage.
- Auch Prüfer können sich irren. Ein arXiv-Audit einer früheren OpenAI-Serie verzeichnet einen scheinbaren Fehler, der zurückgezogen wurde, als ein verlorener Überstrich aus dem Quelltext wiederhergestellt war.
- Human in the Loop KI funktioniert mit fünf Teilen: Eingaben, die der Mensch sieht, eine Regel zum Ablehnen, eine Folge der Ablehnung, eine Maschinenprüfung zuerst und ein Protokoll.
- Wenn Output billig ist, ist die Prüfung der Engpass. Planen Sie sie zuerst ein.
Was OpenAI veröffentlicht hat
OpenAIs Ankündigung ist auf den 6. Oktober 2026 datiert.
Das Repository enthält «mathematische Manuskripte und begleitende Beweisartefakte, erzeugt von einem internen OpenAI-Modell» (meine Übersetzung).
Das README zählt Stand 14. Oktober 719 Manuskripte in 372 Familien, es gilt die Apache-2.0-Lizenz.
Was OpenAI über die Arbeit angibt:
- Das Modell war am 14. Oktober unveröffentlicht. «Die grosse Mehrheit der Resultate wurde mit demselben Verfahren und einem unveröffentlichten internen OpenAI-Modell erzielt» (meine Übersetzung).
- Dem Modell wurden rund 4’000 Probleme gestellt. Der Katalog ist das, was nach der Bedingung «ein angemessenes Mass an Bedeutung» (meine Übersetzung) übrig blieb.
- Jedes Resultat brauchte im Schnitt rund drei Stunden ChatGPT-Pro-Rechenzeit. Das gilt pro Resultat, nicht pro Problem.
- OpenAI hat die unabhängige Advisory Group on Mathematics and Artificial Intelligence am Institute for Advanced Study dazu befragt, wie die Arbeit geteilt werden soll. Der Beitrag sagt nicht, dass die Gruppe die Resultate geprüft hat.
Die Kernbehauptungen sind gross. Familie 003 sagt, dass jede Dirichletsche L-Funktion, die Riemannsche Zetafunktion eingeschlossen, keine Nullstellen mit Realteil über 7/8 hat, was das Überblicks-PDF als «Lösung der Quasi-Riemann-Hypothese» (meine Übersetzung) bezeichnet. Das ist nicht die Riemann-Hypothese.
Familie 004 sagt, dass kein Algorithmus entscheidet, ob ein Polynom mit ganzzahligen Koeffizienten in beliebig vielen Variablen eine rationale Nullstelle hat, und stellt das als Lösung von Hilberts zehntem Problem über den rationalen Zahlen dar. Familie 107 beansprucht einen Exponenten der Matrixmultiplikation von höchstens 9/4 über den rationalen Zahlen.
Ich gebe das als Behauptungen wieder. Ich bin nicht die Person, die sie bestätigen oder bezweifeln kann.
Unter den drei zurückgezogenen Papers ist eines mit dem Titel «The rational Hodge conjecture for products of K3 surfaces». Die Korrektur berührte also eine bekannte, namentlich genannte Vermutung. Das README ist ungewöhnlich konkret darüber, was ungeprüft ist.
«Diese Sammlung enthält Resultate in unterschiedlichen Stadien der Verifikation. Nicht alle haben begleitende Lean-Formalisierungen.» (meine Übersetzung)
Dann: «Einige der unformalisierten Resultate könnten Probleme haben. Wir werden uns bemühen, solche Probleme rasch zu beheben.» (meine Übersetzung)
Zwei Zahlen, die nicht zusammenpassen
Das README nennt eine Zahl: «das Repository hat ~42 % der Hauptresultate formalisiert» (meine Übersetzung). Der Eintrag vom 7. Oktober in der Verlaufsdatei sagt, das Update «bringt den Gesamtanteil formalisierter Hauptresultate auf 300 / 719 = ~42 %» (meine Übersetzung).
Laut README ist 719 die Zahl der Manuskripte.
Der Formalisierungskatalog listet nach meiner Zählung vom 14. Oktober 173 Papers mit formalisiertem Hauptresultat. Eine Seite, die 300 und 173 miteinander in Einklang bringt, habe ich nicht gefunden.
Das ist kein Fehler. Es ist der Grund, zu fragen, was eine Prozentzahl eigentlich zählt.
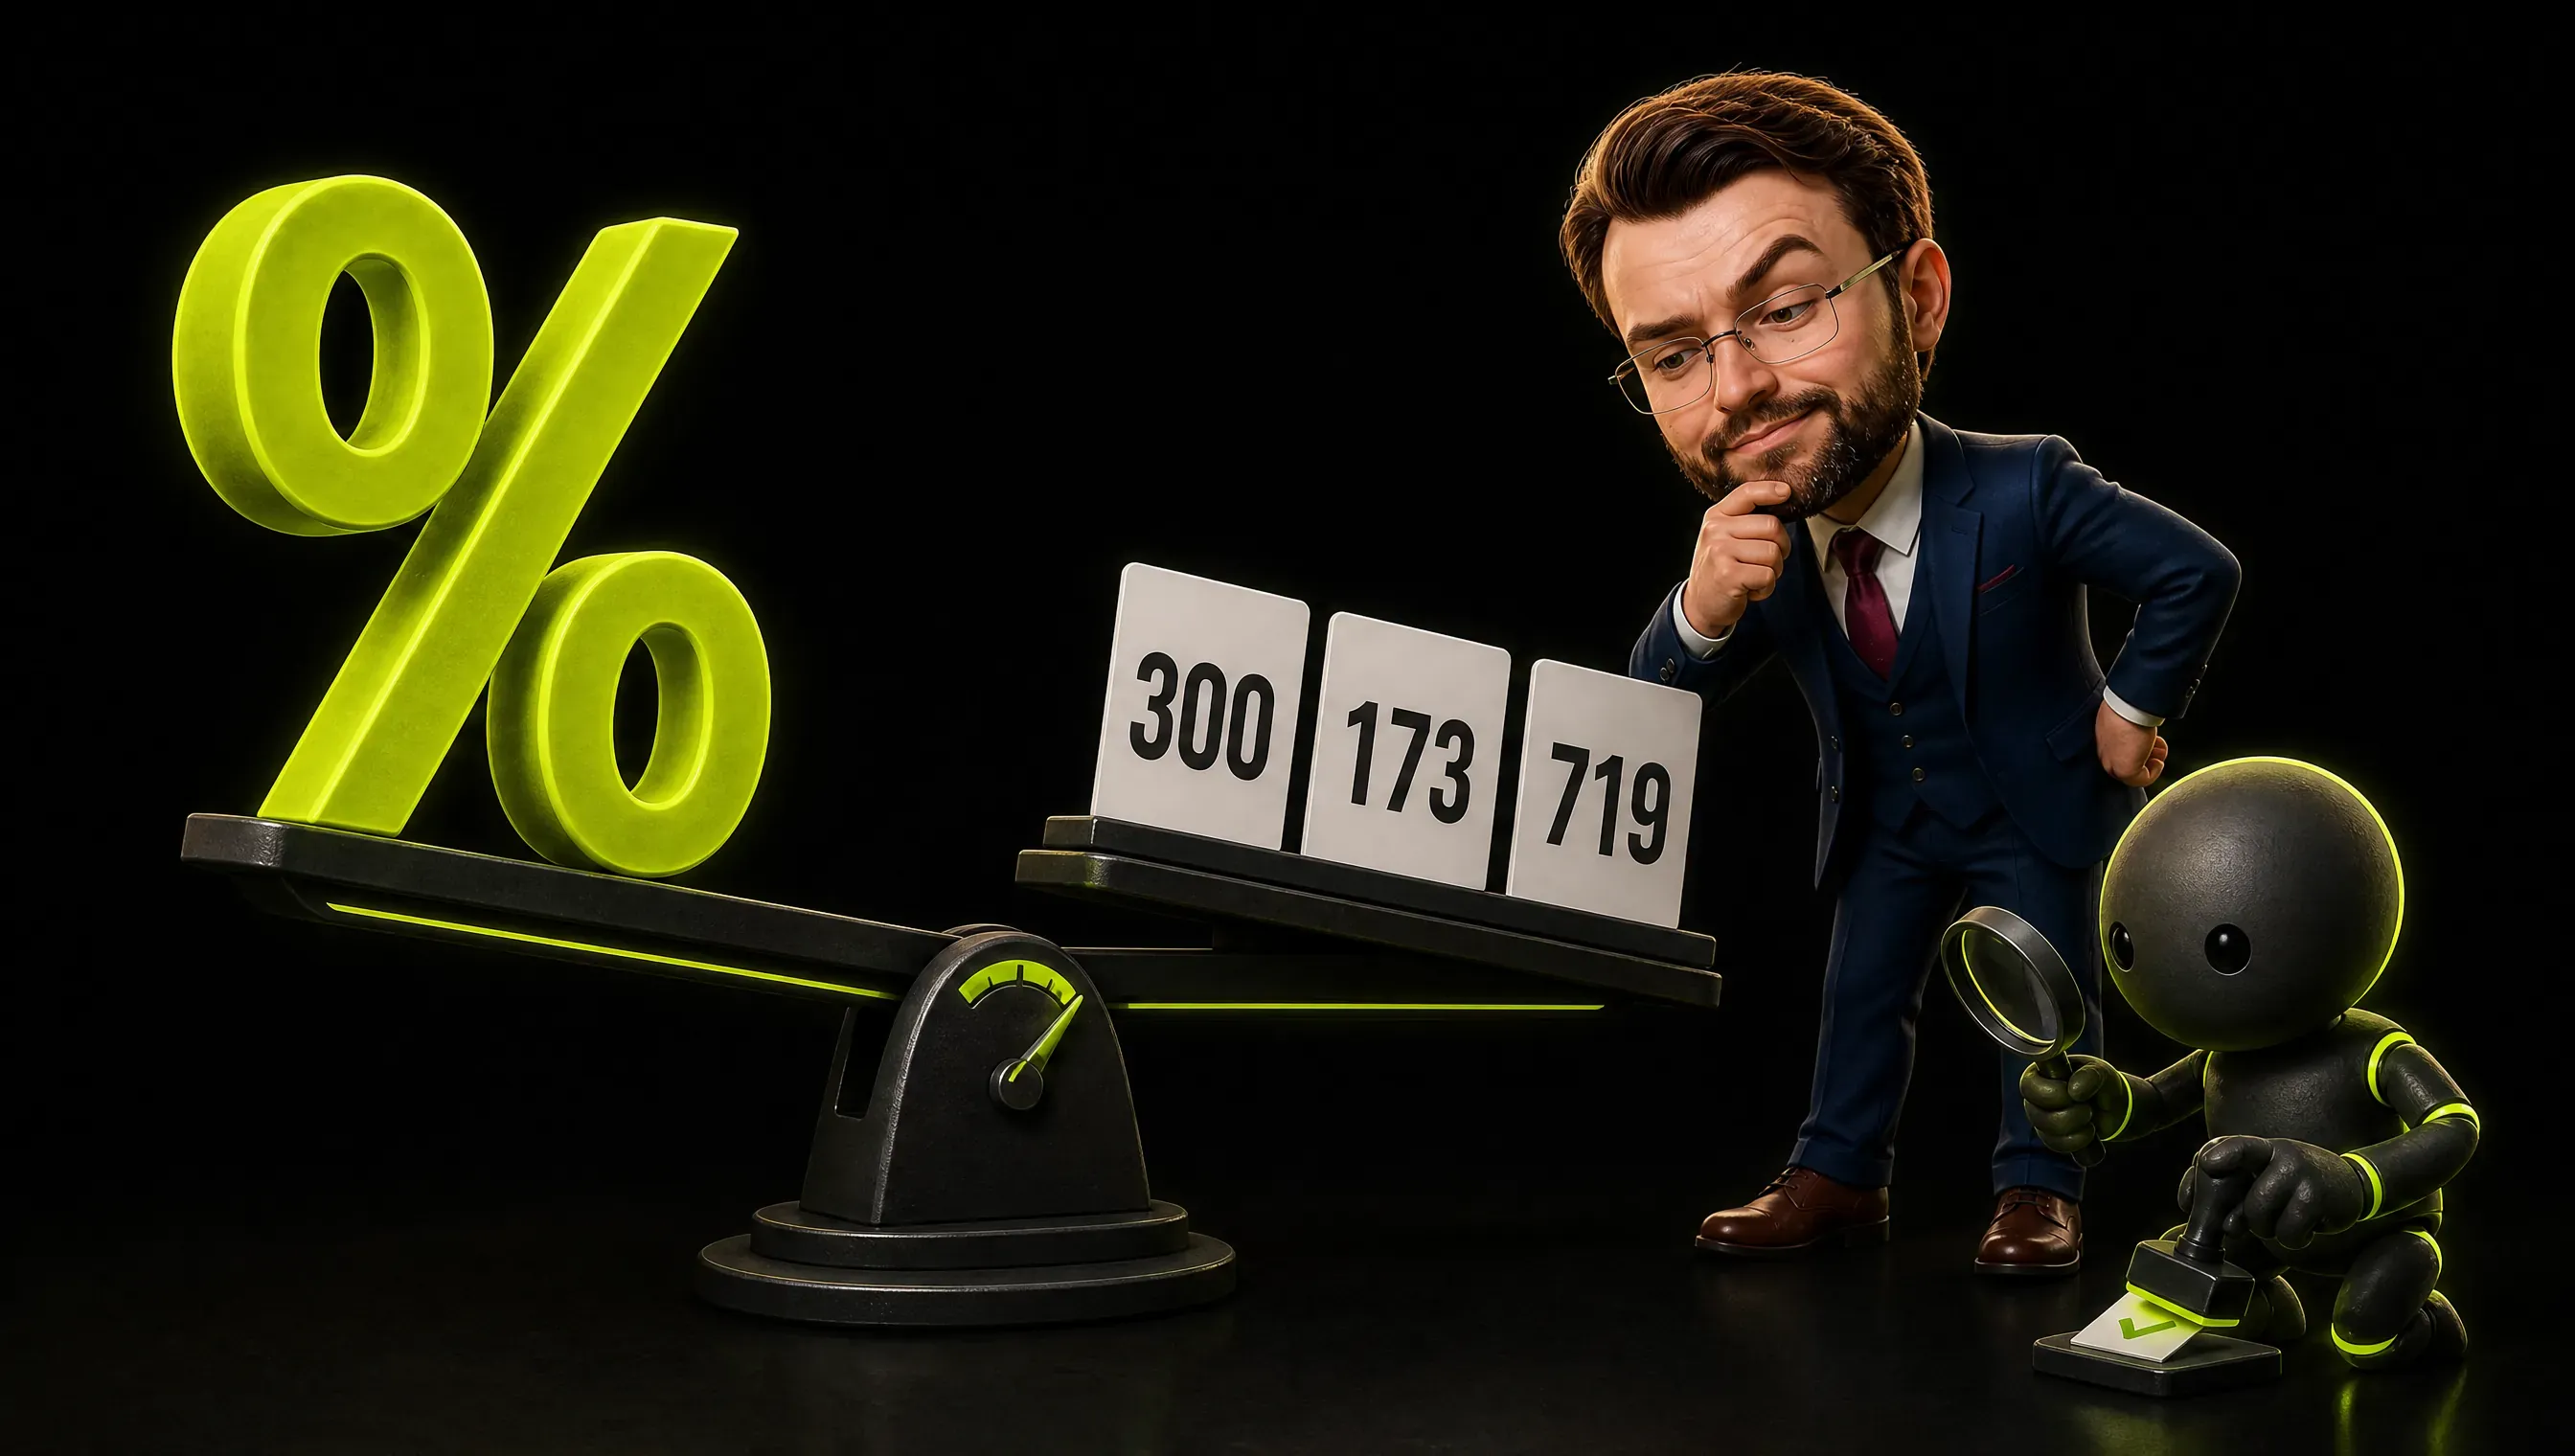
Ein Bericht, der «zu 90 % verifiziert» ist, kann 90 % der Aussagen meinen, 90 % der Seiten oder 90 % der Aussagen, die jemand zu prüfen für nötig hielt. Fragen Sie nach, welche davon gemeint ist, bevor Sie ihm vertrauen.
Was eine Lean-Prüfung leistet und was nicht
Lean ist, in OpenAIs Worten, «eine Programmiersprache, mit der mathematische Beweise von einem Computer geprüft werden können» (meine Übersetzung). Wenn ein Beweis in Lean formalisiert ist und Lean ihn akzeptiert, hat die Maschine verifiziert, dass die formale Aussage aus ihren Axiomen folgt.
Einfach gesagt: Die Maschine verifiziert die Aussage so, wie sie in der Maschine steht.
Ob diese Aussage dem entspricht, was das Paper behauptet, bleibt eine Frage für einen Menschen, der beides liest. Ich erkläre dieses Prinzip hier selbst. OpenAIs Seiten sagen es nicht in diesen Worten.
Ein grüner Haken einer Maschine heisst, dass die Maschine mit sich selbst einig war. Sie müssen trotzdem lesen, worüber sie sich einig war.
Ein Audit-Preprint auf arXiv von zwei Autoren bewertete 18 kapitelspezifische Gutachten zu den zehn Resultaten, die OpenAI am 1. August 2026 angekündigt hatte, einer früheren Serie als die Oktober-Sammlung. Es berichtet, dass «in den untersuchten Bewertungen kein bestätigter inhaltlicher mathematischer Fehler in einem Hauptresultat verbleibt, obwohl die Gutachtertiefe variiert und einige Abhängigkeiten nur teilweise geprüft sind» (meine Übersetzung).
Es markiert Kapitel 8, wo ein Fachgutachter eine «grosse Überarbeitung komprimierter analytischer Argumente» (meine Übersetzung) verlangte, und argumentiert, dass «das Vertrauen formale Prüfung, menschliche Rekonstruktion, unabhängige mathematische Verwendung und ein öffentliches Protokoll kombinieren sollte, das die Korrektur von Beweisen und Gutachten stützt» (meine Übersetzung). Ich zitiere es wegen der Methode, nicht als Urteil über die Mathematik.
Das Marketing hat kein Lean. Die meisten seiner Aussagen lassen sich nur an einer Quelle, einem Datum oder einer Person prüfen, und deshalb zählt das Protokoll mehr als das Werkzeug.
Auch der Prüfer kann sich irren
Das Audit enthält ein Detail, auf das ich immer wieder zurückkomme. In Kapitel 6 wurde ein scheinbarer Polaritätsfehler «zurückgezogen, nachdem ein bei der PDF-Extraktion verlorener Überstrich aus dem gesetzten Quelltext wiederhergestellt wurde» (meine Übersetzung).
Das Abstract sagt nicht, wer ihn gemeldet hat. Nach dieser Lesart kam das Problem aus der Textextraktion, nicht aus dem Beweis. Genau so kann ein Prüfschritt einen Fehler erfinden.
Meine eigene Pipeline hat eine Variante dieser Prüfung. Lese-Agenten ziehen Zitate aus gespeicherten Quellseiten, und ein Skript bestätigt, dass jedes Zitat wortgetreu auf der Seite steht. Bei der Recherche zu fünf aktuellen Artikeln hat es 295 Zitate akzeptiert und zwei abgelehnt, die nicht wortgetreu auf ihren Seiten standen.
Danach liest ein Faktenprüfer den Entwurf, und was er markiert, prüfe ich mit einer Textsuche nach, bevor ich es akzeptiere, weil lange Quellzeilen Fehlalarme ausgelöst haben. Ein skeptischer Reviewer läuft mit hohem Effort, und Übersetzungen bekommen einen zweiten Durchgang durch Muttersprachler, der echte Fehler gefunden hat. Ein Prüfer ist ein Werkzeug mit einer Fehlerquote, und die Fehlerquote braucht eine Prüfung.
Der Reviewer sollte nicht der Autor sein. In meinem CLAUDE.md-Artikel habe ich geschrieben, man solle die Verifikation in Prüfungen legen, an denen eine Maschine scheitern kann, und einen separaten Reviewer nur dort einsetzen, wo Geschmack oder viel auf dem Spiel steht, denn ein Modell bevorzugt tendenziell die eigenen Ergebnisse.
Warum Human in the Loop KI oft Theater ist
Der Begriff verspricht Sicherheit, also hören die Leute auf zu fragen, was sie bedeutet. Eine häufige Antwort lautet: «Ein Mensch schaut es sich an.» Das ist ein Slogan.
Hier meine Definition. Eine echte Schleife hat fünf Teile, und fehlt einer, haben Sie ein Ritual.
- Der Mensch sieht die Eingaben. Die Quellen, die Daten und die Anweisungen, nicht nur den Output. Eine Zusammenfassung, die Sie nicht zurückverfolgen können, können Sie nicht beurteilen.
- Es gibt eine Regel zum Ablehnen. Was würde einen Reviewer Nein sagen lassen? Wenn das niemand beantworten kann, geht jeder Output durch.
- Ablehnen hat eine Folge. Der Output wird neu gemacht, der Prozess korrigiert oder der Anwendungsfall gestoppt. Ein Ablehnen-Button, der nichts ändert, ist Dekoration.
- Eine Maschinenprüfung läuft zuerst. Code prüft Links, Zahlen, Zitate, Formate und Summen, damit der Mensch seine Aufmerksamkeit für das Urteil einsetzt.
- Es gibt ein Protokoll. Ein Log darüber, was geprüft wurde, von wem und was korrigiert wurde. OpenAIs Verlaufsdatei ist ein öffentliches Beispiel.
Eine Schleife mit nur einem Teil, einer Person, die hinschaut, wird zum Gummistempel, sobald eine Deadline und eine Warteschlange von 200 Einträgen dazukommen.
Eine Verifikationstabelle für Marketing-Output
«Die KI hat sich geirrt» verdeckt drei verschiedene Fehler. Falsch heisst, die Aussage ist unwahr: ein erfundenes Feature, eine ausgedachte Statistik, ein Zitat, das niemand gesagt hat. Veraltet heisst, sie war wahr, als das Modell sie lernte oder als die Quelle entstand: ein Preis, eine rechtliche Frist, eine Produktversion.
Unpassend heisst, die Aussage ist wahr und beantwortet eine andere Frage als die, die Sie gestellt haben. Die Zusammenfassung stimmt für das letzte Quartal, oder der Durchschnitt stimmt für die falsche Region. Das fängt nur ein Mensch ab, der die Frage kennt, deshalb braucht ein Reviewer das Briefing und nicht nur den Output.
Sie brauchen kein Lean. Sie brauchen für jede Art von Output die günstigste Prüfung, die laut scheitert.
| Output | Fehler, den sie abfängt | Maschinenprüfung | Menschliche Prüfung | Protokoll |
|---|---|---|---|---|
| Zahlen in einem Bericht | Falsch, unpassend | Summen aus dem Quellexport neu berechnen | Passt das zu dem, was passiert ist? | Name und Datum der Quelldatei |
| Zitate und Statistiken | Falsch | Exakten Text auf der gespeicherten Quellseite bestätigen | Ist die Quelle primär und aktuell? | Link und Abrufdatum |
| Links | Falsch, veraltet | Statuscode-Prüfung für jede URL | Sagen sie, was der Satz behauptet? | Link-Bericht |
| Rechts- oder Preisaussagen | Veraltet, falsch | Keine verlässliche Prüfung | Primärquelle lesen | Quelle, Datum, Reviewer |
| Übersetzungen | Unpassend | Struktur- und Zahlenparität gegenüber dem Original | Zweiter Durchgang durch Muttersprachler | Name des Reviewers und Datum |
| Bilder mit Text | Falsch | Keine verlässliche Prüfung | Jedes Wort lesen | Freigegebene Version |
| Kundenantworten | Unpassend | Liste verbotener Aussagen, Tonregeln | Stichprobe ziehen und lesen | Stichprobenprotokoll |
Manche Prüfungen haben keine Maschinenoption. Genau dort muss ein benannter Mensch die Antwort verantworten.
Ein ausgearbeitetes Beispiel: die Zusammenfassung der Konkurrenzpreise
Dieses Beispiel ist ausgedacht, suchen Sie also nicht nach diesen Konkurrenten. Ein Marketingteam bittet eine KI, die Preisseiten von vier Wettbewerbern für das Sales-Deck in einer Tabelle zusammenzufassen.
Was die KI liefert: eine saubere Tabelle mit Tarifnamen, Monatspreisen und drei Kernfeatures pro Tarif.
Maschinenprüfung: Ein Skript ruft jede Preisseite ab, speichert eine Kopie und bestätigt, dass jeder Preis aus der Tabelle auf der gespeicherten Seite neben dem Tarifnamen steht. Zwei Preise fallen durch. Ein Wettbewerber zeigt standardmässig Jahrespreise, und die KI hat sie als Monatspreise gemeldet.
Menschliche Prüfung: Eine Person, die das Verkaufsgespräch kennt, schaut sich die Tabelle an und bemerkt, dass die Features einen Premium-Tarif des einen Anbieters mit einem Einstiegstarif des anderen vergleichen. Das ist ein Passungsfehler, und kein Skript würde ihn finden.
Protokoll: Die gespeicherten Seiten, das Datum und der Name des Reviewers kommen in den Ordner neben dem Deck. Wenn ein Wettbewerber seine Preise ändert, weiss das Team, welche Folie veraltet ist.
Ein Skript und ein Reviewer schaffen das bei vier Seiten plausibel in einer Stunde. Ihr erster Durchlauf wird länger dauern.
So schreiben Sie eine Ablehnungsregel
Eine Ablehnungsregel ist ein Satz, den ein Reviewer ohne Diskussion anwenden kann. Diese hier funktionieren im Marketing:
- Lehnen Sie jede Zahl ab, die nicht im Quellexport steht.
- Lehnen Sie jedes Zitat ab, das nicht wortgetreu auf der gespeicherten Seite steht.
- Lehnen Sie jede Aussage zu Recht, Preis oder Verfügbarkeit ohne Primärquelle und Datum ab.
- Lehnen Sie jeden Satz an Kunden ab, der ein Ergebnis, eine Frist oder einen Rabatt verspricht.
- Lehnen Sie jede Übersetzung ab, deren Zahlen vom Original abweichen.
Schreiben Sie die Liste einmal, legen Sie sie dorthin, wo der Reviewer arbeitet, und aktualisieren Sie sie, wenn ein Fehler durchrutscht. Jeder durchgerutschte Fehler wird zu einer neuen Regel. Das ist ein Prozessvorschlag, keine Rechtsberatung.
Was ich aus OpenAIs Repository übernehmen würde
Ohne die Mathematik bleiben drei Gewohnheiten, die sich zu kopieren lohnen.
Eine Verlaufsdatei mit Begründungen. Jeder Rückzug nennt die Papers und die Ursache, und die Überarbeitungen sind danach gruppiert, was repariert wurde. Führen Sie für KI-geschriebene Inhalte ein Änderungsprotokoll, das sagt, was korrigiert wurde und warum, nicht nur, dass sich etwas geändert hat.
Alte Versionen bleiben erreichbar. OpenAI schreibt: «Korrekturen und Überarbeitungen werden als neue Versionen festgehalten, wobei zuvor veröffentlichte Versionen zugänglich bleiben» (meine Übersetzung). Auf diesem Blog trägt jeder Artikel ein Datum, und wenn ich einen veröffentlichten Beitrag ändere, setze ich das Aktualisierungsdatum neu.
Hinweise dort, wo der Zweifel sitzt. OpenAI sagt, welche Resultate formalisiert sind und welche Probleme haben könnten. Tun Sie dasselbe in Ihren Berichten: Markieren Sie die Zahlen, die neu berechnet wurden, und die, die von der KI ungeprüft übernommen wurden.
Wenn Output billig ist, ist die Prüfung der Engpass
OpenAI sagt, ein durchschnittliches Resultat habe rund drei Stunden ChatGPT-Pro-Denkzeit gebraucht. Was die Prüfung eines Resultats kostet, sagt es nicht, und ich würde nicht raten.
Die Marketingversion ist leichter zu sehen. Eine KI kann 50 Produktbeschreibungen in einer Minute schreiben, und zu bestätigen, dass keine ein Feature erfindet, ist keine Minute Arbeit.
KI im Marketing multipliziert, was Ihre besten Leute tun, und verschiebt zugleich den Engpass vom Herstellen zum Prüfen. Ein Team, das für die Prüfung kein Budget einplant, hat keine Zeit gespart. Es hat das Risiko zum Kunden verlagert.
Ein Verifikations-Audit in 30 Minuten
Führen Sie das diese Woche an einem KI-Workflow durch.
- Wählen Sie einen wiederkehrenden Output, der Kunden oder Entscheidungen erreicht: einen Bericht, eine Antwortvorlage, einen Produktfeed.
- Schreiben Sie auf, wer ihn heute prüft und was genau diese Person ansieht. Lautet die Antwort «sie lesen ihn», machen Sie weiter.
- Listen Sie die fünf Teile einer echten Schleife auf und markieren Sie, welche existieren.
- Ergänzen Sie die günstigste Maschinenprüfung aus der Tabelle oben.
- Schreiben Sie die Ablehnungsregel in einem Satz.
- Starten Sie ein Log mit einer Zeile pro Durchlauf: Datum, Prüfer, was korrigiert wurde.
- Sehen Sie das Log in einem Monat durch und verschieben Sie die erste manuelle Prüfung in Code.
Häufig gestellte Fragen
Was bedeutet Human in the Loop bei KI?
Es heisst, dass ein Mensch am KI-Prozess teilnimmt, meist indem er Output prüft oder freigibt. Es funktioniert nur, wenn die Person die Eingaben sieht, eine Regel zum Ablehnen und eine Möglichkeit hat, auf eine Ablehnung zu reagieren, und wenn ein Protokoll existiert.
Reicht Human in the Loop, um KI-Output sicher zu machen?
Nicht allein. Ergänzen Sie Maschinenprüfungen für das, was Code verifizieren kann, einen separaten Reviewer für das Urteil und ein Log, mit dem Sie die Aufzeichnung später korrigieren können.
Kann KI ihre eigene Arbeit prüfen?
Sie kann manche Fehler entdecken, und sie neigt dazu, die eigenen Resultate zu bevorzugen. Setzen Sie einen anderen Reviewer ein, ein Bewertungsraster und Prüfungen, die eine Maschine nicht bestehen kann.
Sind OpenAIs Mathe-Resultate bewiesen?
Das kann ich Ihnen nicht sagen, und darum geht es in diesem Artikel nicht. OpenAI sagt, die Sammlung enthalte «Resultate in unterschiedlichen Stadien der Verifikation», nach eigener Zählung seien rund 42 % der Hauptresultate in Lean formalisiert, und einige unformalisierte Resultate «könnten Probleme haben» (meine Übersetzung). Ob die Mathematik stimmt, ist eine Frage für Mathematiker.
Wie verifiziere ich KI-Output bei der Arbeit?
Beginnen Sie mit einem Workflow. Ergänzen Sie eine Maschinenprüfung, eine Ablehnungsregel und ein Log, und setzen Sie eine benannte Person auf die Prüfungen, die Code nicht leisten kann.
Mein Urteil
Ein Human-in-the-Loop-KI-Prozess ist nur so gut wie seine Fähigkeit, Nein zu sagen. Eine Schleife, die nicht ablehnen kann, ist ein Ritual.
Die Karte:
- Zeigen Sie dem Menschen die Eingaben.
- Schreiben Sie die Ablehnungsregel.
- Lassen Sie das Ablehnen etwas verändern.
- Lassen Sie zuerst Maschinenprüfungen laufen.
- Führen Sie ein Protokoll, und lassen Sie es Korrekturen zeigen.
Diese Seite gibt den Stand von OpenAIs Repository am 14. Oktober 2026 wieder. Die Sammlung wird aktualisiert, prüfen Sie also die Verlaufsdatei, bevor Sie sich auf eine Zahl verlassen.
Wollen Sie eine zweite Meinung dazu, wie Ihr Team KI-Output prüft, mit einer Checkliste, die zu Ihren Workflows passt? Nehmen Sie Kontakt auf.