Human in the loop ИИ: чему математика OpenAI учит проверке машинной работы
Human in the loop ИИ превращается в театр, если проверка не умеет говорить «нет». Чему релиз математики OpenAI и его исправления учат маркетологов в проверке ИИ

Human in the loop ИИ звучит надёжно, пока не спросите, что именно проверяет человек. 6 октября OpenAI выложила на GitHub сотни математических рукописей, созданных внутренней моделью.
7 октября в её файле истории появилась запись: «знаковая ошибка делает недействительным аргумент о сокращении стабилизационного следа и конструкцию, которой пользовались две зависимые статьи» (перевод мой). Три рукописи отозвали, ещё четырнадцать исправили.
Файл истории показывает, как выглядит видимое исправление. Запись называет ошибку, статьи, до которых она дошла, и то, что с ними сделали.
Я не могу сказать, верны ли остальные результаты. Могу сказать другое: эту запись маркетолог может скопировать как часть процесса.
Теперь спросите себя, как выглядит ваша версия. На этой неделе ваш ИИ написал отчёт по кампании. Кто его проверил, чем и где запись об этом?
Я не математик и не могу судить о доказательствах. Зато я могу прочитать процесс вокруг них.
Факты ниже взяты из анонса OpenAI, README репозитория, файла истории, каталога формализации и обзора, а также из одного аудита на arXiv. Цитаты и цифры я сверил с сохранёнными копиями этих страниц 14 октября 2026 года.
Главное коротко
- OpenAI отозвала три рукописи 7 октября, на следующий день после публикации: знаковая ошибка сломала аргумент, которым пользовались две другие статьи. Ещё 14 она исправила и записала причины.
- Две цифры о формализации не сходятся с первого взгляда. README говорит, что формализовано около 42% главных результатов, а файл истории даёт 300 из 719. При этом файл каталога перечисляет 173 статьи. Репозиторий не объясняет, как эти числа связаны.
- Машинная проверка подтверждает утверждение в том виде, в каком оно записано в машине. Говорит ли это утверждение то, что заявляет статья, остаётся вопросом к человеку.
- Проверяющие тоже ошибаются. Аудит на arXiv более раннего набора OpenAI фиксирует кажущуюся ошибку, которую сняли, когда из исходника восстановили потерянную черту над буквой.
- Human in the loop ИИ работает при пяти условиях: человек видит исходные данные, есть правило отказа, у отказа есть последствие, сначала работает машинная проверка и ведётся запись.
- Когда результат дёшев, узким местом становится проверка. Закладывайте на неё бюджет в первую очередь.
Что выпустила OpenAI
Анонс OpenAI датирован 6 октября 2026 года. В репозитории лежат «математические рукописи и сопутствующие доказательные артефакты, созданные внутренней моделью OpenAI» (перевод мой). README насчитывает по состоянию на 14 октября 719 рукописей в 372 семействах, действует лицензия Apache-2.0.
Что OpenAI сообщает о работе:
- Модель на 14 октября не выпущена. «Подавляющее большинство результатов получено по одной и той же процедуре с помощью невыпущенной внутренней модели OpenAI» (перевод мой).
- Ей поставили около 4000 задач. Каталог это то, что осталось после «требования соответствующего уровня значимости» (перевод мой).
- На каждый результат ушло в среднем около трёх часов вычислений ChatGPT Pro. Это на результат, а не на задачу.
- OpenAI консультировалась с независимой Advisory Group on Mathematics and Artificial Intelligence при Институте перспективных исследований о том, как поделиться этой работой. В тексте не сказано, что группа проверяла результаты.
Громкие заявления внушительны. Семейство 003 утверждает, что у каждой L-функции Дирихле, включая дзета-функцию Римана, нет нулей с вещественной частью выше 7/8, и обзорный PDF называет это «решением квази-гипотезы Римана» (перевод мой). Это не гипотеза Римана.
Семейство 004 утверждает, что нет алгоритма, который решает, есть ли у многочлена с целыми коэффициентами от произвольного числа переменных рациональный нуль, и подаёт это как решение десятой проблемы Гильберта над рациональными числами. Семейство 107 заявляет показатель умножения матриц не выше 9/4 над рациональными числами.
Я передаю это как заявления. Подтверждать их или сомневаться в них должен не я.
Среди трёх отозванных статей есть одна под названием «Рациональная гипотеза Ходжа для произведений K3-поверхностей» (перевод мой), так что исправление коснулось крупной именной гипотезы. README необычно конкретно говорит о том, что не проверено.
«Эта коллекция включает результаты на разных стадиях проверки. Не ко всем прилагаются формализации в Lean» (перевод мой).
И дальше: «В некоторых неформализованных результатах могут быть проблемы. Мы постараемся быстро исправлять любые такие проблемы» (перевод мой).
Два счёта, которые не сходятся
README даёт один счёт: «в репозитории формализовано ~42% главных результатов» (перевод мой). Запись в файле истории от 7 октября говорит, что обновление «доводит общую долю формализованных главных результатов до 300 / 719 = ~42%» (перевод мой).
README указывает, что 719 это число рукописей. Каталог формализации перечисляет 173 статьи с формализованным главным результатом, по моему подсчёту на 14 октября. Страницы, которая примиряет 300 и 173, я не нашёл.
Это не ошибка. Это повод спросить, что именно считает процент.
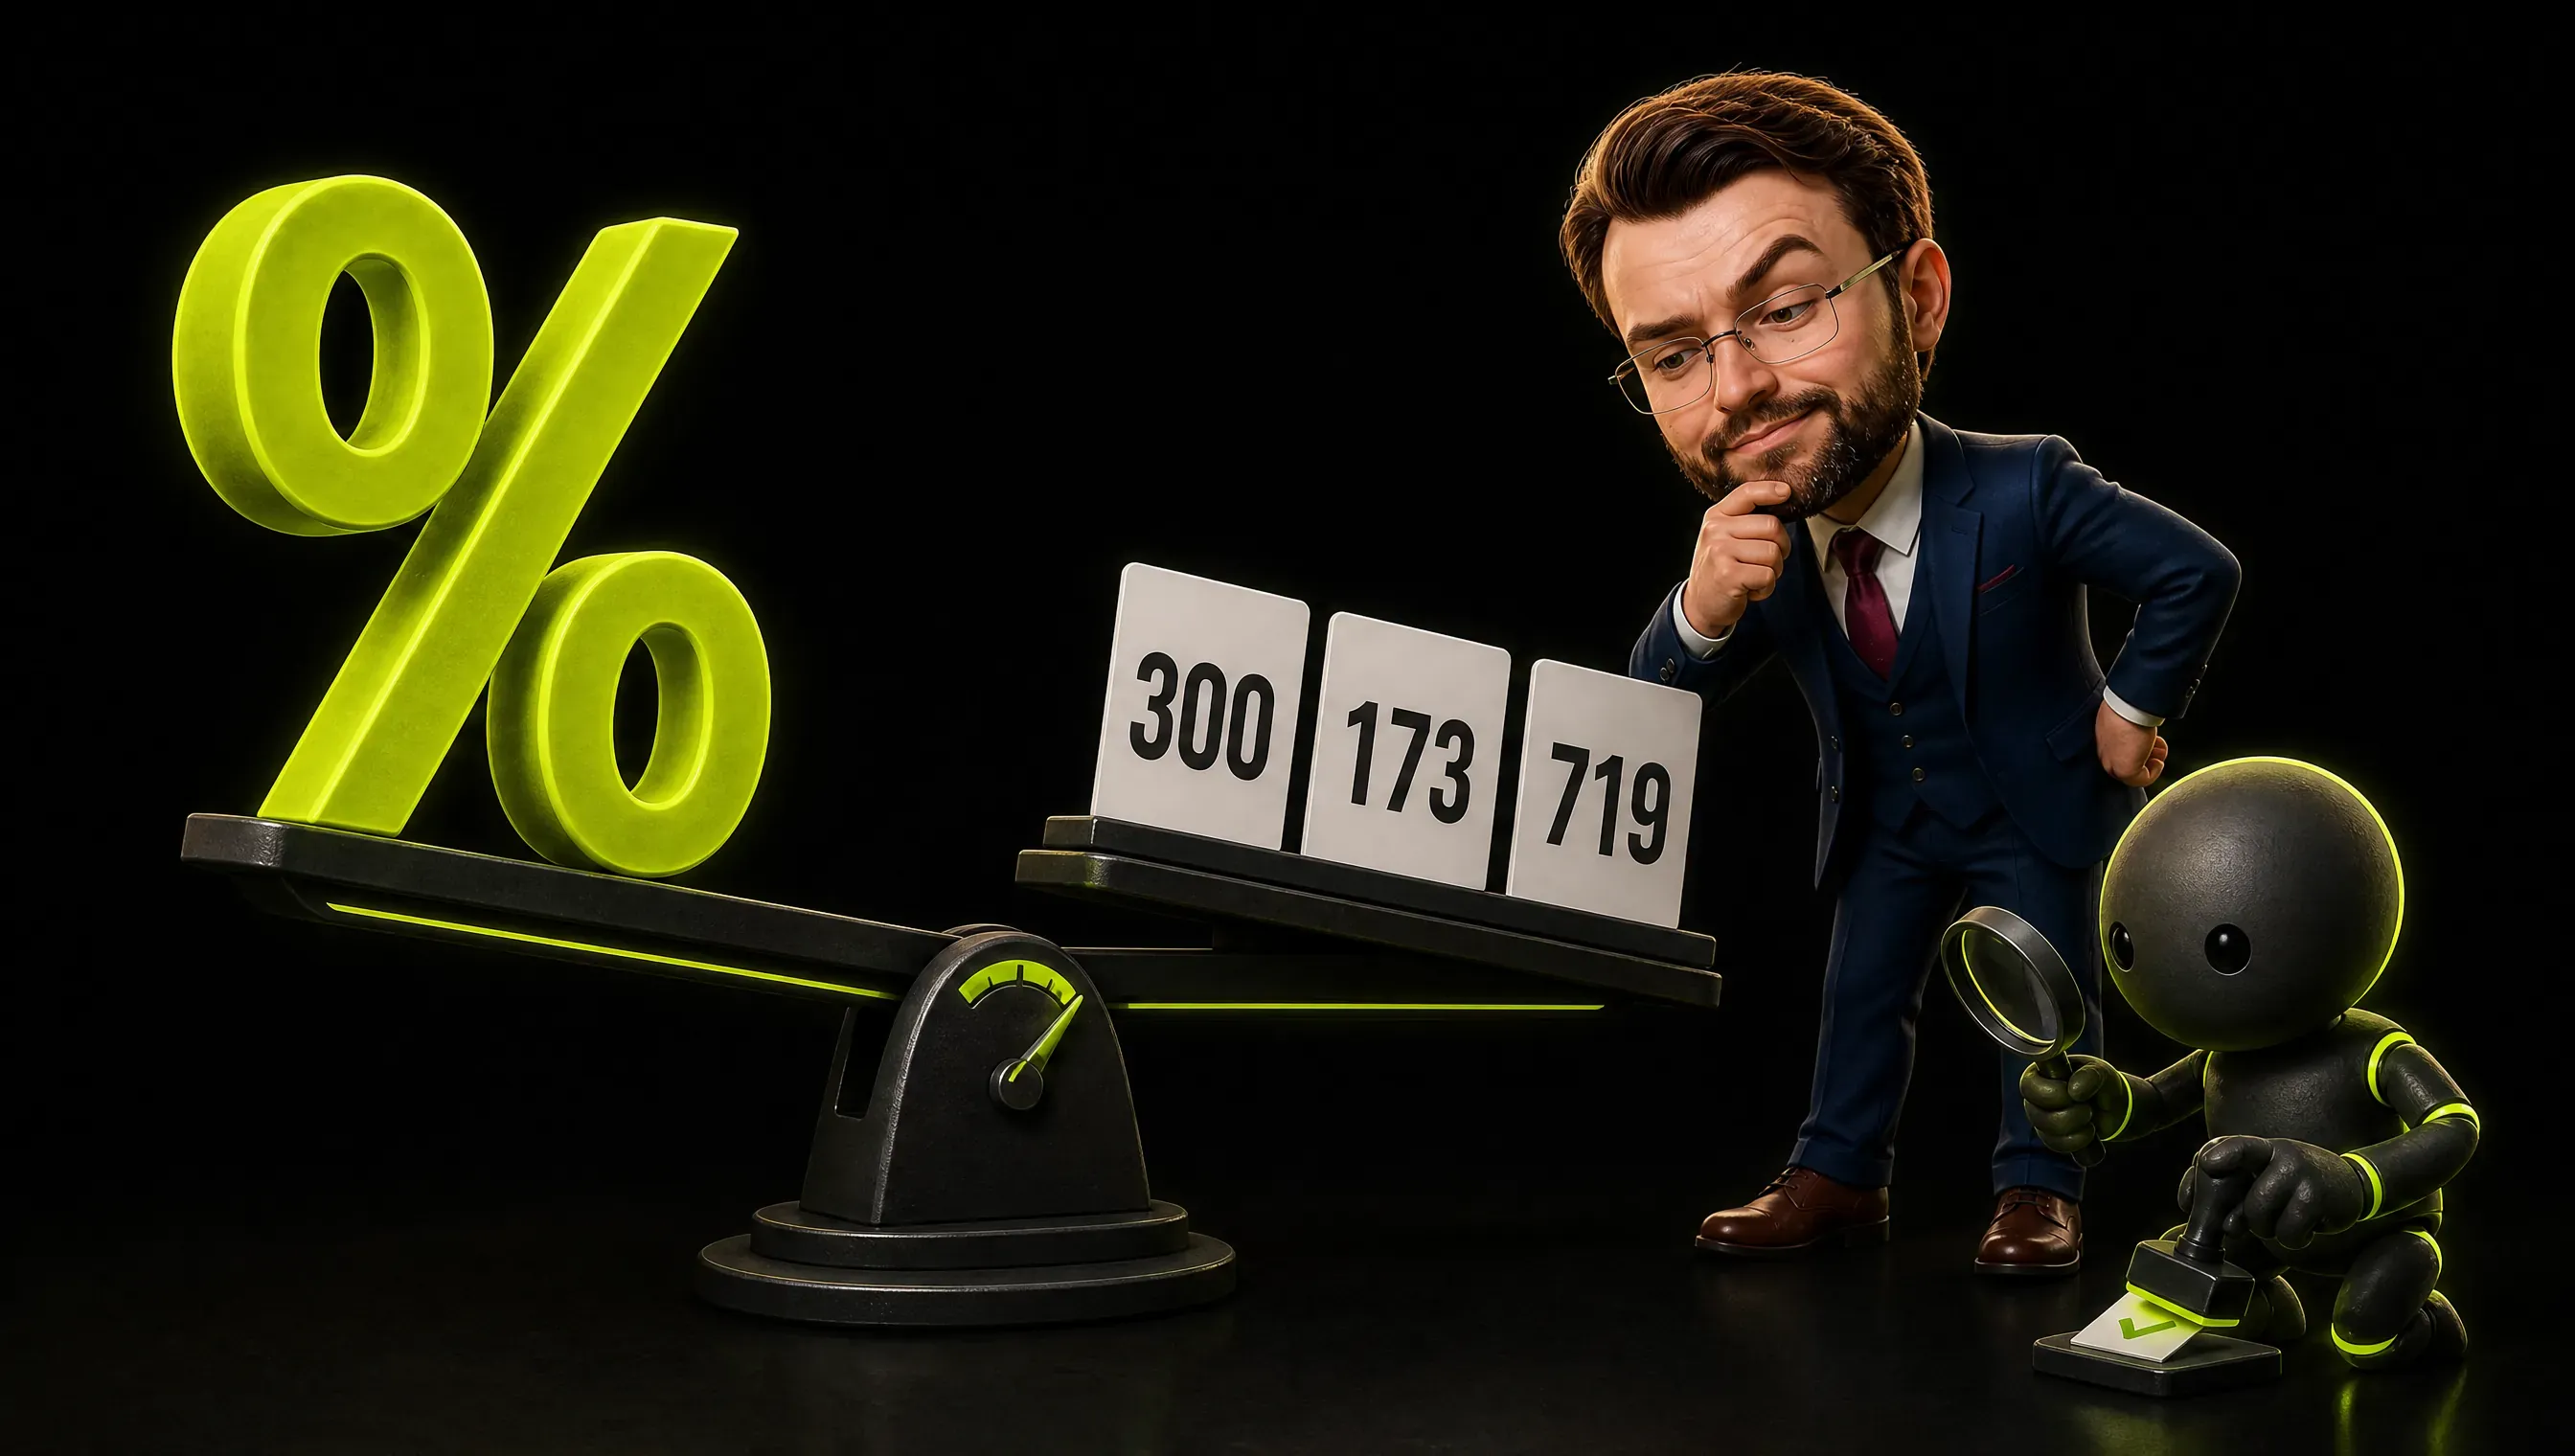
Отчёт, «проверенный на 90%», может означать 90% утверждений, 90% страниц или 90% утверждений, которые кому-то пришло в голову проверить. Спросите, какое из трёх, прежде чем ему верить.
Что делает проверка в Lean и чего не делает
Lean, по словам OpenAI, это «язык программирования, позволяющий проверять математические доказательства на компьютере» (перевод мой). Когда доказательство формализовано в Lean и Lean его принимает, машина подтвердила, что формальное утверждение следует из своих аксиом.
Проще говоря, машина проверяет утверждение в том виде, в каком оно записано в машине.
Говорит ли это утверждение то, что заявляет статья, по-прежнему вопрос к человеку, который читает оба текста. Этот принцип объясняю здесь я. В материалах OpenAI он такими словами не сформулирован.
Зелёная галочка от машины означает, что машина согласилась сама с собой. Читать, с чем именно она согласилась, всё равно вам.
Препринт-аудит на arXiv двух авторов оценил 18 рецензий по главам на десять результатов, объявленных OpenAI 1 августа 2026 года, то есть более раннего набора, чем октябрьская коллекция. Он сообщает: «в рассмотренных оценках не осталось подтверждённой существенной математической ошибки в главном результате, хотя глубина рецензирования различается, а некоторые зависимости проверены лишь частично» (перевод мой).
Он отмечает главу 8: специалист просил «серьёзной переработки сжатых аналитических аргументов», и аудит утверждает, что «уверенность должна складываться из формальной проверки, человеческого воссоздания, независимого математического использования и публичной записи, позволяющей исправлять и доказательства, и рецензии» (перевод мой). Я ссылаюсь на него ради метода, а не как на вердикт о математике.
В маркетинге нет Lean. Большинство его утверждений можно проверить только по источнику, дате или человеку, поэтому запись важнее инструмента.
Проверяющий тоже может ошибаться
В аудите есть деталь, к которой я постоянно возвращаюсь. В главе 6 кажущаяся ошибка полярности была «снята после того, как черта над буквой, потерянная при извлечении из PDF, была восстановлена из типографского исходника» (перевод мой).
В аннотации не сказано, кто на неё указал. По моему прочтению, проблема возникла при извлечении текста, а не в доказательстве. Именно так шаг проверки может выдумать ошибку.
В моём собственном конвейере есть версия такой проверки. Агенты-читатели извлекают цитаты из сохранённых страниц источников, а скрипт подтверждает, что каждая цитата встречается на странице слово в слово. Для исследования к пяти недавним статьям он принял 295 цитат и отклонил две, которых не оказалось на их страницах слово в слово.
Затем черновик читает фактчекер, и то, что он отметил, я перепроверяю текстовым поиском, прежде чем принять, потому что длинные строки источников давали ложные тревоги. Скептический рецензент работает на высоком уровне усилий, а переводы проходят второе чтение носителем языка, которое находило настоящие ошибки. Проверяющий это инструмент с долей ошибок, и эту долю тоже нужно проверять.
Рецензентом не должен быть автор. В своей статье про CLAUDE.md я писал, что проверку нужно строить на «проверках, которые машина может провалить», а там, где важны вкус или ставки, подключать отдельного рецензента, «потому что модель склонна предпочитать собственные результаты» (перевод мой).
Почему human in the loop ИИ так часто театр
Фраза обещает безопасность, поэтому люди перестают спрашивать, что она значит. Типичный ответ: «человек на это смотрит». Это лозунг.
Вот определение, которым пользуюсь я. У настоящего контура пять частей, и если не хватает хотя бы одной, у вас ритуал.
- Человек видит исходные данные. Источники, данные и инструкции, а не только результат. Нельзя оценить резюме, которое нельзя проследить до источника.
- Есть правило отказа. После чего рецензент скажет «нет»? Если никто не может ответить, пройдёт любой результат.
- У отказа есть последствие. Результат переделывают, чинят процесс или останавливают сценарий. Кнопка «отклонить», которая ничего не меняет, это декорация.
- Сначала работает машинная проверка. Код проверяет ссылки, числа, цитаты, форматы и итоги, чтобы человек тратил внимание на суждение.
- Есть запись. Журнал того, что проверяли, кто и что исправили. Файл истории OpenAI это публичный пример.
Контур из одной части, где есть лишь человек, который смотрит, превращается в резиновый штамп, как только добавляются дедлайн и очередь из 200 позиций.
Таблица проверки маркетингового результата
За фразой «ИИ ошибся» прячутся три разных сбоя. Неверно значит, что утверждение ложно: выдуманная функция, вымышленная статистика, цитата, которой никто не говорил. Устарело значит, что оно было верно, когда модель училась или когда писали источник: цена, юридический срок, версия продукта.
Не о том значит, что утверждение верно, но отвечает на другой вопрос, чем тот, что вы задали. Резюме точно для прошлого квартала или среднее точно, но по другому региону. Это заметит только человек, который знает вопрос, поэтому рецензенту нужен бриф, а не только результат.
Lean вам не нужен. Вам нужна самая дешёвая проверка, которая громко проваливается для каждого типа результата.
| Результат | Какой сбой ловит | Машинная проверка | Проверка человеком | Запись |
|---|---|---|---|---|
| Числа в отчёте | Неверно, не о том | Пересчитать итоги по исходной выгрузке | Совпадает ли это с тем, что было на деле? | Имя файла-источника и дата |
| Цитаты и статистика | Неверно | Подтвердить точный текст на сохранённой странице источника | Источник первичный и актуальный? | Ссылка и дата обращения |
| Ссылки | Неверно, устарело | Проверка кода ответа для каждого URL | Говорят ли они то, что утверждает предложение? | Отчёт по ссылкам |
| Юридические и ценовые утверждения | Устарело, неверно | Надёжной нет | Прочитать первичный источник | Источник, дата, рецензент |
| Переводы | Не о том | Паритет структуры и чисел с оригиналом | Второе чтение носителем языка | Имя рецензента и дата |
| Изображения с текстом | Неверно | Надёжной нет | Прочитать каждое слово | Утверждённая версия |
| Ответы клиентам | Не о том | Список запрещённых утверждений, правила тона | Выборка и чтение | Журнал выборки |
У некоторых проверок нет машинного варианта. Это проверки, где ответ должен закреплять за собой конкретный человек.
Пример на практике: сводка цен конкурентов
Этот пример выдуманный, так что не ищите этих конкурентов. Маркетинговая команда просит ИИ свести страницы цен четырёх конкурентов в одну таблицу для презентации отдела продаж.
Что возвращает ИИ: аккуратную таблицу с названиями тарифов, ежемесячными ценами и тремя главными функциями на тариф.
Машинная проверка: скрипт загружает каждую страницу цен, сохраняет копию и подтверждает, что каждая цена из таблицы встречается на сохранённой странице рядом с названием тарифа. Две цены не проходят. Один конкурент по умолчанию показывает годовые цены, а ИИ выдал их за месячные.
Проверка человеком: человек, который знает разговор с покупателем, смотрит на таблицу и замечает, что функции сравнивают премиальный тариф одного поставщика с базовым тарифом другого. Это «не о том», и ни один скрипт этого не найдёт.
Запись: сохранённые страницы, дата и имя рецензента лежат в папке рядом с презентацией. Когда конкурент меняет цены, команда знает, какой слайд устарел.
Скрипт и один рецензент вполне могут справиться с этим за час на четыре страницы. Первый запуск займёт больше.
Как написать правило отказа
Правило отказа это одно предложение, которое рецензент может применить без споров. Для маркетинга подходят такие:
- Отклоняйте любую цифру, которой нет в исходной выгрузке.
- Отклоняйте любую цитату, которой нет слово в слово на сохранённой странице.
- Отклоняйте любое утверждение о законе, цене или наличии без первичного источника и даты.
- Отклоняйте любое предложение для клиента, которое обещает результат, срок или скидку.
- Отклоняйте любой перевод, в котором числа отличаются от оригинала.
Напишите список один раз, положите там, где работает рецензент, и дополняйте, когда ошибка проскочила. Каждая проскочившая ошибка становится новым правилом. Это предложение по процессу, а не юридическая консультация.
Что я бы скопировал из репозитория OpenAI
Уберите математику, и в репозитории останутся три привычки, которые стоит перенять.
Файл истории с причинами. Каждый отзыв называет статьи и причину, а исправления сгруппированы по тому, что именно починили. Для контента, написанного ИИ, ведите журнал изменений, который говорит, что исправили и почему, а не только то, что что-то изменилось.
Старые версии остаются доступными. OpenAI пишет: «Исправления и пересмотры будут записываться как новые версии, а ранее выпущенные версии останутся доступными» (перевод мой). В этом блоге у каждой статьи есть дата, а когда я меняю опубликованный материал, я обновляю дату изменения.
Оговорки там, где живёт сомнение. OpenAI говорит, какие результаты формализованы, а в каких могут быть проблемы. Делайте так же в своих отчётах: помечайте числа, которые пересчитаны, и те, что взяты у ИИ на веру.
Когда результат дёшев, узким местом становится проверка
OpenAI говорит, что средний результат занял около трёх часов размышлений ChatGPT Pro. Сколько занимает проверка одного, она не сообщает, и гадать я не стал бы.
Маркетинговую версию увидеть проще. ИИ пишет 50 описаний товаров за минуту, а убедиться, что ни одно не выдумывает функцию, за минуту не получится.
ИИ в маркетинге умножает то, что делают ваши лучшие люди, и заодно переносит узкое место с производства на проверку. Команда, которая не закладывает бюджет на проверку, время не сэкономила. Она переложила риск на клиента.
30-минутный аудит проверки
Прогоните это на одном ИИ-процессе на этой неделе.
- Выберите один повторяющийся результат, который доходит до клиентов или решений: отчёт, шаблон ответа, товарный фид.
- Запишите, кто проверяет его сегодня и что именно смотрит. Если ответ «читают», идите дальше.
- Перечислите пять частей настоящего контура и отметьте, какие есть.
- Добавьте самую дешёвую машинную проверку из таблицы выше.
- Напишите правило отказа одним предложением.
- Заведите журнал с одной строкой на запуск: дата, проверяющий, что исправлено.
- Просмотрите журнал через месяц и перенесите первую ручную проверку в код.
Частые вопросы
Что такое human in the loop в ИИ?
Это участие человека в процессе ИИ, обычно в виде проверки или утверждения результата. Работает это только тогда, когда человек видит исходные данные, у него есть правило отказа и способ действовать после отказа, а запись ведётся.
Достаточно ли human in the loop, чтобы результат ИИ был безопасным?
Само по себе нет. Добавьте машинные проверки для того, что может проверить код, отдельного рецензента для суждения и журнал, позволяющий позже исправить запись.
Может ли ИИ проверять собственную работу?
Какие-то ошибки он ловит, но склонен отдавать предпочтение своим результатам. Используйте другого рецензента, критерии оценки и проверки, которые машина может провалить.
Доказаны ли математические результаты OpenAI?
Не могу сказать, и эта статья не об этом. OpenAI сообщает, что в коллекции есть «результаты на разных стадиях проверки», что по её подсчёту около 42% главных результатов формализованы в Lean и что в некоторых неформализованных результатах «могут быть проблемы» (перевод мой). Верна ли математика, решать математикам.
Как проверять результат ИИ на работе?
Начните с одного процесса. Добавьте машинную проверку, правило отказа и журнал и назначьте конкретного человека на те проверки, которые код сделать не может.
Мой вердикт
Процесс human in the loop ИИ хорош ровно настолько, насколько он умеет говорить «нет». Контур, который не может отклонить, это ритуал.
Памятка:
- Покажите человеку исходные данные.
- Напишите правило отказа.
- Сделайте так, чтобы отказ что-то менял.
- Сначала запускайте машинные проверки.
- Ведите запись и пусть она показывает исправления.
Эта страница отражает состояние репозитория OpenAI на 14 октября 2026 года. Коллекция обновляется, так что загляните в файл истории, прежде чем полагаться на какую-либо цифру.
Нужен взгляд со стороны на то, как ваша команда проверяет результаты ИИ, и чек-лист под ваши процессы? Напишите мне.