Anthropic удалила более 80% промпта Claude Code. Я сократил свой CLAUDE.md на 79%
Контекстная инженерия после Claude 5: Anthropic удалила более 80% промпта Claude Code. Что я вырезал, вынес и оставил в своём CLAUDE.md на практике, и почему.
24 июля Anthropic сообщила, что убрала более 80% системного промпта Claude Code для своих новейших моделей. Результаты в кодинге не просели. Большинство советов по контекстной инженерии (context engineering), которые вы читали в прошлом году, за одну ночь стали сомнительными.
Если вы ведёте файл CLAUDE.md, это должно вас смутить. Теперь Anthropic называет «мифами» значительную часть старых советов: давайте правила, давайте примеры, выкладывайте всё сразу, повторяйтесь.
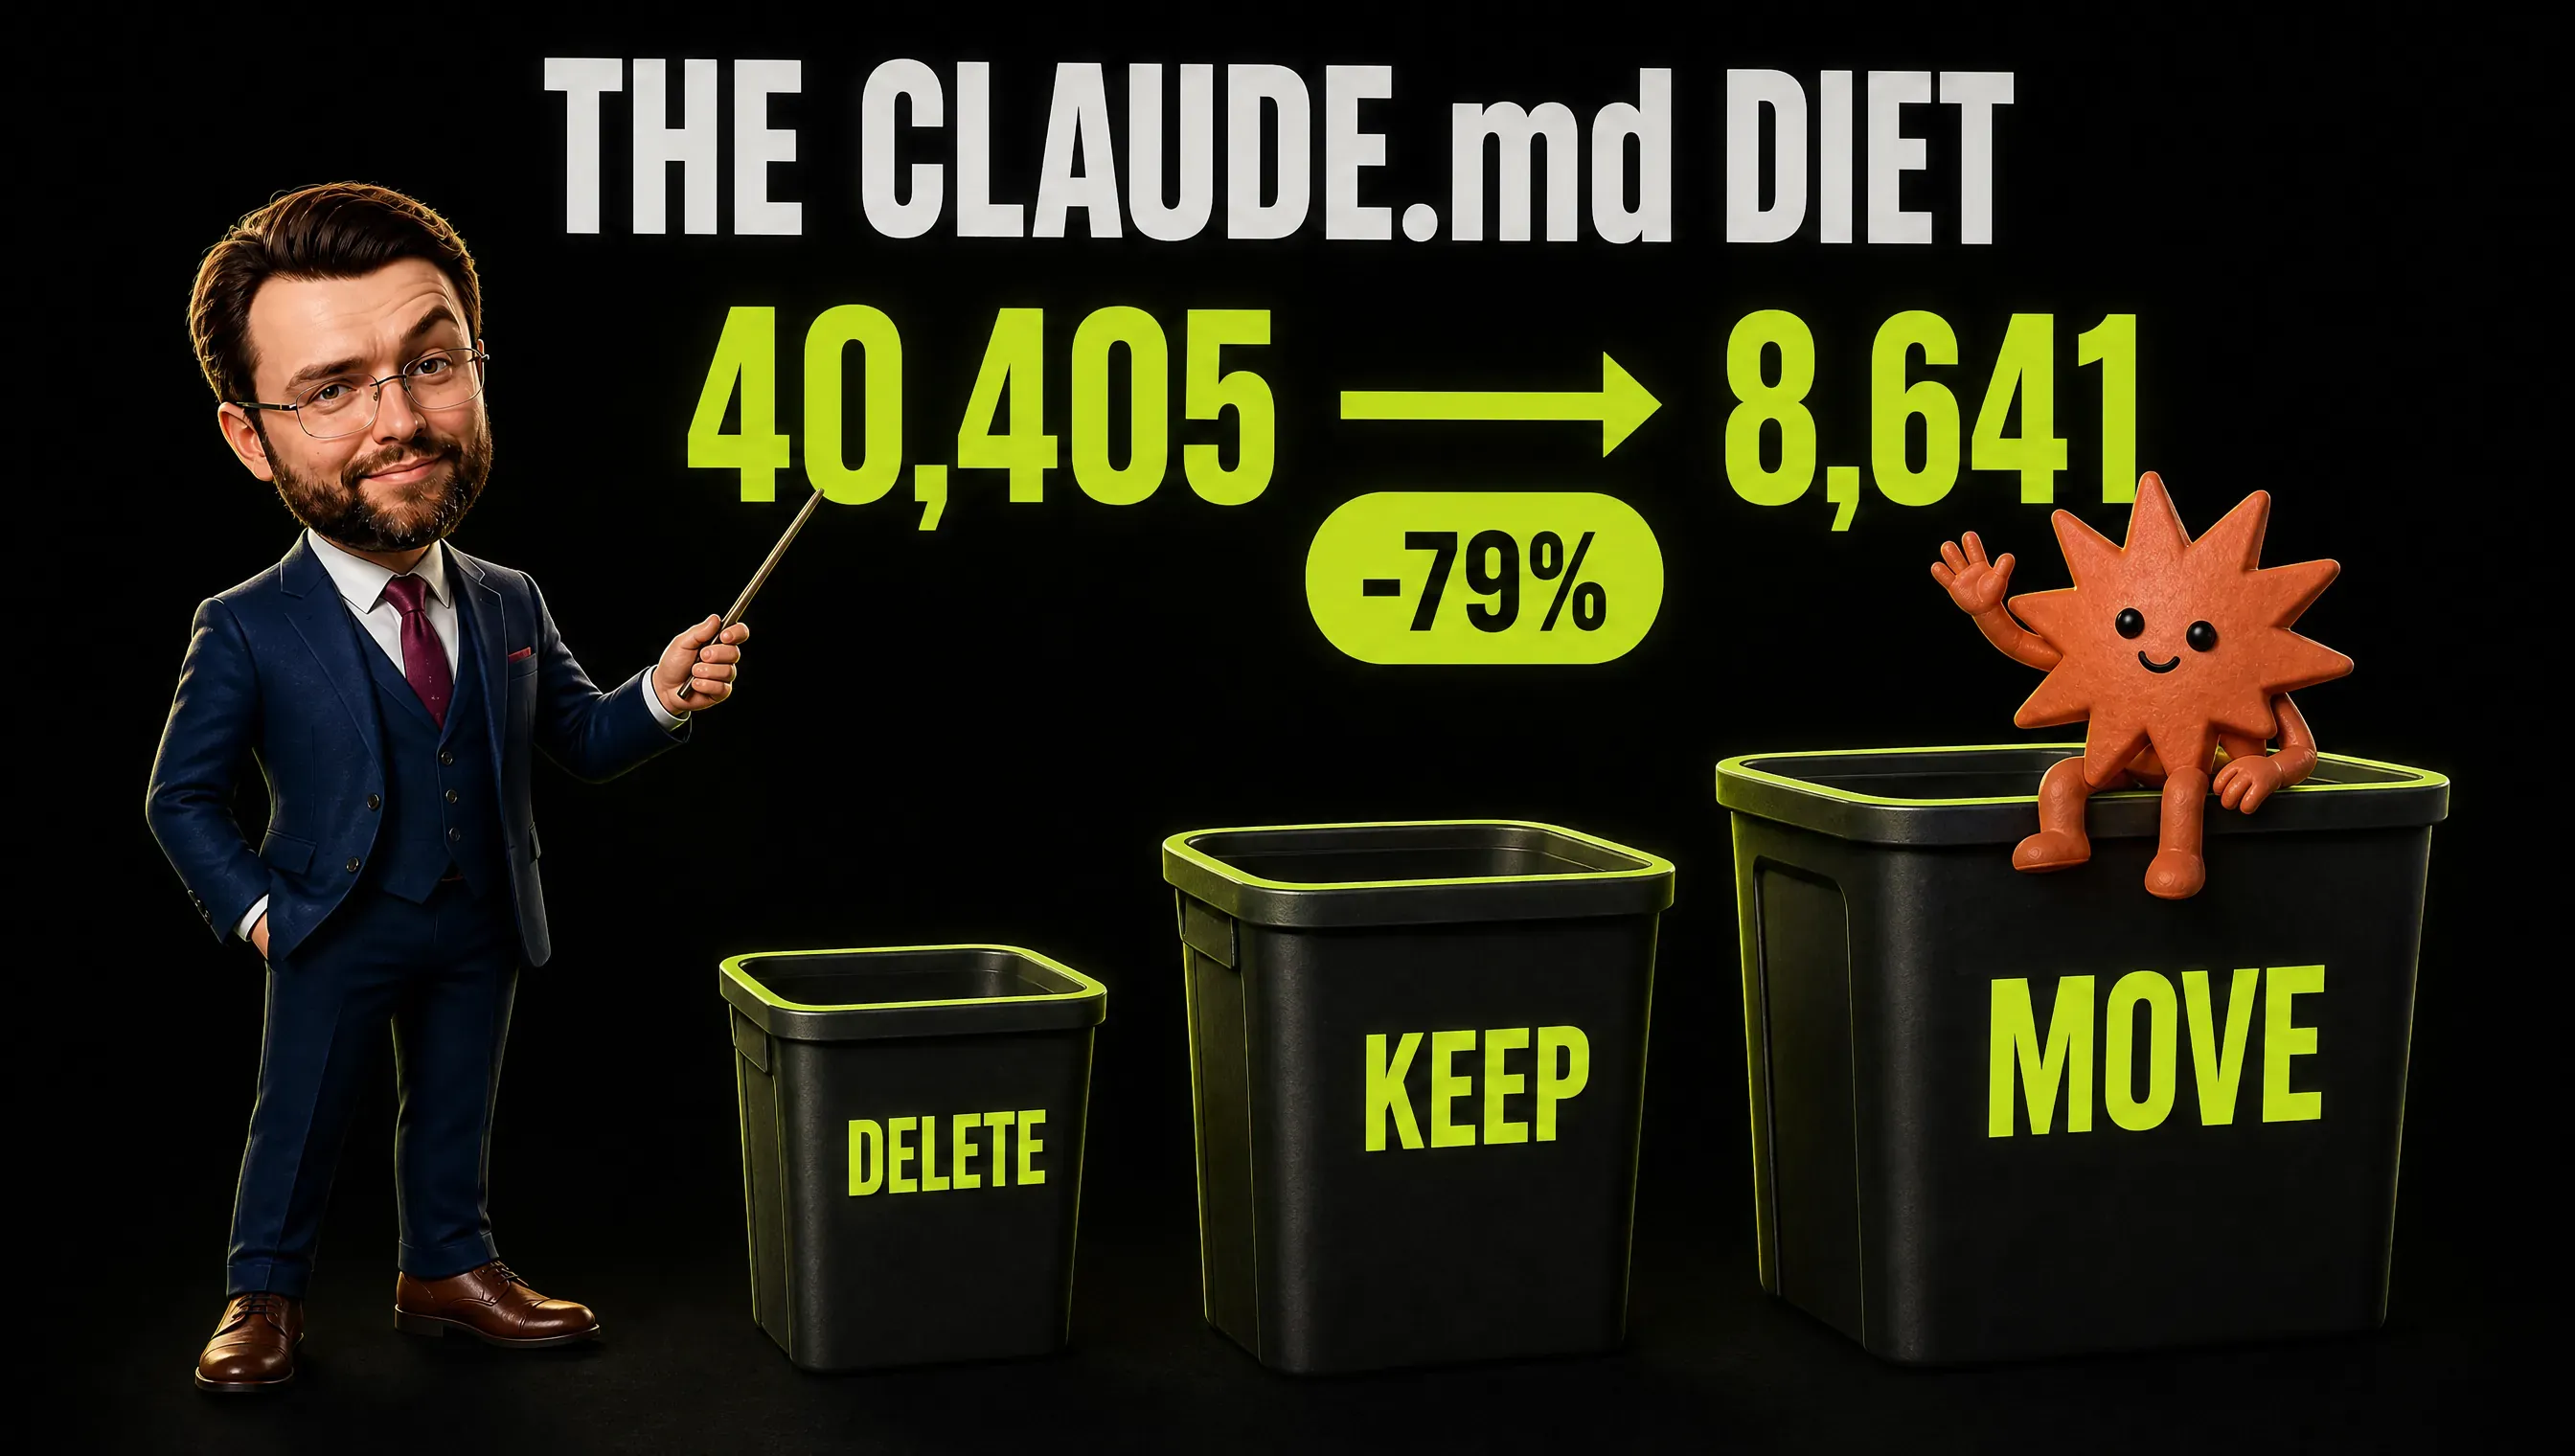
Я проверил собственную настройку. В конце сентября я сократил свой CLAUDE.md на 79%: с 40 405 символов до 8 641.
Но большую часть я не удалил. Я вынес её за указатели. История Anthropic в основном про удаление. Моя в основном про перенос, и эта разница многое говорит о том, чем на самом деле являются ваши инструкции.
Я прочитал оригинальный пост Anthropic, нужные разделы руководств по промптам для Opus 5, Opus 5.5, Fable 5.1 и Sonnet 5.5, а также документацию Claude Code, и проследил каждую цитату до источника. Начал я с обзора на Claude Fast, остальное проверил по первоисточникам.
Ключевые выводы
- Anthropic убрала более 80% системного промпта Claude Code без измеримых потерь в своих оценках по кодингу. Такой же тест для маркетинга, текстов или операционной работы Anthropic не публиковала.
- Диагноз Anthropic: избыточные ограничения. Устаревшие правила на худший случай и правила, которые спорят друг с другом, заставляли модель сначала разбирать споры, а потом работать. Длина тоже имеет значение.
- Одна проверка решает судьбу каждой строки: стала бы сильная модель вести себя хуже без неё? Добавьте второй вопрос: насколько плох худший случай, если модель ошибётся?
- Удаляйте инструкции, которые дублируют компетенцию модели. Выносите редкие процедуры за указатели. Оставляйте факты о вас, которые не угадает ни одна модель. Мой файл сократился на 79% в основном за счёт переноса.
- Поручайте проверку тому, что машина может провалить. Тесты, хуки и запрещающие правила детерминированы. «Будь внимателен» это пожелание, которое стоит токенов.
- Удаление это практика, а не разовое событие. Мой файл вырос на 17% за 13 дней. Датируйте каждое правило и записывайте, зачем оно нужно, чтобы перепроверить его, когда сменится модель.
Что такое контекстная инженерия и чем она отличается от промпт-инжиниринга?
Контекстная инженерия (context engineering) это проектирование всего, что модель читает помимо вашего вопроса: системного промпта, файлов CLAUDE.md, навыков (skills), памяти, описаний инструментов и справочных файлов. Промпт обслуживает один запрос. Контекст используется в тысячах запросов, поэтому одна неверная строка превращается в налог, который вы платите каждый раз.
Файл CLAUDE.md это обычный текстовый файл в корне проекта, который Claude Code читает в начале каждой сессии. В нём лежат факты, правила и указатели, которые модель не может угадать. Хорошая контекстная инженерия делает его коротким, конкретным и свободным от правил, которым модель и так следует.
Термин получил распространение в июне 2025 года, когда Саймон Уиллисон собрал реакции Тоби Лютке из Shopify и Андрея Карпатого: оба предпочли его выражению «prompt engineering». Эссе Anthropic от 29 сентября 2025 года задало принцип, который остаётся верным: найдите наименьший набор высокосигнальных токенов, который делает нужный результат наиболее вероятным.
Контекст ломается и так, как не ломается одиночный промпт. Дрю Бройниг назвал четыре вида сбоев в июне 2025 года: отравление, отвлечение, путаница и конфликт. Конфликт, то есть новая информация, противоречащая уже имеющейся в контексте, самый наглядный пример из июльского поста Anthropic.
Что удалила Anthropic
Пост называется The new rules of context engineering for Claude 5 generation models, его автор Тарик Шихипар (Thariq Shihipar), чтение занимает семь минут. Главное утверждение: Anthropic убрала более 80% системного промпта Claude Code для моделей вроде Claude Opus 5 и Claude Fable 5 «без измеримых потерь в наших оценках по кодингу».
Важны две детали. Первая касается границ: оценки по кодингу. Пост не разбирает, какие типы задач выдержали проверку.
Вторая деталь это диагноз. Anthropic говорит, что переограничивала модель через системный промпт, файлы CLAUDE.md и навыки. В её собственных транскриптах нашлись противоречащие друг другу сообщения внутри одного запроса: в одном месте «оставляй документацию по необходимости», в другом «НЕ добавляй комментарии». Модель может понять, чего вы хотите, но сначала ей придётся думать усерднее.
Anthropic не только удаляла. Проверку и ревью кода она вынесла в навыки, а как именно 80% делятся на удалённое и перенесённое, не публиковала.
Возьмём правило о комментариях. Старый системный промпт велел Claude по умолчанию не писать комментарии, длинные докстринги и планирующие документы, если их не просили. Это был компромисс: старые модели писали плохие комментарии, и Anthropic мирилась с правилом, которое ошибалось всякий раз, когда кому-то нужна была документация.
Новый промпт заменяет его одним предложением:
Пиши код так, чтобы он читался как окружающий код: подстраивайся под его плотность комментариев, именование и идиомы.
Claude Fast хорошо формулирует этот сдвиг: правило, верное в большинстве случаев, превратилось в критерий, верный всегда.
Этот шаблон знаком маркетологам. Брендбук говорит одно, бриф агентства другое, ночное письмо гендиректора третье. Модель это тот, кому нужно сдать один результат, удовлетворяющий всем троим.
Шесть сдвигов для тех, кто не пишет код
Anthropic перечисляет шесть старых привычек, ставших мифами. Вот деловая версия каждой, потому что эта логика работает для любого брифа, который вы отдаёте человеку или машине.
| Раньше | Теперь | Деловая версия |
|---|---|---|
| Давать Claude правила | Дать Claude право на суждение | Опытному сотруднику дают цель и границы, а не чек-лист из 40 пунктов |
| Давать Claude примеры | Проектировать интерфейсы | Длинные списки примеров сужают то, что пробует модель. Назовите поля и допустимые значения и оставьте один-два разнообразных примера для стиля |
| Выкладывать всё сразу | Раскрывать по мере необходимости | Картотека, а не папка, которую читают перед каждой встречей |
| Повторяться | Простые описания инструментов | Скажите один раз и там, где это используется |
| Память в файлах CLAUDE.md | Автопамять | Пусть инструмент ведёт заметки. Решения, которые вам придётся отстаивать, храните в своих файлах |
| Простые спецификации | Богатые референсы | Присылайте макет, тест или рубрику, а не абзац о них |
У второго сдвига есть предшественник годичной давности. В июле 2025 года команда Manus писала, что языковые модели «отличные имитаторы». Их агент, разбирая 20 резюме, часто попадал в ритм и повторял шаблон. Anthropic обнаружила, что примеры в описаниях инструментов сужают то, что модель исследует, а на рисунке в её посте описание TodoWrite сжимается примерно с 9 100 символов до одной строки. Разные системы, родственный эффект.
Четвёртый сдвиг мой любимый. Старые модели могли внимательнее слушать конец контекста, чем начало, поэтому команды повторяли свои критичные правила. Anthropic убрала повторы и перенесла указания по инструментам в их описания.
Повторы к тому же рождают противоречия. Напишите правило в трёх местах, и рано или поздно вы поправите только два.
Одна проверка для каждой строки и вопрос, который она упускает
Claude Fast сводит метод к одному вопросу для каждой строки: стала бы сильная модель вести себя хуже без этой строки? Если нет, удаляйте.
Проверка хорошая, и новой её не назовёшь. В документации Claude Code уже есть её двойник: «Приведёт ли удаление этой строки к ошибкам Claude?», а дальше: «Если нет, вырежьте её». Документация добавляет причину: раздутые файлы CLAUDE.md приводят к тому, что Claude игнорирует ваши настоящие инструкции. Изменилось другое: в июле выяснилось, сколько строк эту проверку не проходят.
Вот что она упускает: насколько плох худший случай? Anthropic говорит, что ранние правила появились, чтобы избежать худших сценариев вроде удаления файлов. Сильная модель может поступить правильно 999 раз из 1 000. Тысячный раз стоит вам клиента.
Даже когда руководство Anthropic по Sonnet 5.5 даёт вам промпт для большей автономности, оно добавляет, что этот промпт «не заменяет ваши собственные правила о рискованных или необратимых действиях. Оставьте эти правила в системном промпте».
Поэтому оценивайте каждую строку дважды. Насколько вероятно, что модель справится сама, и сколько стоит ошибка? Дёшево и вероятно: удаляйте. Дорого: оставьте правило и подкрепите его тем, с чем нельзя спорить. Документация сама проводит эту границу: инструкции в CLAUDE.md носят рекомендательный характер, а хуки детерминированы.
9 октября авторежим Claude Code, где отдельная модель-классификатор проверяет действия, остановил скрипт, который собирался писать в рабочую production-систему. Скрипт оставался остановленным, пока я не написал одно предложение с названием действия, ресурса и скрипта. Фразы «действуй» оказалось недостаточно.
Правило в файле это пожелание. Вторая модель-проверяющая лучше. Гарантия только у хука или запрещающего правила.
Контекстная инженерия после Claude 5: что удалить, что оставить, что вынести
Мой vault это второй мозг, который работает на Claude Code. Настройку я описал в статье про второй мозг. CLAUDE.md в его корне это ядро: оно загружается в каждой сессии, работаю ли я над клиентом, кампанией или этим блогом.
К сентябрю он вырос до 40 405 символов. 26 сентября я поручил своим агентам перестроить его. Новый файл занимает 8 641 символ, то есть на 79% меньше. Пять рабочих заметок за тот же проход уменьшились на 41-79%, одна из них с 17 363 символов до 4 883.
Вот поворот. Большую часть я не удалил. Я вынес её.
Эти 79% относятся к размеру, который загружается всегда. 19 разделов старого файла теперь лежат на семи страницах вики, которые открываются по триггеру. В оставшемся ядре шесть коротких разделов: личность и стиль, старт сессии и журнал, письмо и поиск, жёсткие ограничения, таблица из 13 триггеров и правила поддержки самого файла.
Каждый триггер говорит: когда работаешь над этим, сначала открой ту страницу. Ничего не импортируется. Новый риск в том, что триггер не сработает, поэтому каждый триггер называет свою страницу.
Прежде чем что-либо трогать, мои агенты сделали резервные копии 18 файлов с контрольной суммой. После этого они проверили, что файл-двойник AGENTS.md совпадает байт в байт и что 205 ссылок в ядре, руководстве и хронологиях по-прежнему работают.
Почему переносить, а не удалять? Из-за того, чем являются мои инструкции. Claude Fast говорит, что большая часть вырезанного у них была инструкциями, а не информацией: строками, которые велят модели быть осторожной или думать по шагам. Anthropic свои 80% не расписывает. Мои в основном факты о бизнесе одного человека, которые модель не может вывести сама.
Модель не может угадать, что по умолчанию я хочу итальянский. Не может знать, что мой CDN отклоняет стандартный user agent питоновских скриптов. Не может знать, что ни одна рекламная кампания не меняется без моего прямого «добро». Claude Fast называет это «информацией, которую модель не может вывести сама». Такая информация проходит любую проверку. Вопрос лишь в том, где она хранится.
| Корзина | Проверка | Что туда попало |
|---|---|---|
| Удалить | Сильная модель и так это делает, или два правила противоречат друг другу | Старое правило поиска, которое отсылало к внешней автопамяти, в то время как другое правило её запрещало. Я оставил одно |
| Оставить в ядре | Модель не может вывести это сама, или худший случай дорогой | Мои правила голоса и языка, стартовая рутина, лимиты расходов и согласований, таблица триггеров |
| Вынести | Нужно иногда, но не всегда | Процедуры публикации, рецепты по сервисам, брендовые каноны, правила для изображений: 19 разделов на 7 страницах |
Одно предупреждение от Claude Fast, и оно верное. Некоторые строки выглядят скучными, а на деле это золото. По словам Claude Fast, факты о проекте это «самые ценные строки вашего CLAUDE.md, и они выглядят скучно, а значит, именно их уничтожит чересчур рьяная чистка».
Раскрытие по мере необходимости это просто хорошая картотека
Решение Anthropic для «выкладывать всё сразу» это дерево файлов, которые можно загрузить в нужный момент. Обратное пост называет мифом: убеждение, что каждую практику нужно держать в одном центральном файле, потому что Claude «иначе не найдёт». Claude Fast говорит короче: Claude найдёт.
Моя версия это картотека с бюджетами размера:
- Маршрутизатор. Одна индексная заметка по компаниям и направлениям, несколько тысяч символов.
- Индекс направления. Клиенты и активности одной компании.
- Рабочая заметка одной активности. Цель от 1 000 до 3 000 символов и потолок в 10 000.
- Страницы вики и сырые источники. Открываются, только когда они нужны задаче.
В начале сессии модель читает ядро и одну рабочую заметку. Остального она не читает. Большая часть моей памяти лежит на диске и ничего не стоит, пока триггер её не откроет.
Ловушка, о которой стоит знать: импорты это не раскрытие по мере необходимости. Документация Claude Code прямолинейна: импорты помогают организовать длинный файл, но не уменьшают его стоимость в контексте, потому что импортированные файлы тоже загружаются при запуске. Разбейте файл в 600 строк на шесть импортов, и у вас будет шесть файлов и те же 600 строк. Контекст экономит правило, которое загружается только для определённых папок, навык или простой указатель, по которому модель идёт, когда нужно.
Вторая половина этого сдвига: заменять пороги критериями. Пример Claude Fast отправлял работу специализированным агентам по числу файлов. Переименование 40 файлов пересекает порог, но это одна механическая задача. Изменение в трёх файлах, которое затрагивает миграцию базы данных, контракт API и форму, требует трёх видов экспертизы. Поэтому критерием стало число предметных областей плюс один разобранный пример, где проходит планка.
Вы знаете это по бюджетам. «Любая трата выше 5 000 требует согласования» это порог. «Всё, что нельзя отменить, требует согласования» это критерий. Порог пропускает ошибку на 4 900. Правилом у меня остаётся критерий, а число я держу только там, где клиент задал реальный лимит.
Не перегибайте. Полевое руководство по Fable от Шихипара предупреждает: если вы слишком конкретны, Claude следует за вами, даже когда лучше свернуть. Если слишком расплывчаты, он заполняет пробелы общими лучшими практиками. Проверяйте, чтобы найти середину.
Ловушка проверки и урок на 17 долларов
В каждом файле инструкций, который я видел, есть какая-нибудь версия фразы «проверь свою работу, прежде чем отчитаться». Это похоже на добросовестность. Руководство Anthropic по Opus 5 говорит, что это даёт обратный эффект. Opus 5 проверяет свою работу и без просьб, а явные инструкции по проверке «приводят к избыточной проверке у Claude Opus 5, а их удаление сокращает расход токенов впустую без потери качества».
То же руководство предупреждает, что Opus 5 делегирует субагентам охотнее прежних моделей, и рекомендует детерминированные ограничения на их число.
9 октября я понял, почему. Я попросил свою систему изучить тему для статьи. Она запустила десять исследовательских агентов параллельно, и они унаследовали максимальный уровень усилий сессии. Ещё восемь были запланированы.
Я остановил процесс через шесть минут. Он сделал 233 вызова и обработал около 31 миллиона токенов, почти все из них повторные чтения веб-страниц, которые уже лежали в контексте. Счётчик расхода показывал около 17 долларов. Результат исследования: ноль готовых досье.
Второй процесс в то же утро, без заданного уровня усилий, обработал около 287 миллионов токенов за 40 минут. Anthropic предупреждала, что её собственные рабочие процессы «могут в итоге расходовать существенно больше токенов».
Моим первым решением была церемония: оценивать стоимость и спрашивать меня перед каждым процессом. Я отверг её: медленнее и не безопаснее. Второе решение стало интерфейсом. Уровень усилий (effort) стал обязательным параметром каждого вызова агента: низкий для веб-исследований и механической работы, средний для текстов и переводов, высокий только для по-настоящему сложного суждения.
Руководство Anthropic по Opus 5.5 объясняет, почему это помогает: снижение уровня усилий сокращает размышления, а с ними стоимость и задержку, «надёжнее, чем это делают инструкции в промпте». Это второй сдвиг на практике. Не описывайте поведение словами. Проектируйте управление.
Правда, уровень усилий сокращает размышления, а не повторные чтения. Более сильный тормоз это лимит. Руководство по Opus 5 называет CLAUDE_CODE_MAX_CONCURRENT_SUBAGENTS, CLAUDE_CODE_MAX_SUBAGENT_SPAWN_DEPTH и, для SDK, max_budget_usd, всё это начиная с Claude Code 2.1.217. Это настройки, а не пожелания.
Два уточнения. Руководство по Sonnet 5.5 говорит, что одна стоп-инструкция против субагентов-ревьюеров снизила стоимость сессии примерно на треть при максимальном уровне усилий на задачах по кодингу, а качество не изменилось. Оно же говорит, что на низком уровне усилий Sonnet 5.5 может пропускать проверки, и короткий промпт с просьбой о настоящих проверках делает это редким. Всё зависит от модели и уровня усилий.
Так где должна жить проверка? В проверках, которые в проекте уже есть: тесты, сборка, хук. Отдельного ревьюера с рубрикой добавляйте только там, где решает вкус или высоки ставки, как это делают рабочие процессы Anthropic, потому что модель склонна предпочитать собственные результаты. Проверка, которую машина может провалить, лучше фразы с просьбой о внимательности.
О том, что нужно настоящей проверке сверх фразы с просьбой о внимательности, читайте в моём материале про human in the loop ИИ.
Где удаление ведёт не туда
Это результат для кодинга. Anthropic написала «без измеримых потерь в наших оценках по кодингу». Как отметил AI Weekly, пост не разбирает, какие категории задач выдержали проверку. Я не нашёл опубликованных тестов на голос бренда, юридические тексты или клиентскую отчётность. Проверяйте на своих задачах.
Это совет для Claude 5. Даже внутри семейства руководства различаются: руководство Anthropic по Opus 5.5 говорит, что названия уровней усилий не соответствуют одному и тому же объёму размышлений у разных моделей. Если ваш стек смешивает модели, как у меня, где рядом с Claude работают GLM и Kimi, настраивайте поведенческие правила под каждую модель. Мои зеркальные файлы могут делить одно ядро только потому, что оно в основном состоит из нейтральных к модели фактов и указателей. Про GLM 5.3 я писал, если вам интересна сторона открытых весов.
Если вы распределяете работу между моделями Claude, мой разбор моделей Claude для маркетинга: Haiku, Sonnet и Opus ставит цены рядом с задачами.
Большое окно это ещё не внимание. Отчёт Chroma Context Rot от июля 2025 года проверил 18 моделей, включая Claude 4, и показал, что надёжность падает с ростом входных данных даже на простых задачах. Anthropic говорит, что следование инструкциям, вызов инструментов и рассуждения Claude Opus 5 остаются стабильными на протяжении всего окна в 1 млн токенов, но в руководстве нет цифр. Разные модели с разницей в год: я бы не ставил ни на одно, ни на другое.
Два практических вывода остаются в силе при любом раскладе. В тесте Chroma на память сфокусированные входные данные превзошли полные. А Manus отметил, что на Claude Sonnet кэшированные входные токены стоят в десять раз меньше некэшированных, поэтому стабильный префикс экономит деньги.
Память Claude Code: арендовать или владеть
Пятый сдвиг гласит, что горячая клавиша # уходит, а автопамять приходит: Claude теперь сам сохраняет воспоминания, важные для работы и для вас. Я ею пользуюсь. Документация Claude Code приводит мелкий шрифт. Автопамять по умолчанию локальна для машины, в каждую сессию загружаются только первые 200 строк или 25 КБ её индекса, и она пропускает всё, что Claude может вывести из вашего кода.
Claude сам решает, что сохранять, и это отлично для привычек и поправок, мелочей, которые вы никогда не записали бы. Для решений, которые вам придётся отстаивать на встрече, она плохой дом. Это обычный markdown, который можно просмотреть, но он всё равно лежит в папке одного инструмента.
Моё правило: канон в файлах, которыми владею я, автопамять короткая, в основном указатели и небольшие поправки. Vault переезжает между моими машинами, а те же правила доходят до других агентов через двойника AGENTS.md. Теперь документация описывает, как Claude Code читает AGENTS.md вместо CLAUDE.md, так что двойник может оказаться привычкой, от которой можно отказаться.
Когда я проверял двенадцать репозиториев PhotoCraft для статьи про открытый аналог Photoshop, в каждом из них оказался AGENTS.md. Контекстные файлы это новый README.
Удаление это практика, а не разовое событие
Вот часть, которую никто не выносит в заголовок. 9 октября, через тринадцать дней после сокращения, мой CLAUDE.md занимает 10 127 символов. Это на 17% больше, чем в день, когда я его подрезал, и выше потолка в 10 000, который я сам себе поставил. Файлы инструкций отрастают как сорняки, по одному разумному добавлению за раз.
Поэтому я отношусь к каждому правилу как к гипотезе с датой. У правила в моих заметках есть суть, причина, способ применения и дата, когда я его принял. Порог компактации, то есть число токенов, при котором длинная сессия сжимается, я задавал трижды за три дня в июле: 500 000 токенов, потом 400 000, потом около 100 000. Эта история лежит рядом с правилом.
Добавьте в свои правила ещё одно поле: как вы узнаете, что его безопасно убрать. Когда выходит новая модель, спросите, остаётся ли причина в силе.
У Claude Fast есть на этот случай фраза: «Ваши старые указания не становятся ошибочными задним числом». Изменился компромисс, а не логика. Я хочу, чтобы в будущем я читал свои правила как решения, принятые в прежних условиях, а не как ошибки.
Аудит CLAUDE.md за 30 минут, который можно провести сегодня
Поставьте таймер. Для короткого файла закладывайте 30 минут, для большого дольше. Вам нужны копия и честный взгляд.
- Скопируйте файл или закоммитьте его в git. Сохраните оригинал. Ничто из удалённого не потеряно, если это можно вернуть.
- Запустите
/doctor prompt-audit. Нужен Claude Code v2.1.283 или новее. Прочитайте отчёт о мёртвых ссылках, противоречиях и правилах, написанных для старых моделей. Пока ничего не применяйте. - Выберите 3-5 реальных задач и сохраните результаты. Это ваша точка отсчёта.
- Разложите каждую строку: удалить, оставить или вынести. Удалите то, что, как вы проверили, сильная модель делает и так, например «будь осторожен». Оставьте то, что она не может вывести сама и что дорого угадывать неверно. Остальное вынесите за указатель. Роль или строку «сначала подумай» оставьте, если тест показывает, что они помогают, особенно вне кодинга.
- Найдите дубликаты и противоречия. Поищите каждое правило ядра. Если оно встречается в трёх местах, у вас три его версии.
- Превратите «будь осторожен» в проверку, которую машина может провалить. Тест, хук, запрещающее правило. Ревьюера с рубрикой добавляйте только там, где продукт это вкус.
- Замените пороги критериями. Добавьте один разобранный пример, где проходит граница.
- Режьте партиями и перезапускайте задачи. Верните любую партию, после которой результаты ухудшились. Потом датируйте то, что уцелело, и напишите, зачем оно, а в календарь поставьте напоминание на выход следующей модели.
Относитесь с подозрением к строкам, которые вы не можете заставить себя вырезать. Некоторые из них золото. Большинство рубцовая ткань.
Часто задаваемые вопросы
Нужен ли файл CLAUDE.md?
Нет, но это самое дешёвое место для всего, что Claude не может угадать. Совет Anthropic: держите его лёгким, пишите, для чего репозиторий, и тратьте большую часть токенов на подводные камни. Автопамять может покрыть привычки и поправки.
Какой длины должен быть CLAUDE.md?
Документация Claude Code ориентируется на менее 200 строк на файл, потому что более длинные файлы стоят контекста и снижают соблюдение инструкций. Строки это грубая мера: мой файл занимает 71 строку, но около 10 000 символов, поэтому я слежу за противоречиями и символами.
Станет ли Claude хуже, если удалять инструкции?
В своих оценках по кодингу Anthropic не нашла измеримых потерь. Для другой работы публичного теста нет, поэтому убирайте строки небольшими партиями и сравнивайте на своих задачах. Один симптом из документации Claude Code: если Claude продолжает игнорировать правило, файл, скорее всего, слишком длинный.
Что делает /doctor?
Две вещи, по документации. Проверка на сокращение предлагает, что вырезать из закоммиченного CLAUDE.md: она убирает то, что Claude может вывести из кода, например структуру каталогов и списки зависимостей, и оставляет подводные камни, обоснования и нестандартные соглашения (Claude Code v2.1.206 или новее). /doctor prompt-audit находит инструкции, написанные для старых моделей, мёртвые ссылки и противоречия и предлагает правки, не применяя их.
Промпт-инжиниринг умер?
Нет. Бриф для каждой задачи по-прежнему нужно писать. Умерло другое: набивать постоянный контекст правилами, которым сильная модель уже следует.
Мой вердикт
Урок Anthropic не в том, чтобы «писать меньше». Он такой: перестаньте писать инструкции, которым сильная модель и так следует, и начните отбирать то, чего она знать не может.
Контекстная инженерия после Claude 5 умещается на карточке:
- Режьте то, что дублирует компетенцию.
- Оставляйте то, что знаете только вы.
- Выносите то, что нужно изредка.
- Запирайте всё опасное за механизмом, а не за предложением.
- Датируйте и возвращайтесь.
Эта страница отражает руководства по состоянию на 9 октября 2026 года. Anthropic часто их пересматривает, поэтому проверяйте даты, прежде чем опираться на какую-либо деталь.
Только начинаете работать с агентами? Начните с моего руководства по вайб-кодингу. Уже запускаете их и хотите, чтобы кто-то свежим взглядом посмотрел на ваши файлы инструкций или на всю настройку? Свяжитесь со мной.


