Anthropic ha eliminato oltre l'80% del prompt di Claude Code. Io ho tagliato il mio CLAUDE.md del 79%.
Context engineering con Claude 5: Anthropic ha eliminato oltre l'80% del prompt di Claude Code. Ecco cosa ho tagliato, spostato e tenuto nel mio CLAUDE.md.
Il 24 luglio Anthropic ha dichiarato di aver rimosso più dell’80 percento del system prompt di Claude Code per i suoi modelli più recenti. I punteggi sul codice sono rimasti invariati. Gran parte di ciò che hai letto l’anno scorso sul context engineering e su come scrivere un CLAUDE.md è diventata sospetta da un giorno all’altro.
Se mantieni un file CLAUDE.md, dovrebbe metterti a disagio. Anthropic oggi chiama “miti” buona parte dei vecchi consigli: dai delle regole, dai degli esempi, metti tutto all’inizio, ripeti le cose.
Ho controllato la mia configurazione. A fine settembre ho tagliato il mio CLAUDE.md del 79 percento, da 40.405 caratteri a 8.641.
Ma non ho cancellato la maggior parte del file. L’ho spostata dietro dei puntatori. La storia di Anthropic parla soprattutto di cancellare. La mia parla soprattutto di spostare, e la differenza dice molto su cosa siano davvero le tue istruzioni.
Ho letto il post originale di Anthropic, le sezioni rilevanti delle guide al prompting per Opus 5, Opus 5.5, Fable 5.1 e Sonnet 5.5 e la documentazione di Claude Code, e ho ricondotto ogni citazione alla sua fonte. Sono partito da un riassunto su Claude Fast e per il resto sono andato alle fonti primarie.
In sintesi
- Anthropic ha rimosso oltre l’80 percento del system prompt di Claude Code senza alcuna perdita misurabile nelle sue valutazioni sul codice. Anthropic non ha pubblicato lo stesso test per marketing, scrittura o operations.
- La diagnosi di Anthropic è stata l’eccesso di vincoli. Regole stantie per il caso peggiore e regole in conflitto costringevano il modello a fare l’arbitro prima di lavorare. Conta anche la lunghezza.
- Un solo test decide ogni riga: un modello forte si comporterebbe peggio senza di essa? Aggiungi una seconda domanda: quanto è grave il caso peggiore se il modello tira a indovinare?
- Elimina le istruzioni che copiano la competenza del modello. Sposta le procedure occasionali dietro dei puntatori. Tieni i fatti su di te che nessun modello può indovinare. Il mio file è sceso del 79 percento soprattutto spostando.
- Affida la verifica a controlli che una macchina può far fallire. Test, hook e regole di blocco sono deterministici. “Fai attenzione” è un suggerimento che costa token.
- Eliminare è una pratica, non un evento. Il mio file è cresciuto del 17 percento in 13 giorni. Metti una data a ogni regola e scrivi perché esiste, così potrai rimetterla alla prova quando cambia il modello.
Cos’è il context engineering e in cosa si differenzia dal prompt engineering?
Il context engineering è la pratica di progettare tutto ciò che un modello legge oltre alla tua domanda: il system prompt, i file CLAUDE.md, le skill, la memoria, le descrizioni degli strumenti e i file di riferimento. Un prompt serve una richiesta. Il contesto viene riutilizzato in migliaia di richieste, quindi una riga sbagliata diventa una tassa che paghi ogni volta.
Un file CLAUDE.md è un file di testo semplice nella radice del tuo progetto che Claude Code legge all’inizio di ogni sessione. Contiene i fatti, le regole e i puntatori che il modello non può indovinare. Un buon context engineering lo tiene breve, specifico e privo di regole che il modello già segue.
Il termine è esploso a giugno 2025, quando Simon Willison ha raccolto le reazioni di Tobi Lütke di Shopify e di Andrej Karpathy, che lo preferivano entrambi a “prompt engineering”. Il saggio di Anthropic del 29 settembre 2025 ha fissato il principio che vale ancora: trova il più piccolo insieme di token ad alto segnale che renda più probabile il tuo risultato.
Il contesto può anche fallire in modi che un singolo prompt non conosce. Drew Breunig ne ha nominati quattro a giugno 2025: avvelenamento, distrazione, confusione e conflitto. Il conflitto, cioè nuove informazioni che contraddicono ciò che è già nel contesto, è l’esempio più chiaro nel post di luglio di Anthropic.
Cosa ha eliminato Anthropic
Il post è The new rules of context engineering for Claude 5 generation models, di Thariq Shihipar, sette minuti di lettura. L’affermazione principale: Anthropic ha rimosso oltre l’80 percento del system prompt di Claude Code per modelli come Claude Opus 5 e Claude Fable 5 “senza alcuna perdita misurabile nelle nostre valutazioni sul codice.”
Due dettagli contano. Il primo è l’ambito: valutazioni sul codice. Il post non spiega quali tipi di compiti abbiano retto.
Il secondo è la diagnosi. Anthropic dice di aver vincolato troppo il modello, attraverso il system prompt, i file CLAUDE.md e le skill. Le sue stesse trascrizioni mostravano messaggi in conflitto dentro una sola richiesta, come “lascia la documentazione nella misura appropriata” in un punto e “NON aggiungere commenti” in un altro. Il modello capisce cosa vuoi, ma prima deve pensarci di più.
Anthropic non ha solo cancellato. Ha anche spostato verifica e code review dentro le skill, e non ha pubblicato come si divida l’80 percento tra eliminato e spostato.
Prendi la regola sui commenti. Il vecchio system prompt diceva a Claude di non scrivere commenti per impostazione predefinita, né docstring lunghe, né documenti di pianificazione, salvo richiesta. Era un compromesso: i vecchi modelli scrivevano commenti scadenti, così Anthropic accettava una regola sbagliata ogni volta che qualcuno voleva della documentazione.
Il nuovo prompt la sostituisce con una sola frase:
Write code that reads like the surrounding code: match its comment density, naming, and idiom.
In italiano: scrivi codice che si legge come il codice che lo circonda, con la stessa densità di commenti, gli stessi nomi e le stesse convenzioni.
Claude Fast riassume bene il cambiamento: una regola giusta quasi sempre è diventata un criterio giusto sempre.
Conosci questo schema dal marketing. Il brand book dice una cosa, il brief dell’agenzia un’altra, l’email notturna del CEO una terza. Il modello è la persona che deve consegnare un solo risultato che soddisfi tutti e tre.
I sei cambi di rotta, tradotti per chi non scrive codice
Anthropic elenca sei vecchie abitudini diventate miti. Ecco la versione business di ciascuna, perché la logica vale per qualsiasi brief tu consegni a una persona o a una macchina.
| Prima | Ora | La versione business |
|---|---|---|
| Dai regole a Claude | Lascia che Claude usi il giudizio | Dai a un senior l’obiettivo e i limiti, non una checklist di 40 punti |
| Dai esempi a Claude | Progetta interfacce | Lunghe liste di esempi restringono ciò che il modello prova. Nomina i campi e i valori ammessi, e tieni uno o due esempi diversi tra loro per lo stile |
| Metti tutto all’inizio | Usa la progressive disclosure | Un archivio ordinato, non un raccoglitore da leggere prima di ogni riunione |
| Ripeti le cose | Descrizioni semplici degli strumenti | Dillo una volta, nel punto in cui serve |
| Memoria nei file CLAUDE.md | Auto-memory | Lascia che sia lo strumento a prendere appunti. Tieni le decisioni che devi difendere in file che controlli tu |
| Specifiche semplici | Riferimenti ricchi | Manda il mockup, il test o la griglia di valutazione, non un paragrafo che li descrive |
Il secondo cambio ha un parente di un anno prima. A luglio 2025 il team di Manus ha scritto che i modelli linguistici sono “imitatori eccellenti”. Il loro agente, mentre esaminava 20 curriculum, cadeva spesso in un ritmo e ripeteva lo schema. Anthropic ha scoperto che gli esempi nelle descrizioni degli strumenti restringono ciò che il modello esplora, e in una figura del suo post la descrizione di TodoWrite passa da circa 9.100 caratteri a una riga. Configurazioni diverse, effetto affine.
Il quarto cambio è il mio preferito. I modelli più vecchi potevano ascoltare più attentamente la fine del contesto che l’inizio, così i team ripetevano le regole critiche. Anthropic ha cancellato le ripetizioni e ha spostato le indicazioni sugli strumenti nelle descrizioni degli strumenti.
La ripetizione è anche il modo in cui nascono le contraddizioni. Scrivi una regola in tre posti e prima o poi ne modifichi solo due.
Il test dietro ogni riga, e la domanda che manca
Claude Fast riduce il metodo a una domanda per ogni riga: un modello forte si comporterebbe peggio senza questa riga? Se no, eliminala.
È un buon test, e non è nuovo. La documentazione di Claude Code ne ha già uno gemello: “Would removing this cause Claude to make mistakes?”, cioè “Rimuovere questa riga farebbe sbagliare Claude?”, seguito da “If not, cut it”, cioè “Se no, tagliala.” La documentazione aggiunge il perché: i file CLAUDE.md gonfi fanno sì che Claude ignori le tue istruzioni vere. Ciò che è cambiato a luglio è quante righe non superano il test.
Ecco cosa manca al test: quanto è grave il caso peggiore? Anthropic dice che le prime regole esistevano per evitare scenari peggiori come la cancellazione di file. Un modello forte può fare la cosa giusta 999 volte su 1.000. La millesima è quella che ti costa un cliente.
Anche quando la guida di Anthropic a Sonnet 5.5 ti consegna un prompt per più autonomia, aggiunge che il prompt “non sostituisce le tue regole sulle azioni rischiose o irreversibili. Tieni quelle regole nel tuo system prompt.”
Quindi dai a ogni riga due punteggi. Quanto è probabile che il modello la azzecchi da solo, e quanto costa se non la azzecca? Economica e probabile: eliminala. Costosa: tieni la regola e appoggiala a qualcosa che non si può discutere. La documentazione traccia da sola la linea: le istruzioni di CLAUDE.md sono consultive, mentre gli hook sono deterministici.
Il 9 ottobre la modalità auto di Claude Code, in cui un modello classificatore separato esamina le azioni, ha bloccato uno script che stava per scrivere su un sistema di produzione attivo. È rimasto bloccato finché non ho scritto una frase che nominava l’azione, la risorsa e lo script. “Vai pure” non bastava.
Una regola in un file è un suggerimento. Un secondo modello che controlla è meglio. Solo un hook o una regola di blocco è una garanzia.
Context engineering dopo Claude 5: cosa eliminare, tenere o spostare
Il mio vault è un secondo cervello che gira su Claude Code. Ho spiegato la configurazione nel mio articolo sul secondo cervello. Il CLAUDE.md nella sua radice è il kernel: si carica a ogni sessione, che io stia lavorando su un cliente, su una campagna o su questo blog.
A settembre era arrivato a 40.405 caratteri. Il 26 settembre l’ho fatto ricostruire ai miei agenti. Il nuovo file è di 8.641 caratteri, un taglio del 79 percento. Cinque note di memoria di lavoro si sono ridotte tra il 41 e il 79 percento nello stesso passaggio, una da 17.363 caratteri a 4.883.
Ed ecco il colpo di scena. Non ho cancellato la maggior parte del file. L’ho spostata.
Il 79 percento è la dimensione sempre caricata. Le 19 sezioni del vecchio file ora vivono in sette pagine wiki che si aprono su un trigger. Il nucleo rimasto ha sei sezioni brevi: identità e stile, avvio della sessione e registrazione, scrittura e ricerca, vincoli rigidi, una tabella di 13 trigger e le regole per la manutenzione del file stesso.
Ogni trigger dice: quando lavori su questo, apri prima quella pagina. Non viene importato nulla. Il nuovo rischio è un trigger che non scatta, quindi ogni trigger nomina la sua pagina.
Prima di toccare qualsiasi cosa, i miei agenti hanno fatto il backup di 18 file con un checksum. Dopo, hanno verificato che il file gemello AGENTS.md fosse identico byte per byte e che 205 link tra nucleo, manuale e cronologie funzionassero ancora.
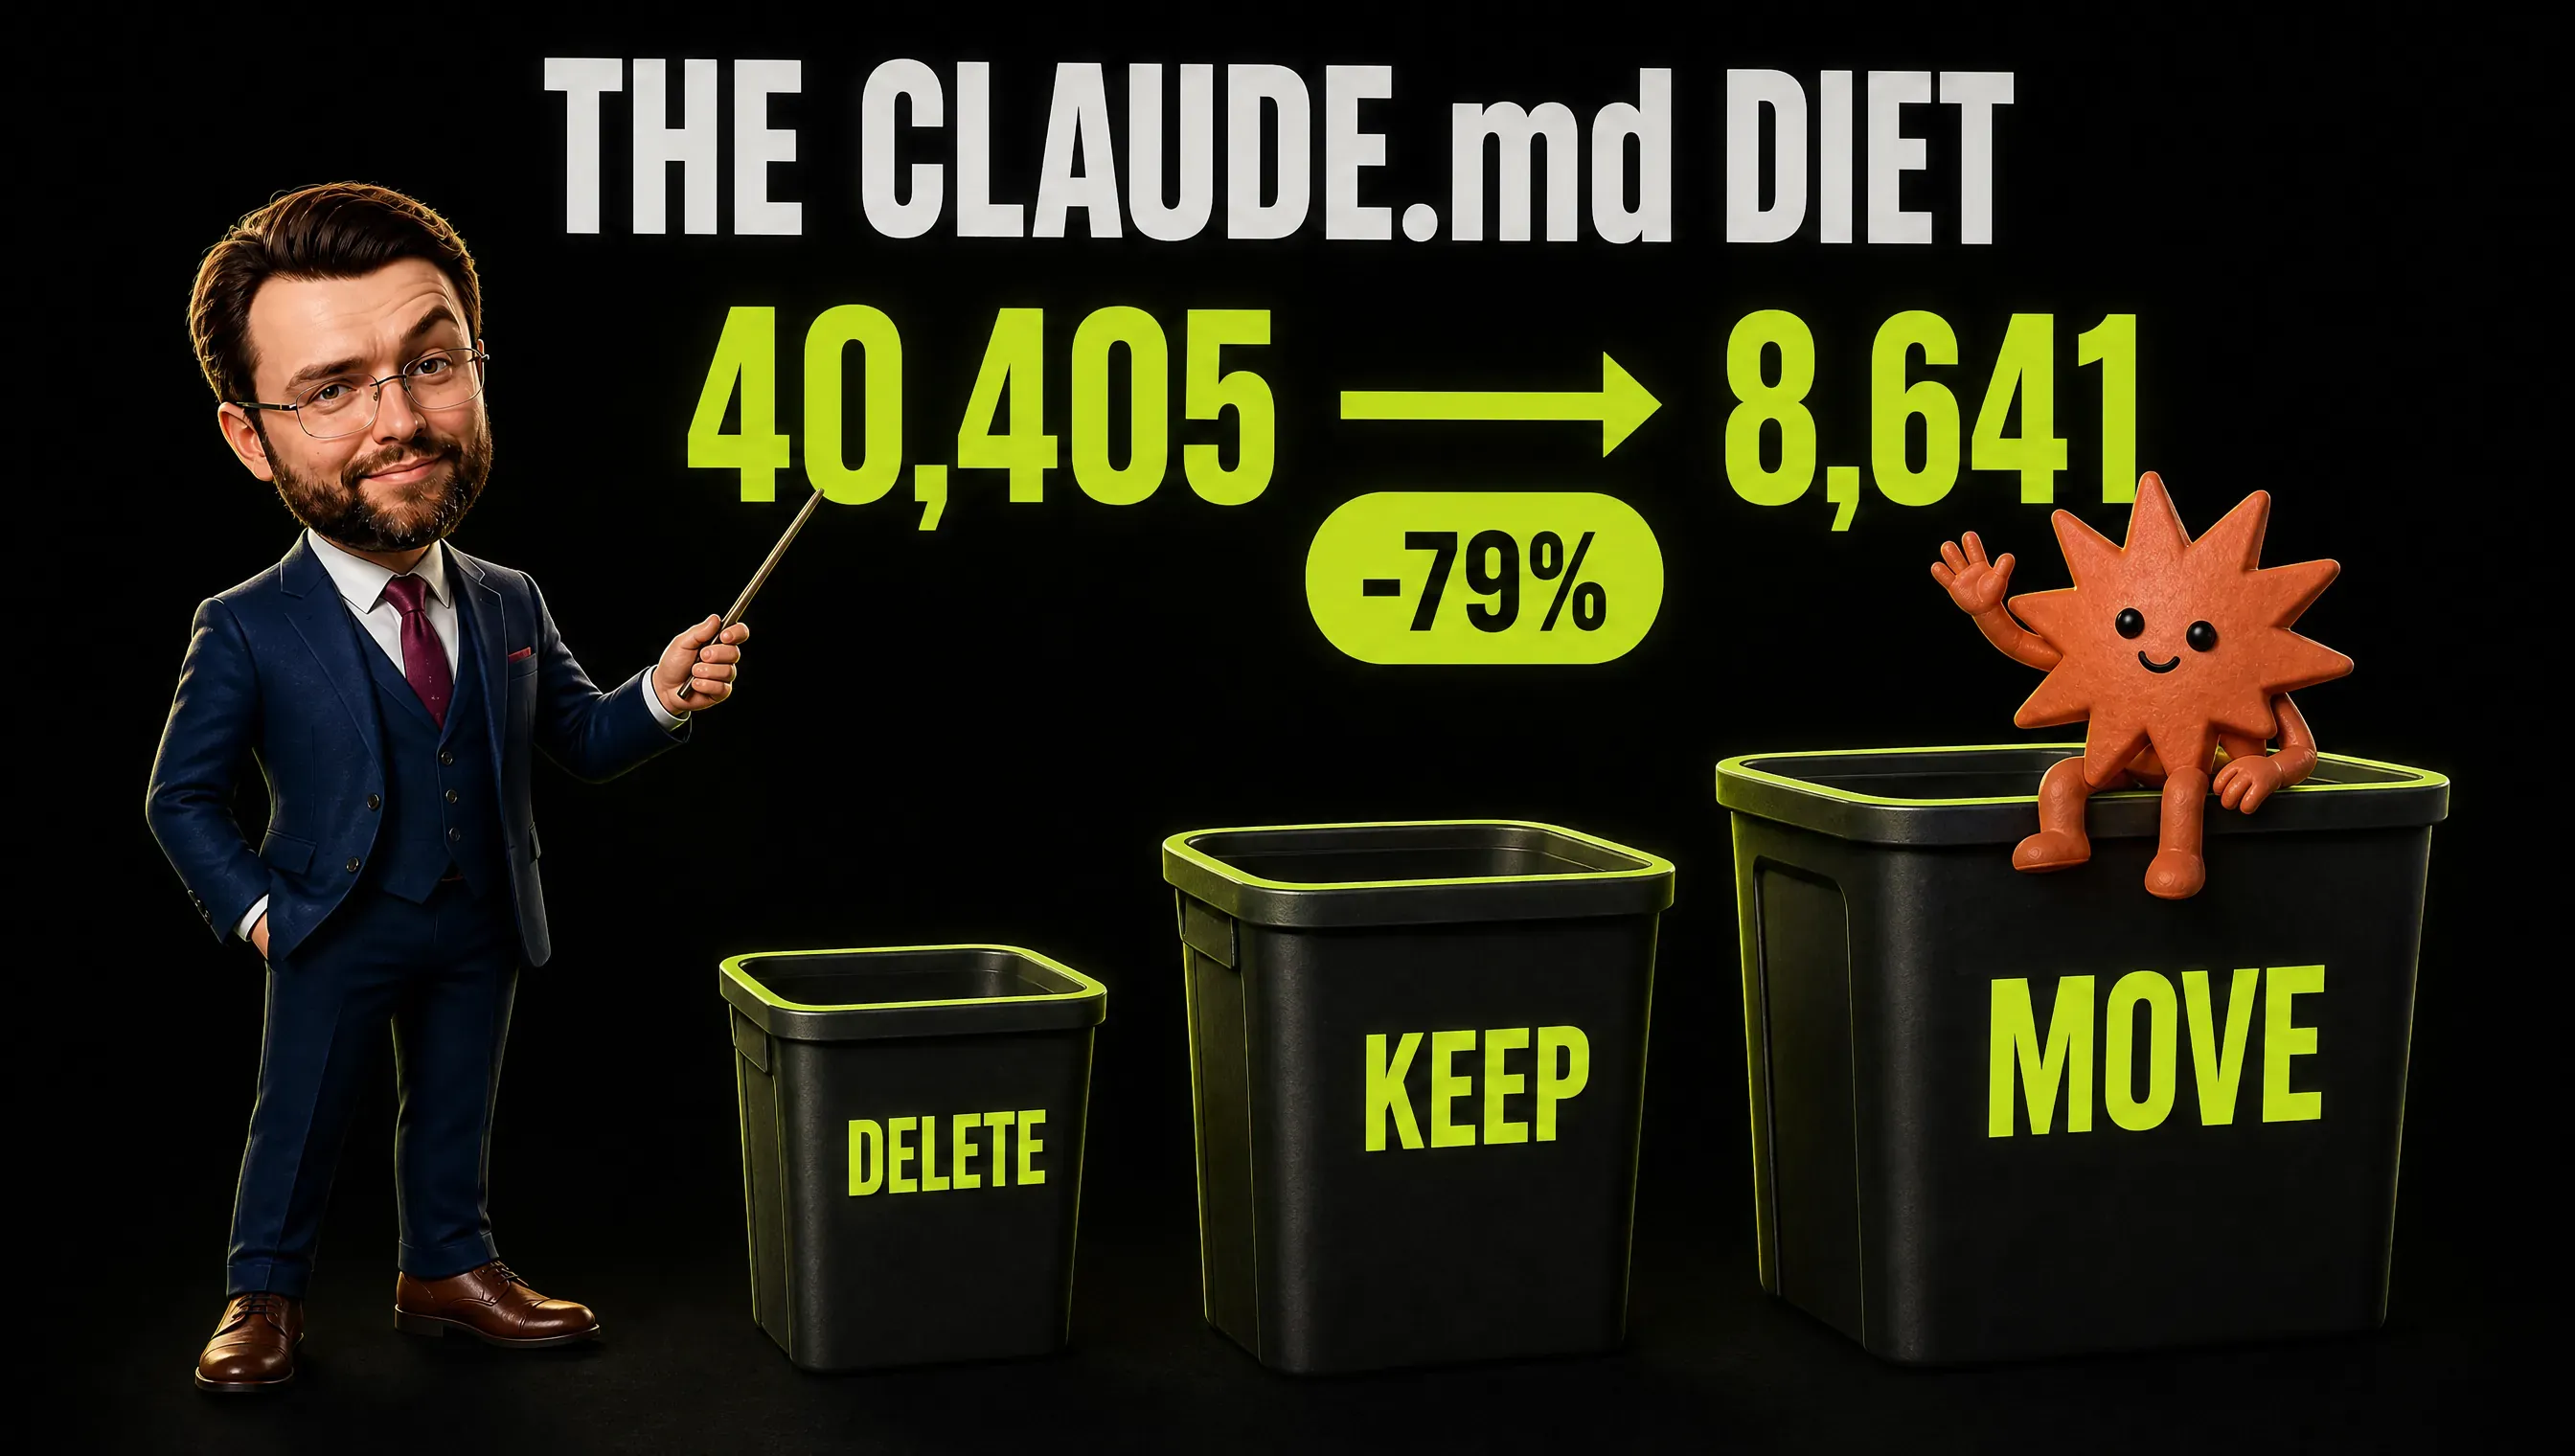
Perché spostare invece di cancellare? Per ciò che sono le mie istruzioni. Claude Fast dice che la maggior parte di ciò che ha tagliato era istruzione, non informazione: righe che dicevano al modello di fare attenzione o di ragionare passo per passo. Anthropic non elenca il suo 80 percento. Le mie sono per lo più fatti sull’attività di una persona che nessun modello può dedurre.
Un modello non può indovinare che voglio l’italiano come lingua predefinita. Non può sapere che la mia CDN rifiuta lo user agent predefinito degli script Python. Non può sapere che nessuna campagna pubblicitaria cambia senza il mio via libera esplicito. Claude Fast lo chiama “information the model cannot derive”, cioè informazione che il modello non può dedurre. Supera qualsiasi test. L’unica domanda è dove vive.
| Contenitore | Il test | Cosa ci è finito |
|---|---|---|
| Elimina | Un modello forte lo fa comunque, o due regole sono in disaccordo | Una vecchia regola di recupero che rimandava all’auto-memory esterna mentre un’altra regola la vietava. Ne ho tenuta una |
| Tieni, nel nucleo | Il modello non può dedurlo, o il caso peggiore è costoso | Le mie regole di voce e di lingua, la routine di avvio, i limiti di spesa e di approvazione, la tabella dei trigger |
| Sposta | Serve a volte, mai sempre | Procedure di pubblicazione, ricette per servizio, canoni di brand, regole per le immagini: 19 sezioni in 7 pagine |
Un avvertimento di Claude Fast, ed è giusto. Alcune righe sembrano noiose e sono oro. I fatti di progetto “sono le righe di maggior valore del tuo CLAUDE.md e sembrano noiose, il che le rende esattamente ciò che una pulizia troppo entusiasta distrugge.”
La progressive disclosure è un buon archivio
La soluzione di Anthropic al “metti tutto all’inizio” è un albero di file che si possono caricare al momento giusto. Il post chiama mito il contrario: la convinzione di dover tenere ogni pratica in un unico file centrale perché Claude “non la troverebbe altrimenti.” Claude Fast lo dice più in breve: Claude la troverà.
La mia versione è un archivio con budget di dimensione:
- Il router. Una nota indice di aziende e aree, poche migliaia di caratteri.
- L’indice di area. I clienti e le attività di una sola azienda.
- La nota di lavoro di una singola attività. Un obiettivo da 1.000 a 3.000 caratteri e un tetto di 10.000.
- Pagine wiki e fonti grezze. Si aprono solo quando un compito le richiede.
All’inizio di una sessione il modello legge il nucleo e una nota di lavoro. Il resto non lo legge. La maggior parte della mia memoria sta su disco e non costa nulla finché un trigger non la apre.
Una trappola da conoscere: gli import non sono progressive disclosure. La documentazione di Claude Code è netta: gli import aiutano a organizzare un file lungo ma non riducono il suo costo di contesto, perché anche i file importati si caricano all’avvio. Dividi un file di 600 righe in sei import e hai sei file e le stesse 600 righe. Ciò che fa risparmiare contesto è una regola che si carica solo per certe cartelle, una skill, o un semplice puntatore che il modello segue quando serve.
La seconda metà di questo cambio è sostituire le soglie con i criteri. L’esempio di Claude Fast mandava il lavoro ad agenti specialisti in base al numero di file. Una rinomina di 40 file supera la soglia ed è un lavoro meccanico. Una modifica a tre file che tocca una migrazione di database, un contratto API e un form richiede tre tipi di competenza. Così il criterio è diventato il numero di domini, più un esempio concreto di dove si colloca l’asticella.
Lo conosci dai budget. “Ogni spesa sopra 5.000 richiede approvazione” è una soglia. “Tutto ciò che non puoi annullare richiede approvazione” è un criterio. La soglia lascia passare l’errore da 4.900. Come regola tengo il criterio e un numero solo dove un cliente ha fissato un tetto reale.
Non esagerare. La guida di Shihipar a Fable avverte che se sei troppo specifico, Claude ti segue anche quando un cambio di rotta sarebbe meglio. Se sei troppo vago, riempie i vuoti con le solite buone pratiche generiche. Fai delle prove per trovare la via di mezzo.
La trappola della verifica e la lezione da 17 dollari
Ogni file di istruzioni che ho visto contiene una versione di “verifica il tuo lavoro prima di riferire.” Sembra diligenza. La guida di Anthropic a Opus 5 dice che si ritorce contro. Opus 5 verifica il proprio lavoro senza che tu glielo chieda, e le istruzioni di verifica esplicite “causano una verifica eccessiva su Claude Opus 5, e rimuoverle riduce i token sprecati senza perdita di qualità.”
La stessa guida avverte che Opus 5 delega ai subagenti più volentieri dei modelli precedenti e raccomanda limiti deterministici sul numero di quelli che possono girare.
Il 9 ottobre ho capito perché. Ho chiesto alla mia configurazione di fare ricerca per un articolo. Ha lanciato dieci agenti di ricerca in parallelo, che hanno ereditato l’effort massimo della sessione. Altri otto erano in programma.
L’ho fermata dopo sei minuti. Aveva fatto 233 chiamate ed elaborato circa 31 milioni di token, quasi tutti riletture di pagine web già presenti nel contesto. Il contatore d’uso mostrava circa 17 dollari. Il risultato della ricerca: zero dossier finiti.
Un secondo workflow quella mattina, senza effort impostato, ha elaborato circa 287 milioni di token in 40 minuti. Anthropic aveva avvertito che i suoi stessi workflow “possono finire per usare molti più token”.
La mia prima correzione era una cerimonia: stimare il costo e chiedermi conferma prima di ogni workflow. L’ho scartata perché più lenta e non più sicura. La seconda correzione è stata un’interfaccia. L’effort è diventato un parametro obbligatorio in ogni chiamata a un agente: low per ricerca web e lavoro meccanico, medium per scrittura e traduzione, high solo per un giudizio davvero difficile.
La guida di Anthropic a Opus 5.5 spiega perché aiuta: abbassare l’effort riduce il ragionamento, e con esso costi e latenza, “in modo più affidabile di quanto facciano le istruzioni nel prompt.” È il secondo cambio in pratica. Non descrivere il comportamento a parole. Progetta il comando.
L’effort però riduce il ragionamento, non le riletture. Il freno più forte è un limite. La guida di Opus 5 nomina CLAUDE_CODE_MAX_CONCURRENT_SUBAGENTS, CLAUDE_CODE_MAX_SUBAGENT_SPAWN_DEPTH e, per l’SDK, max_budget_usd, tutti da Claude Code 2.1.217. Sono impostazioni, non suggerimenti.
Due sfumature. La guida a Sonnet 5.5 dice che una sola istruzione di stop contro i subagenti revisori ha ridotto il costo della sessione di circa un terzo con effort massimo su compiti di codice, senza cambiare la qualità. Dice anche che con effort basso Sonnet 5.5 può saltare dei controlli, e un breve prompt che chiede controlli veri lo rende raro. Dipende dal modello e dall’effort.
Dove dovrebbe vivere, allora, la verifica? Nei controlli che il progetto ha già: test, una build, un hook. Aggiungi un revisore separato con una griglia di valutazione solo dove il gusto o la posta in gioco sono alti, come fanno i workflow di Anthropic, perché un modello tende a preferire i propri risultati. Un controllo che una macchina può far fallire vale più di una frase che chiede attenzione. Per ciò che serve a un controllo vero oltre a una frase che chiede attenzione, leggi il mio pezzo sul human in the loop AI.
Dove eliminare va storto
È un risultato sul codice. Anthropic ha scritto “nessuna perdita misurabile nelle nostre valutazioni sul codice.” Come ha notato AI Weekly, il post non spiega quali categorie di compiti abbiano retto. Non ho trovato nessun test pubblicato su voce di brand, testi legali o reportistica per i clienti. Metti alla prova i tuoi compiti.
È un consiglio per Claude 5. Anche dentro la famiglia le guide differiscono: la guida di Anthropic a Opus 5.5 dice che i nomi dei livelli di effort non corrispondono alla stessa quantità di ragionamento tra i modelli. Se il tuo stack mescola modelli, come il mio con GLM e Kimi accanto a Claude, regola le regole di comportamento modello per modello. I miei file speculari possono condividere un solo nucleo soltanto perché è fatto per lo più di fatti e puntatori validi per qualsiasi modello. Ho scritto su GLM 5.3 se vuoi il lato open-weight. Se smisti il lavoro tra i modelli Claude, il mio confronto tra Claude Haiku, Sonnet e Opus per il marketing mette i prezzi accanto ai lavori.
Una finestra grande non è lo stesso che attenzione. Il rapporto Context Rot di Chroma, di luglio 2025, ha testato 18 modelli, tra cui Claude 4, e ha trovato che l’affidabilità calava al crescere dell’input, anche su compiti semplici. Anthropic dice che il rispetto delle istruzioni, la chiamata degli strumenti e il ragionamento di Claude Opus 5 restano costanti lungo tutta la sua finestra da 1 milione di token, ma la guida non pubblica cifre. Modelli diversi, a un anno di distanza: non scommetterei né in un senso né nell’altro.
Due punti restano pratici qualunque affermazione sia vera. Nel test di memoria di Chroma, gli input mirati battevano quelli completi. E Manus ha fatto notare che su Claude Sonnet i token di input in cache costano un decimo di quelli non in cache, quindi un prefisso stabile fa risparmiare.
Memoria di Claude Code: affittarla o possederla
Il quinto cambio dice che la scorciatoia # è fuori e l’auto-memory è dentro: Claude ora salva i ricordi rilevanti per il lavoro e per te. La uso. La documentazione di Claude Code riporta i dettagli in piccolo. L’auto-memory è locale alla macchina per impostazione predefinita, a ogni sessione si caricano solo le prime 200 righe o 25 KB del suo indice, e salta tutto ciò che Claude può dedurre dal tuo codice.
Claude decide cosa salvare, il che è ottimo per abitudini e correzioni, le piccole cose che non scriveresti mai. È una cattiva casa per le decisioni che devi difendere in una riunione. È markdown semplice che puoi rivedere, ma sta comunque nella cartella di un solo strumento.
La mia regola: canone in file che possiedo, auto-memory breve, per lo più puntatori e piccole correzioni. Il vault si sposta tra le mie macchine e le stesse regole raggiungono altri agenti tramite il gemello AGENTS.md. La documentazione ora descrive Claude Code che legge AGENTS.md al posto di CLAUDE.md, quindi il gemello potrebbe essere un’abitudine da abbandonare.
Quando ho controllato i dodici repository di PhotoCraft per il mio articolo sull’alternativa open source a Photoshop, tutti avevano un AGENTS.md. I file di contesto sono il nuovo README.
Eliminare è una pratica, non un evento
Ecco la parte che nessuno mette in un titolo. Il 9 ottobre, tredici giorni dopo il mio taglio, il mio CLAUDE.md è di 10.127 caratteri. Cioè il 17 percento in più rispetto al giorno in cui l’ho sfoltito, e sopra il tetto di 10.000 che mi ero dato. I file di istruzioni ricrescono come erbacce, una aggiunta ragionevole alla volta.
Quindi tratto ogni regola come un’ipotesi con una data. Una regola nelle mie note riporta cosa, perché, come applicarla e il giorno in cui l’ho decisa. A luglio ho fissato tre volte in tre giorni la mia soglia di compattazione, cioè il numero di token a cui una sessione lunga viene riassunta: 500.000, poi 400.000, poi circa 100.000. Quella storia sta accanto alla regola.
Aggiungi un campo in più alle tue: come sapresti che è sicuro rimuoverla. Quando arriva un nuovo modello, chiediti se il motivo regge ancora.
Claude Fast ha una frase per questo: “Your old guidance does not become wrong retroactively”, cioè le tue vecchie indicazioni non diventano sbagliate retroattivamente. È cambiato il compromesso, non la logica. Voglio che il me stesso del futuro legga le mie regole come decisioni prese in condizioni precedenti, non come errori.
Un audit di CLAUDE.md in 30 minuti che puoi fare oggi
Imposta un timer. Calcola 30 minuti per un file breve, di più per uno grande. Ti servono una copia e un occhio onesto.
- Copia il file o fai il commit su git. Tieni l’originale. Niente di ciò che elimini è perso se puoi riaverlo.
- Esegui
/doctor prompt-audit. Richiede Claude Code v2.1.283 o successivo. Leggi il report: riferimenti morti, contraddizioni e regole scritte per modelli più vecchi. Non applicare ancora nulla. - Scegli da 3 a 5 compiti reali e salva i risultati. È la tua base di confronto.
- Ordina ogni riga: elimina, tieni o sposta. Elimina ciò che hai verificato che un modello forte fa comunque, come “fai attenzione”. Tieni ciò che non può dedurre e ciò che costa caro indovinare male. Sposta il resto dietro un puntatore. Tieni un ruolo o una riga “prima pensa” se un test mostra che aiuta, soprattutto fuori dal codice.
- Caccia duplicati e contraddizioni. Cerca ogni regola del nucleo. Se compare in tre posti, ne hai tre versioni.
- Trasforma “fai attenzione” in un controllo che una macchina può far fallire. Un test, un hook, una regola di blocco. Aggiungi un revisore con griglia di valutazione solo dove il gusto è il prodotto.
- Sostituisci le soglie con i criteri. Aggiungi un esempio concreto di dove passa la linea.
- Taglia a lotti e rilancia i compiti. Ripristina ogni lotto che peggiora i risultati. Poi metti una data a ciò che sopravvive e scrivi perché, e metti un promemoria in calendario per il prossimo rilascio di un modello.
Diffida delle righe che non sopporti di tagliare. Alcune sono oro. Quasi tutte sono tessuto cicatriziale.
Domande frequenti
Serve un file CLAUDE.md?
No, ma è il posto più economico per tenere ciò che Claude non può indovinare. Il consiglio di Anthropic è di tenerlo leggero, dire a cosa serve il repository e spendere la maggior parte dei token sulle insidie. L’auto-memory può coprire abitudini e correzioni.
Quanto dovrebbe essere lungo un CLAUDE.md?
La documentazione di Claude Code punta a meno di 200 righe per file, perché i file più lunghi costano contesto e riducono l’aderenza. Le righe sono una misura approssimativa: il mio è di 71 righe ma di circa 10.000 caratteri, quindi controllo le contraddizioni e i caratteri.
Eliminare istruzioni peggiora Claude?
Sulle sue valutazioni sul codice Anthropic non ha trovato alcuna perdita misurabile. Per altri lavori non c’è un test pubblico, quindi rimuovi le righe in piccoli lotti e confronta sui tuoi compiti. Un sintomo dalla documentazione di Claude Code: se Claude continua a ignorare una regola, il file è probabilmente troppo lungo.
Cosa fa /doctor?
Due cose, secondo la documentazione. Un controllo di sfoltimento propone tagli per un CLAUDE.md nel repository: elimina ciò che Claude può dedurre dal codice, come la struttura delle cartelle e gli elenchi delle dipendenze, e tiene insidie, motivazioni e convenzioni non standard (Claude Code v2.1.206 o successivo). /doctor prompt-audit trova le istruzioni scritte per modelli più vecchi, i riferimenti morti e le contraddizioni, e propone modifiche senza applicarle.
Il prompt engineering è morto?
No. Il brief per ogni lavoro lo scrivi ancora. Ciò che è morto è riempire il contesto permanente di regole che un modello forte già segue.
Il mio verdetto
La lezione di Anthropic non è “scrivi meno.” È questa: smetti di scrivere istruzioni che un modello forte già segue e comincia a curare ciò che non può sapere.
Il context engineering dopo Claude 5 sta su un biglietto:
- Taglia ciò che duplica la competenza.
- Tieni ciò che sai solo tu.
- Sposta ciò che è occasionale.
- Blocca tutto ciò che è pericoloso dietro un meccanismo, non una frase.
- Metti una data e torna a controllare.
Questa pagina riflette le guide al 9 ottobre 2026. Anthropic le rivede spesso, quindi controlla le date prima di fare affidamento su qualsiasi dettaglio.
Sei all’inizio con gli agenti? Parti dalla mia guida al vibe coding. Li usi già e vuoi un secondo paio d’occhi sui tuoi file di istruzioni o sulla tua configurazione? Contattami.


