Anthropic hat über 80% des Prompts von Claude Code gestrichen. Ich habe meine CLAUDE.md um 79% gekürzt.
Context Engineering mit Claude 5: Anthropic strich über 80% von Claude Codes Prompt. Was ich in meiner CLAUDE.md gelöscht, verschoben und behalten habe.
Am 24. Juli gab Anthropic bekannt, dass es für seine neuesten Modelle mehr als 80% des System-Prompts von Claude Code entfernt hat. Die Werte bei den Coding-Tests blieben stabil. Damit wurde ein Grossteil dessen, was Sie letztes Jahr über Context Engineering und CLAUDE.md gelesen haben, über Nacht fragwürdig.
Wenn Sie eine CLAUDE.md pflegen, sollte Sie das beunruhigen. Anthropic nennt vieles vom alten Rat inzwischen «Mythen»: Regeln vorgeben, Beispiele vorgeben, alles an den Anfang stellen, sich wiederholen.
Ich habe mein eigenes Setup geprüft. Ende September habe ich meine CLAUDE.md um 79% gekürzt, von 40.405 auf 8.641 Zeichen.
Den grössten Teil habe ich aber nicht gelöscht. Ich habe ihn hinter Verweise verschoben. Anthropics Geschichte handelt vor allem vom Löschen. Meine handelt vor allem vom Verschieben, und der Unterschied sagt viel darüber, was Ihre Anweisungen eigentlich sind.
Ich habe Anthropics Originalbeitrag gelesen, dazu die einschlägigen Abschnitte der Prompting-Guides für Opus 5, Opus 5.5, Fable 5.1 und Sonnet 5.5 sowie die Claude-Code-Dokumentation, und jedes Zitat bis zur Quelle zurückverfolgt. Ausgangspunkt war eine Zusammenfassung auf Claude Fast, den Rest habe ich in den Primärquellen nachgelesen.
Das Wichtigste vorab
- Anthropic hat über 80% des System-Prompts von Claude Code entfernt, ohne messbaren Verlust bei den Coding-Evaluierungen. Für Marketing, Texte oder Operations hat Anthropic denselben Test nicht veröffentlicht.
- Anthropics Diagnose lautete: zu viele Einschränkungen. Veraltete Worst-Case-Regeln und Regeln, die sich widersprechen, machten das Modell zum Schiedsrichter, bevor es arbeiten konnte. Auch die Länge zählt.
- Ein Test entscheidet über jede Zeile: Würde sich ein starkes Modell ohne sie schlechter verhalten? Dazu eine zweite Frage: Wie schlimm ist der schlimmste Fall, wenn es falsch rät?
- Löschen Sie Anweisungen, die die Fähigkeiten des Modells nur kopieren. Verschieben Sie gelegentlich benötigte Abläufe hinter Verweise. Behalten Sie die Fakten über Sie, die kein Modell erraten kann. Meine Datei schrumpfte um 79%, vor allem durch Verschieben.
- Legen Sie die Kontrolle in Prüfungen, an denen eine Maschine scheitern kann. Tests, Hooks und Deny-Regeln sind deterministisch. «Sei sorgfältig» ist eine Empfehlung, die Tokens kostet.
- Löschen ist eine Praxis, kein einmaliges Ereignis. Meine Datei wuchs in 13 Tagen um 17%. Datieren Sie jede Regel und halten Sie fest, warum es sie gibt, damit Sie sie bei einem neuen Modell erneut prüfen können.
Was ist Context Engineering, und wie unterscheidet es sich von Prompt Engineering?
Context Engineering ist die Gestaltung von allem, was ein Modell ausser Ihrer Frage liest: System-Prompt, CLAUDE.md-Dateien, Skills, Memory, Tool-Beschreibungen und Referenzdateien. Ein Prompt dient einer einzelnen Anfrage. Kontext wird tausendfach wiederverwendet, also wird eine falsche Zeile zu einer Steuer, die Sie jedes Mal zahlen.
Eine CLAUDE.md ist eine einfache Textdatei im Stammverzeichnis Ihres Projekts, die Claude Code zu Beginn jeder Sitzung liest. Sie enthält die Fakten, Regeln und Verweise, die das Modell nicht erraten kann. Gutes Context Engineering hält sie kurz, konkret und frei von Regeln, die das Modell ohnehin befolgt.
Der Begriff setzte sich im Juni 2025 durch, als Simon Willison die Reaktionen von Tobi Lütke (Shopify) und Andrej Karpathy sammelte, die ihn beide dem «Prompt Engineering» vorzogen. Anthropics Essay vom 29. September 2025 formulierte das Prinzip, das bis heute gilt: Finden Sie die kleinstmögliche Menge hochwertiger Tokens, die Ihr Ergebnis am wahrscheinlichsten macht.
Kontext scheitert ausserdem auf Arten, die bei einem einzelnen Prompt nicht vorkommen. Drew Breunig benannte im Juni 2025 vier: Vergiftung, Ablenkung, Verwirrung und Konflikt. Der Konflikt, also neue Informationen, die dem widersprechen, was schon im Kontext steht, ist das klarste Beispiel in Anthropics Juli-Beitrag.
Was Anthropic gestrichen hat
Der Beitrag heisst The new rules of context engineering for Claude 5 generation models, stammt von Thariq Shihipar und ist in sieben Minuten gelesen. Die Kernaussage: Anthropic hat für Modelle wie Claude Opus 5 und Claude Fable 5 über 80% des System-Prompts von Claude Code entfernt, «ohne messbaren Verlust bei unseren Coding-Evaluierungen».
Zwei Details zählen. Das erste ist der Geltungsbereich: Coding-Evaluierungen. Der Beitrag schlüsselt nicht auf, bei welchen Aufgaben die Qualität gehalten hat.
Das zweite ist die Diagnose. Anthropic sagt, es habe das Modell übermässig eingeschränkt, durch den System-Prompt, die CLAUDE.md-Dateien und die Skills. Die eigenen Transkripte zeigten widersprüchliche Botschaften in einer einzigen Anfrage, etwa «Dokumentation nach Bedarf belassen» an einer Stelle und «KEINE Kommentare hinzufügen» an einer anderen. Das Modell kann herausfinden, was Sie wollen, muss dafür aber erst härter nachdenken.
Anthropic hat nicht nur gelöscht. Es hat auch Verifikation und Code-Review in Skills verschoben, und es hat nicht veröffentlicht, wie sich die 80% auf Gelöschtes und Verschobenes aufteilen.
Nehmen Sie die Kommentarregel. Der alte System-Prompt wies Claude an, standardmässig keine Kommentare, keine langen Docstrings und keine Planungsdokumente zu schreiben, ausser auf Wunsch. Das war ein Kompromiss: Ältere Modelle schrieben schlechte Kommentare, also nahm Anthropic eine Regel in Kauf, die immer dann falsch war, wenn jemand Dokumentation wollte.
Der neue Prompt ersetzt sie durch einen einzigen Satz:
Schreibe Code, der sich liest wie der umgebende Code: Passe Kommentardichte, Benennung und Idiomatik an.
Claude Fast bringt den Wandel gut auf den Punkt: Eine Regel, die meistens stimmt, wurde zu einem Kriterium, das immer stimmt.
Das Muster kennen Sie aus dem Marketing. Das Brand Book sagt das eine, das Agentur-Briefing das andere, die nächtliche Mail des CEO etwas Drittes. Das Modell ist die Person, die einen einzigen Output liefern muss, der alle drei zufriedenstellt.
Die sechs Verschiebungen, übersetzt für alle, die keinen Code schreiben
Anthropic nennt sechs alte Gewohnheiten, die zu Mythen wurden. Hier ist die Business-Version jeder einzelnen, denn die Logik gilt für jedes Briefing, das Sie einem Menschen oder einer Maschine übergeben.
| Früher | Heute | Die Business-Version |
|---|---|---|
| Claude Regeln geben | Claude urteilen lassen | Geben Sie einer erfahrenen Fachkraft das Ziel und die Grenzen, nicht eine Checkliste mit 40 Punkten |
| Claude Beispiele geben | Schnittstellen gestalten | Lange Beispiellisten verengen, was das Modell versucht. Nennen Sie die Felder und die erlaubten Werte und behalten Sie ein bis zwei unterschiedliche Beispiele für den Stil |
| Alles an den Anfang stellen | Progressive Disclosure nutzen | Ein Ablagesystem, kein Ordner, den Sie vor jedem Meeting durchlesen |
| Sich wiederholen | Einfache Tool-Beschreibungen | Sagen Sie es einmal, dort, wo es gebraucht wird |
| Memory in CLAUDE.md-Dateien | Auto-Memory | Lassen Sie das Tool mitschreiben. Entscheidungen, die Sie vertreten müssen, gehören in Dateien, die Ihnen gehören |
| Einfache Specs | Reichhaltige Referenzen | Schicken Sie das Mockup, den Test oder das Bewertungsraster, nicht einen Absatz darüber |
Die zweite Verschiebung hat ein Vorbild von vor einem Jahr. Im Juli 2025 schrieb das Team hinter Manus, Sprachmodelle seien «hervorragende Nachahmer». Ihr Agent verfiel beim Durchsehen von 20 Lebensläufen oft in einen Rhythmus und wiederholte das Muster. Anthropic stellte fest, dass Beispiele in Tool-Beschreibungen einschränken, was ein Modell erkundet, und in einer Grafik seines Beitrags schrumpft die Beschreibung von TodoWrite von etwa 9.100 Zeichen auf eine Zeile. Andere Setups, ein verwandter Effekt.
Die vierte Verschiebung ist mein Favorit. Ältere Modelle konnten dem Ende des Kontexts stärker folgen als dem Anfang, also wiederholten Teams ihre wichtigsten Regeln. Anthropic strich die Wiederholungen und verlegte die Hinweise zu den Tools in die Tool-Beschreibungen.
Wiederholung ist auch der Ort, an dem Widersprüche entstehen. Sagen Sie eine Regel an drei Stellen, und früher oder später ändern Sie nur zwei davon.
Der eine Test hinter jeder Zeile und die Frage, die er auslässt
Claude Fast fasst die Methode in einer Frage pro Zeile zusammen: Würde sich ein starkes Modell ohne diese Zeile schlechter verhalten? Wenn nicht, löschen.
Das ist ein guter Test, und er ist nicht neu. Die Claude-Code-Dokumentation enthält schon einen Zwilling: «Würde das Entfernen dazu führen, dass Claude Fehler macht?», gefolgt von «Wenn nicht, streichen.» Die Dokumentation nennt auch den Grund: Aufgeblähte CLAUDE.md-Dateien führen dazu, dass Claude Ihre eigentlichen Anweisungen ignoriert. Neu seit Juli ist, wie viele Zeilen den Test nicht bestehen.
Was der Test auslässt: Wie schlimm ist der schlimmste Fall? Anthropic sagt, die frühen Regeln hätten existiert, um Worst-Case-Szenarien wie das Löschen von Dateien zu vermeiden. Ein starkes Modell macht es vielleicht 999 von 1.000 Mal richtig. Beim tausendsten Mal verlieren Sie einen Kunden.
Selbst wenn Ihnen Anthropics Guide für Sonnet 5.5 einen Prompt für mehr Autonomie mitgibt, fügt er hinzu, der Prompt «ersetzt nicht Ihre eigenen Regeln zu riskanten oder nicht rückgängig zu machenden Aktionen. Behalten Sie diese Regeln in Ihrem System-Prompt.»
Bewerten Sie also jede Zeile zweimal. Wie wahrscheinlich ist es, dass das Modell es allein richtig macht, und was kostet es, wenn nicht? Billig und wahrscheinlich: löschen. Teuer: die Regel behalten und mit etwas absichern, das sich nicht wegdiskutieren lässt. Die Dokumentation zieht die Linie selbst: CLAUDE.md-Anweisungen sind beratend, Hooks sind deterministisch.
Am 9. Oktober stoppte der Auto-Modus von Claude Code, in dem ein separates Klassifikatormodell die Aktionen prüft, ein Skript, das auf ein produktives Live-System schreiben wollte. Es blieb gestoppt, bis ich einen Satz schrieb, der die Aktion, die Ressource und das Skript nannte. «Mach weiter» reichte nicht.
Eine Regel in einer Datei ist eine Empfehlung. Ein zweites Modell, das mitprüft, ist besser. Nur ein Hook oder eine Deny-Regel ist eine Garantie.
Context Engineering nach Claude 5: Löschen, Behalten oder Verschieben
Mein Vault ist ein zweites Gehirn, das auf Claude Code läuft. Das Setup habe ich in meinem Artikel zum zweiten Gehirn erklärt. Die CLAUDE.md in seinem Stammverzeichnis ist der Kern: Sie wird in jeder Sitzung geladen, egal ob ich an einem Kunden, einer Kampagne oder diesem Blog arbeite.
Im September war sie auf 40.405 Zeichen angewachsen. Am 26. September liess ich sie von meinen Agenten neu aufbauen. Die neue Datei hat 8.641 Zeichen, ein Minus von 79%. Fünf Arbeitsnotizen schrumpften im selben Durchgang um 41% bis 79%, eine davon von 17.363 auf 4.883 Zeichen.
Jetzt kommt der Haken. Ich habe den grössten Teil nicht gelöscht. Ich habe ihn verschoben.
Die 79% beziehen sich auf die Grösse, die immer geladen wird. Die 19 Abschnitte der alten Datei liegen heute in sieben Wiki-Seiten, die sich auf einen Auslöser hin öffnen. Der verbleibende Kern hat sechs kurze Abschnitte: Identität und Stil, Sitzungsstart und Protokollierung, Schreiben und Suchen, harte Grenzen, eine Tabelle mit 13 Auslösern und die Regeln für die Pflege der Datei selbst.
Jeder Auslöser sagt: Wenn du daran arbeitest, öffne zuerst diese Seite. Nichts wird importiert. Das neue Risiko ist ein Auslöser, der nicht greift, deshalb nennt jeder Auslöser seine Seite.
Bevor ich irgendetwas anfasste, sicherten meine Agenten 18 Dateien mit einer Prüfsumme. Danach kontrollierten sie, dass die Zwillingsdatei AGENTS.md Byte für Byte identisch war und dass 205 Links über Kern, Handbuch und Chroniken hinweg weiterhin aufgelöst wurden.
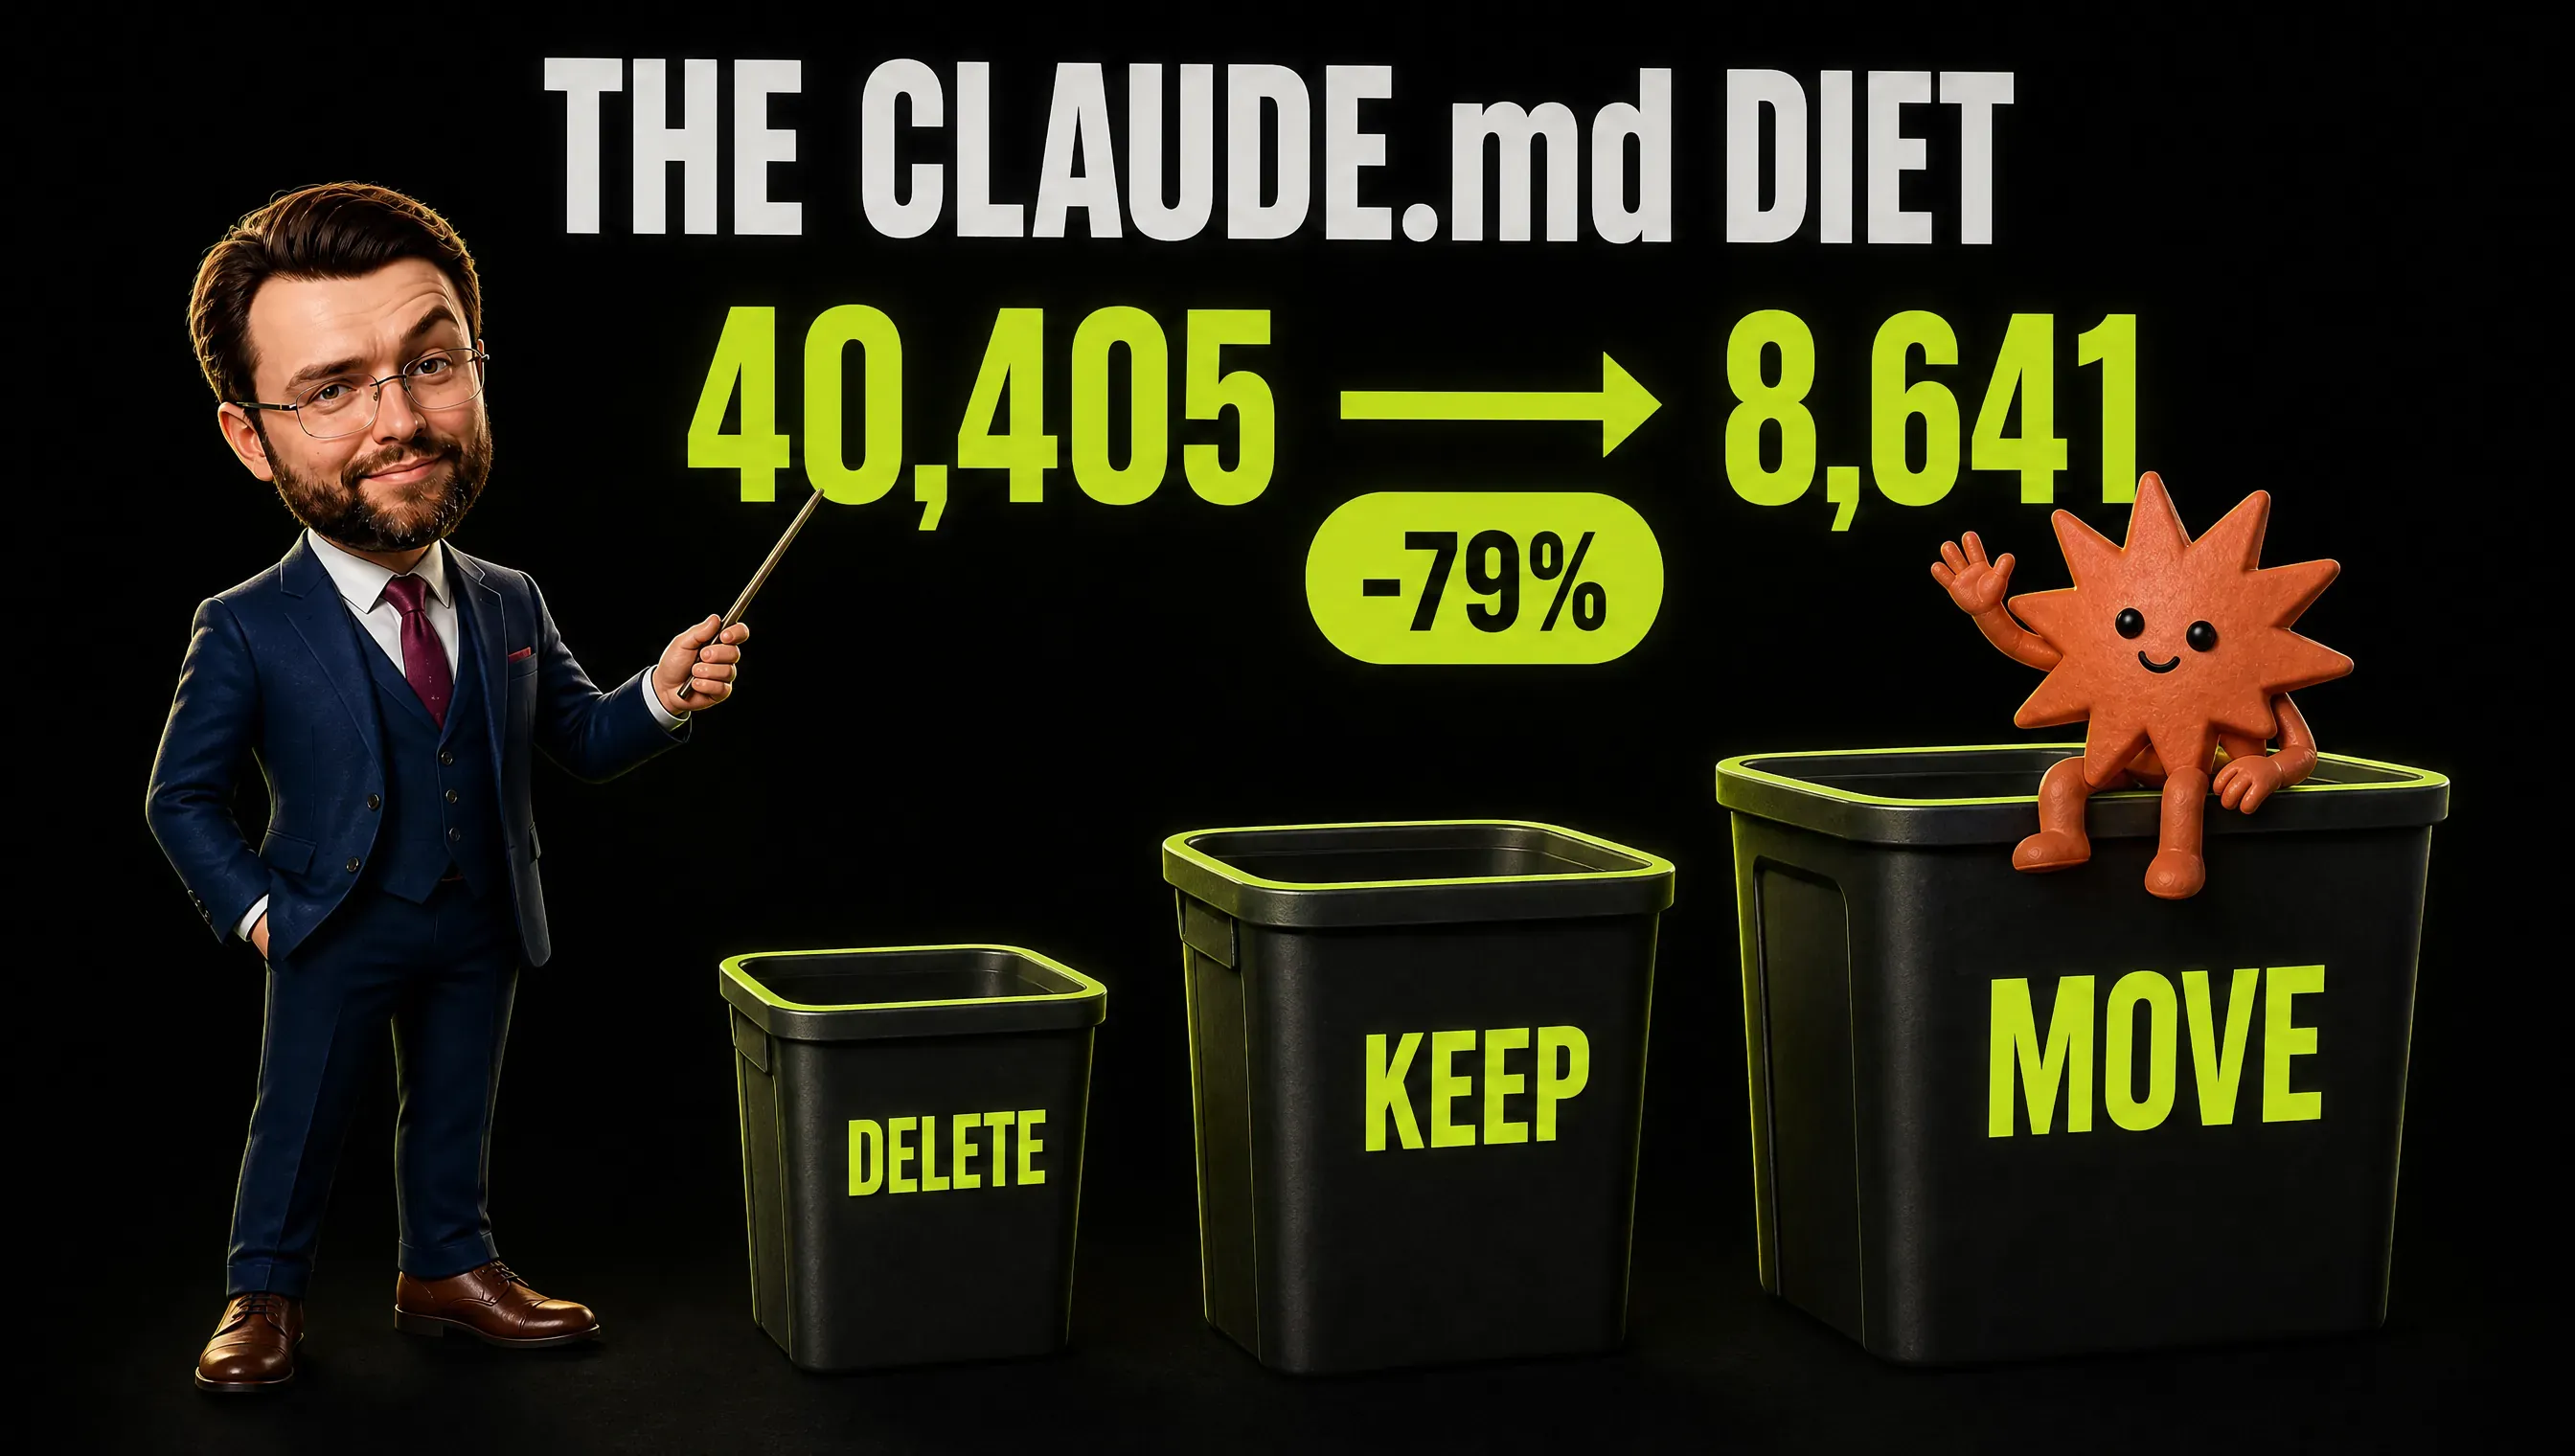
Warum verschieben statt löschen? Wegen der Art meiner Anweisungen. Claude Fast sagt, das meiste, was dort gestrichen wurde, sei Instruktion gewesen und keine Information: Zeilen, die das Modell auffordern, sorgfältig zu sein oder Schritt für Schritt zu denken. Anthropic schlüsselt seine 80% nicht auf. Meine sind überwiegend Fakten über das Geschäft einer einzelnen Person, die kein Modell herleiten kann.
Ein Modell kann nicht erraten, dass ich standardmässig Italienisch will. Es kann nicht wissen, dass mein CDN den Standard-User-Agent von Python-Skripten ablehnt. Es kann nicht wissen, dass keine Werbekampagne ohne mein ausdrückliches Okay geändert wird. Claude Fast nennt das «Informationen, die das Modell nicht ableiten kann». Sie überstehen jeden Test. Offen bleibt nur, wo sie liegen.
| Behälter | Der Test | Was hineinkam |
|---|---|---|
| Löschen | Ein starkes Modell tut es ohnehin, oder zwei Regeln widersprechen sich | Eine alte Abruf-Regel, die auf externes Auto-Memory verwies, während eine andere Regel es verbot. Ich habe eine behalten |
| Behalten, im Kern | Das Modell kann es nicht ableiten, oder der schlimmste Fall ist teuer | Meine Stil- und Sprachregeln, die Startroutine, Ausgabe- und Freigabegrenzen, die Tabelle der Auslöser |
| Verschieben | Manchmal nötig, nie immer | Veröffentlichungsabläufe, Rezepte pro Dienst, Marken-Kanons, Bildregeln: 19 Abschnitte in 7 Seiten |
Eine Warnung von Claude Fast, und sie stimmt. Manche Zeilen wirken langweilig und sind Gold. Projektfakten «sind die wertvollsten Zeilen in Ihrer CLAUDE.md, und sie wirken langweilig, weshalb ein übereifriger Löschdurchgang genau sie zerstört.»
Progressive Disclosure ist gute Ablage
Anthropics Antwort auf «alles an den Anfang» ist ein Baum aus Dateien, die zum richtigen Zeitpunkt geladen werden können. Das Gegenteil nennt der Beitrag einen Mythos: den Glauben, man müsse jede Praxis in einer zentralen Datei halten, weil Claude sie «sonst nicht finden würde». Claude Fast sagt es kürzer: Claude findet es.
Meine Version ist ein Ablagesystem mit Grössenbudgets:
- Der Router. Eine Indexnotiz mit Unternehmen und Bereichen, ein paar tausend Zeichen.
- Der Bereichsindex. Die Kunden und Aktivitäten eines Unternehmens.
- Die Arbeitsnotiz einer Aktivität. Ein Ziel von 1.000 bis 3.000 Zeichen und eine Obergrenze von 10.000.
- Wiki-Seiten und Rohquellen. Sie werden nur geöffnet, wenn eine Aufgabe sie braucht.
Zu Beginn einer Sitzung liest das Modell den Kern und eine Arbeitsnotiz. Den Rest liest es nicht. Der grösste Teil meines Gedächtnisses liegt auf der Festplatte und kostet nichts, bis ein Auslöser ihn öffnet.
Eine Falle, die man kennen sollte: Imports sind keine Progressive Disclosure. Die Claude-Code-Dokumentation ist da eindeutig: Imports helfen, eine lange Datei zu organisieren, verringern aber nicht ihre Kontextkosten, weil importierte Dateien ebenfalls beim Start geladen werden. Wer eine Datei mit 600 Zeilen in sechs Imports aufteilt, hat sechs Dateien und dieselben 600 Zeilen. Kontext sparen Sie mit einer Regel, die nur für bestimmte Ordner geladen wird, mit einem Skill oder mit einem schlichten Verweis, dem das Modell bei Bedarf folgt.
Die zweite Hälfte dieser Verschiebung heisst: Schwellenwerte durch Kriterien ersetzen. Claude Fasts Beispiel schickte Arbeit nach Dateianzahl an Spezialisten-Agenten. Eine Umbenennung über 40 Dateien überschreitet die Schwelle und ist eine mechanische Aufgabe. Eine Änderung an drei Dateien, die eine Datenbankmigration, einen API-Vertrag und ein Formular berührt, braucht drei Arten von Fachwissen. Also wurde das Kriterium zur Anzahl der Fachgebiete, plus ein ausgearbeitetes Beispiel dafür, wo die Latte liegt.
Aus Budgets kennen Sie das. «Jede Ausgabe über 5.000 braucht eine Freigabe» ist ein Schwellenwert. «Alles, was sich nicht rückgängig machen lässt, braucht eine Freigabe» ist ein Kriterium. Der Schwellenwert lässt den Fehler bei 4.900 durch. Ich behalte das Kriterium als Regel und eine Zahl nur dort, wo ein Kunde eine echte Obergrenze gesetzt hat.
Schiessen Sie nicht über das Ziel hinaus. Shihipars Fable-Feldführer warnt: Sind Sie zu konkret, folgt Claude Ihnen auch dann, wenn ein Kurswechsel besser wäre. Sind Sie zu vage, füllt es die Lücken mit generischen Best Practices. Testen Sie, um die Mitte zu finden.
Die Verifikationsfalle und die Lektion für 17 Dollar
Jede Anweisungsdatei, die ich je gesehen habe, enthält irgendeine Version von «prüfe deine Arbeit, bevor du berichtest». Das fühlt sich nach Sorgfalt an. Anthropics Opus-5-Guide sagt, es schlägt ins Gegenteil um. Opus 5 prüft seine Arbeit von selbst, und ausdrückliche Verifikationsanweisungen «führen bei Claude Opus 5 zu Über-Verifikation, und ihr Entfernen reduziert verschwendete Tokens ohne Qualitätsverlust.»
Derselbe Guide warnt, dass Opus 5 bereitwilliger an Subagenten delegiert als frühere Modelle, und empfiehlt deterministische Obergrenzen dafür, wie viele gleichzeitig laufen dürfen.
Am 9. Oktober habe ich gelernt, warum. Ich bat mein Setup, für einen Artikel zu recherchieren. Es startete zehn Recherche-Agenten parallel, und sie erbten den maximalen Effort der Sitzung. Acht weitere waren geplant.
Nach sechs Minuten habe ich es gestoppt. Es hatte 233 Aufrufe gemacht und etwa 31 Millionen Tokens verarbeitet, fast alle davon erneute Lesevorgänge von Webseiten, die schon im Kontext lagen. Die Nutzungsanzeige zeigte rund 17 Dollar. Das Rechercheergebnis: null fertige Dossiers.
Ein zweiter Workflow am selben Morgen, ohne gesetzten Effort, verarbeitete in 40 Minuten rund 287 Millionen Tokens. Anthropic hatte gewarnt, dass die eigenen Workflows «am Ende deutlich mehr Tokens verbrauchen können».
Meine erste Korrektur war ein Ritual: die Kosten schätzen und mich vor jedem Workflow fragen. Ich habe es verworfen, weil es langsamer und nicht sicherer war. Die zweite Korrektur war eine Schnittstelle. Effort wurde bei jedem Agentenaufruf zum Pflichtparameter: low für Webrecherche und mechanische Arbeit, medium für Schreiben und Übersetzen, high nur für ein wirklich schwieriges Urteil.
Anthropics Guide für Opus 5.5 erklärt, warum das hilft: Ein niedrigerer Effort senkt das Nachdenken und damit Kosten und Latenz, «zuverlässiger als Prompt-Anweisungen». Das ist die zweite Verschiebung in der Praxis. Beschreiben Sie das Verhalten nicht in Prosa. Gestalten Sie den Regler.
Effort senkt aber das Nachdenken, nicht das erneute Lesen. Die stärkere Bremse ist eine Obergrenze. Der Opus-5-Guide nennt CLAUDE_CODE_MAX_CONCURRENT_SUBAGENTS, CLAUDE_CODE_MAX_SUBAGENT_SPAWN_DEPTH und, für das SDK, max_budget_usd, alle ab Claude Code 2.1.217. Das sind Einstellungen, keine Empfehlungen.
Zwei Nuancen. Der Sonnet-5.5-Guide sagt, eine einzige Stopp-Anweisung gegen Reviewer-Subagenten habe die Sitzungskosten bei maximalem Effort in Coding-Aufgaben um rund ein Drittel gesenkt, ohne Qualitätsänderung. Er sagt auch, dass Sonnet 5.5 bei niedrigem Effort Prüfungen überspringen kann und ein kurzer Prompt, der echte Prüfungen verlangt, das selten macht. Es hängt vom Modell und vom Effort ab.
Wo soll Verifikation also leben? In den Prüfungen, die das Projekt ohnehin hat: Tests, ein Build, ein Hook. Einen separaten Reviewer mit Bewertungsraster ergänzen Sie nur dort, wo Geschmack oder viel auf dem Spiel steht, wie in Anthropics Workflows, denn ein Modell bevorzugt tendenziell die eigenen Ergebnisse. Eine Prüfung, an der eine Maschine scheitern kann, schlägt einen Satz, der um Sorgfalt bittet.
Was eine echte Prüfung über einen Satz hinaus braucht, steht in meinem Beitrag über Human in the Loop KI.
Wo Löschen schiefgeht
Es ist ein Coding-Ergebnis. Anthropic schrieb «ohne messbaren Verlust bei unseren Coding-Evaluierungen». Wie AI Weekly anmerkte, schlüsselt der Beitrag nicht auf, bei welchen Aufgabenkategorien die Qualität hielt. Ich habe keinen veröffentlichten Test zu Markenstimme, Rechtstexten oder Kundenreporting gefunden. Testen Sie Ihre eigenen Aufgaben.
Es ist ein Rat für Claude 5. Selbst innerhalb der Familie unterscheiden sich die Guides: Anthropics Opus-5.5-Guide sagt, die Namen der Effort-Stufen entsprächen bei verschiedenen Modellen nicht derselben Menge an Nachdenken. Wenn Ihr Stack Modelle mischt, wie meiner mit GLM und Kimi neben Claude, stimmen Sie die Verhaltensregeln pro Modell ab. Meine gespiegelten Dateien können nur deshalb einen gemeinsamen Kern teilen, weil er überwiegend aus modellneutralen Fakten und Verweisen besteht. Über GLM 5.3 habe ich geschrieben, falls Sie die Open-Weight-Seite interessiert.
Wenn Sie Aufgaben auf verschiedene Claude-Modelle verteilen, stellt mein Vergleich Claude Haiku, Sonnet und Opus für Marketing die Preise neben die Jobs.
Ein grosses Fenster ist nicht dasselbe wie Aufmerksamkeit. Chromas Context-Rot-Bericht vom Juli 2025 testete 18 Modelle, darunter Claude 4, und stellte fest, dass die Zuverlässigkeit mit wachsendem Input sank, selbst bei einfachen Aufgaben. Anthropic sagt, dass Instruktionsbefolgung, Tool-Aufrufe und Reasoning von Claude Opus 5 über das gesamte 1-Mio.-Token-Fenster konstant bleiben, doch der Guide veröffentlicht keine Zahlen. Andere Modelle, ein Jahr Abstand: Ich würde auf keine der beiden Seiten wetten.
Zwei Punkte bleiben praxisnah, welche Aussage auch stimmt. In Chromas Memory-Test schlugen fokussierte Inputs die vollständigen. Und Manus wies darauf hin, dass gecachte Input-Tokens bei Claude Sonnet ein Zehntel der ungecachten kosten, ein stabiles Präfix spart also Geld.
Claude Code Memory: mieten oder besitzen
Die fünfte Verschiebung sagt, der #-Hotkey ist raus und Auto-Memory ist drin: Claude speichert jetzt Erinnerungen, die für die Arbeit und für Sie relevant sind. Ich nutze es. Das Kleingedruckte steht in der Claude-Code-Dokumentation. Auto-Memory ist standardmässig lokal auf dem Rechner, bei jeder Sitzung werden nur die ersten 200 Zeilen oder 25 KB des Index geladen, und alles, was Claude aus Ihrem Code ableiten kann, wird übersprungen.
Claude entscheidet, was gespeichert wird. Das ist ideal für Gewohnheiten und Korrekturen, die kleinen Dinge, die Sie nie aufschreiben würden. Als Ablage für Entscheidungen, die Sie in einem Meeting vertreten müssen, taugt es schlecht. Es ist einfaches Markdown, das Sie prüfen können, liegt aber trotzdem im Ordner eines einzelnen Tools.
Meine Regel: Der Kanon liegt in Dateien, die mir gehören, Auto-Memory bleibt kurz und enthält vor allem Verweise und kleine Korrekturen. Der Vault wandert zwischen meinen Rechnern, und dieselben Regeln erreichen über den AGENTS.md-Zwilling andere Agenten. Die Dokumentation beschreibt inzwischen, dass Claude Code AGENTS.md anstelle von CLAUDE.md liest, der Zwilling ist also vielleicht eine Gewohnheit, die ich ablegen kann.
Als ich für meinen Artikel zur Open-Source-Photoshop-Alternative die zwölf PhotoCraft-Repositories prüfte, lieferte jedes einzelne eine AGENTS.md mit. Kontextdateien sind das neue README.
Löschen ist eine Praxis, kein Ereignis
Hier kommt der Teil, den niemand in eine Schlagzeile schreibt. Am 9. Oktober, dreizehn Tage nach meinem Schnitt, hat meine CLAUDE.md 10.127 Zeichen. Das sind 17% mehr als am Tag des Kürzens und mehr als die Obergrenze von 10.000, die ich mir selbst gesetzt habe. Anweisungsdateien wachsen nach wie Unkraut, eine vernünftige Ergänzung nach der anderen.
Deshalb behandle ich jede Regel als Hypothese mit Datum. Eine Regel in meinen Notizen trägt, was sie besagt, warum, wie man sie anwendet und an welchem Tag ich sie beschlossen habe. Meine Compaction-Schwelle, also die Token-Zahl, ab der eine lange Sitzung zusammengefasst wird, habe ich im Juli innerhalb von drei Tagen dreimal festgelegt: 500.000 Tokens, dann 400.000, dann etwa 100.000. Diese Geschichte steht neben der Regel.
Fügen Sie Ihrer Notiz ein weiteres Feld hinzu: woran Sie erkennen, dass die Regel gefahrlos entfernt werden kann. Wenn ein neues Modell erscheint, fragen Sie, ob der Grund noch gilt.
Claude Fast hat dafür einen Satz: «Ihre alte Anleitung wird nicht rückwirkend falsch.» Der Kompromiss hat sich geändert, nicht die Logik. Ich möchte, dass mein künftiges Ich meine Regeln als Entscheidungen unter älteren Bedingungen liest und nicht als Fehler.
Ein CLAUDE.md-Audit in 30 Minuten, das Sie heute durchführen können
Stellen Sie einen Timer. Rechnen Sie mit 30 Minuten für eine kurze Datei, bei einer grossen mit mehr. Sie brauchen eine Kopie und einen ehrlichen Blick.
- Kopieren Sie die Datei oder committen Sie sie in Git. Behalten Sie das Original. Nichts, was Sie löschen, ist verloren, wenn Sie es zurückholen können.
- Führen Sie
/doctor prompt-auditaus. Es braucht Claude Code ab Version 2.1.283. Lesen Sie den Bericht auf tote Verweise, Widersprüche und Regeln, die für ältere Modelle geschrieben wurden. Wenden Sie noch nichts an. - Wählen Sie 3 bis 5 echte Aufgaben und speichern Sie die Ergebnisse. Das ist Ihre Baseline.
- Sortieren Sie jede Zeile: löschen, behalten oder verschieben. Löschen Sie, was ein starkes Modell, wie Sie getestet haben, ohnehin tut, etwa «sei sorgfältig». Behalten Sie, was es nicht ableiten kann und was bei falschem Raten teuer wird. Verschieben Sie den Rest hinter einen Verweis. Behalten Sie eine Rollenzeile oder eine «denk zuerst nach»-Zeile, wenn ein Test zeigt, dass sie hilft, besonders ausserhalb von Coding.
- Suchen Sie Duplikate und Widersprüche. Suchen Sie nach jeder Kernregel. Taucht sie an drei Stellen auf, haben Sie drei Versionen davon.
- Machen Sie aus «sei sorgfältig» eine Prüfung, an der eine Maschine scheitern kann. Ein Test, ein Hook, eine Deny-Regel. Ergänzen Sie einen Reviewer mit Bewertungsraster nur dort, wo Geschmack das Produkt ist.
- Tauschen Sie Schwellenwerte gegen Kriterien. Fügen Sie ein ausgearbeitetes Beispiel hinzu, wo die Linie verläuft.
- Kürzen Sie in Etappen und führen Sie die Aufgaben erneut aus. Stellen Sie jede Etappe wieder her, die die Ergebnisse verschlechtert. Datieren Sie dann, was übrig bleibt, begründen Sie es und tragen Sie sich einen Termin für die nächste Modellveröffentlichung in den Kalender ein.
Misstrauen Sie den Zeilen, von denen Sie sich nicht trennen können. Manche sind Gold. Die meisten sind Narbengewebe.
Häufig gestellte Fragen
Braucht es eine CLAUDE.md?
Nein, aber sie ist der günstigste Ort für das, was Claude nicht erraten kann. Anthropics Rat lautet: schlank halten, sagen, wofür das Repository da ist, und die meisten Tokens für Stolpersteine verwenden. Auto-Memory kann Gewohnheiten und Korrekturen abdecken.
Wie lang sollte eine CLAUDE.md sein?
Die Claude-Code-Dokumentation peilt unter 200 Zeilen pro Datei an, weil längere Dateien Kontext kosten und die Befolgung verschlechtern. Zeilen sind ein grobes Mass: Meine hat 71 Zeilen, aber rund 10.000 Zeichen, also achte ich auf Widersprüche und Zeichen.
Macht Löschen von Anweisungen Claude schlechter?
Bei seinen Coding-Evaluierungen fand Anthropic keinen messbaren Verlust. Für andere Arbeit gibt es keinen öffentlichen Test, also entfernen Sie Zeilen in kleinen Etappen und vergleichen Sie anhand Ihrer eigenen Aufgaben. Ein Symptom aus der Claude-Code-Dokumentation: Wenn Claude eine Regel immer wieder ignoriert, ist die Datei wahrscheinlich zu lang.
Was macht /doctor?
Laut Dokumentation zwei Dinge. Eine Trim-Prüfung schlägt Kürzungen für eine eingecheckte CLAUDE.md vor: Sie streicht, was Claude aus dem Code ableiten kann, etwa Verzeichnisstrukturen und Abhängigkeitslisten, und behält Stolpersteine, Begründungen und Konventionen, die vom Standard abweichen (ab Claude Code v2.1.206). /doctor prompt-audit findet Anweisungen, die für ältere Modelle geschrieben wurden, tote Verweise und Widersprüche und schlägt Änderungen vor, ohne sie anzuwenden.
Ist Prompt Engineering tot?
Nein. Das Briefing für jede einzelne Aufgabe schreiben Sie weiterhin. Tot ist die Praxis, den Standardkontext mit Regeln zu füllen, die ein starkes Modell ohnehin befolgt.
Mein Fazit
Anthropics Lehre lautet nicht «schreibe weniger». Sie lautet: Hören Sie auf, Anweisungen zu schreiben, die ein starkes Modell ohnehin befolgt, und beginnen Sie, das zu kuratieren, was es nicht wissen kann.
Gutes Context Engineering nach Claude 5 passt auf eine Karte:
- Kürzen Sie, was nur die Fähigkeiten des Modells dupliziert.
- Behalten Sie, was nur Sie wissen.
- Verschieben Sie, was nur gelegentlich gebraucht wird.
- Sichern Sie alles Gefährliche mit einem Mechanismus ab, nicht mit einem Satz.
- Datieren Sie es und kommen Sie wieder.
Diese Seite gibt den Stand der Guides am 9. Oktober 2026 wieder. Anthropic überarbeitet sie häufig, prüfen Sie also die Daten, bevor Sie sich auf ein Detail verlassen.
Neu im Bauen mit Agenten? Beginnen Sie mit meinem Leitfaden zum Vibe Coding. Sie setzen sie schon ein und möchten eine zweite Meinung zu Ihren Anweisungsdateien oder Ihrem Setup? Nehmen Sie Kontakt auf.


