AI幻觉与Human in the Loop:OpenAI数学论文发布教我们如何审核机器的活
面对AI幻觉,Human in the Loop常常只是走过场,除非审核真的能说不。看OpenAI数学论文的发布和更正,学会怎样检查AI做的活。

面对AI幻觉,Human in the Loop听上去很安全,直到你问一句:这个人到底在检查什么?10月6日,OpenAI把数百篇由内部模型生成的数学手稿放到了GitHub上。
10月7日,它的更新记录文件写道:“一个符号错误使一个稳定化迹抵消论证失效,也使两篇依赖它的论文所用的构造失效。”(我的翻译)三篇手稿被撤回,另有十四篇被修订。
这份记录展示了一次公开更正长什么样。它写明了错误是什么、波及哪些论文,以及做了什么处理。
剩下的结果是否成立,我说不上来。我能说的是:这份记录,是营销人可以照抄的那一部分流程。
现在问问你自己的版本长什么样。你的AI这周写了一份投放报告。谁检查过,用什么检查,记录在哪里?
我不是数学家,没法评判那些证明。我能读懂的,是围绕它们的流程。
下面的事实来自OpenAI的公告、仓库的README、更新记录文件、形式化目录和概览文件,以及一份arXiv审计。引文和数字,我已在2026年10月14日对照这些页面的存档副本核对过。
要点先看
- OpenAI在10月7日撤回了三篇手稿, 即发布后的次日,一个符号错误让另外两篇论文所用的论证失效。它还修订了另外14篇,并写下了原因。
- 两个形式化数字看上去对不上。 README说约42%的顶层结果已形式化,更新记录给出的是719篇中的300篇,而目录文件只列出173篇论文。仓库没有说明它们之间的关系。
- 机器检查验证的是写进机器里的那个命题。 这个命题是否表达了论文的主张,仍然是人的问题。
- 检查者也会出错。 一份针对OpenAI早前成果的arXiv审计记录了一个表面上的错误,后来从源文件里找回一个丢失的上划线,这个错误就被撤回了。
- Human in the Loop要有五个部分: 人看得见输入、有驳回的规则、驳回有后果、机器先检查、有记录。
- 当产出变得廉价,检查就成了瓶颈。 先把预算留给它。
OpenAI发布了什么
OpenAI的公告日期是2026年10月6日。仓库里放的是“由OpenAI内部模型生成的数学手稿及配套证明材料”(我的翻译)。截至10月14日,README统计有719篇手稿、372个系列,适用Apache-2.0许可证。
OpenAI对这项工作的说法:
- 截至10月14日,该模型尚未发布。 “绝大多数结果是用同一套流程、借助一个未发布的OpenAI内部模型得到的。”(我的翻译)
- 它被问了大约4000个问题。 目录是在“要求达到相当的重要性”(我的翻译)之后剩下的部分。
- 每个结果平均用了约三小时的ChatGPT Pro算力。 这是每个结果,不是每个问题。
- OpenAI就如何分享这项工作,咨询了 高等研究院的独立机构“数学与人工智能顾问小组”。公告没有说这个小组检查过这些结果。
头条主张很大。003号系列称,每一个狄利克雷L函数,包括黎曼ζ函数在内,在实部大于7/8的地方都没有零点,概览PDF 称之为“解决了准黎曼猜想”(我的翻译)。这不是黎曼猜想。
004号系列称,不存在算法能判定一个任意多变量的整系数多项式是否有有理零点,并把它表述为解决了有理数上的希尔伯特第十问题。107号系列则声称,在有理数上矩阵乘法指数不超过9/4。
我只把这些当作主张来转述。我没有资格确认它们,也没有资格质疑它们。
被撤回的三篇里有一篇题为《K3曲面乘积的有理霍奇猜想》,所以这次更正触及了一个著名猜想。README对哪些内容未经检查,说得异常具体。
“这批成果处于不同的验证阶段。并非全部附有Lean形式化。”(我的翻译)
接着:“部分未形式化的结果可能存在问题。我们会努力尽快修复这类问题。”(我的翻译)
两个对不上的数字
README给出一个数字:“仓库约有42%的顶层结果已形式化。”(我的翻译)10月7日的更新记录写道,这次更新“使已形式化的顶层结果比例达到300 / 719 = 约42%”(我的翻译)。
README说719是手稿数量。形式化目录列出了主要结果已形式化的173篇论文,这是我在10月14日自己数的。我没有找到哪个页面能把300和173对上。
这不是错误。这是该追问“百分比到底在数什么”的理由。
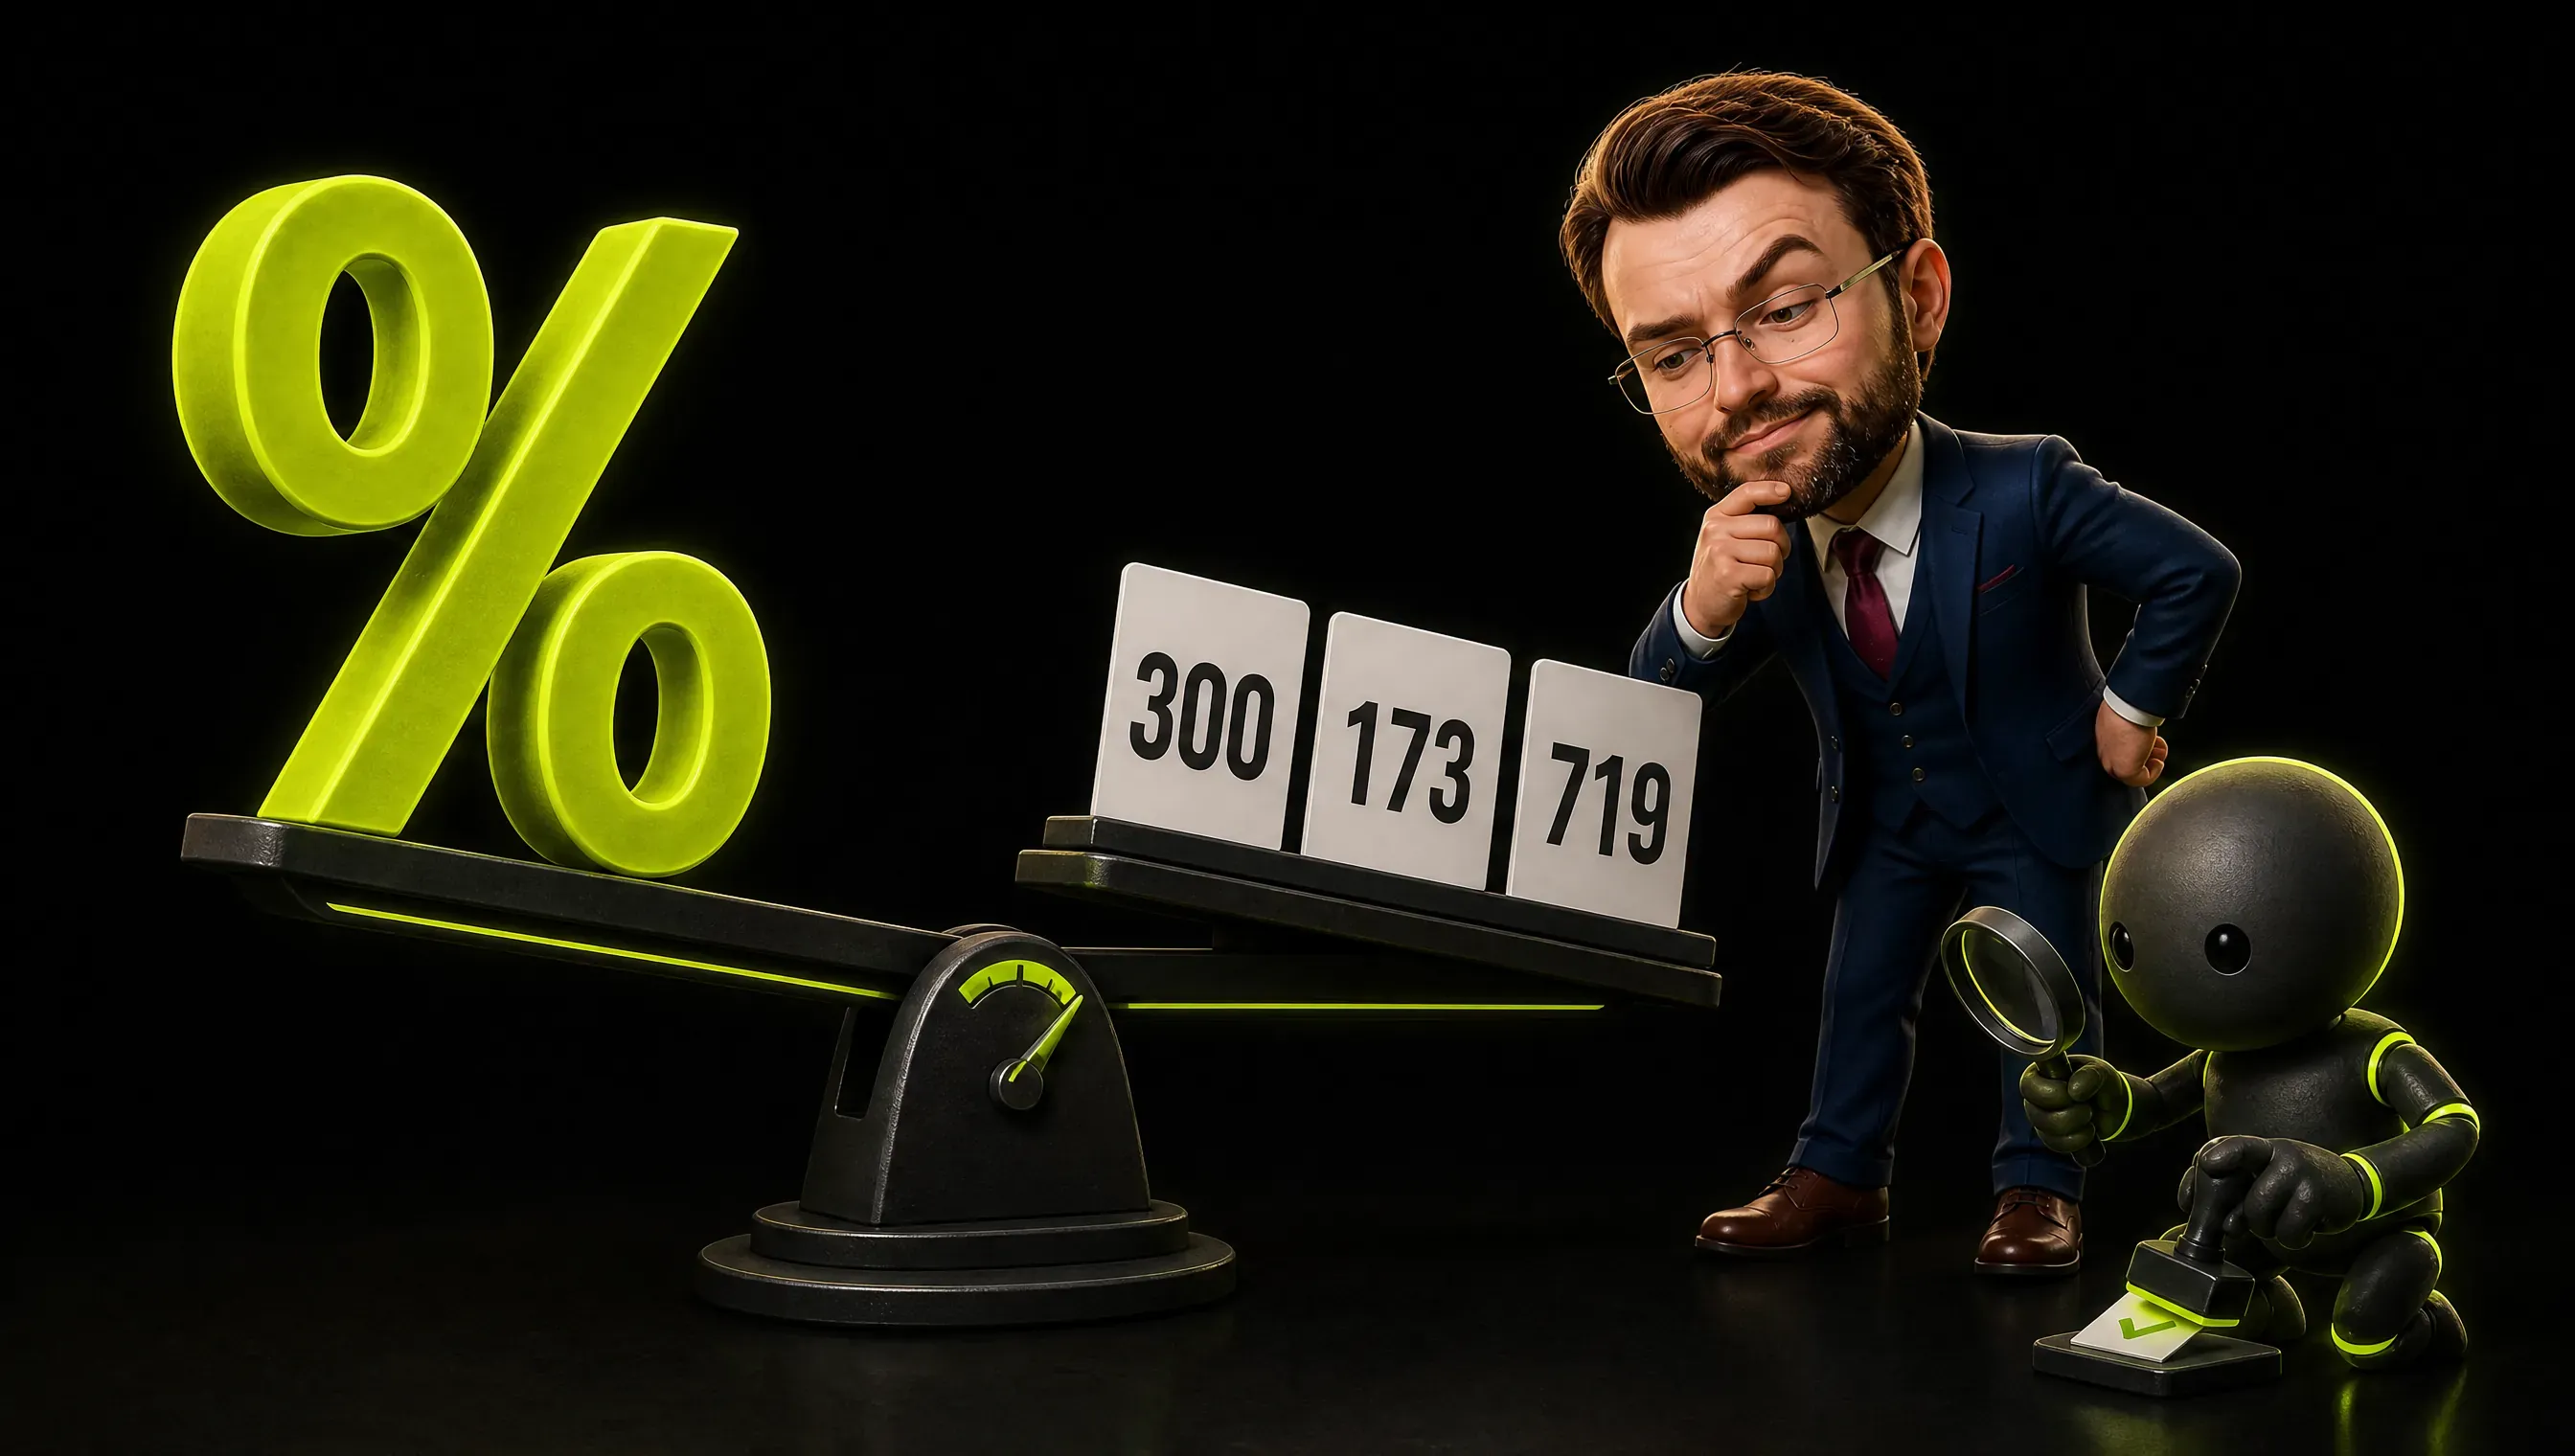
一份“90%已核实”的报告,可能指90%的论断,可能指90%的页面,也可能指90%的“有人想到要去查的论断”。信它之前,先问是哪一种。
Lean检查能做什么,不能做什么
用OpenAI的话说,Lean是“一种可以让计算机检查数学证明的编程语言”(我的翻译)。一个证明在Lean中形式化、并被Lean接受,机器就验证了:这个形式命题可以从它的公理推出。
说白了,机器验证的是写进机器里的那个命题。
这个命题是否表达了论文所说的意思,仍需要一个把两边都读过的人来判断。这个原则是我在这里解释的。OpenAI的页面没有用这样的话说过。
机器亮起的绿勾,意思是机器和自己达成了一致。你仍然得读一读它同意的是什么。
一份由两位作者撰写的 arXiv审计预印本评估了对OpenAI于2026年8月1日公布的十项结果的18份分章审查,那是比10月这批更早的一组。它报告称,“在所审查的评估中,主要结果里没有遗留的、已确认的实质性数学错误,尽管审查深度参差不齐,部分依赖项仍只是部分检查过。”(我的翻译)
它指出第8章曾有专家要求对“被压缩的解析论证”做“大幅修订”(我的翻译),并主张“信心应当综合形式化检查、人工重构、独立的数学运用,以及一份既支持更正证明、也支持更正审查的公开记录”(我的翻译)。我引用它是为了方法,不是为了对那些数学下结论。
营销没有Lean。它的大多数论断只能对照来源、日期或某个人来核对,这就是为什么记录比工具更重要。
检查者也会出错
这份审计里有个细节,我一直惦记。在第6章,一个表面上的极性错误“在从排版源文件中找回PDF提取时丢失的一个上划线后被撤回”(我的翻译)。
摘要没有说是谁提出的。按这个读法,问题出在文本提取,不在证明本身。这样的丢失,正是检查环节自己制造出错误的方式。
我自己的流程里就有类似的检查。读取用的智能体从存档的来源页面中提取引文,再由一个脚本确认每条引文逐字出现在该页面里。在最近五篇文章的资料研究中,它通过了295条引文,拒绝了两条在各自页面里找不到逐字原文的引文。
接着由事实核查员读草稿,我会用文本搜索重新核对它标出的问题再采纳,因为过长的来源行曾造成误报。持怀疑态度的审稿人用高强度跑,译文还要经过母语者二审,二审确实查出过真错误。检查者是个有错误率的工具,而这个错误率也需要检查。
审稿人不该是作者本人。在我那篇CLAUDE.md文章里我写过,要把核实放进“机器可能不通过的检查”,在重品味或风险高的地方另设审稿人,“因为模型倾向于偏爱自己的结果”。
为什么Human in the Loop常常只是走过场
这个说法承诺了安全,于是人们不再追问它的含义。常见的回答是“有人看一眼”。这是口号。
我用的定义是这样:真正的闭环有五个部分,缺任何一个,都只是个仪式。
- 人看得见输入。 来源、数据和指令,加上产出。你没法评判一份你无法追溯的摘要。
- 有驳回的规则。 什么情况下审稿人会说不?如果没人答得上来,每份产出都会通过。
- 驳回有后果。 产出重做、流程修正,或者这个用例被叫停。一个什么都改变不了的驳回按钮,只是装饰。
- 机器先检查。 由代码检查链接、数字、引文、格式和合计,让人把注意力花在判断上。
- 有记录。 一份日志,写明查了什么、谁查的、修了什么。OpenAI的更新记录文件就是一个公开的例子。
只有一个部分的闭环,也就是“有个人看一眼”,一旦加上截止时间和200条的队列,就变成了橡皮图章。
营销产出的核查表
“AI搞错了”其实藏着三种不同的失败。错误指命题是假的:编出来的功能、杜撰的统计数据、没人说过的引语。过期指它在模型学习时或来源写成时是真的:价格、法律期限、产品版本。
错配指命题是真的,却回答了和你所问不同的问题。摘要对上个季度是准确的,平均值对另一个地区是准确的。只有知道问题是什么的人才抓得到,所以审稿人需要的是任务说明,而不只是产出。
你不需要Lean。你需要的是,对每种产出,最便宜又会大声报错的那个检查。
| 产出 | 能抓住的失败 | 机器检查 | 人工检查 | 记录 |
|---|---|---|---|---|
| 报告中的数字 | 错误、错配 | 根据来源导出文件重新计算合计 | 这与实际发生的事相符吗? | 来源文件名和日期 |
| 引文和统计数据 | 错误 | 在存档的来源页面上确认原文 | 来源是一手的、现行的吗? | 链接和访问日期 |
| 链接 | 错误、过期 | 对每个URL做状态码检查 | 它们说的和句子声称的一致吗? | 链接报告 |
| 法律或价格论断 | 过期、错误 | 没有可靠的方法 | 阅读一手来源 | 来源、日期、审稿人 |
| 译文 | 错配 | 与原文做结构和数字对照 | 母语者二审 | 审稿人姓名和日期 |
| 带文字的图片 | 错误 | 没有可靠的方法 | 逐字阅读 | 批准的版本 |
| 客户回复 | 错配 | 禁用论断清单、语气规则 | 抽样并阅读 | 抽样日志 |
有些检查没有机器方案。这些恰恰是必须由一个具名的人对答案负责的地方。
一个实例:竞品价格汇总
这个例子是我编的,所以别去找这些竞品。一个营销团队让AI把四家竞品的价格页汇总成一张表,放进销售演示稿。
AI返回的: 一张整洁的表,有套餐名、月价,以及每个套餐的三项主打功能。
机器检查: 一个脚本抓取每个价格页、保存副本,并确认表里的每个价格都出现在存档页面上、且紧挨着套餐名。两个价格没通过。有一家竞品默认显示年付价格,而AI把它们当成了月价。
人工检查: 一个熟悉销售对话的人看了这张表,发现功能对比的是一家的高级套餐和另一家的入门套餐。这是错配,没有哪个脚本找得出来。
记录: 存档的页面、日期和审稿人姓名,放在演示稿旁边的文件夹里。当某家竞品改价时,团队就知道哪一页已经过期。
四个页面,一个脚本加一位审稿人,一小时左右应该做得完。你的第一次会更久。
怎样写一条驳回规则
驳回规则就是一句话,审稿人不用争论就能套用。这些适用于营销:
- 驳回任何没有出现在来源导出文件里的数字。
- 驳回任何没有逐字出现在存档页面上的引文。
- 驳回任何关于法律、价格或供货的论断,只要缺少一手来源和日期。
- 驳回任何向客户承诺结果、期限或折扣的句子。
- 驳回任何数字与原文不一致的译文。
这份清单只写一次,放在审稿人干活的地方,每当有错误漏过就更新。每个漏过的错误,都变成一条新规则。这是流程建议,不是法律意见。
我会从OpenAI的仓库里学什么
抛开数学,这个仓库有三个值得照抄的习惯。
附带原因的更新记录。 每次撤回都写明论文和原因,修订按修复的内容分组。对AI写的内容,也该有一份变更日志,写明修了什么、为什么修,而不只是写明有变动。
旧版本保持可访问。 OpenAI说:“更正和修订将作为新版本记录,之前发布的版本仍可访问。”(我的翻译)在这个博客上,每篇文章都有日期,我改动已发布的文章时,会更新“更新日期”。
在有疑问的地方写免责说明。 OpenAI说明了哪些结果已形式化、哪些可能有问题。你的报告也这样做:标出重新计算过的数字,和照单全收的AI数字。
产出廉价时,检查就是瓶颈
OpenAI说,平均每个结果用了约三小时的ChatGPT Pro思考。它没有说检查一个结果要多久,我也不会去猜。
营销里的版本更容易看清。AI一分钟能写50条产品描述,而确认其中没有一条编造功能,可不是一分钟的活。
把AI用于营销会放大你最优秀的人的产出,同时把瓶颈从制作挪到了检查。不为检查留预算的团队,没有省下时间。它只是把风险转嫁给了客户。
30分钟核查审计
这周挑一个AI工作流来做一遍。
- 选一个会触达客户或影响决策的周期性产出:一份报告、一个回复模板、一份产品数据源。
- 写下今天谁在检查,以及他们具体看什么。如果答案是“他们读一遍”,继续往下。
- 列出真正闭环的五个部分,标出哪些已经存在。
- 从上面的表里加上最便宜的机器检查。
- 用一句话写出驳回规则。
- 开一份日志,每次运行一行:日期、检查者、修了什么。
- 一个月后回看日志,把第一个手动检查移进代码里。
常见问题
Human in the Loop在AI里是什么意思?
指有人参与AI流程,通常是审阅或批准产出。只有当这个人看得见输入、有驳回的规则、驳回后有办法行动,并且存在一份记录时,它才管用。
有了Human in the Loop,AI产出就安全了吗?
单靠它不行。对代码能核实的部分加上机器检查,对需要判断的部分另设审稿人,再有一份能让你日后更正记录的日志。
AI能检查自己的活吗?
它能抓到一部分错误,而且倾向于偏爱自己的结果。请用另一个审稿人、一份评分标准,以及机器可能不通过的检查。
OpenAI的数学结果被证明了吗?
我没法告诉你,这篇文章也不是讲这个的。OpenAI说这批成果“处于不同的验证阶段”,按它的统计约42%的顶层结果已用Lean形式化,部分未形式化的结果“可能存在问题”(我的翻译)。数学是否正确,是数学家的问题。
怎样在工作中核实AI产出?
从一个工作流开始。加一个机器检查、一条驳回规则和一份日志,机器做不了的检查,指定一个具名的人负责。
我的结论
一个Human in the Loop的AI流程,好坏取决于它能不能说不。不能驳回的闭环,只是个仪式。
这张卡片:
- 让人看见输入。
- 写出驳回规则。
- 让驳回改变点什么。
- 先跑机器检查。
- 留一份记录,并让记录显示更正。
本文反映的是OpenAI仓库截至2026年10月14日的状态。这批成果还在更新,所以在你依赖某个数字之前,先看一眼更新记录文件。
想让人帮你再看一遍团队如何检查AI产出,并拿到一份贴合你工作流的清单吗?联系我。