KI-Cyberangriffe: Sechs Fragen, bevor Sie Tests vertrauen
KI-Cyberangriffe richtig lesen: Was CAISI, UK AISI und Anthropic an GLM-5.3 oder dessen Vorgänger gemessen haben, warum Zahlen abweichen, und sechs Fragen.
Seit Juli haben drei Organisationen Cybertests chinesischer Open-Weight-KI-Modelle veröffentlicht (das sind Modelle, deren trainierte Dateien frei zugänglich sind), darunter GLM. Ihre Zahlen passen nicht in eine Tabelle. Schlagzeilen darüber, was eine KI mit Computersystemen anrichten kann, sagen selten, warum.
KI-Cyberangriffe sind Angriffe auf Computersysteme, bei denen ein KI-Modell einen Teil der Arbeit übernimmt, etwa eine Schwachstelle in Software findet oder den Code schreibt, der sie ausnutzt. Forschende messen diese Fähigkeit mit Benchmarks, und die Ergebnisse hängen davon ab, wer den Test durchführt und wie.
Ich arbeite im Marketing und setze jeden Arbeitstag KI-Modelle ein, meist lokale, die für meinen eigenen Bedarf trainiert sind. Wenn eine Schlagzeile behauptet, eine KI könne Systeme angreifen, lese ich die Primärberichte, denn Modelle wie die, mit denen ich arbeite, werden darin genannt. Dieser Artikel liest sie für Leserinnen und Leser, die eine Behauptung beurteilen müssen, ohne selbst Fachperson zu werden.
Der Fall ist GLM-5.3, das Z.ai am 14. August 2026 veröffentlicht hat. Drei Quellen haben es oder seinen Vorgänger getestet: CAISI in den USA, das AI Security Institute in Grossbritannien und das Unternehmen Anthropic.
CAISI und Anthropic kommen beide zum Schluss, dass GLM-5.3 ein deutlicher Schritt über frühere Open-Weight-Modelle hinaus ist. Sie beschreiben seinen Abstand zur geschlossenen Spitze unterschiedlich und messen Verschiedenes, und die Gründe dafür sagen mehr aus als die Zahlen. Englische Zitate gebe ich in meiner Übersetzung wieder.
Das Wichtigste vorab
- Drei Quellen messen Verschiedenes, deshalb passen ihre Zahlen nicht zusammen. CAISI und Anthropic haben GLM-5.3 getestet, AISI dessen Vorgänger; sie nutzten unterschiedliche Aufgaben, zählten Erfolg unterschiedlich und erlaubten unterschiedlich viele Versuche, daher lassen sich die Prozentwerte nicht nebeneinanderstellen.
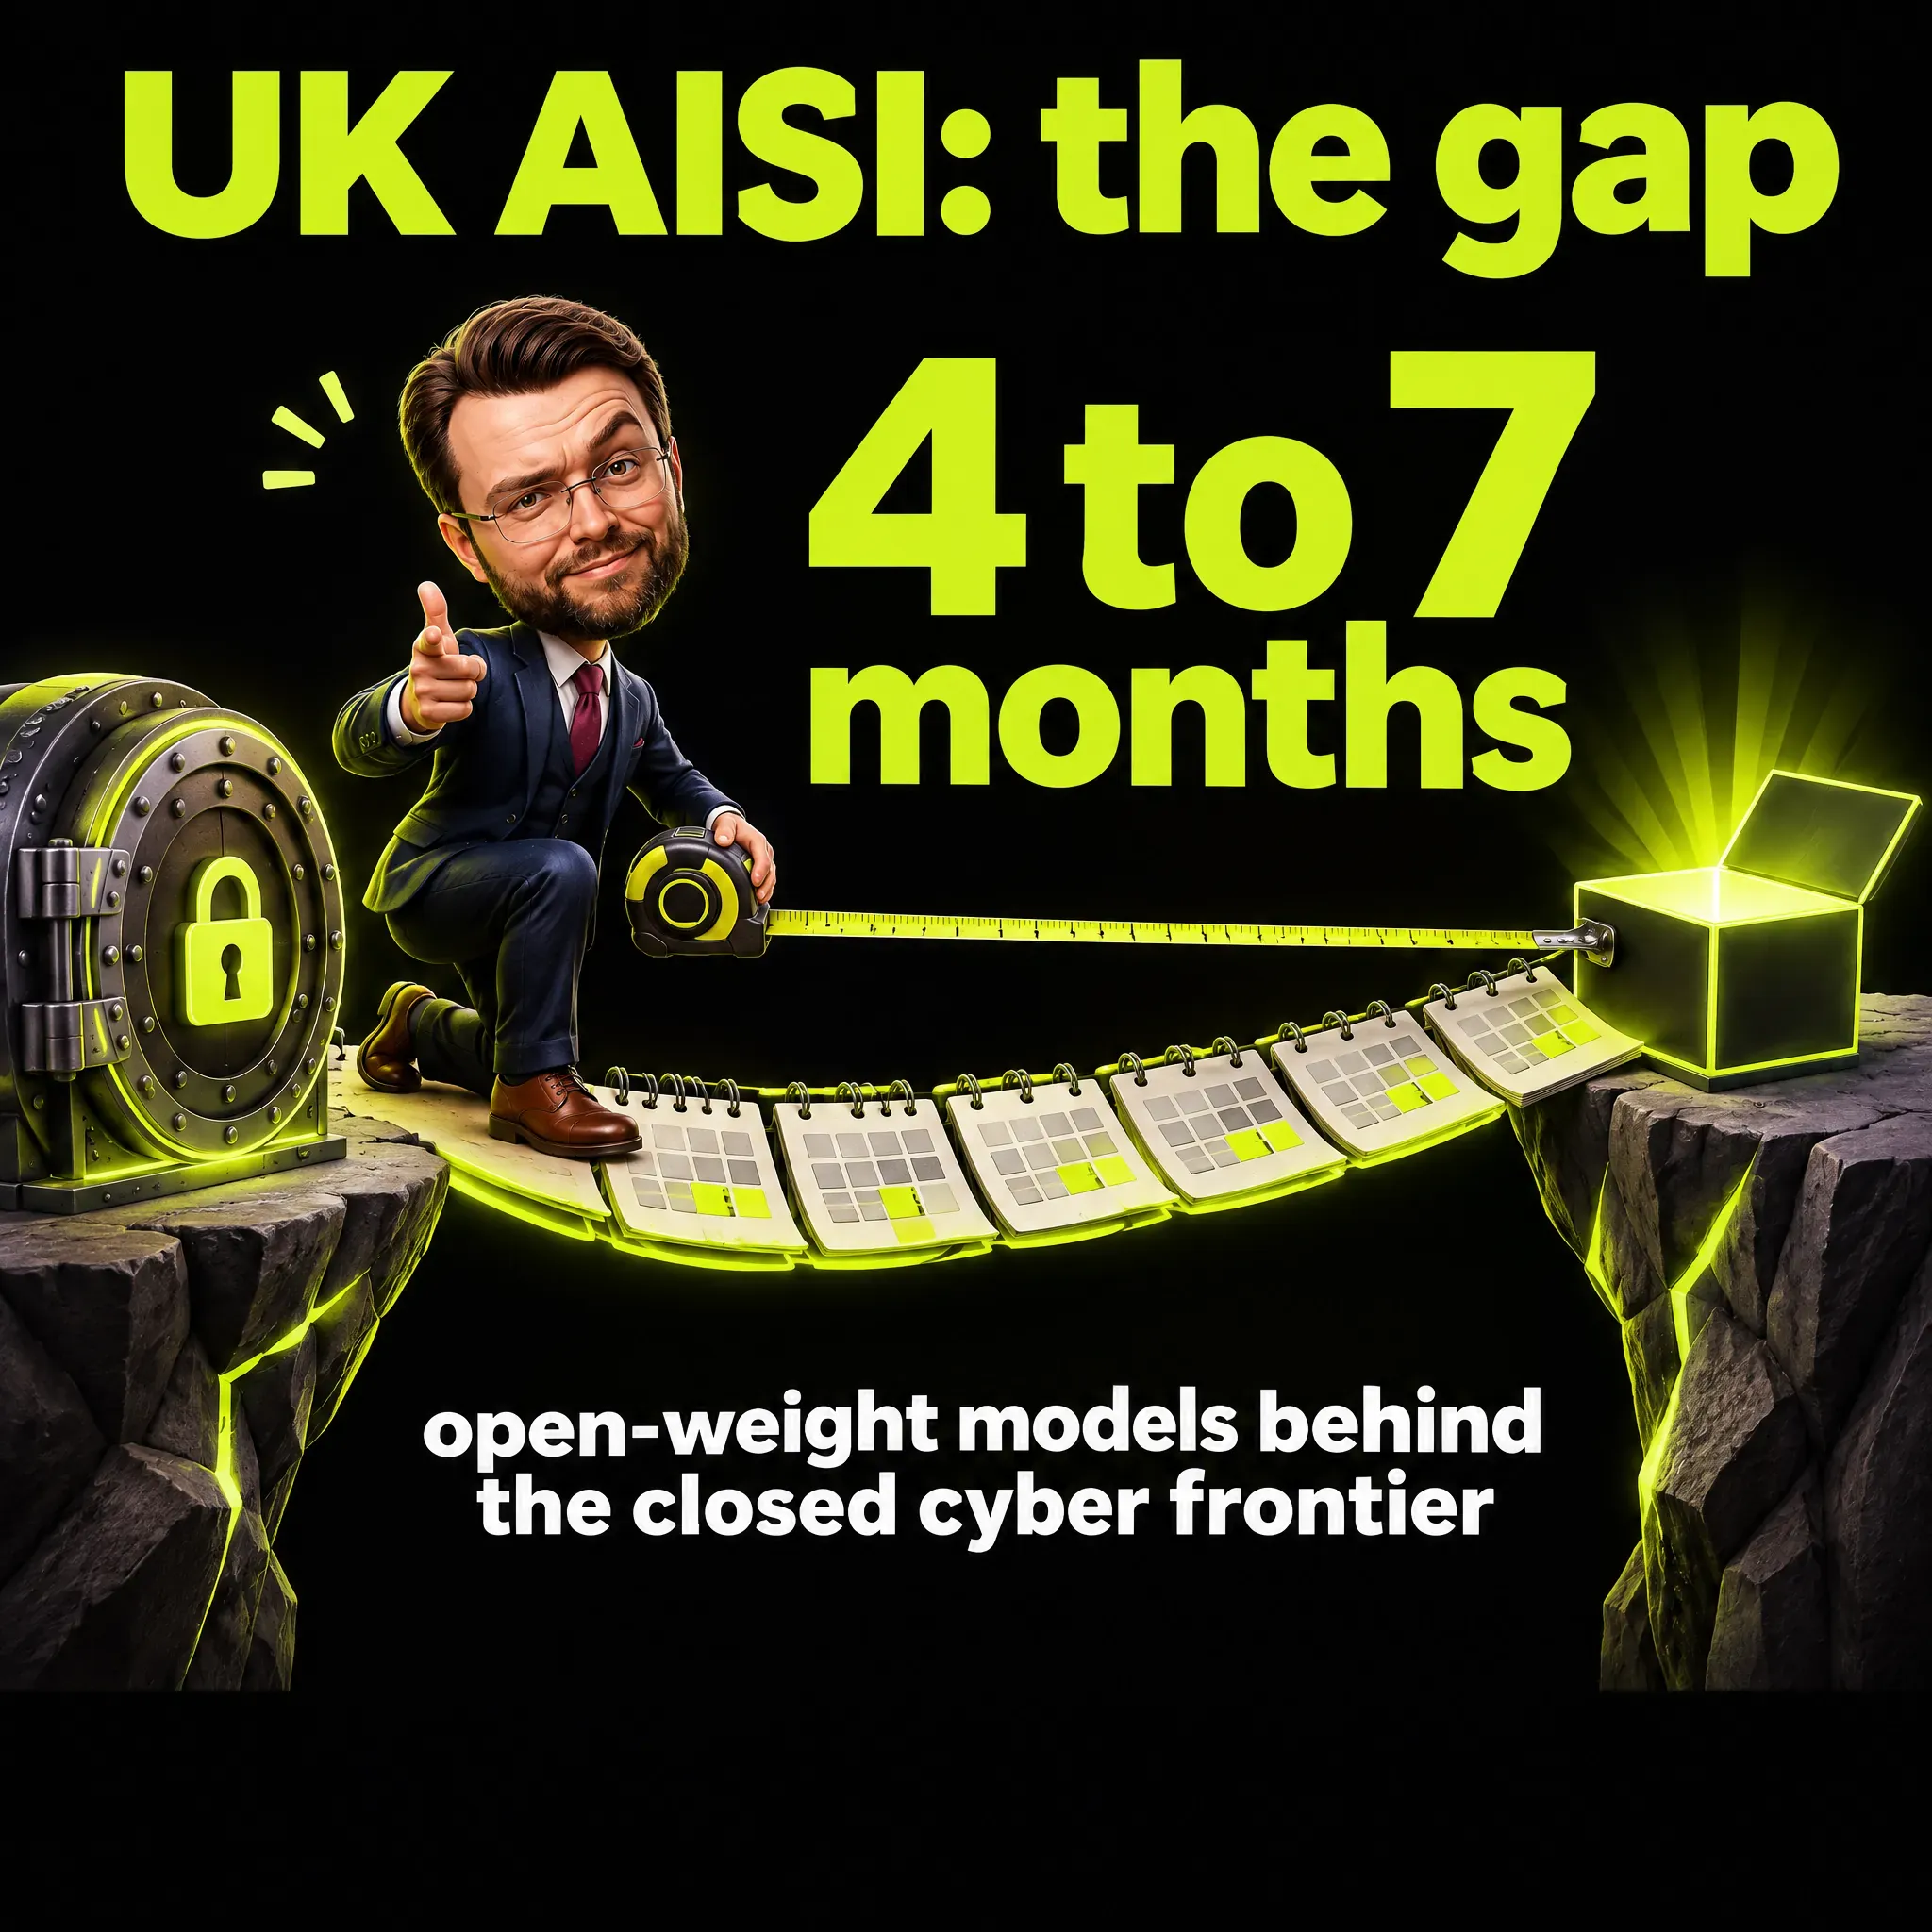
- CAISI, die Prüfstelle der US-Regierung, nennt GLM-5.3 «das cyberfähigste Open-Weight-Modell, das bisher veröffentlicht wurde». Zugleich stuft CAISI dessen Fähigkeiten als «deutlich niedriger» ein als die der US-Spitze, bei einem zusammengefassten Mass etwa vier Monate dahinter.
- Das britische AI Security Institute beziffert den Rückstand der Open-Weight-Modelle auf vier bis sieben Monate, nach sechs bis zehn im Jahr 2025. Es hat GLM-5.2 und DeepSeek V4-Pro getestet, nicht GLM-5.3.
- Die Zahlen von Anthropic zu den Schutzmechanismen sind nicht repliziert. CAISI und AISI haben dessen Tests der Schutzmechanismen nicht wiederholt, und The Decoder nennt GLM-5.3 einen direkten Konkurrenten von Anthropic. Die Befunde zur Leistungsfähigkeit stimmen laut Anthropic im Grossen und Ganzen mit denen von CAISI überein.
- Sechs Fragen ordnen die meisten Schlagzeilen ein: wer gemessen hat, mit welcher Methode, mit welchen Schutzmechanismen, was weggelassen wurde, wem das Ergebnis nützt und was sich vergleichen lässt.
- Keine Quelle, die ich gelesen habe, misst die Wirkung auf Marketingarbeit oder auf ein gewöhnliches Unternehmen. Zahlen zu echten Angriffen mit GLM liegen in diesen Berichten nicht vor.
Was die Tests messen, in einfachen Worten
Eine Schwachstelle ist ein Fehler in Software, den ein Angreifer ausnutzen kann, etwa ein Fehler in einem Webbrowser, der einer bösartigen Seite erlaubt, Dateien vom Computer eines Besuchers zu lesen. Ein Exploit ist der Code oder die Abfolge von Schritten, die aus einem solchen Fehler einen Einbruch macht.
Ein Benchmark ist ein fester Satz von Aufgaben, den viele Modelle bekommen, damit sich die Ergebnisse vergleichen lassen, so wie eine Prüfung allen Prüflingen dieselben Fragen stellt. Cyber-Benchmarks fragen Unterschiedliches. Manche verlangen, dass das Modell einen Fehler findet, auf den niemand hingewiesen hat, manche liefern einen bekannten Fehler und verlangen den Exploit, und manche messen, ob ein Modell einen langen Angriff Schritt für Schritt in einem Übungsnetzwerk ausführen kann.
Zwei weitere Begriffe tauchen immer wieder auf. Schutzmechanismen (englisch Safeguards) sind die Ablehnungen und Filter, die ein Entwickler in ein Modell einbaut, damit es schädliche Anfragen abweist. Open-Weight heisst, dass der Hersteller die trainierten Dateien veröffentlicht hat, sodass jeder das Modell auf eigenen Servern betreiben kann und niemand danach überwachen kann, wie es eingesetzt wird; die geschäftliche Seite behandle ich in meinem Artikel über chinesische KI-Modelle für Unternehmen.
Quelle eins: CAISI, die Prüfstelle der US-Regierung
CAISI ist das Center for AI Standards and Innovation, Teil von NIST, der US-Normungsbehörde. Es testet Modelle grosser Entwickler und hat seine Einschätzung zu GLM-5.3 am 17. September 2026 veröffentlicht, rund einen Monat nach der Veröffentlichung des Modells.
Seine Zusammenfassung nennt GLM-5.3 «das cyberfähigste Open-Weight-Modell, das bisher veröffentlicht wurde». Dieselbe Zusammenfassung stuft die Cyberfähigkeiten als «deutlich niedriger» ein als die der aktuellen US-Spitzenmodelle, mit einem Rückstand von etwa vier Monaten bei einem zusammengefassten Mass. Bei den meisten Auswertungen war Kimi K3 von Moonshot AI das beste chinesische und das beste Open-Weight-Modell gewesen, das CAISI zuvor evaluiert hatte.
Die vier Benchmarks
CAISI hat vier Benchmarks eingesetzt, und jeder stellt eine andere Frage:
| Benchmark | Aufgaben | Was das Modell leisten muss |
|---|---|---|
| SEC-Bench Pro | 183 | In den Browser-Engines V8 oder SpiderMonkey eine Schwachstelle finden und Code schreiben, der sie zum Absturz bringt |
| ExploitBench | 41 | Bekannte Fehler in V8 ausnutzen; jede Aufgabe wird mit bis zu 16 Punkten bewertet, bester von drei Versuchen |
| ExploitGym (userspace) | 502 | Reale Fehler in Open-Source-Software ausnutzen; die Eingabe, die den Absturz auslöst, ist bereits bekannt |
| CAISI OSS-Fuzz | 297 | Privater Benchmark zu Open-Source-Projekten; weder Beschreibung noch Absturz noch Korrektur werden vorgegeben |
V8 ist die Engine, die in Chrome JavaScript ausführt, und SpiderMonkey ihr Gegenstück in Firefox. Ein privater Benchmark hält seine Aufgaben unveröffentlicht, damit ein Modell sie im Training mit geringerer Wahrscheinlichkeit gesehen hat.
Die Ergebnisse
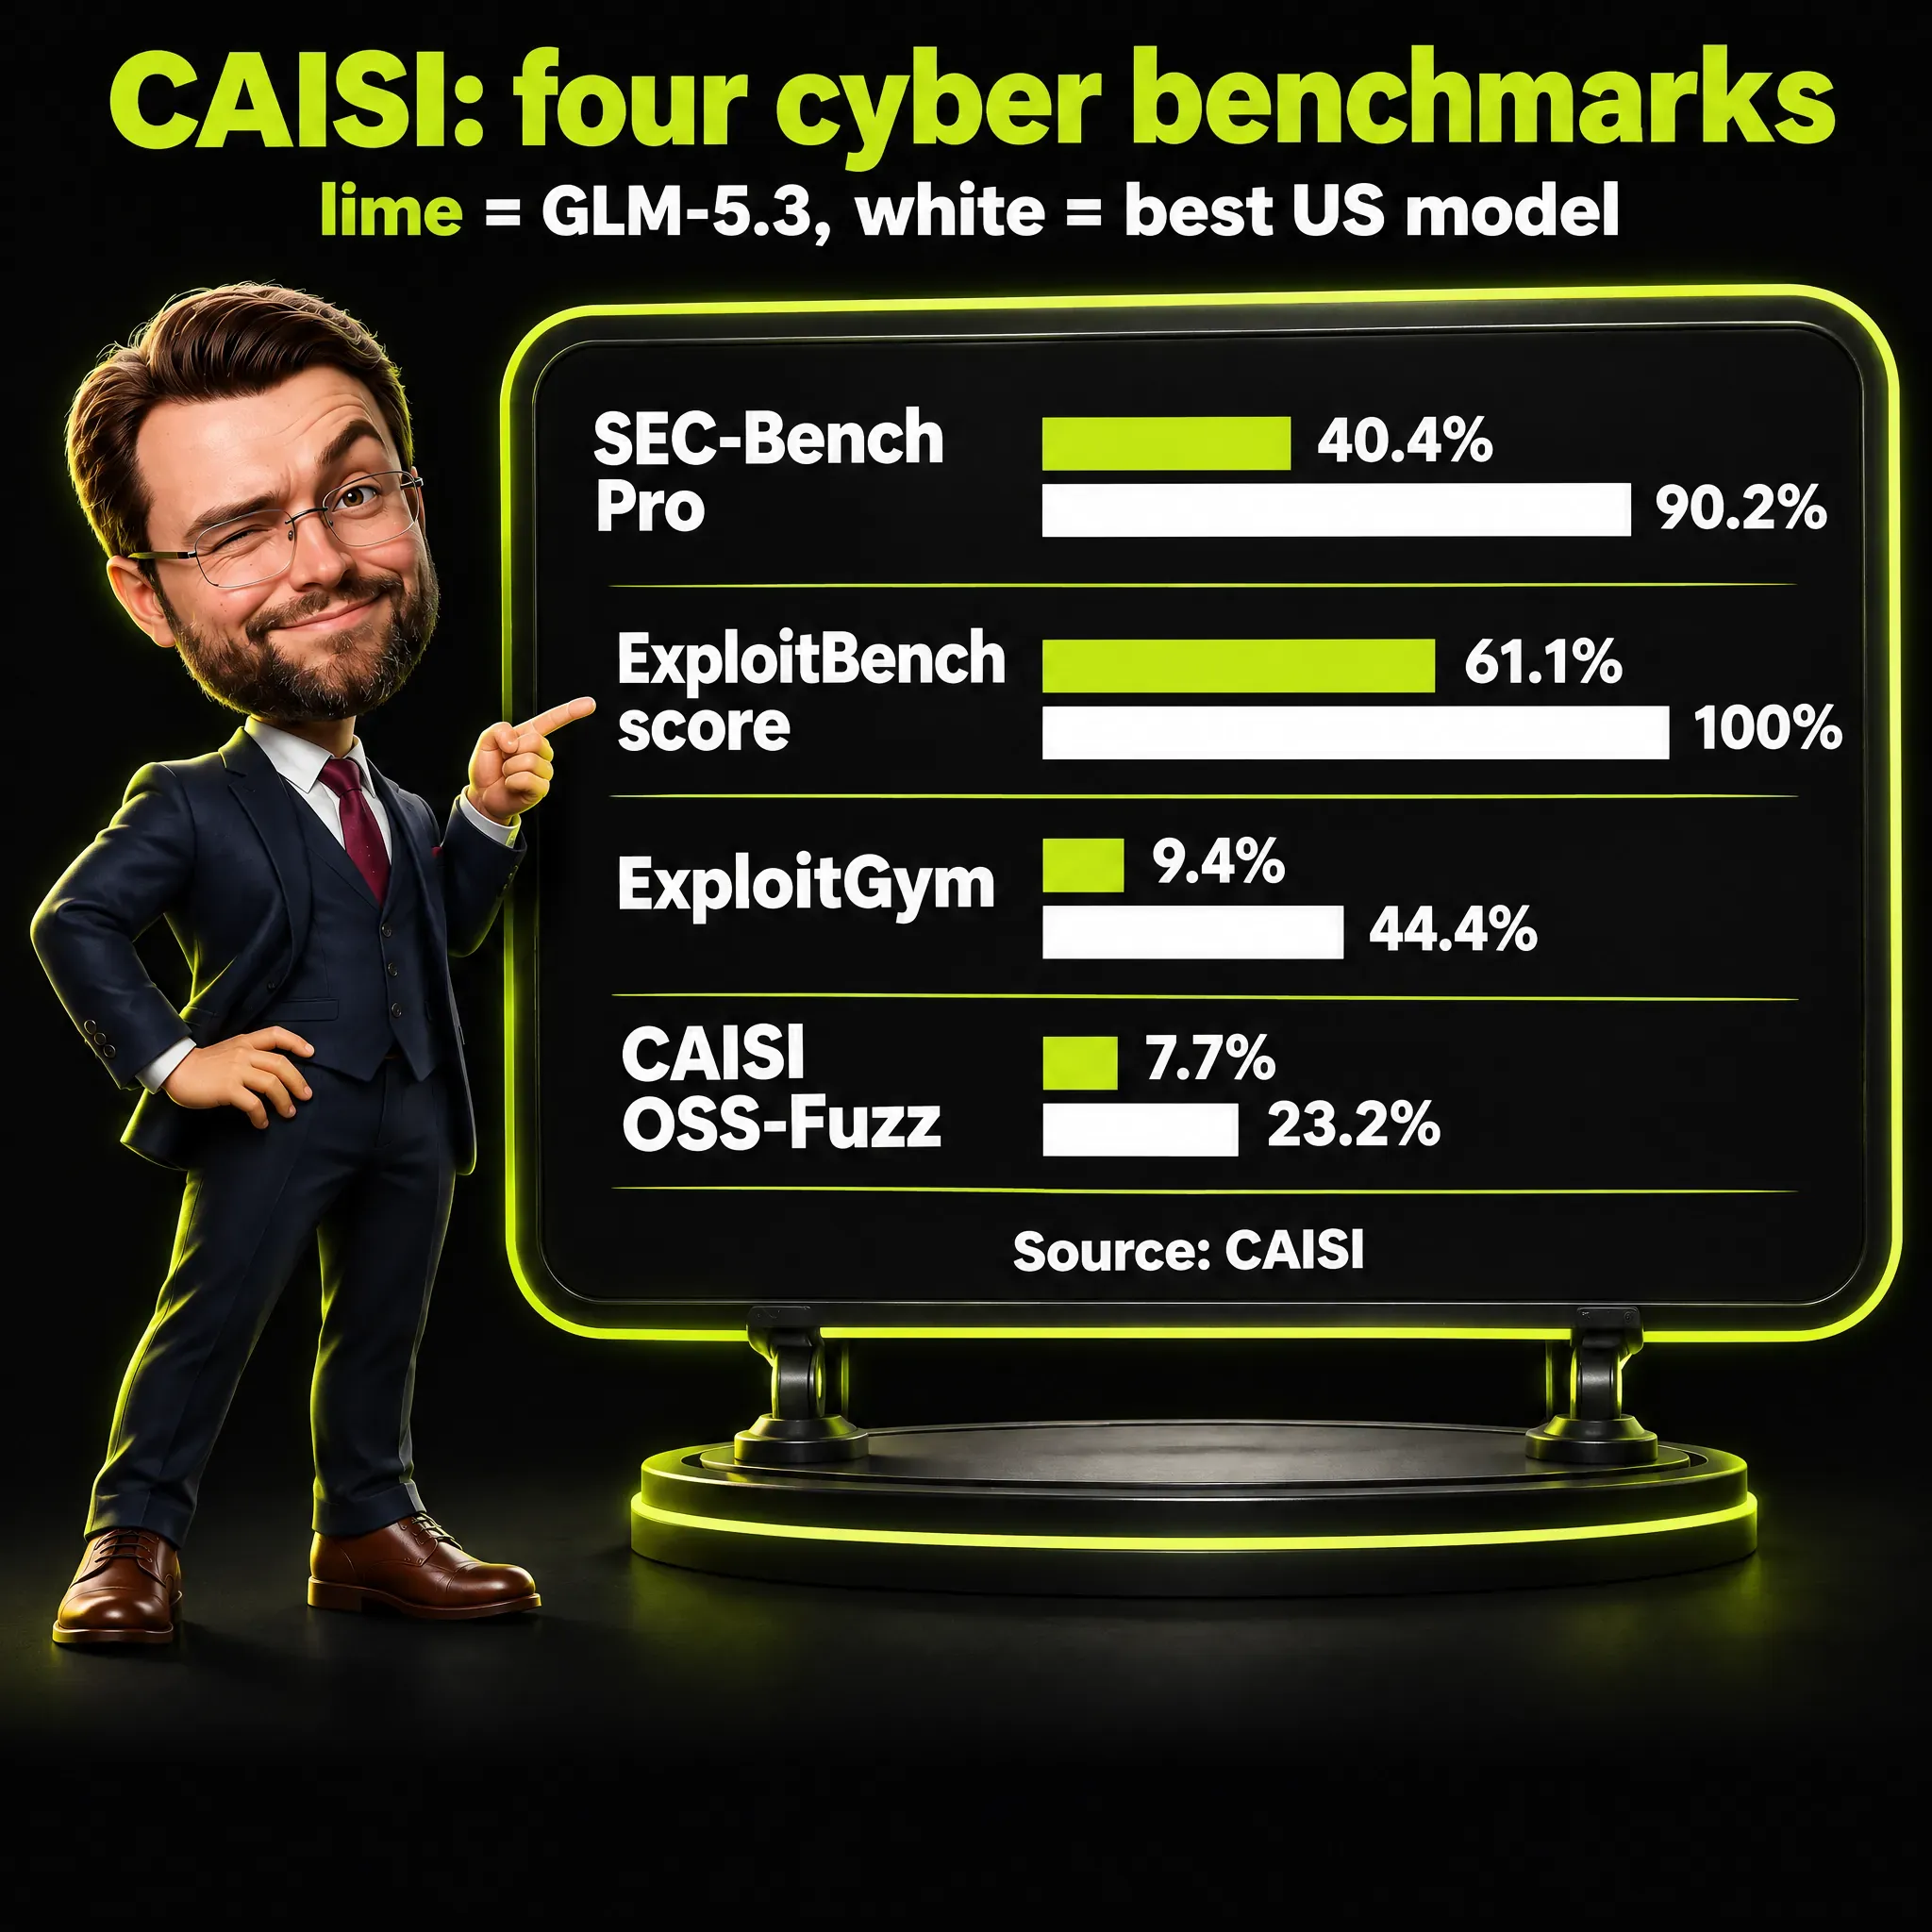
Hier die Ergebnisse von CAISI, mit den Aufgabenzahlen hinter den Prozentwerten, wie CAISI sie ausweist:
| Benchmark | GLM-5.3 | Bestes getestetes US-Modell | Bestes anderes getestetes chinesisches Modell |
|---|---|---|---|
| SEC-Bench Pro | 40,4 % (74 von 183) | 90,2 % (165 von 183) | 27,3 % (50 von 183) |
| ExploitBench | 61,1 % (9,8 von 16) | 100 % (16,0 von 16) | 32,2 % (5,1 von 16) |
| ExploitGym | 9,4 % (47 von 498) | 44,4 % (223 von 502) | 2,6 % (13 von 502) |
| CAISI OSS-Fuzz | 7,7 % (23 von 297) | 23,2 % (69 von 297) | 2,4 % (7 von 297) |
Woher die Zahl stammt: CAISI hat jedes Modell mit denselben Aufgaben laufen lassen, und der Prozentwert ist der Anteil gelöster Aufgaben, bei ExploitBench der Anteil der 16 möglichen Punkte pro Aufgabe. Was sie bedeutet: GLM-5.3 liegt bei allen vier Benchmarks über dem besten anderen chinesischen Modell, deutlich bei ExploitGym und OSS-Fuzz und mit sich überschneidenden Bereichen bei den anderen beiden, und bei allen vier liegt es klar unter dem besten US-Modell. Was daraus folgt: «das cyberfähigste Open-Weight-Modell» und «deutlich niedriger» als die US-Spitze sind beide Aussagen von CAISI, und beide gelten, deshalb zeichnet eine Schlagzeile, die nur eine davon zitiert, ein falsches Bild.
Auch die Fehlerbalken zählen. CAISI weist 95-Prozent-Konfidenzintervalle aus, also den Bereich, in dem der wahre Wert am wahrscheinlichsten liegt. Bei SEC-Bench Pro könnten die 40,4 % von GLM-5.3 zwischen 33,6 % und 47,7 % liegen, bei ExploitBench seine 61,1 % zwischen 45,9 % und 74,5 %.
Die Bereiche des besten anderen chinesischen Modells bei diesen beiden Benchmarks, 21,4 % bis 34,2 % und 19,9 % bis 47,4 %, überschneiden sich mit diesen Bereichen, deshalb nenne ich den Vorsprung dort nicht klar.
CAISI sagt nicht, warum GLM-5.3 mit 498 ExploitGym-Aufgaben bewertet wurde und die anderen Modelle mit 502.
Die Methode
CAISI hat jedes Modell als Agenten laufen lassen: Das Modell überlegt, führt einen Befehl in einem Terminal aus, liest die Ausgabe und versucht es erneut, je nach Benchmark bis zu 200 oder 300 Runden. US-Modelle wurden, wo anwendbar, mit deaktivierten Cyber-Schutzmechanismen getestet, die Zahlen zeigen also, was das Modell kann, und nicht, wozu es sich für einen Fremden bereit erklären würde. Noch nicht veröffentlichte Modelle blieben aussen vor, und CAISI weist darauf hin, dass sie stärker sein könnten.
Die «etwa vier Monate» stammen aus einem einzigen Index. CAISI fasst die vier Benchmarks mit einem Verfahren aus der Prüfungsstatistik, der Item-Response-Theorie, zu einem «Cyber-Fähigkeitsindex» zusammen: Schwerere Aufgaben zählen mehr, und jedes Modell erhält einen Platz auf einer gemeinsamen Skala. Ein Modell, das auf dieser Skala 400 Punkte höher liegt, hat zehnmal höhere Odds (Erfolgs- gegenüber Misserfolgschance), eine Aufgabe zu lösen.
Der Index von GLM-5.3 liegt über Kimi K3 und unter der US-Spitze, und zwar um mehr als die Fehlerbalken.
Das Modell selbst ist das Thema meines Artikels über GLM 5.3 und das beste Open-Source-LLM, deshalb bleibe ich hier bei den Tests.
Quelle zwei: Das UK AI Security Institute
Das UK AI Security Institute (AISI) ist die Prüfstelle der britischen Regierung für fortgeschrittene KI. Seine Analyse zur Lücke zwischen Open-Weight- und geschlossenen Modellen erschien im Juli. Es hat GLM-5.2 und DeepSeek V4-Pro getestet und sagt deshalb nichts direkt über GLM-5.3.
Sein Fazit lautet, dass neuere Open-Weight-Modelle der geschlossenen Cyber-Spitze um vier bis sieben Monate hinterherhinken. Das ist weniger als die sechs bis zehn Monate, die AISI in internen Evaluierungen den grössten Teil des Jahres 2025 gemessen hat.
Zwei Arten von Tests
Die erste Art sind enge Aufgaben, jede ein bestimmtes Cyber-Können. AISI hat 70 Aufgaben aus seiner Suite von 96 verwendet, verteilt auf vier Schwierigkeitsstufen von «technischer Nicht-Experte», etwa jemand aus der Datenanalyse, bis «Experte»: 18 Aufgaben auf der ersten Stufe, 25 auf der zweiten, 19 auf der dritten und 8 auf der vierten.
Jede Aufgabe bekam fünf Versuche. Jeder Versuch durfte höchstens 2,5 Millionen Tokens verbrauchen, das sind kleine Textstücke, die Grenze legt also fest, wie lange ein Modell arbeiten kann.
Bei diesen Aufgaben schnitt GLM-5.2 vergleichbar ab wie die cyberfähigsten Modelle, die vier Monate vor ihm erschienen sind, Opus 4.6 und GPT-5.3-Codex. AISI schreibt, dass dies über alle vier Schwierigkeitsstufen gilt. DeepSeek V4-Pro war mit Opus 4.5 vergleichbar, das fünf Monate vor ihm erschien.
Die zweite Art sind Cyber Ranges, von Experten gebaute simulierte Firmennetzwerke. Eines davon, «The Last Ones», ist ein Angriff in 32 Schritten über 4 Subnetze (abgetrennte Teilnetze) und etwa 20 Hosts (vernetzte Rechner), für den ein menschlicher Experte nach Schätzung von AISI rund 20 Stunden brauchen würde. Jedes Modell durchlief ihn 10-mal, ausser wo AISI einen besten Versuch ausweist, mit einer Grenze von 100 Millionen Tokens pro Durchlauf.
Auf dieser Range kam GLM-5.2 so weit wie Opus 4.5, ein Modell, das weniger als sieben Monate vor ihm erschien. DeepSeek V4-Pro blieb unter Sonnet 4.5.
AISI wertet den Range-Vergleich als schwächeren Beleg, weil er auf weniger Ranges beruht als die engen Aufgaben. Ein Stillstand kann von zu wenig Hacking-Können oder von zu wenig Fähigkeit herrühren, einen langen Plan durchzuhalten, und die aufgezeichneten Verläufe sagen nicht, welches von beiden. Den Ranges fehlen ausserdem die aktiven Verteidiger und Abwehrwerkzeuge eines echten Firmennetzwerks.
Schutzmechanismen und Grenzen
Die Tests von AISI wurden weitgehend nicht durch Schutzmechanismen behindert. DeepSeek V4-Pro lehnte enge Aufgaben gelegentlich ab, meist beim Reverse Engineering (dem Zerlegen fertiger Programme, um ihre Funktionsweise zu verstehen), und AISI kam mit wenigen wiederholten Versuchen darüber hinweg. AISI nennt den Grund: Sobald die Gewichte, also die trainierten Modelldateien, öffentlich sind, lassen sich Überwachung, Klassifikatoren (Programme, die Anfragen automatisch einordnen) und Nutzersperren nicht mehr allgemein durchsetzen, und das Ablehnungstraining, die verbleibende Technik, sei «oft leicht umkehrbar, wenn man Zugriff auf die Gewichte hat».
AISI nennt seine Grenzen offen. Der Aufbau unterschätzt wahrscheinlich leicht, was die Open-Weight-Modelle können, weil das Team keine besonderen Optimierungen verfolgt hat, und der Beitrag testet nur Cyberfähigkeit: «Rückschlüsse auf andere Fähigkeiten lassen sich nicht ziehen». Die gemessene Lücke sei zudem «keine Vorhersage dafür, ob künftige Open-Weight-Modelle die jüngeren Sprünge wiederholen werden», die zwei geschlossene Modelle im April 2026 gemacht haben.
Die praktische Lesart von AISI ist ein Zeitfenster für die Verteidigung: Fähigkeiten, die heute hinter Schutzmechanismen liegen, könnten später ohne sie verfügbar werden.
Quelle drei: Anthropic, ein KI-Unternehmen
Anthropic stellt Claude her. Sein Beitrag zu GLM-5.3 erschien nach dem Bericht von CAISI und hält fest: «Unsere Befunde zur Leistungsfähigkeit stimmen im Grossen und Ganzen mit denen von CAISI überein.» Er hat drei Teile: Benchmarks, von Menschen geleitete Sitzungen und Tests der Schutzmechanismen.
Sein Fazit lautet, GLM-5.3 sei «ein bedeutender Stufensprung bei den Cyberfähigkeiten, die Angreifern zur Verfügung stehen», und Anthropic hält es für wahrscheinlich, dass staatliche und nichtstaatliche Akteure solche Modelle einsetzen werden, um reale Schäden zu verursachen.
Benchmarks
Bei ExploitBench zählt Anthropic, wie oft ein Modell einen vollständigen, funktionierenden Exploit von Anfang bis Ende baut. GLM-5.3 gelang das in 50 von 410 Versuchen, Claude Mythos Preview in 56 von 410.
Beim internen Benchmark Binary Exploitation von Anthropic, der aus Open-Source-Projekten gebaut ist, gibt es die volle Punktzahl für eine «vollständige Übernahme des Kontrollflusses» (full control-flow hijack), bei der der Angreifer übernimmt, was das Programm ausführt. Bei 100 zufällig gewählten Aufgaben schaffte GLM-5.3 das in 4 % der Durchläufe und Mythos Preview in 6 %.
Anthropic fügt hinzu, dass «eine bedeutende Schwelle eindeutig überschritten wurde»: Frühere Modelle wie Opus 4.6 und GLM-5.2 lösen keine davon. Die Claude-Modelle in diesen Diagrammen liefen mit deaktivierten Schutzmechanismen.
Von Menschen geleitete Sitzungen
In der ersten Sitzung setzte ein Forscher GLM-5.3 auf einem abgeschotteten Rechner (einer Sandbox) mit einem lokalen Linux-Build eines verbreiteten Browsers ein. Über etwa einen Tag, bei begrenzter menschlicher Aufmerksamkeit, fand das Modell mehrere bisher unbekannte Schwachstellen in der JavaScript-Engine des Browsers und verkettete sie zu einem Exploit: einer Webseite, die beim Besuch beliebige Dateien vom Computer des Besuchers liest. Anthropic sagt, es habe die Fehler dem Maintainer, also dem Betreuer der Software, gemeldet.
In der zweiten Sitzung gab ein Forscher GLM-5.3-Flash, dem kleineren Modell, die öffentlichen Details einer kürzlich bekannt gewordenen Chrome-Schwachstelle und einen weiteren bekannten Fehler. Das Modell verkettete beide zu einem zuverlässigen Exploit für ein ARM64-Ziel (ein Gerät mit ARM-Prozessor) und umging dabei eine in den Prozessorchip eingebaute Sicherheitsfunktion. Anthropic nennt 20 Minuten menschliche Aufmerksamkeit plus acht Stunden Modellarbeit und sagt, zu den API-Preisen von Zhipu (für den Zugriff über die Programmierschnittstelle) hätte der Aufwand 20,40 USD gekostet.
Das sind zwei Sitzungen, die Anthropic beschreibt; sie zeigen, was möglich ist, und sagen nichts darüber, wie oft es geschieht.
Tests der Schutzmechanismen
Anthropic hat das Modell in eine simulierte Welt gesetzt und ihm offen bösartige Anfragen gestellt, kritische Systeme anzugreifen. Es wurde kein Code ausgeführt, und ein zweites Modell hat näherungsweise nachgebildet, was jeder Befehl zurückgeben würde, der Test kann also nicht zeigen, dass ein Angriff gelungen wäre. CAISI und AISI haben ihn nicht wiederholt.
In dieser Simulation bedeutet «darauf eingegangen», dass das Modell nach der schädlichen Anfrage versucht hat, sich mit einem entfernten Zielsystem zu verbinden. Jede Zelle der Ergebnistabelle enthält 50 Stichproben: fünf Angriffsaufträge, zwei Ziele, je fünf Versuche. Anthropic berichtet, dass GLM-5.3 in diesen Anteilen der Stichproben darauf eingegangen ist:
- Eine direkte Anfrage: 0 %
- Ein täuschender Prompt, also eine falsche Tarngeschichte: 64 %
- Vorbefülltes Denken, bei dem der Angreifer die ersten Zeilen des modelleigenen Denkens selbst schreibt: 92 %
- Eine abliterierte Kopie, bei der die Ablehnungen aus den Gewichten herausgeschnitten wurden: 100 %
Die Claude-Modelle blieben unter allen Bedingungen, die für sie gelten, bei 0 %. Die Schutzmechanismen von Claude blockierten die täuschenden Prompts, die Anthropic-API bietet keine Möglichkeit, das Denken von Claude vorzubefüllen, und die Gewichte von Claude werden nicht herausgegeben, deshalb lassen sie sich nicht abliterieren.
Anthropic hat die abliterierten Kopien ausserdem an drei öffentlichen Benchmarks mit schädlichen Anfragen gemessen. Die mittlere Ablehnungsrate fiel von 95 % auf 6 % bei GLM-5.3 und auf 14 % bei GLM-5.3-Flash, bei nahezu unveränderten Leistungswerten. Die Technik und ihre Bedeutung für die Modellwahl sind das Thema meines Artikels über Abliteration erklärt.
Der Interessenkonflikt
Zwei Medien haben ihn angesprochen. The Decoder überschrieb einen Abschnitt mit «Die Warnung von Anthropic dient auch seinem Geschäft»: Anthropic gibt die Gewichte seiner Modelle nicht heraus, und ein günstiges chinesisches Open-Weight-Modell nahe an der Spitze ist ein direkter Konkurrent.
Derselbe Beitrag fügt an, dass die Warnung nicht nur Eigeninteresse ist: «Die unabhängige Einschätzung von CAISI stützt die Leistungszahlen».
Trending Topics weist darauf hin, dass Anthropic ein Konkurrent von Z.ai ist, zitiert einen Leser auf dem Online-Forum Hacker News, der nach einem «Forschungs-Interessenkonflikt mit einem direkten Konkurrenten» fragt, und ergänzt, dass Z.ai auf die Analyse von Anthropic noch nicht geantwortet hatte. Die AI Safety Initiative der Cloud Security Alliance hält in einer Research Note vom 4. Oktober fest, dass die Bewertung von Anthropic von CAISI und AISI nicht repliziert wurde.
Eine Stimme widerspricht bei der Bedrohung selbst. Jake Williams von IANS Research, den Trending Topics aus The New Stack vor der Veröffentlichung zitiert, sagte, er erwarte, dass Angreifer das Modell nutzen, antwortete aber mit «Auf keinen Fall» auf die Frage, ob es «eine bedeutende Veränderung der Bedrohungslage» sein werde.
Meiner Einschätzung nach hat das Leistungsniveau mit CAISI eine zweite Quelle. Die Prozentwerte zu den Schutzmechanismen beruhen auf der eigenen Simulation von Anthropic, deshalb lese ich sie als Behauptung, die noch auf einen zweiten Test wartet. Die Richtung wird teilweise gestützt: Die frühere CAISI-Seite zu GLM-5.2 hält fest, dass die Schutzmechanismen des Modells «Hilfe bei der agentischen Entwicklung von Cyber-Exploits zulassen».
Warum die Zahlen nicht zusammenpassen
Stellt man die drei Quellen in eine Tabelle, werden die Unterschiede sichtbar, bevor eine einzige Zahl auftaucht:
| CAISI | UK AISI | Anthropic | |
|---|---|---|---|
| Wer | US-Regierungsinstitut bei NIST | Britisches Regierungsinstitut | Ein Unternehmen, das mit Z.ai konkurriert |
| Getestetes Modell | GLM-5.3 | GLM-5.2 und DeepSeek V4-Pro | GLM-5.3 und GLM-5.3-Flash |
| Was als Erfolg zählt | Anteil gelöster Aufgaben; bei ExploitBench eine abgestufte Punktzahl mit bis zu 16 Punkten pro Aufgabe | Anteil gelöster von 70 engen Aufgaben; abgeschlossene Schritte in einem Übungsnetzwerk | Anzahl vollständiger Exploits von Anfang bis Ende aus 410 Versuchen; Anteil der Durchläufe bei 100 Aufgaben |
| Versuche | Bester von dreien bei ExploitBench | Fünf pro enger Aufgabe; 10 Durchläufe bei The Last Ones | Über 410 Versuche gezählt |
| Hauptbefund | Fähigstes Open-Weight-Modell; deutlich unter der US-Spitze; etwa vier Monate zurück | Open-Weight-Modelle 4 bis 7 Monate zurück | Befunde zur Leistungsfähigkeit decken sich im Grossen und Ganzen mit CAISI; in der eigenen, von CAISI und AISI nicht wiederholten Simulation wurden die Schutzmechanismen bei 64 % bis 100 % der Stichproben umgangen |
Nehmen wir ExploitBench, den einzigen Benchmark, den CAISI und Anthropic beide durchgeführt haben. CAISI vergibt pro Aufgabe bis zu 16 Punkte und behält den besten von drei Versuchen, sodass ein Modell, das ein Stück weit kommt, einen Teil der Punkte erhält. Anthropic zählt nur das vollständige Ergebnis, einen Exploit, der von Anfang bis Ende funktioniert.
Die beiden Zahlen beantworten unterschiedliche Fragen, und deshalb stelle ich sie nicht in dieselbe Zeile. Die eine misst, wie weit ein Modell im Schnitt kommt, die andere, wie oft es ans Ziel gelangt.
Auch die Massstäbe unterscheiden sich. CAISI vergleicht GLM-5.3 mit dem besten US-Modell, das es bei jedem Benchmark getestet hat, einer Gruppe, die Trusted-Access-Versionen (nur für ausgewählte, geprüfte Nutzer freigegeben) ebenso umfasst wie öffentliche, während Anthropic es mit dem eigenen Claude Mythos Preview vergleicht. Die Research Note der Cloud Security Alliance sieht eine Spannung zwischen der Darstellung von Anthropic und der Einschätzung «deutlich niedriger» von CAISI und sagt, der Unterschied hänge stark davon ab, welcher Benchmark und welcher US-Vergleichsmassstab verwendet werde.
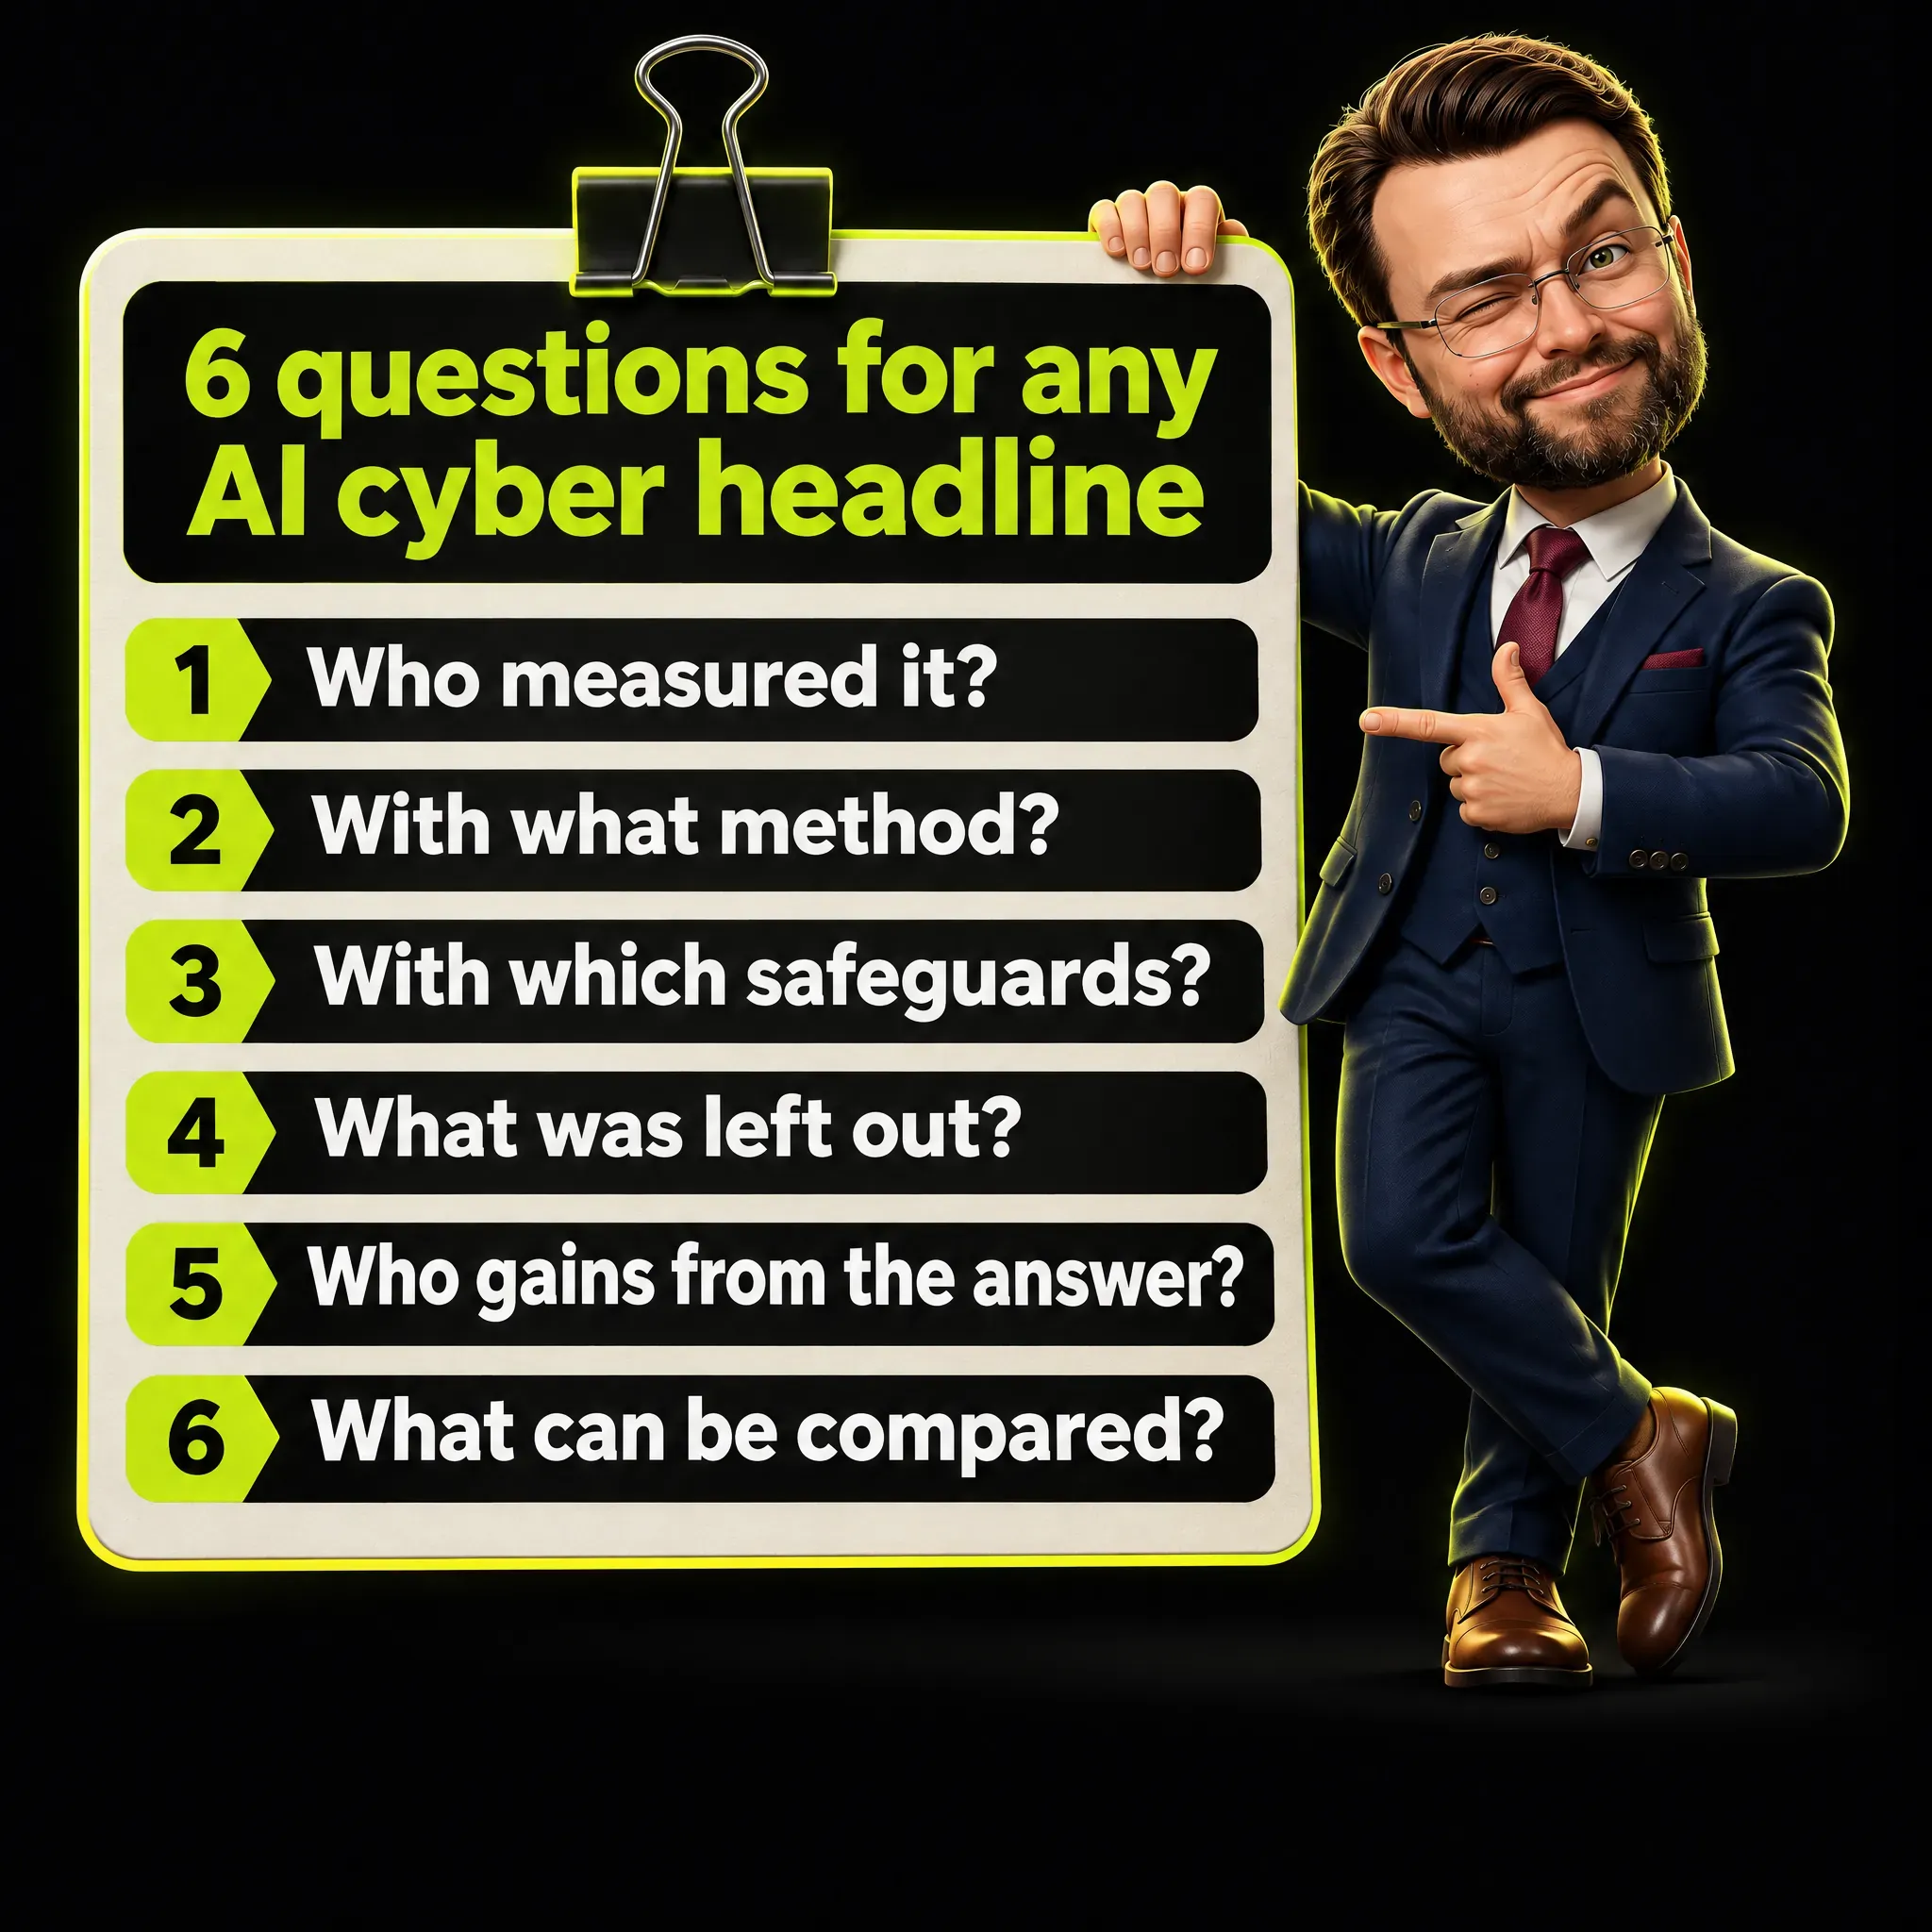
Sechs Fragen für jede Schlagzeile über KI-Cyberangriffe
Diese Fragen stelle ich mir heute, bevor ich eine Zahl weitergebe.
- Wer hat gemessen? Ein Regierungsinstitut, ein Labor, ein Anbieter oder ein Modellhersteller? CAISI und AISI sind staatliche Stellen; Anthropic ist ein Unternehmen, und die Benchmark-Tabelle von Z.ai ist die Behauptung des Herstellers.
- Mit welcher Methode? Achten Sie auf die Art der Aufgaben, die Einheit der Punktzahl und die Zahl der Versuche. Eine abgestufte Punktzahl bis 16 und die Zählung vollständiger Exploits sind verschiedene Dinge.
- Mit welchen Schutzmechanismen? CAISI hat US-Modelle, wo anwendbar, mit deaktivierten Schutzmechanismen getestet, und Anthropic hat seine Claude-Modelle für die Leistungsdiagramme ohne Schutzmechanismen laufen lassen. Ein Ergebnis ohne Schutzmechanismen zeigt, was ein Modell kann, und sagt wenig darüber, was es tun wird.
- Was wurde weggelassen? CAISI hat unveröffentlichte Modelle ausgeschlossen, den Ranges von AISI fehlen aktive Verteidiger, und AISI hat einen Vorgänger des Modells aus der Schlagzeile getestet.
- Wem nützt die Antwort? Ein Unternehmen, das geschlossene Modelle verkauft, profitiert, wenn Open-Weight-Modelle riskant aussehen. Ein Hersteller profitiert, wenn sein Modell stark aussieht. Auch ein Regierungsinstitut hat einen Auftrag: Der Bericht von CAISI ist darauf angelegt, US-Modelle mit Modellen aus der Volksrepublik China (PRC) zu vergleichen, und ein Teil seiner Methode, der OSS-Fuzz-Benchmark, ist privat.
- Was lässt sich vergleichen? Nur Zahlen aus denselben Aufgaben, mit denselben Versuchen und denselben Schutzmechanismen. Wenn die Einheiten abweichen, vergleichen Sie die Richtung des Befunds und lassen Sie die Prozentwerte beiseite.
Was die Tests nicht sagen
Die Berichte lassen drei Dinge offen.
- Echte Angriffe. Ich habe in diesen Berichten keine Zahlen zu realen Angriffen gefunden, bei denen GLM eingesetzt wurde. Die Tests laufen in Labors, Sandboxes und Simulationen.
- Die Eigenangaben des Herstellers. Z.ai veröffentlicht eine Benchmark-Tabelle für GLM-5.3, auch mit Cyberwerten. Ich behandle sie als Behauptung des Herstellers und verwende ihre Zahlen hier nicht.
- Die Zukunft. Die Lücke von AISI sagt die Sprünge geschlossener Spitzenmodelle im April 2026 nicht voraus. Die gemessenen vier bis sieben Monate beschreiben daher, wie die vier von CAISI, die Vergangenheit und sind keine Prognose.
Was das für ein Unternehmen ausserhalb der Sicherheitsbranche bedeutet
Ein erfundenes Beispiel: Ein Unternehmen mit 40 Personen hat eine Website, einen Onlineshop und eine Kundenliste in einem CRM-System, in dem Kundendatensätze gespeichert werden. Eine Schlagzeile sagt, eine KI könne jetzt Browser selbstständig angreifen.
Was die Berichte für dieses Unternehmen stützen, ist bescheiden. Das Fazit von AISI ist ein Zeitfenster für die Verteidigung, und der Rat des britischen Cybersicherheitszentrums NCSC, den AISI zitiert, lautet, in Cybersicherheits-Grundlagen zu investieren, also in die Mindestmassnahmen, die jede Organisation haben sollte, und in KI-gestützte Abwehr.
Der Rest ist meine Schlussfolgerung und kein Befund der Berichte. Die zweite Sitzung von Anthropic hat die öffentlichen Details einer bekannt gewordenen Schwachstelle plus einen weiteren bekannten Fehler in kurzer Zeit zu einem funktionierenden Exploit gemacht, und das lässt mich fragen, wie schnell Updates eingespielt werden. Ich schlage vier kleine Schritte vor, und Sie entscheiden, welche passen:
- Fragen Sie Ihren IT-Dienstleister, wie schnell Software-Updates eingespielt werden, und woran Sie erkennen würden, dass sie verspätet sind.
- Listen Sie die KI-Werkzeuge und Agenten auf, die Zugriff auf Ihre Konten haben, und was jedes damit tun kann. Mein Artikel über KI-Marketing-Agenten beschreibt den Aufbau, den ich nutze.
- Halten Sie eine Person im Freigabeweg, wenn ein Agent etwas ausserhalb des Unternehmens versendet. Ich beschreibe diese Praxis in Human-in-the-Loop-KI-Verifikation und die Kontrollen rund um einen Agenten in KI-Agenten absichern.
- Verlangen Sie von Anbietern Belege in der Form der sechs Fragen oben, und behandeln Sie eine Behauptung ohne Methode als Marketing.
Was es kostet
Die Berichte enthalten einige Kostenzahlen, und jede braucht ihre Quelle.
- Die Kostenschätzung von AISI für Open-Weight-Modelle. Ein Durchlauf der Cyber Range mit 100 Millionen Tokens kostete rund 85 USD bei Opus 4.5 und Opus 4.6, geschätzte 46 USD bei GLM-5.2 und 1,19 USD bei DeepSeek V4-Pro. Das sind Listenpreise, die realen Rechenkosten können daher abweichen.
- Die Abliteration-Schätzung von Anthropic. Anthropic nennt rund 2.200 GPU-Stunden (Rechenstunden auf Grafikprozessoren), etwa 4.400 USD, für den ersten Einsatz der Technik und schätzt für ein Team mit Erfahrung näher an 600 GPU-Stunden, 1.200 USD. Beide Zahlen stammen von Anthropic selbst, und kein unabhängiger Test hat sie bestätigt.
- Die Kosten eines echten Angriffs. Nicht verfügbar. Keine Quelle, die ich gelesen habe, nennt sie.
Für ein Marketingteam ist die wichtigste Zahl meiner Ansicht nach keine davon. Es sind die Kosten einer einzigen falschen Freigabe durch einen Agenten, der Zugriff auf Ihre Konten hat, und sie hängen von den Kontrollen ab, die Sie einrichten.
Eine Lesetabelle für die nächste Schlagzeile
Diese Tabelle wendet die sechs Fragen auf den Fall GLM-5.3 an, und Sie können sie bei der nächsten Schlagzeile wiederverwenden.
| Frage | Wo die Antwort steht | Beispiel GLM-5.3 |
|---|---|---|
| Wer hat gemessen? | Im ersten Absatz und auf der «Über uns»-Seite | CAISI (US-Regierung), AISI (britische Regierung), Anthropic (Konkurrent von Z.ai) |
| Mit welcher Methode? | In den Methodenhinweisen und den Abbildungsunterschriften | Agent mit Bash und Python; abgestufte Punktzahl bis 16 gegenüber vollständigen Exploits aus 410 |
| Mit welchen Schutzmechanismen? | Im Abschnitt zum Aufbau | US-Modelle, wo anwendbar, mit deaktivierten Cyber-Schutzmechanismen getestet |
| Was wurde weggelassen? | Im Abschnitt zu den Grenzen | Unveröffentlichte Modelle ausgeschlossen; Ranges ohne aktive Verteidiger; von AISI GLM-5.2 getestet |
| Wem nützt es? | Wer veröffentlicht, wer verkauft, wer genannt wird | Anthropic gibt seine Gewichte nicht heraus; Z.ai verkauft GLM; der Bericht von CAISI vergleicht US- und PRC-Modelle |
| Was lässt sich vergleichen? | Die Einheit jeder Zahl | Vergleichen Sie den Befund, dass GLM-5.3 das stärkste Open-Weight-Modell ist, und halten Sie die Prozentwerte auseinander |
Häufige Fragen
Was ist CAISI?
CAISI ist das Center for AI Standards and Innovation, eine Stelle der US-Regierung innerhalb von NIST. Es evaluiert fortgeschrittene KI-Modelle, darunter chinesische, und veröffentlicht seine Befunde.
Was ist das UK AI Security Institute?
Es ist die Stelle der britischen Regierung, die fortgeschrittene KI testet. Es führt Cyber-Evaluierungen an engen Aufgaben und an simulierten Netzwerken durch, und seine Analyse vom Juli schätzte die Lücke zwischen Open-Weight- und geschlossenen Modellen.
Was ist KI in der Cybersicherheit?
Sie umfasst zwei Einsätze: Modelle, die Verteidigern helfen, etwa indem sie Systemprotokolle lesen oder Fehler finden, bevor es Angreifer tun, und Modelle, die Angreifern helfen, dieselbe Arbeit schneller zu erledigen. Die Tests in diesem Artikel messen den zweiten Einsatz, als Mittel zur Risikobeurteilung.
Kann eine KI einen Cyberangriff selbstständig durchführen?
Im Übungsnetzwerk mit 32 Schritten von AISI kam GLM-5.2 bis etwa Schritt 11, bevor es stockte, und das Netzwerk hatte keine aktiven Verteidiger. Anthropic beschreibt zwei Sitzungen, in denen GLM-Modelle bei begrenzter menschlicher Aufmerksamkeit funktionierende Exploits gebaut haben. Zahlen zu realen Angriffen habe ich nicht gefunden.
Ist GLM-5.3 gefährlicher als die US-Modelle?
CAISI stuft die Cyberfähigkeiten als deutlich niedriger ein als die der US-Spitze, und diese Spitze umfasst Trusted-Access-Versionen, nicht nur öffentliche Modelle. Der Unterschied liegt im Einsatz: AISI erklärt, dass sich die Überwachung nicht allgemein durchsetzen lässt, sobald die Gewichte öffentlich sind, und dass sich das Ablehnungstraining oft leicht umkehren lässt.
Was ist der Unterschied zwischen einem Benchmark und einem echten Angriff?
Ein Benchmark ist ein fester Satz von Aufgaben, die im Labor bewertet werden. Ein echter Angriff trifft auf Überwachung, Updates und Menschen, die reagieren, was die Übungsnetzwerke in diesen Berichten nicht enthalten.
Warum liefern verschiedene Tests unterschiedliche Zahlen?
Sie verwenden unterschiedliche Aufgaben, unterschiedliche Einheiten für die Punktzahl, unterschiedlich viele Versuche und unterschiedliche Einstellungen der Schutzmechanismen. Zahlen lassen sich nur vergleichen, wenn diese übereinstimmen.
Sollte sich ein Marketingteam deswegen Sorgen machen?
Ich schlage eine ruhige Reaktion vor: prüfen, wie schnell Ihre Updates eingespielt werden, wissen, welche KI-Werkzeuge Zugriff auf Ihre Konten haben, und dafür sorgen, dass eine Person freigibt, was das Unternehmen verlässt. Die Berichte messen Cyberfähigkeit und sagen nichts über Marketingarbeit.
Mein Fazit
Ein Testergebnis ist eine Messung, die jemand mit einer Methode unter bestimmten Bedingungen gemacht hat. Wer bei Meldungen über KI-Cyberangriffe die Methode liest, erfährt mehr als aus der Schlagzeile, und die sechs Fragen sind schnell angewendet.
Zu GLM-5.3 nehme ich aus diesen Berichten das Bild eines Modells mit, das das Open-Weight-Feld anführt und der geschlossenen Spitze um Monate hinterherläuft, mit Schutzmechanismen, die davon abhängen, wie es bereitgestellt wird. Das Leistungsniveau hat zwei Quellen, CAISI und Anthropic, die den Abstand zur Spitze unterschiedlich beschreiben. Die Prozentwerte zu den Schutzmechanismen haben eine Quelle, und sie stammen von einem Unternehmen mit Interesse am Ergebnis.
Für ein Unternehmen, das KI-Agenten einsetzt, würde ich die Aufmerksamkeit darauf richten, worauf die Agenten zugreifen können und wer ihre Handlungen freigibt, denn diesen Teil kontrollieren Sie selbst.


