瓶颈转移了:AI slop与人工审核能力
AI slop生成成本低,检查成本高。瓶颈为何从创作转向审核:真实数据、我自己的失误,还有一份审核预算。
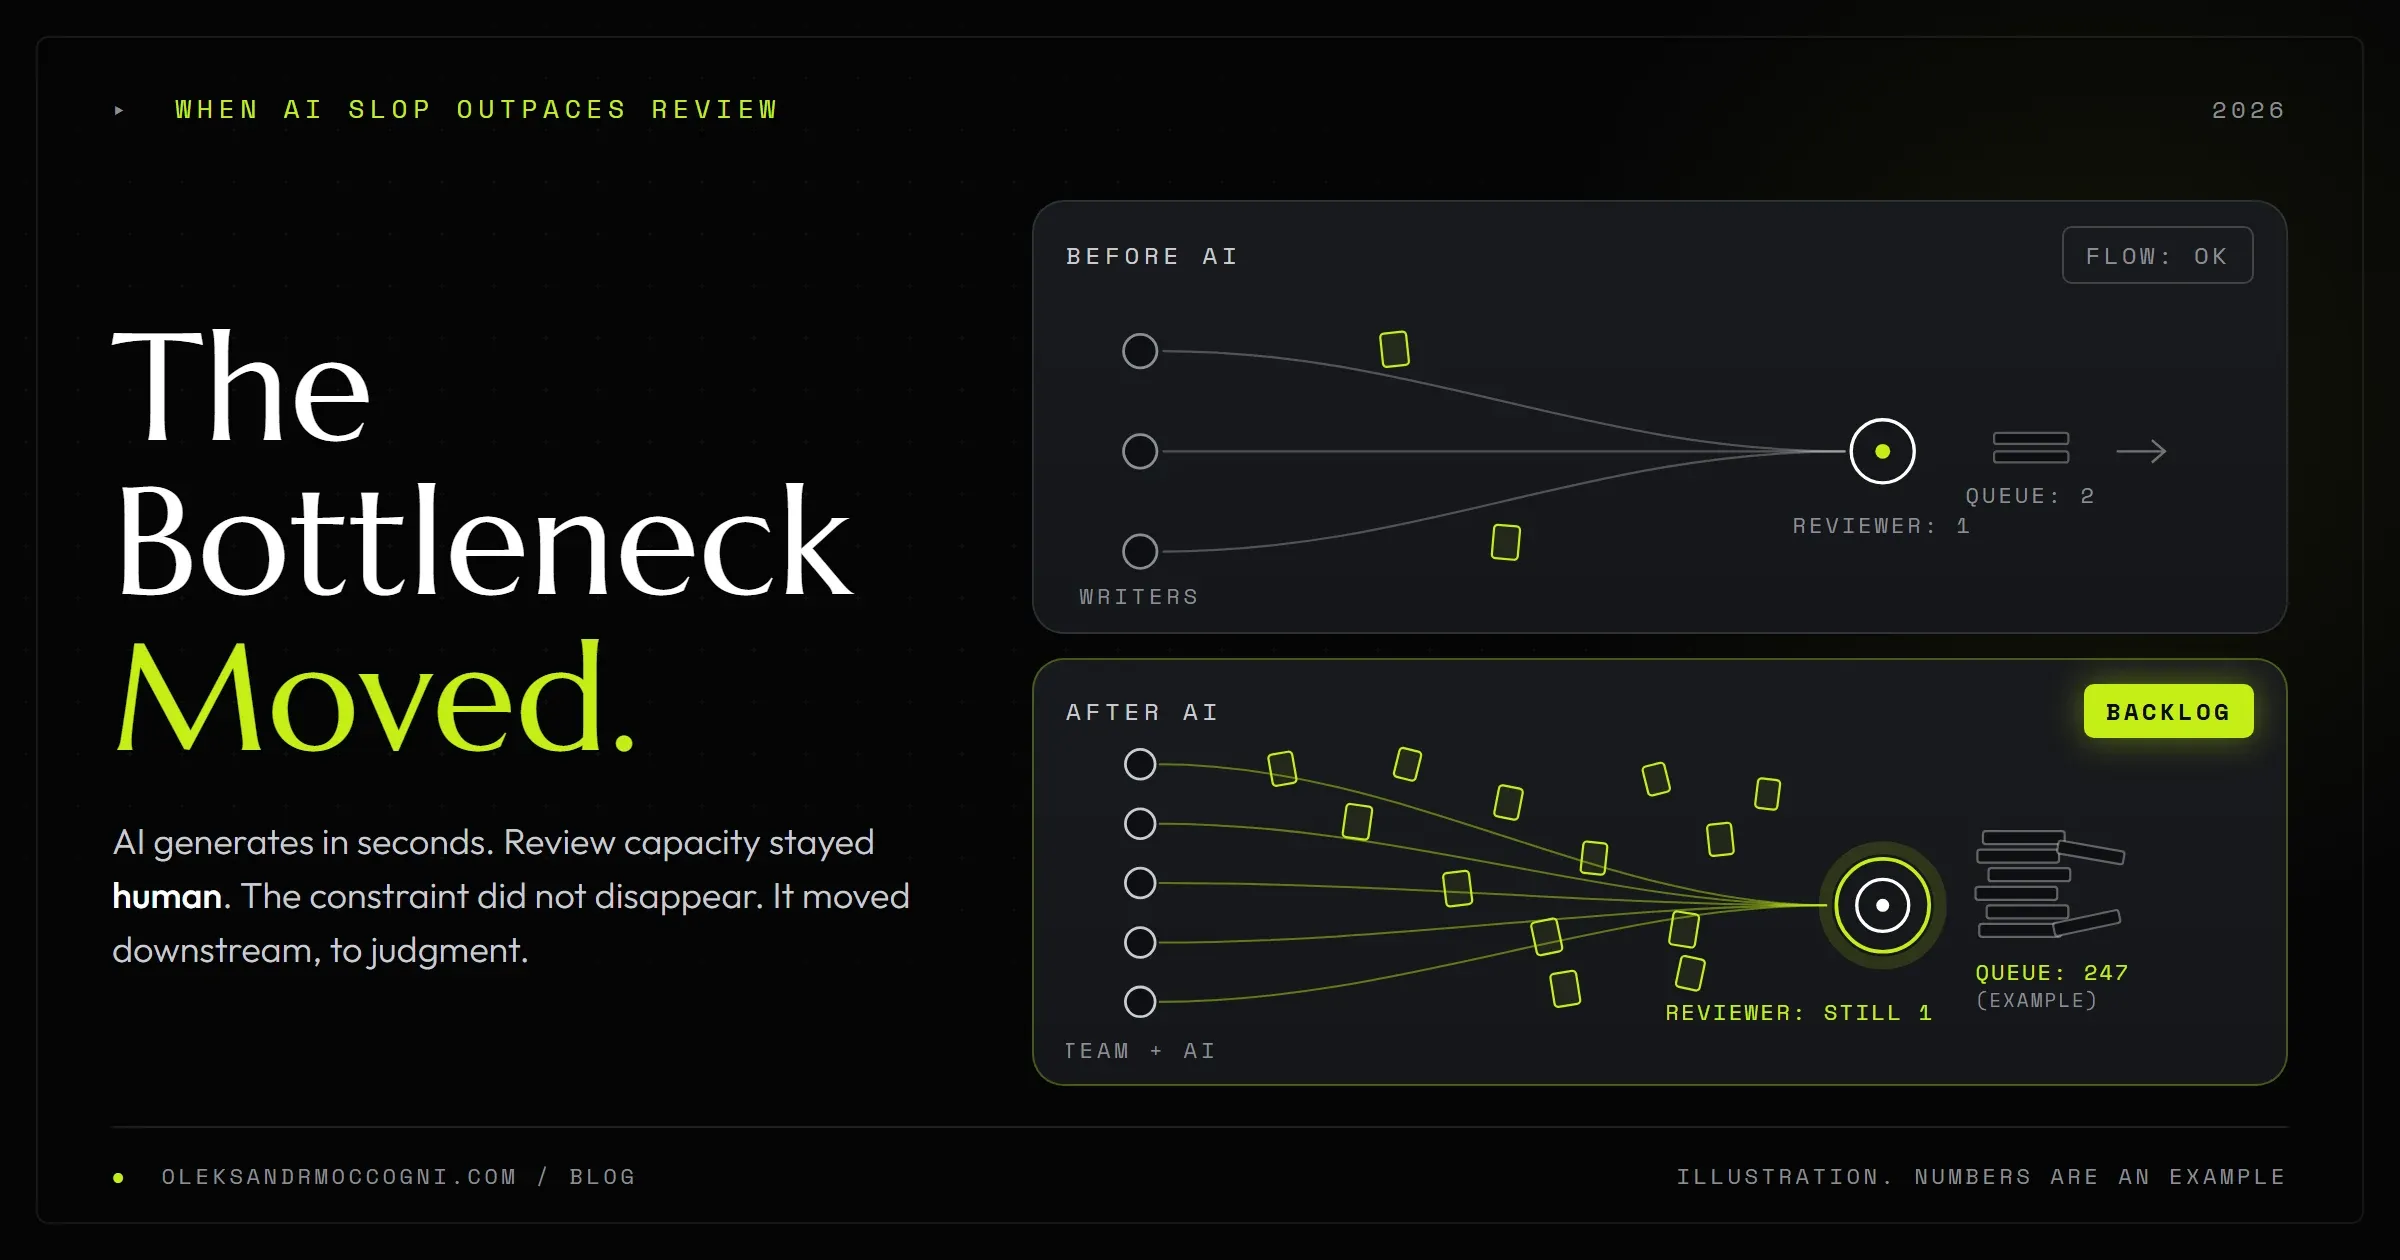
AI slop主要不是写作问题。当产出几乎免费、检查却不免费时,剩下的就是它。
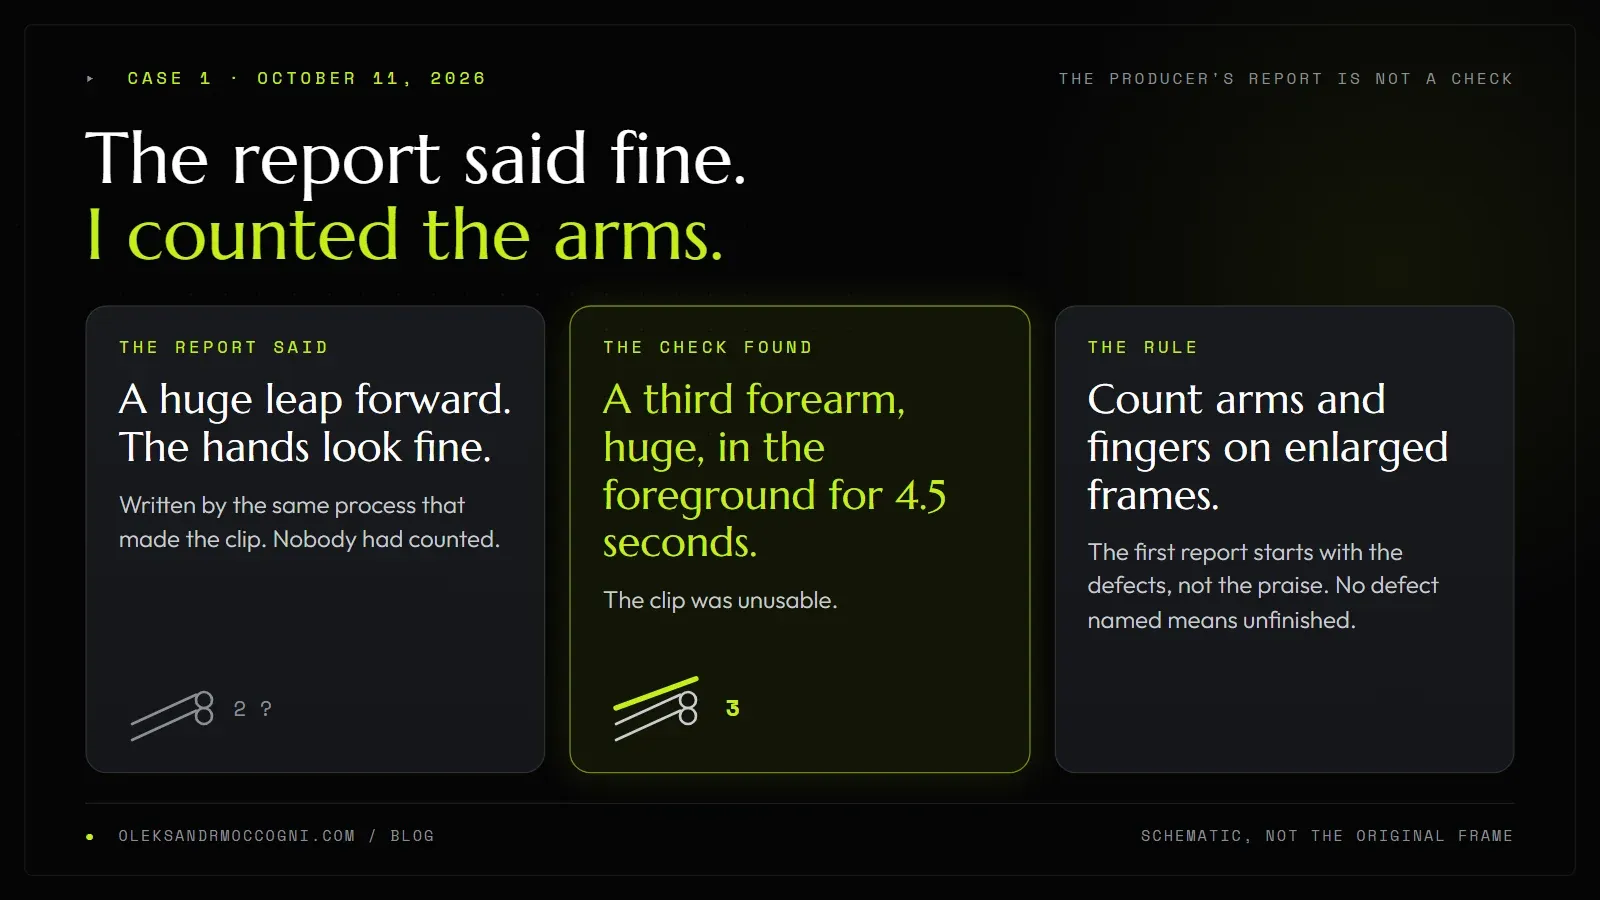
2026年10月11日,一位AI助手告诉我,一部生成短片的第一段是巨大的飞跃,手也没问题。它根本没数手臂。我数了,一条巨大的第三条前臂在前景里停了4.5秒。这段素材没法用。
在这个故事里,模型不是反派。问题出在生成之后的那一步:总得有人去看、去数、去说不行。生成变快了,这一步并没有变快。
这篇文章讲的就是这道缺口。我把它叫作审核瓶颈:工作流中的一个点,看上去已经完成的产出在这里等着一个能判断它的人。我会先定义AI slop,再讲我唯一信任的一组瓶颈数据,接着复盘我自己的流水线骗过我的三次经历,最后给出我现在用的审核预算。
要点先看
- AI slop由缺少审核来定义,而不是由模型来定义。 最广为人知的定义,说的是递给没要求它的人的、未经审核的内容。
- 瓶颈从创作转到了判断。 在一个大型数据集里,AI采用度高的团队合并的pull request多了98%,审核时间增加了91%。
- 生产者自己的报告不算检查。 下面我的三次失误里,做出这份活的系统,同时也说这份活没问题。
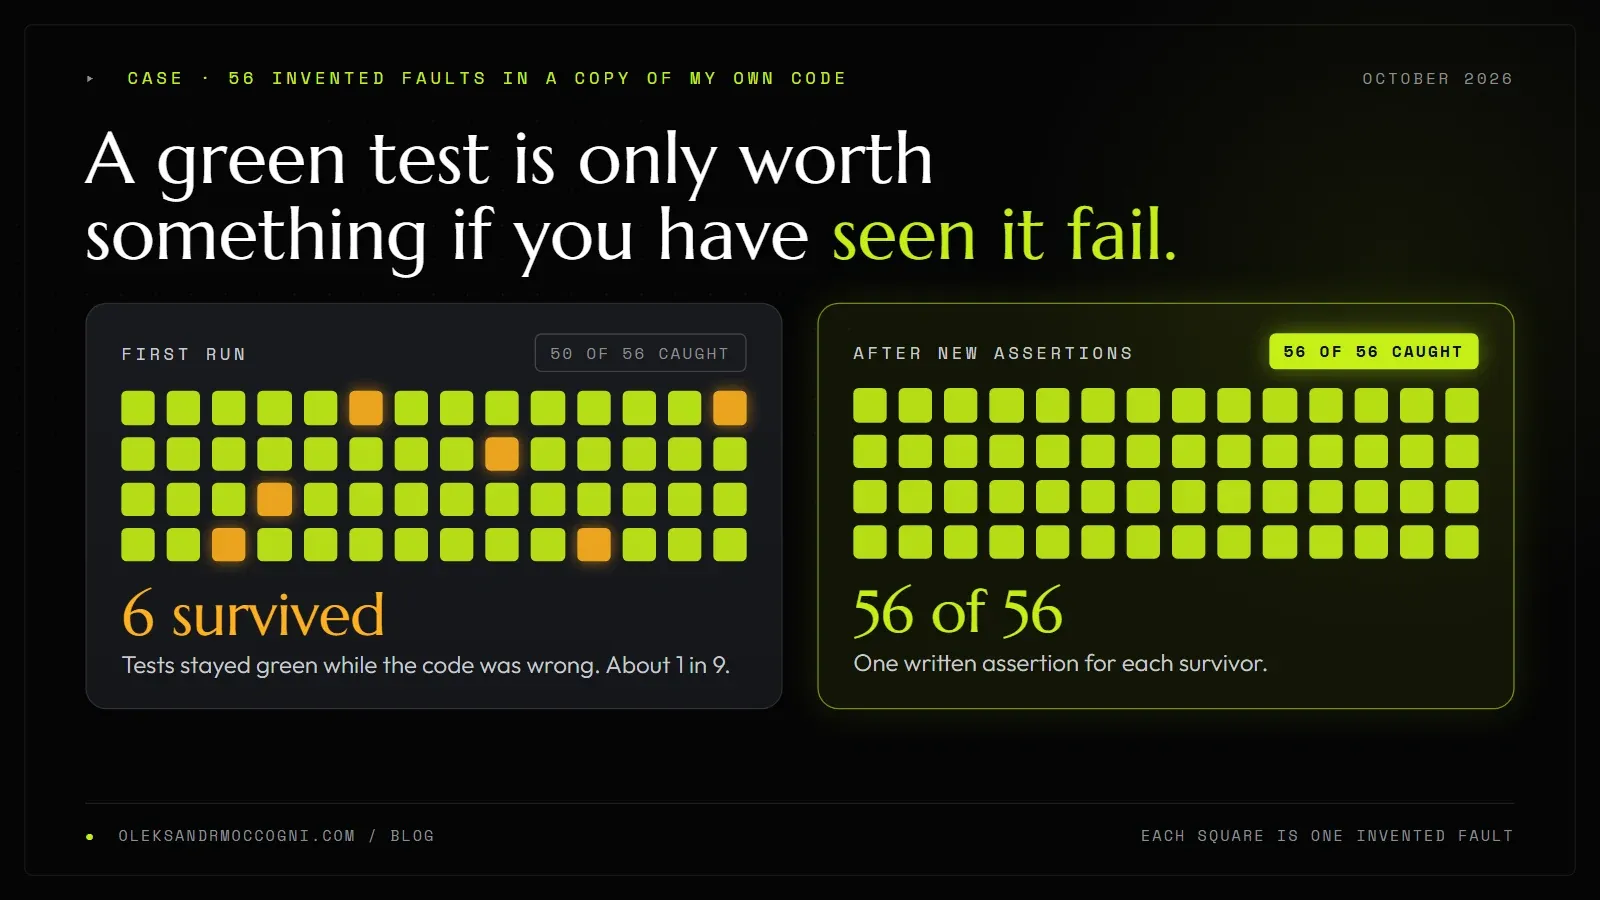
- 机器检查排在最前面。 我在自己代码的副本里编造了56个故障:50个当场被抓到,6个漏网,现在56个全部被抓到。
- 先给审核定预算,再增加产出。 如果未经审核的队列越来越长,就停止生成。
- 永远不要把状态消息当成核实。 列出正在运行的东西,数一数画面里有什么。
什么是AI slop?这个词的含义
“slop”传播得很快,以至于Merriam-Webster把它选为2025年度词汇。按美联社2025年12月15日的报道,这部词典的定义是“低质量的数字内容,通常借助人工智能大量生产”(我的翻译)。词典总裁Greg Barlow列举了例子:荒诞的视频、古怪的广告图片、看上去很真的假新闻、粗制滥造的AI写作电子书。
这是词典里的含义。更尖锐的说法出现得更早。2024年5月8日,开发者Simon Willison在一篇短文里讲清了slop的含义,他说自己“越来越觉得,把未经审核、由人工生成的内容分享给别人,是一种无礼”(我的翻译),并称slop是“这种反模式的理想名称”(我的翻译)。
他还补了一条重要的限定:“并非所有AI生成的内容都是slop。但如果是不假思索地生成,又硬塞给没要求它的人,slop就是最贴切的词。”(我的翻译)
把两个说法合在一起,AI slop有三个部分:
| 测试 | 问题 | 判为slop的条件 |
|---|---|---|
| 有人要求吗 | 读者要求过这个内容吗? | 没有 |
| 审核过吗 | 在它发出之前,有能判断它的人检查过吗? | 没有 |
| 数量 | 它是因为制作便宜而大量生产的吗? | 是 |
看中间一行。slop不是由文字听起来怎样、图片看起来怎样来定义的,而是由缺少审核来定义的。同一段文字,没人检查就是slop,有人检查就没问题。
所以我认为有用的问题不是“怎样阻止AI产出slop?”,而是“谁来检查,他们能检查多少,当产出来得比他们检查的速度还快时会发生什么?”我对智能体工作的回答,写在AI营销智能体里。
AI的瓶颈从创作转到了判断
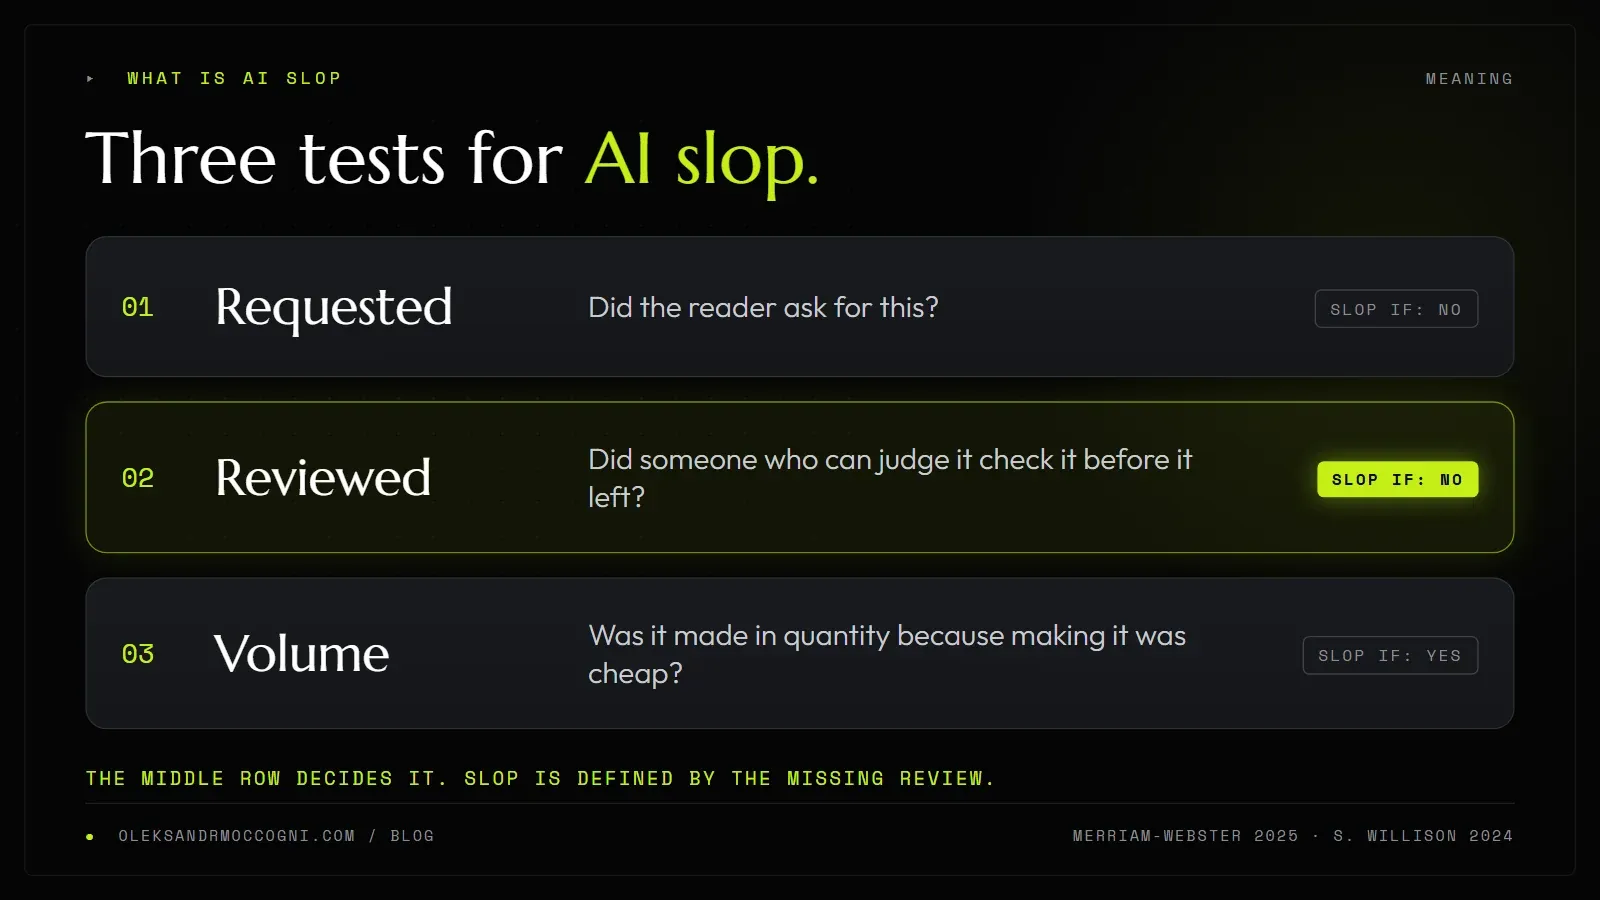
在生成式AI之前,做一份文档、一份报告或一段代码都要花时间。这段时间是天然的节流阀。一个团队交给审核者的东西,不可能比团队写得出来的更多,所以审核能力和创作能力大致是一起增长的。
现在,创作随算力扩展,审核随人的注意力扩展,而注意力是串行的:一个人一次只能读一样东西。当前一个数字上升、后一个原地不动时,队列会自己算出结果。
我用“审核瓶颈”来称呼这件事。看下面这张图:同一个团队、同一个审核者,加入AI之前和之后。图里的数字只是示意,不是数据。
一个说明问题的数据集
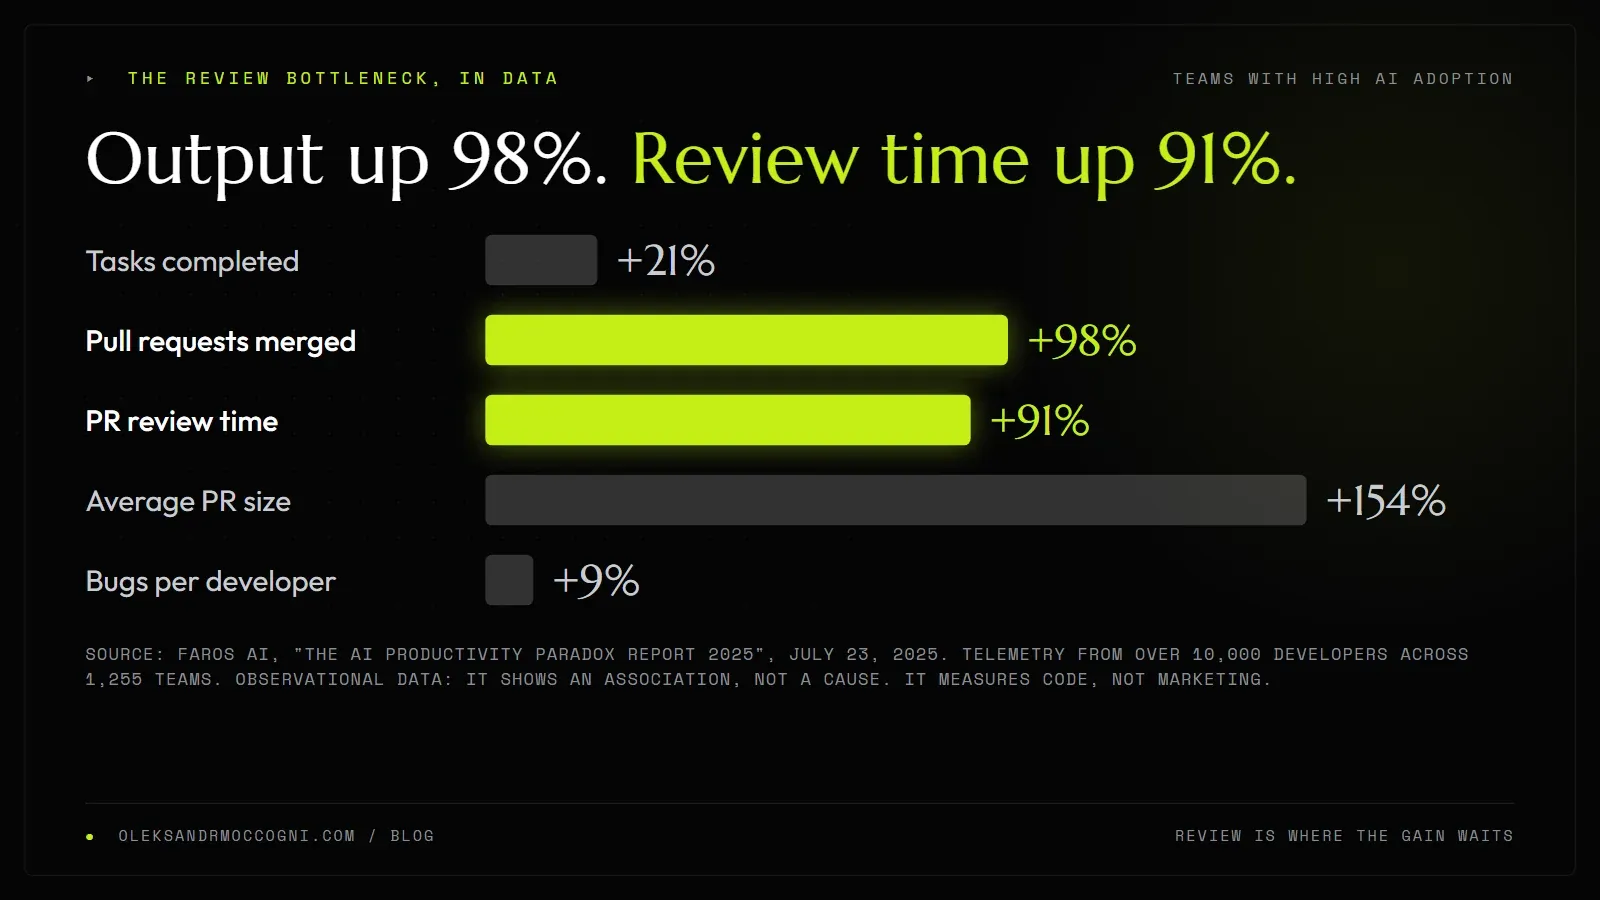
我知道的最好的数据来自软件团队,因为pull request让审核看得见。2025年7月23日发布的一份报告里,向工程负责人销售软件的Faros AI,分析了来自1,255个团队、超过10,000名开发者的遥测数据。它发现,AI采用度高的团队里,开发者“完成的任务多21%,合并的pull request多98%,但PR审核时间增加91%”(我的翻译)。
同一份报告还把AI的采用与平均pull request规模增加154%、每位开发者的bug数增加9%联系在一起。Faros自己把这种格局称为“一个关键瓶颈:人工批准”(我的翻译)。
请仔细读这段话。这是观察性的遥测数据,不是对照实验,所以它只能说明关联,不能说明因果。Faros把产品卖给关心这个问题的人,所以它与这个话题有利益关系。而且它衡量的是代码,不是营销。
不过,这个形状和我在自己工作里看到的一样。产出急剧上升,每一份产出还变得更大,人处理每一份所需的时间也跟着上升。这条链上没有任何一环让审核变得更便宜。
如果你做营销,就把“pull request”换成“投放报告”“文章”“广告变体”或“落地页”。结构完全一样。有人得在它上线之前批准,而那个人就是你。
为什么审核不能像生成那样扩展
我有四个理由,它们来自我自己的工作,而不是来自某项研究:
- 判断是串行的。 我可以同时启动十次生成,却没法同时判断十个。
- 流畅的产出会藏起自己的错误。 精致表格里的一个错数,比草稿笔记里的一个错数更难发现。表面越漂亮,我的检查就越弱,除非我有意把它加强。
- 检查需要生成不需要的背景。 模型不知道项目是做什么用的,也能产出一段视频或一份报告。而审核它的人,恰恰需要知道这一点。
- 没有人会立刻感受到跳过审核的代价。 产出上线了,队列变短了,错误稍后才在别的地方、以别的名字冒出来。
下面是我自己的估计,不是测量值:当我想把一样东西做成正好我要的样子,一次只做一个功能,我花在调试上的时间,大约是标准的纯人工流程所需时间的四倍。整体上我仍然省时间,但这比对AI说一句“直接做”更慢,也更难。我自己的一个项目,在几小时之内而不是几天之内,从很小的范围变成了企业级规模。写代码不再是慢的那一部分,检查它却没有变快。
我自己的流水线骗过我三次
我每天都和AI智能体一起工作,比起重复一个承诺,我更愿意告诉你它们在哪里失败了。这三个案例都是真的,而且每个都是同一个形状:做出这份活的系统,同时也报告说这份活没问题。
1. 第三条前臂(10月11日)
当时我在分段生成一部短片。第一段回来了,助手的报告称它是巨大的飞跃,还说手没问题。我没有数手臂。我去看的时候,一条巨大的第三条前臂在前景里悬了4.5秒。
这份报告并不是有意撒谎。它是做出这段素材的同一个流程写的总结,而这个流程里没有一步要求它必须找出缺陷。
我事后写下的规则是:在放大的画面上数手臂和手指,并且让第一份报告以缺陷开头,而不是以夸奖开头。如果第一份报告说不出任何一个缺陷,我就把它当作没做完。
2. “已成功停止”(10月17日)
我停掉了一个正在跑测试的shell任务。工具回答:“已成功停止。”可是shell和Python进程都还活着。我杀掉其中一个时,shell启动了下一步。
状态消息是一个声明,不是检查。一次你没有核实的停止,只是你希望它停了。
规则是:停止任何东西之后,列出正在运行的进程,重复直到列表为空,然后再继续。
3. 一个不可能失败的测试(9月23日至10月11日)
一个针对线索表单追踪的端到端测试,日期是9月23日,它屏蔽了标签所监听的API调用。监听器从未触发,测试每次都通过。
10月11日,我发现本该只有一个的线索事件,触发了两次,间隔只有50毫秒。我信任了好几周的测试,根本看不到这件事。如果我没发现就把这些数据关联到广告转化上,转化就会被算两次。
规则是:追踪测试必须让API返回一个伪造的成功响应,这样监听器才有东西可以响应。不可能失败的测试不是测试,只是摆设。
先做机器检查
仔细读代码或文字,是最后一道防线,不是第一道。凡是机器能检查的,就让机器去查,把人留给机器判断不了的部分。
这个实验改变了我的想法。我有一个用来运行和监督AI智能体的工具,它的测试套件我自认为不错。为了弄清是不是这样,我编造了56个故障,把它们植入代码的一份副本,然后跑测试。
- 50个故障当场被抓到。
- 6个故障漏网。 代码是错的,测试套件却一直是绿的。
- 我为这6个写了新的断言。最终成绩是56个全部抓到。
56个里漏了6个,约为11%。一个我本来会称之为可靠的测试套件,每九个故障就放过去大约一个。重点不是这个工具做得不好,重点是光读测试,我永远不会知道,而一个绿色的勾,只有在你见过它失败之后才有价值。
关于这件事人的一面,我写在了我关于Human in the Loop的文章里。简短的版本是:不能驳回的闭环只是个仪式。先加机器检查,再加人,最后加记录。
发布前如何识别AI slop
大多数人先用眼睛看slop,这行不通,因为slop很流畅。下面是我改为检查的迹象,每一条都有一个一分钟就能做完的测试:
- 它陈述了它说不出来源的东西。 测试:每个数字、名字和日期,都能追到一个你自己打开过的页面,而不是追到草稿。
- 它很泛。 测试:这一段原封不动放到任何别的公司的网站上,成立吗?如果成立,它对你的公司什么也没说。
- 它含有不可能为真的细节。 测试:数图片里的肢体和手指,读招牌上的字,重算合计,核对单位。
- 它在凑字数。 测试:删掉三分之一。如果什么也没损失,那三分之一就是水分。
- 没人说得清是谁批准的。 测试:文件旁边有一个名字和一个日期。
这些都不需要专门的工具,需要的是节省下来的生产时间本该换来的那段时间。
有些平台已经开始自己检查了:LinkedIn(领英)报告说,截至2026年8月,被它归为AI slop的内容浏览量减少了40%。这个数字从何而来,我在LinkedIn算法如何给帖子排序一文里讲过。
审核预算:我现在怎么工作
解决办法不是“更用力地审核”。更用力地审核同样无法扩展。解决办法是把审核当成预算,用对待钱的同样纪律去对待它。
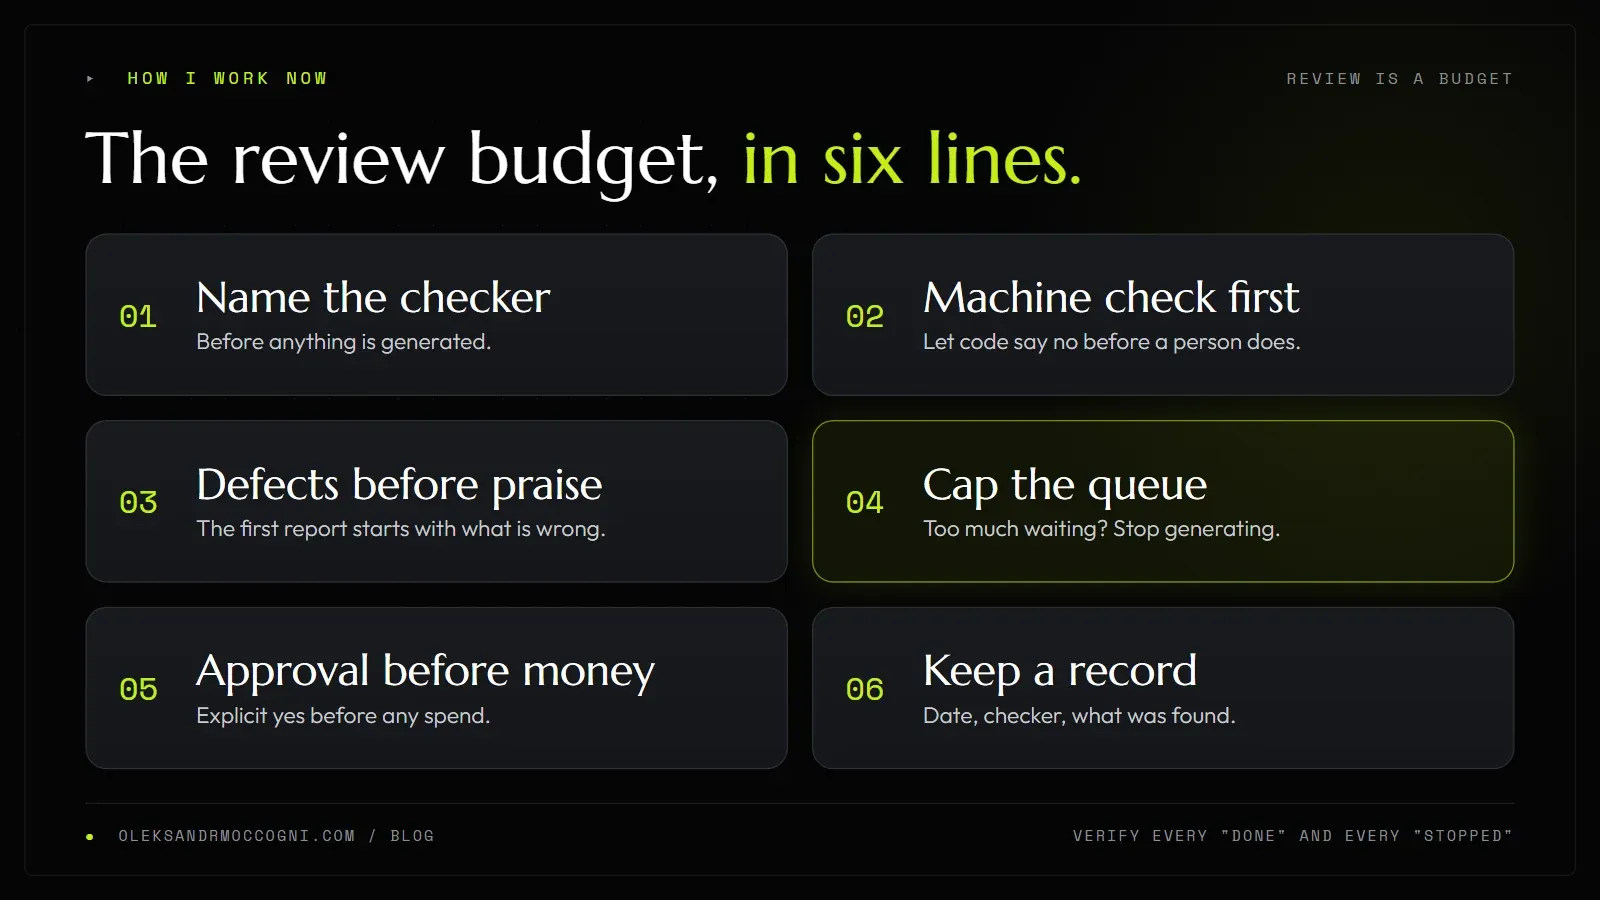
1. 为每类产出指定检查者
对每一类产出,在生成之前先写下由谁或由什么来检查它。没有指定检查者的产出,还不能去生产。
2. 先放最便宜的机器检查
| 产出 | 机器可以检查 | 必须由人判断 |
|---|---|---|
| 代码 | 测试、类型、构建 | 设计,以及与产品是否契合 |
| 追踪 | 返回伪造成功响应的测试、事件计数 | 数据是否回答了业务问题 |
| 视频或图片 | 抽帧、数肢体和文字 | 是否符合品牌、值不值得展示 |
| 报告或文章 | 数字对照来源、链接、日期 | 论证是否正确 |
| 广告改动 | 账户限额、差异对比 | 要不要花这笔钱 |
3. 让生产者先报告缺陷
要求生成流程在报告开头先写哪里有问题、哪些它没能核实、哪些是它假设的。以夸奖开头的报告,是我最不信任的那种。
4. 给队列设上限
如果等待审核的条目数量超过你事先设定的上限,就停止生成,直到数量回落。这和看板里的在制品上限是同一个想法,只是用在了AI产出上。一堆越积越多的未审核产出不是生产力,而是一笔还没开发票的负债。
5. 在花钱之前放一道人工的明确批准
这些是我已经在用于自己智能体的规则。广告活动的改动或花费,只有经过我的明确批准才会发生,即使只是暂停也一样。读取和报告是自由的。对于付费生成,我先要一份预检,写明模型、条目数量和费用。然后在任何批量之前,先评判一个结果。如果这第一个结果被否决,后面所有步骤都停止。
批准和停止要由你自己的流程来执行,别指望模型自带的拒答,开放权重模型的拒答可以被去掉,原理见abliteration是什么。
6. 留一份记录
每次运行一行:日期、谁检查的、发现了什么、改了什么。一个月之后,这份日志会告诉你哪一项手动检查该搬进代码里。五个部分的闭环,我在Human in the Loop那篇文章里讲得更详细。
这对营销团队意味着什么
当一个团队买下了AI的产出这一侧(更多草稿、更多变体、更多报告),却没有给审核这一侧定预算,结果是可以预料的。审核者,通常是经理,成了瓶颈,而他的批准变成了橡皮图章,因为队列永远没有尽头。
看清队列的简单办法
拿你的工具一周能产出的条目数,减去一个人一周能真正审核的条目数。如果结果为正,队列每周就会增加这么多。
下面是一个用编造数字的例子,不是数据。你的工具每周产出120条,一位审核者能认真审核40条。队列每周增加80条,一个月后有320条在等着。没有人会审核320条。它们会被扫一眼、盖个章或者被忽略,而slop正是这样离开了一家从没打算发布它的公司。
三个指标
如果这听上去很熟悉,我建议在购买其他任何东西之前,先看三个指标:
- 队列大小: 此刻有多少AI产出的条目在等人决定?
- 每条的审核时间: 一次真正的审核要多久,而不是扫一眼?
- 漏网率: 在已批准的条目里,有多少在上线之后需要修正?
如果队列在增长而漏网率持平,你不是在抓问题,而是在盲目批准。如果漏网率在上升,slop已经出去了。
审核只是AI项目停滞的原因之一。我那篇AI营销项目为什么会失败讲的是更广的一组原因,而AI营销应用讲的是两年半的日常使用教会我,AI在哪些地方仍然会出错。
这些都不是反对使用AI的理由。我的大部分工作都在用它。这是在主张:把节省下来的生产时间,花在无法自动化的那一部分上,也就是判断什么程度才够好、可以发出去,并且在审核跟不上的时候,愿意少发一些。
常见问题
什么是AI slop?
AI slop是借助AI、通常大量制作、并且没有经过真正审核就被分享出去的低质量数字内容。Merriam-Webster把它定义为“低质量的数字内容,通常借助人工智能大量生产”(我的翻译)。关键的测试是:在它到达没要求它的读者面前之前,有没有人检查过。
AI slop的中文意思是什么?
这个含义有两层。词典层面指低质量、批量生产的AI内容。实际使用层面,来自Simon Willison在2024年的定义,指的是被推给没要求它的人的、未经审核的AI内容。并非所有AI生成的内容都是slop。
怎样避免AI slop?
发布之前先审核,并把生成量限制在你能审核的范围之内。为每类产出指定一位检查者,先跑机器检查,要求生产系统先报告缺陷再夸奖,并给未审核条目的队列设上限。
为什么叫AI slop?
据美联社关于Merriam-Webster这次选择的报道,“slop”最初指软泥,后来指价值很低的东西。人们把这个词用在AI产出上,是因为数量:源源不断、成本低廉、没有人要求过的内容。
所有AI生成的内容都是slop吗?
不是。一个人要求过、检查过并且愿意为之负责的内容,无论由什么工具做出,都不是slop。Willison在2024年的那篇文章里说的是同一个意思。
什么是审核瓶颈?
这是我自己的说法,指工作流中的一个点:看上去已经完成的产出,在这里等着一个能判断它的人。当AI让创作变便宜时,这个点就成了好活能出去多少的上限。
AI能审核它自己的产出吗?
它能抓到一部分错误,但倾向于给自己的活打高分,我的第三条前臂就说明了这一点。请用另一个审核者、一份评分标准,以及可能不通过的机器检查。
我的结论
AI slop是一种症状。原因是失衡:制作的成本掉到了接近零,判断的成本却纹丝不动。靠写更好的提示词解决不了这个问题。解决办法是给审核一笔预算、一位明确的负责人,以及一个会说不的机器检查。
这张卡片:
- 在生成任何东西之前,先指定检查者。
- 先跑机器检查。
- 先要缺陷,再要夸奖。
- 给未审核产出的队列设上限。
- 在花钱之前先放一道明确的批准。
- 核实每一个“完成”和每一个“已停止”。
- 留一份记录,并随着时间把手动检查搬进代码。
Faros的数字以2025年7月23日的发布为准,词典定义以2025年12月15日的报道为准。我自己工作中的案例和统计,在正文中都标了日期。
想让人帮你再看一遍团队如何审核AI产出,并拿到一份贴合你工作流的清单吗?和我聊聊你的审核流程。