Аблитерация модели ИИ: как открытая модель перестаёт отказывать
Аблитерация убирает отказы ИИ-модели правкой её опубликованных файлов. Что показали работа 2024 года и тесты Anthropic на GLM-5.3 и сколько это стоит.
Аблитерация - это приём, который лишает ИИ-модель привычки отказываться выполнять вредные запросы пользователей: правка вносится в опубликованные файлы модели, так называемые веса (weights), после чего поведение отказа отключается, а остальные способности модели, по данным измерявших это исследователей, в основном остаются на прежнем уровне.
В отчёте Anthropic о GLM-5.3, опубликованном 29 сентября 2026 года, этим словом названа правка модели GLM-5.3 от Z.ai, модели с открытыми весами (open-weight означает, что разработчик публикует файлы модели и любой может их скачать). Отказ (refusal) - это когда модель отклоняет запрос, который выглядит вредным, а веса - файлы, в которых хранится всё, чему модель научилась. Аблитерированная модель - это копия открытой модели, отредактированная таким способом.
Я работаю в маркетинге и каждый рабочий день пользуюсь ИИ-моделями, в основном локальными, обученными под мои задачи. Я прочитал источники, стоящие за этим термином, потому что от них зависит, насколько я могу полагаться на встроенную защиту модели, когда выбираю, на чём будет работать агент. В этой статье я объясняю механизм простыми словами и показываю, что измерила Anthropic, а рядом с каждым утверждением указываю интерес его источника.
Инструкций по применению метода здесь нет, и я не выношу суждений ни о какой стране или компании. Цитаты из английских источников я привожу в своём переводе. Полное сравнение тестов GLM-5.3 в кибербезопасности - в моей статье о том, как читать тесты ИИ в кибербезопасности.
Главное коротко
- Аблитерация правит опубликованные файлы модели с открытыми весами, и модель перестаёт отказывать. Для неё нужна копия весов, поэтому, как говорит Anthropic, к Claude её применить нельзя.
- Для этого приёма Anthropic ссылается на исследовательскую работу 2024 года. Ардити с соавторами обнаружили, что в 13 открытых чат-моделях объёмом до 72 миллиардов параметров (настраиваемых чисел внутри модели) отказ определяется одним направлением внутри модели, а свой метод называют «white-box jailbreak» (обходом защиты при доступе к внутреннему устройству модели).
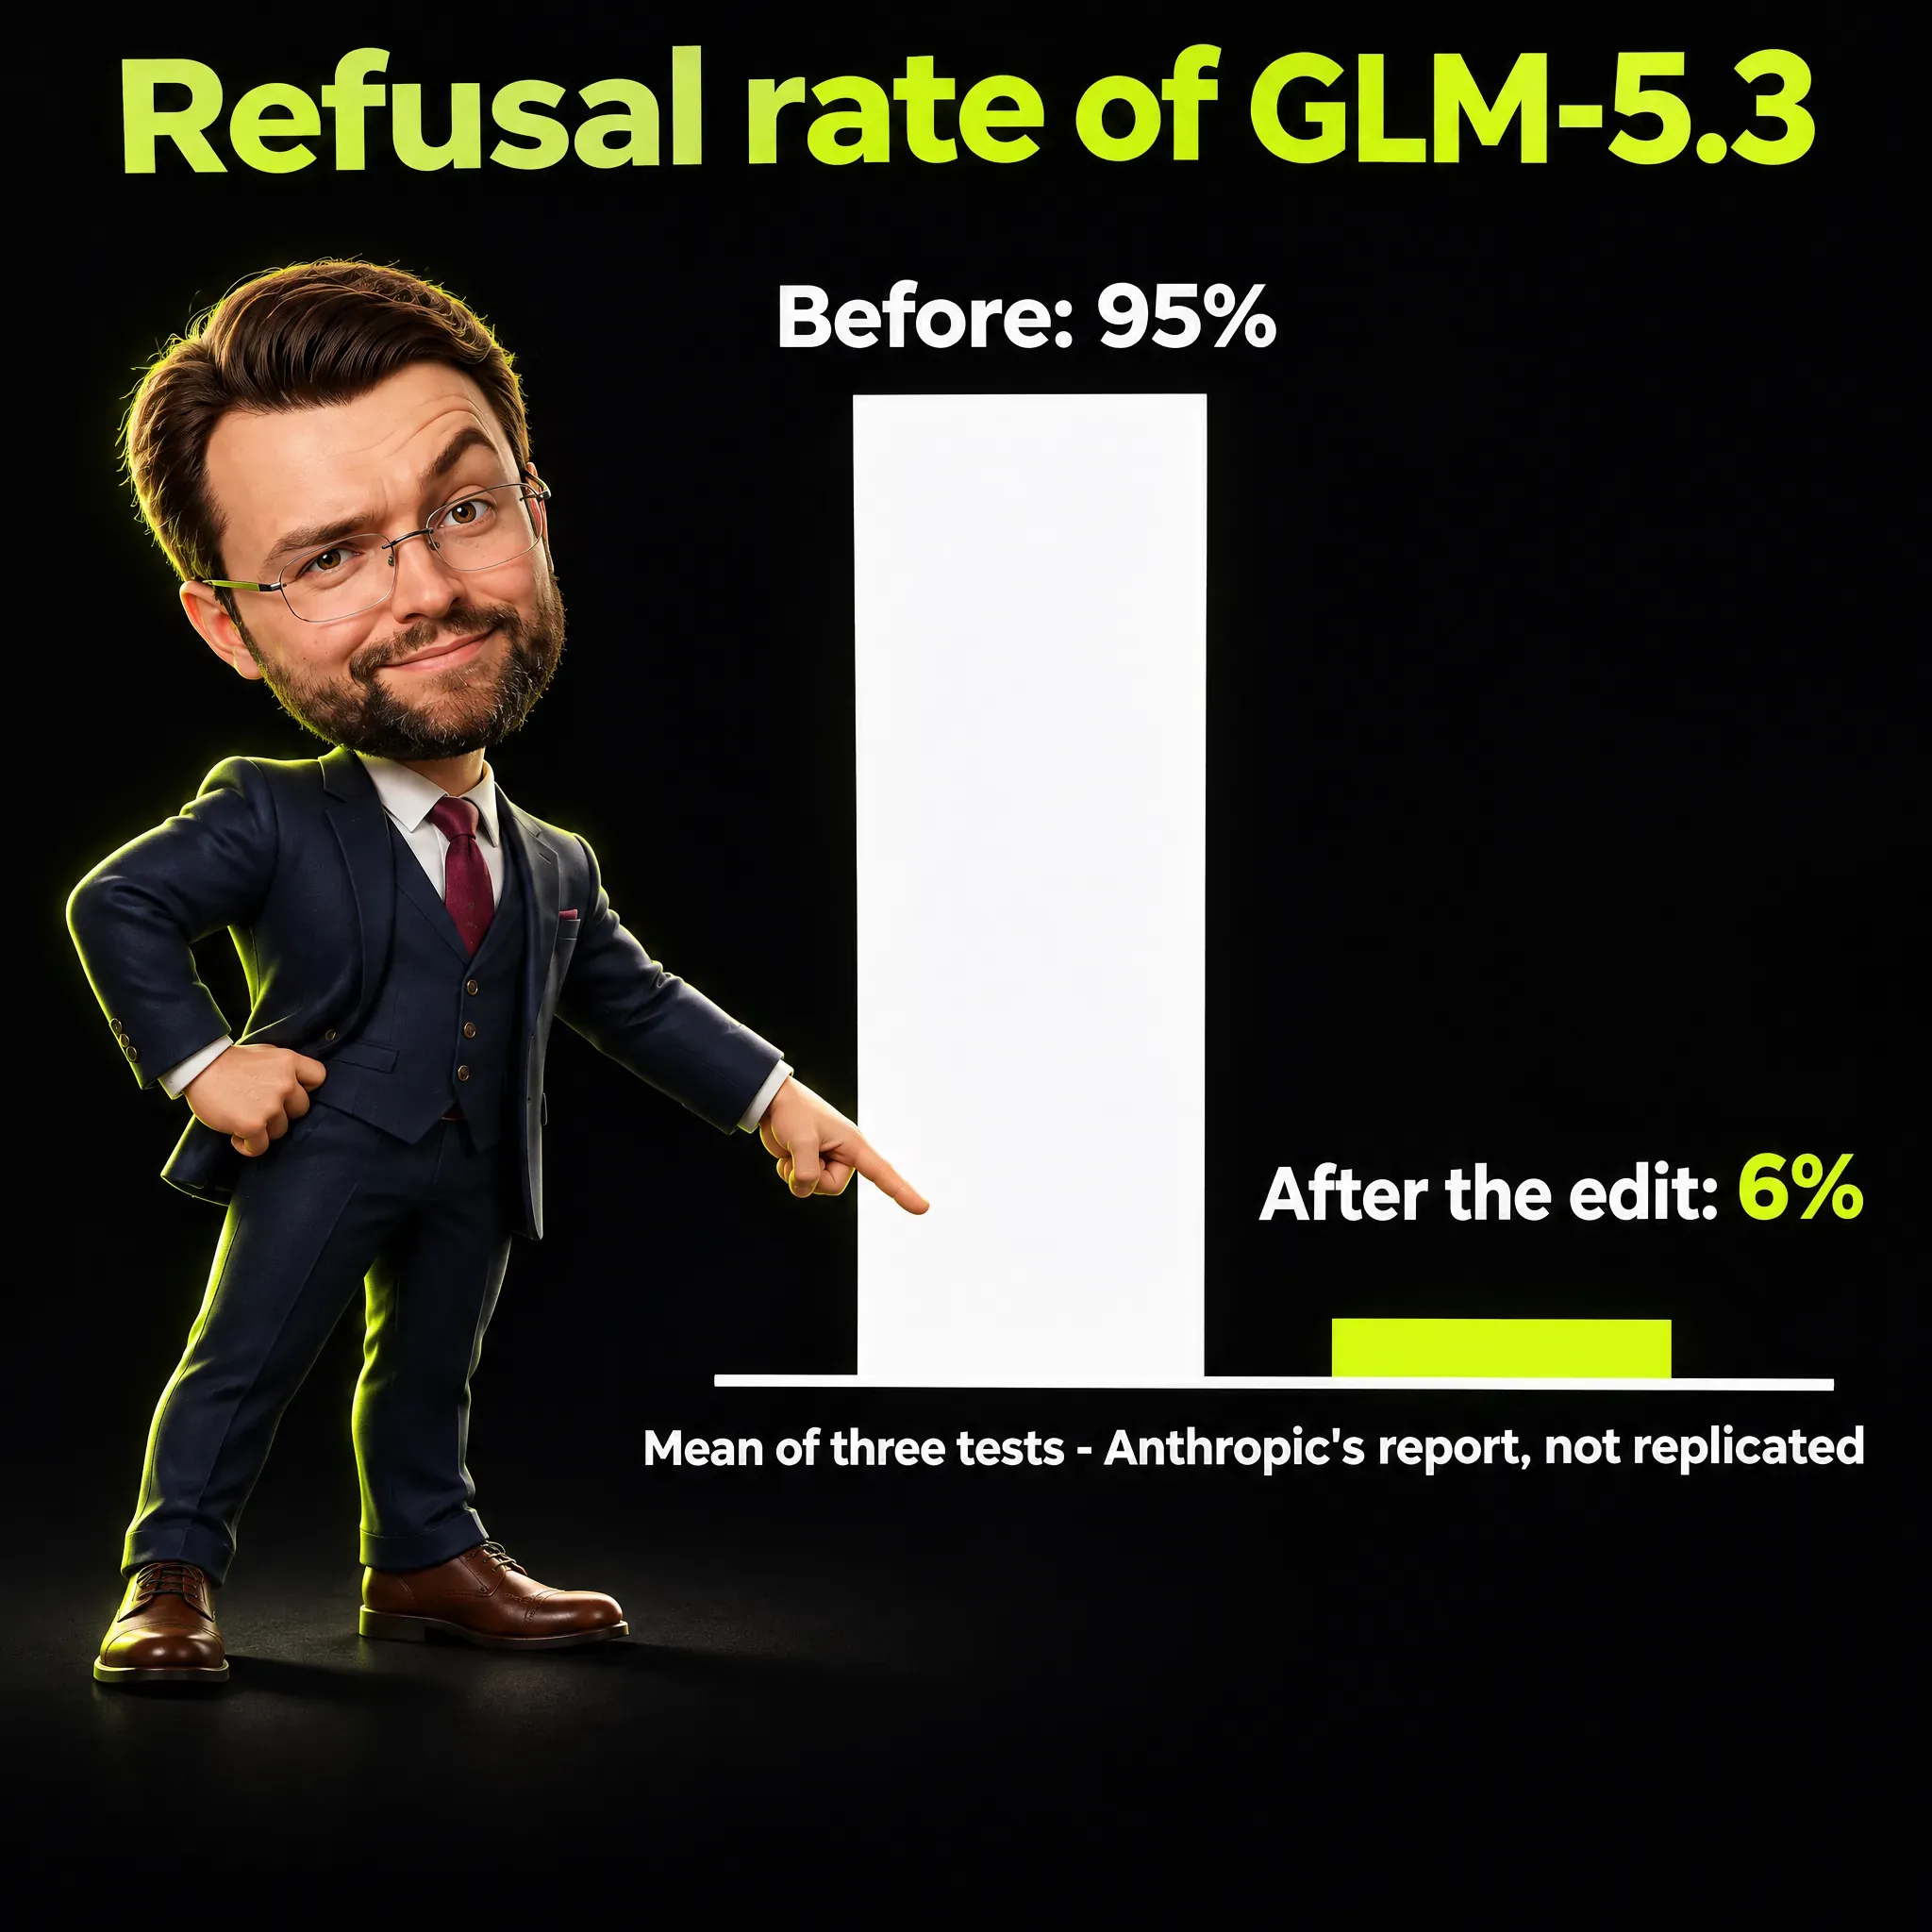
- По данным Anthropic, средняя доля отказов GLM-5.3 после правки упала с 95% до 6%. Независимой проверки этих цифр нет. Cloud Security Alliance (CSA), отраслевая группа по безопасности, пишет, что цифры Anthropic «заслуживают той же тщательной проверки, что и данные любой заинтересованной стороны», и что два государственных тестировщика, CAISI и AISI, их не воспроизводили.
- Два государственных органа говорят нечто похожее в общих словах, и ни один из них аблитерацию не тестировал. Британский институт безопасности ИИ (UK AI Security Institute, AISI) называет обучение отказу «часто легко обратимым при наличии доступа к весам», а американский Центр по стандартам и инновациям в области ИИ (Center for AI Standards and Innovation, CAISI) на странице о GLM-5.2 пишет, что защитные механизмы (safeguards), то есть встроенные меры против вредного использования, «можно обойти при самостоятельном размещении» модели (self-hosted, на собственных серверах).
- Anthropic оценивает затраты на вычисления примерно в 4 400 долларов на первую попытку и около 1 200 долларов для опытной команды. CSA и новостное издание The Decoder повторяют эти цифры, а независимой проверки нет.
- Ни один из прочитанных мной источников не измеряет, как аблитерированные модели используются на практике. Мой вывод: для компании важны средства контроля вокруг модели, то есть кто имеет к ней доступ и кто одобряет её действия.
Что такое отказ и где он находится
Когда вы просите хорошо сделанную чат-модель о чём-то откровенно вредном, она отказывает. Отказ складывается из нескольких слоёв сразу, а аблитерация затрагивает только один из них.
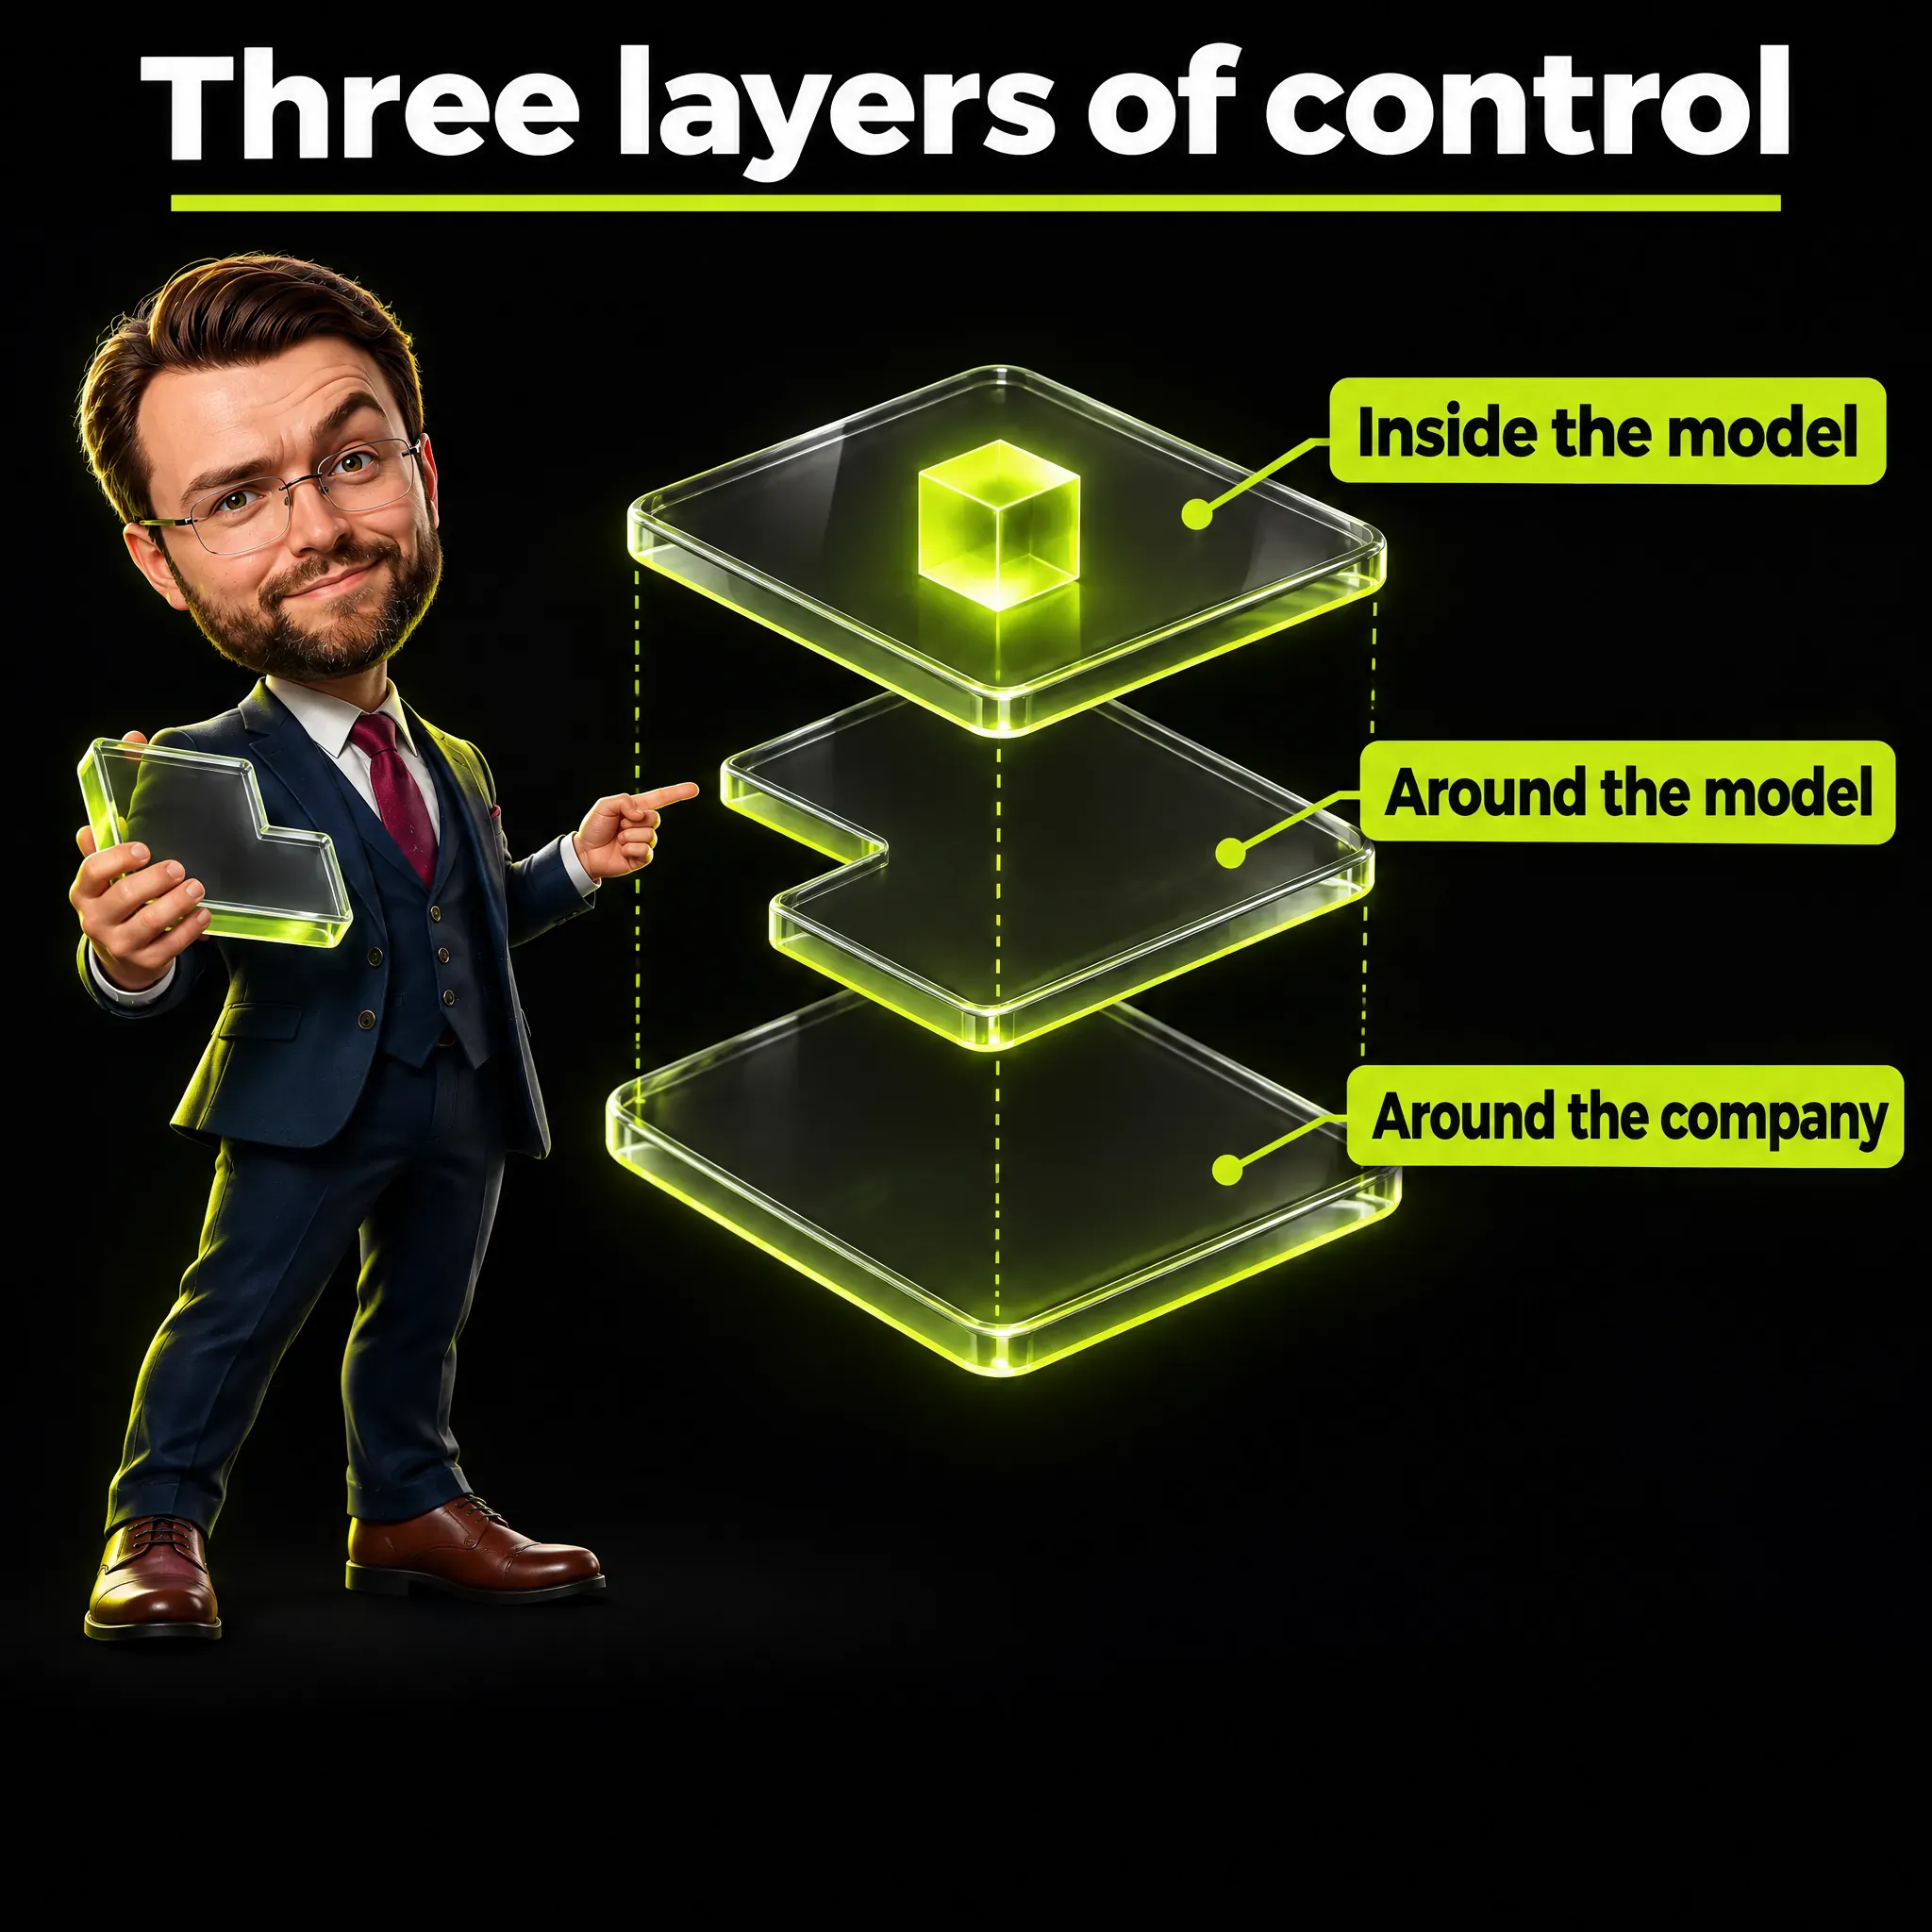
Мне удобно различать три слоя. Первые два взяты из описания моделей с открытыми весами у AISI, а третий - моя собственная формулировка:
- Внутри модели. Обучение отказу (refusal training) - это обучение модели отклонять вредные запросы, и оно закладывает эту привычку в сами веса.
- Вокруг модели, у провайдера. Провайдер может отслеживать запросы, запускать классификаторы (программы, которые сортируют запросы на безвредные и вредные) и блокировать пользователей, злоупотребляющих сервисом.
- Вокруг компании, которая использует модель. Это то, что контролирует пользователь: к каким учётным записям и инструментам имеет доступ модель и какие действия требуют одобрения человека.
В размещённом сервисе, например в Claude через API Anthropic (способ, которым программы отправляют запросы модели через интернет), первые два слоя находятся у провайдера. У модели с открытыми весами разработчик публикует первый слой и передаёт файлы, так что второй слой он больше не контролирует.
Вывод AISI таков: меры второго слоя требуют контроля над доступом к модели и «не могут применяться универсально, когда веса опубликованы». Остаётся обучение отказу, которое AISI описывает как «часто легко обратимое при наличии доступа к весам».
Что делает аблитерация простыми словами
Для этого приёма Anthropic ссылается на работу 2024 года «Refusal in Language Models Is Mediated by a Single Direction» («Отказ в языковых моделях определяется одним направлением»). Её написали Энди Ардити (Andy Arditi) и шесть соавторов, а размещена она на arXiv, открытом сайте научных препринтов. Anthropic называет аблитерацию «стандартной техникой снижения отказов».
Слова «аблитерация» в аннотации работы нет, а её авторы называют свой метод «white-box jailbreak». White-box метод - это такой, при котором атакующий видит внутреннее устройство модели, а для этого нужны веса. Black-box метод, например хитро составленный запрос, работает снаружи и видит только ответы.
Главный вывод работы: в каждой из 13 популярных открытых чат-моделей объёмом до 72 миллиардов параметров отказ определяется «одномерным подпространством», то есть одним направлением во внутренних вычислениях модели. Если стереть это направление, модель перестаёт отказываться выполнять вредные инструкции, а если добавить его, начинает отказывать даже на безобидные.
Вот моя собственная аналогия: представьте микшерный пульт с десятками ползунков, один из которых подписан «осторожность». В этих моделях отказ ведёт себя как этот единственный ползунок, и авторы сообщают, что его опускание оказывает «минимальное влияние на другие способности». Их вывод о безопасности: результаты «подчёркивают хрупкость нынешних методов дообучения безопасности», то есть дополнительного обучения, которое учит модель отказывать.
Эта статья остаётся на уровне принципа, и мне его достаточно, чтобы оценить риск. Насколько я понимаю источники, правка делается на копии файлов, то есть серверы разработчика в ней вообще не участвуют. AISI пишет, что после выпуска моделей «копии можно скачивать, распространять и запускать на частных системах вне какого-либо мониторинга».
Что Anthropic измерила на GLM-5.3
Чтобы понять, насколько приём ослабляет защитные механизмы GLM-5.3, Anthropic сама сделала аблитерированную копию. Она прогнала копию через три публичных бенчмарка (стандартных теста), JailbreakBench, HarmBench и StrongREJECT, которые измеряют, как часто модель выполняет откровенно вредные запросы. Доля отказов - это доля таких запросов, которые модель отклоняет.
Anthropic сообщает, что правка снизила долю отказов GLM-5.3 с более чем 90% до таких значений:
| Бенчмарк | Доля отказов GLM-5.3 после правки |
|---|---|
| JailbreakBench | около 3% |
| HarmBench | около 2% |
| StrongREJECT | 12% |
Диаграмма Anthropic усредняет три бенчмарка. Средняя доля отказов падает с 95% до 6% у GLM-5.3 и с 95% до 14% у более лёгкой GLM-5.3-Flash, тогда как модели Claude отказывают примерно в 96% случаев.
Способности почти не изменились: на GPQA-Diamond, тесте общих научных знаний, обычная и аблитерированная модели показали одинаковый результат, а на проверенном подмножестве кибербенчмарка CyberGym аблитерированная версия набрала на несколько процентов меньше. Anthropic резюмирует, что аблитерация «в целом оставляет способности нетронутыми».
Откуда цифры: одна компания, её собственная аблитерированная копия и три публичных бенчмарка. Что они значат: в этих тестах правка убрала большую часть отказов, а тест по науке и тест по кибербезопасности почти не изменились. Что меняется: пока кто-то другой не повторит тест, я считаю эти цифры утверждением Anthropic, а CSA пишет, что CAISI и AISI цифры Anthropic не воспроизводили.
Anthropic также сообщает, что несколько разработчиков опубликовали аблитерированные версии GLM-5.3 «в течение нескольких дней после выпуска модели». CAISI называет датой выпуска 14 августа 2026 года и пишет, что Z.ai опубликовала веса две недели спустя, поэтому по источникам я не могу сказать, от какой даты считаются эти дни. Ни в одном источнике я не нашёл цифр о том, сколько человек скачивали или использовали эти версии.
Три способа обойти отказ и что нужно для каждого
Аблитерация - один из нескольких способов обойти отказ, и для компании важно, что именно должно быть в руках у человека. Anthropic проверила три из них на GLM-5.3 в имитированном мире, где модель получала откровенно вредоносные запросы на атаку критически важных систем. В исходном виде GLM-5.3 отказывала во всех испытаниях.
В этой имитации «брался за задачу» означает, что после вредного запроса модель пыталась подключиться к удалённой целевой системе. Каждая ячейка опирается на 50 выборок, а код не выполняется, поэтому Anthropic называет такие имитации «несовершенными мерами того, как модель повела бы себя в конкретной ситуации». Сноска добавляет, что киберзадачи в более ранних тестах Anthropic «не вызывали таких отказов у выпущенной модели», поэтому 0% в первой строке описывает только откровенно вредоносные запросы.
| Способ обойти отказ | Что нужно человеку | GLM-5.3 бралась за задачу | Claude, по данным Anthropic |
|---|---|---|---|
| Прямой запрос | Доступ к чату или API | 0% | 0% |
| Ложная легенда в запросе | Доступ к чату или API | 64% | 0%, защитные механизмы заблокировали запросы |
| Предзаполненное рассуждение: атакующий сам пишет начало рассуждения модели | API, который это позволяет | 92% | Невозможно, API не даёт возможности предзаполнения |
| Аблитерированная копия | Веса | 100% | Невозможно, веса пользователям не передаются |
Первые два способа нацелены на слой провайдера: провайдер, который предоставляет модель, может проверять запросы и не предлагать предзаполнение, что, по словам Anthropic, она и делает для Claude. У третьего способа провайдера посередине нет, потому что он применяется к копии файлов. Это моё прочтение таблицы: строка с аблитерацией - та, до которой не дотягивается ни одна мера на стороне провайдера, что согласуется с мыслью AISI о том, что такие меры не работают, когда веса публичны.
Цифры принадлежат одной лишь Anthropic, и она резюмирует, что в её тестах атакующие могут обойти защитные механизмы GLM-5.3 «в 64-100% случаев при помощи простых приёмов». Полная имитация, включая то, как строились выборки, разобрана в моём сравнении тестов AISI, CAISI и Anthropic.
Кто что утверждает и какой интерес у каждого источника
Источники сходятся в принципе, а цифры по аблитерации даёт только Anthropic. Эта таблица держит интерес каждого источника рядом с его утверждением:
| Источник | Что он говорит | Что учесть |
|---|---|---|
| Ардити с соавторами, 2024 (работа на arXiv) | Отказ определяется одним направлением в 13 открытых чат-моделях; дообучение безопасности хрупкое | Модели до 72 миллиардов параметров; в аннотации нет слова «abliteration» |
| UK AISI | Когда веса публичны, мониторинг, классификаторы и блокировка пользователей не могут применяться универсально; обучение отказу часто легко обратимо | Государственный орган тестирования; в его публикации тестировались GLM-5.2 и DeepSeek V4-Pro, а не GLM-5.3, его оценки «в основном не встречали препятствий со стороны защитных механизмов», а теста аблитерации в ней нет |
| CAISI (страница о GLM-5.2) | Защитные механизмы моделей с открытыми весами можно обойти при самостоятельном размещении | Орган правительства США; это одна оговорка на странице о GLM-5.2, а страница о GLM-5.3 приводит результаты кибербенчмарков и аблитерацию не упоминает |
| Anthropic | Средняя доля отказов с 95% до 6% после правки; стоимость около 4 400 долларов | Не публикует собственные веса; CSA пишет, что её цифры «заслуживают той же тщательной проверки, что и данные любой заинтересованной стороны» и не воспроизведены |
| Cloud Security Alliance | «Защитные механизмы, судя по всему, не переживают самостоятельное размещение» | Опирается на цифры Anthropic по одной модели; распространение на системы с открытыми весами в целом - собственный вывод CSA |
| The Decoder (новостное издание) | Предупреждение Anthropic «служит и её бизнесу», а оценка CAISI подтверждает цифры о способностях | Пересказывает других и сам тестов не проводил; CSA пишет, что подача Anthropic кибервозможностей модели «плохо согласуется с» «существенно более низкой» оценкой CAISI |
Если читать вместе, источники сходятся в общих словах: публичные веса отнимают у провайдера контроль, а встроенные отказы - слабое место. Только Anthropic измерила, насколько слабое, и только на GLM-5.3 и GLM-5.3-Flash. The Decoder указывает, что Anthropic не публикует собственные веса, а дешёвая модель с открытыми весами, близкая к передовым, «является ещё и прямым конкурентом».
AISI прямо говорит и о другой стороне. У моделей с открытыми весами, пишет институт, есть реальные преимущества: их можно размещать в частном порядке, без возврата данных к провайдеру, адаптировать под конкретные задачи и запускать по цене вычислений. Они также дают надёжную основу, которую провайдер не может изменить или снять с поддержки.
Моё прочтение такое: принцип в общих словах формулируют работа 2024 года и оба государственных органа, а масштаб эффекта для GLM-5.3 опирается на один отчёт Anthropic. CSA и The Decoder пересказывают этот отчёт, а ни один из государственных органов аблитерацию не тестировал.
Сколько это стоит
Стоимость - то, что я проверил бы внимательнее всего, потому что от неё зависит, сколько людей могут это сделать. Вот цифры из источников, у каждой есть владелец:
- Первая попытка Anthropic на GLM-5.3. Около 2 200 GPU-часов и примерно 4 400 долларов на вычисления, причём делала это команда, которая раньше с этим не работала. GPU-час - это один час работы одного графического процессора (GPU), то есть чипа, на котором запускают ИИ-модели. По моему собственному расчёту, это около 2 долларов за GPU-час.
- Модель поменьше. На аблитерацию GLM-5.3-Flash ушло около 600 GPU-часов. Денежной цифры для неё Anthropic не называет.
- Опытная команда. Anthropic оценивает, что команде, опытной в этой технике и начинающей с нуля на этой модели, потребовалось бы ближе к 600 GPU-часам, или 1 200 долларам.
- Куда ушли часы. Anthropic пишет, что большая часть из 2 200 часов ушла на параллельный перебор вариантов и на проверку возможностей модели после изменений.
- Всё остальное. Время людей, хостинг и стоимость того, что делают с изменённой копией, ни в одном прочитанном мной источнике не приводятся.
Anthropic - единственный источник, который называет число, и оно получено одной командой, на одной модели и в одном отчёте. CSA пишет, что отказ «можно убрать за скромную сумму», а CSA и The Decoder повторяют цифры Anthropic.
По этим цифрам, аблитерация модели такого размера потребовала тысяч долларов на вычисления, и открытый вопрос смещается от того, по карману ли это кому-то, к тому, кто стал бы это делать и зачем. Ответа на него я ни в одном источнике не нашёл.
Цифра в 1 200 долларов требует отдельной оговорки. Это оценка для гипотетической опытной команды, приведённая в сноске, и Anthropic её не измеряла.
Что это меняет для компании, использующей открытые модели
Механизм и стоимость приводят к одному практическому следствию. Для модели с открытыми весами я считаю отказы разработчика настройкой по умолчанию, поскольку источники не дают оснований обещать, что они сохранятся в чужой копии. CSA приходит к тому же выводу для компаний: они «не должны рассматривать защитные механизмы провайдера модели как основное средство против злоупотреблений со стороны других», когда система имеет открытые веса.
Две категории компаний сталкиваются с этим по-разному:
- Компания, которая запускает модель с открытыми весами на собственных серверах, часто по причине конфиденциальности, которую называет AISI, владеет копией весов, и эта копия считается активом. Второй слой, то есть мониторинг и одобрения вокруг модели, - это то, что компания строит сама, а совет CSA - составить опись таких моделей и «относиться к весам модели как к чувствительным активам».
- Компания, которая пользуется ИИ только через сервис, видит вопрос об аблитерации как вопрос о том, что другие делают с открытыми копиями. Полезнее другой вопрос: до чего могут дотянуться её собственные агенты и к чему посторонний мог бы склонить агента, например спрятав инструкции на веб-странице или в письме, которое агент читает, - об этом я пишу в статье про безопасность ИИ-агентов.
Придуманный пример: дизайн-агентство из 12 человек запускает модель с открытыми весами на собственном сервере, чтобы файлы клиентов не покидали здание, - это первое преимущество, которое называет AISI. Агент на этом сервере читает входящие письма клиентов и готовит ответы. Встроенные отказы модели - первый слой, а агентство добавляет тот, который контролирует само: агент читает только папку входящих, и ничего из подготовленного им не уходит без одобрения человека.
Теперь предположим, что кто-то в агентстве подставил изменённую копию модели, которая отвечает свободнее. Встроенные отказы исчезли, но агент по-прежнему читает только папку входящих, и каждый исходящий черновик по-прежнему ждёт человека. В этом выдуманном примере оба ограничения продолжают действовать, хотя ни один источник не проверял, что они выдержат, а черновик, проскочивший мимо торопливого проверяющего, всё равно остался бы путём, по которому информация может уйти.
CSA рекомендует то же направление для компаний с доступом к инструментам: пересматривать этот доступ «исходя из предположения, что защитные механизмы, основанные на отказах, не выдержат состязательных запросов», то есть запросов, составленных, чтобы обмануть модель. Этап одобрения я описываю в статье о проверке ИИ с участием человека, а настройку, которую использую для агентов, - в материале об ИИ-агентах для маркетинга.
Я бы не читал ничего из этого как довод против моделей с открытыми весами. Сам AISI называет преимущества, важные для компании, которая хранит данные клиентов у себя, а во что обходится запуск такой модели, разобрано в статье о стоимости собственной LLM на сервере. Вывод, который я делаю, скромнее: модель я выбираю по качеству и цене, а средства контроля безопасности строю вокруг неё сам.
Что остаётся неизвестным
Источники оставляют эти вопросы открытыми:
- Воспроизведение. CSA пишет, что CAISI и AISI цифры Anthropic не воспроизводили. Опубликованные тесты AISI касались GLM-5.2 и DeepSeek V4-Pro, а каждая ячейка имитации атаки у Anthropic опирается на 50 выборок.
- Что показывает имитация. Поскольку код в ней не выполняется, указывает The Decoder, она показывает, что модель пытается сделать, и не может показать, удалась бы атака.
- Размер и метод. Работа 2024 года тестировала модели до 72 миллиардов параметров, тогда как на странице GLM-5.3 в Hugging Face указано 753 миллиарда. Anthropic сама аблитерировала GLM-5.3 и ссылается на эту работу как на источник метода, но проверить, насколько близки два метода, я не могу.
- Использование в реальности. Я не нашёл данных о том, как часто используются аблитерированные модели и какой вред за этим последовал.
- Закон. Законно ли изменять такие копии, делиться ими или пользоваться ими, - вопрос к юридическому консультанту, и юридических советов я здесь не даю.
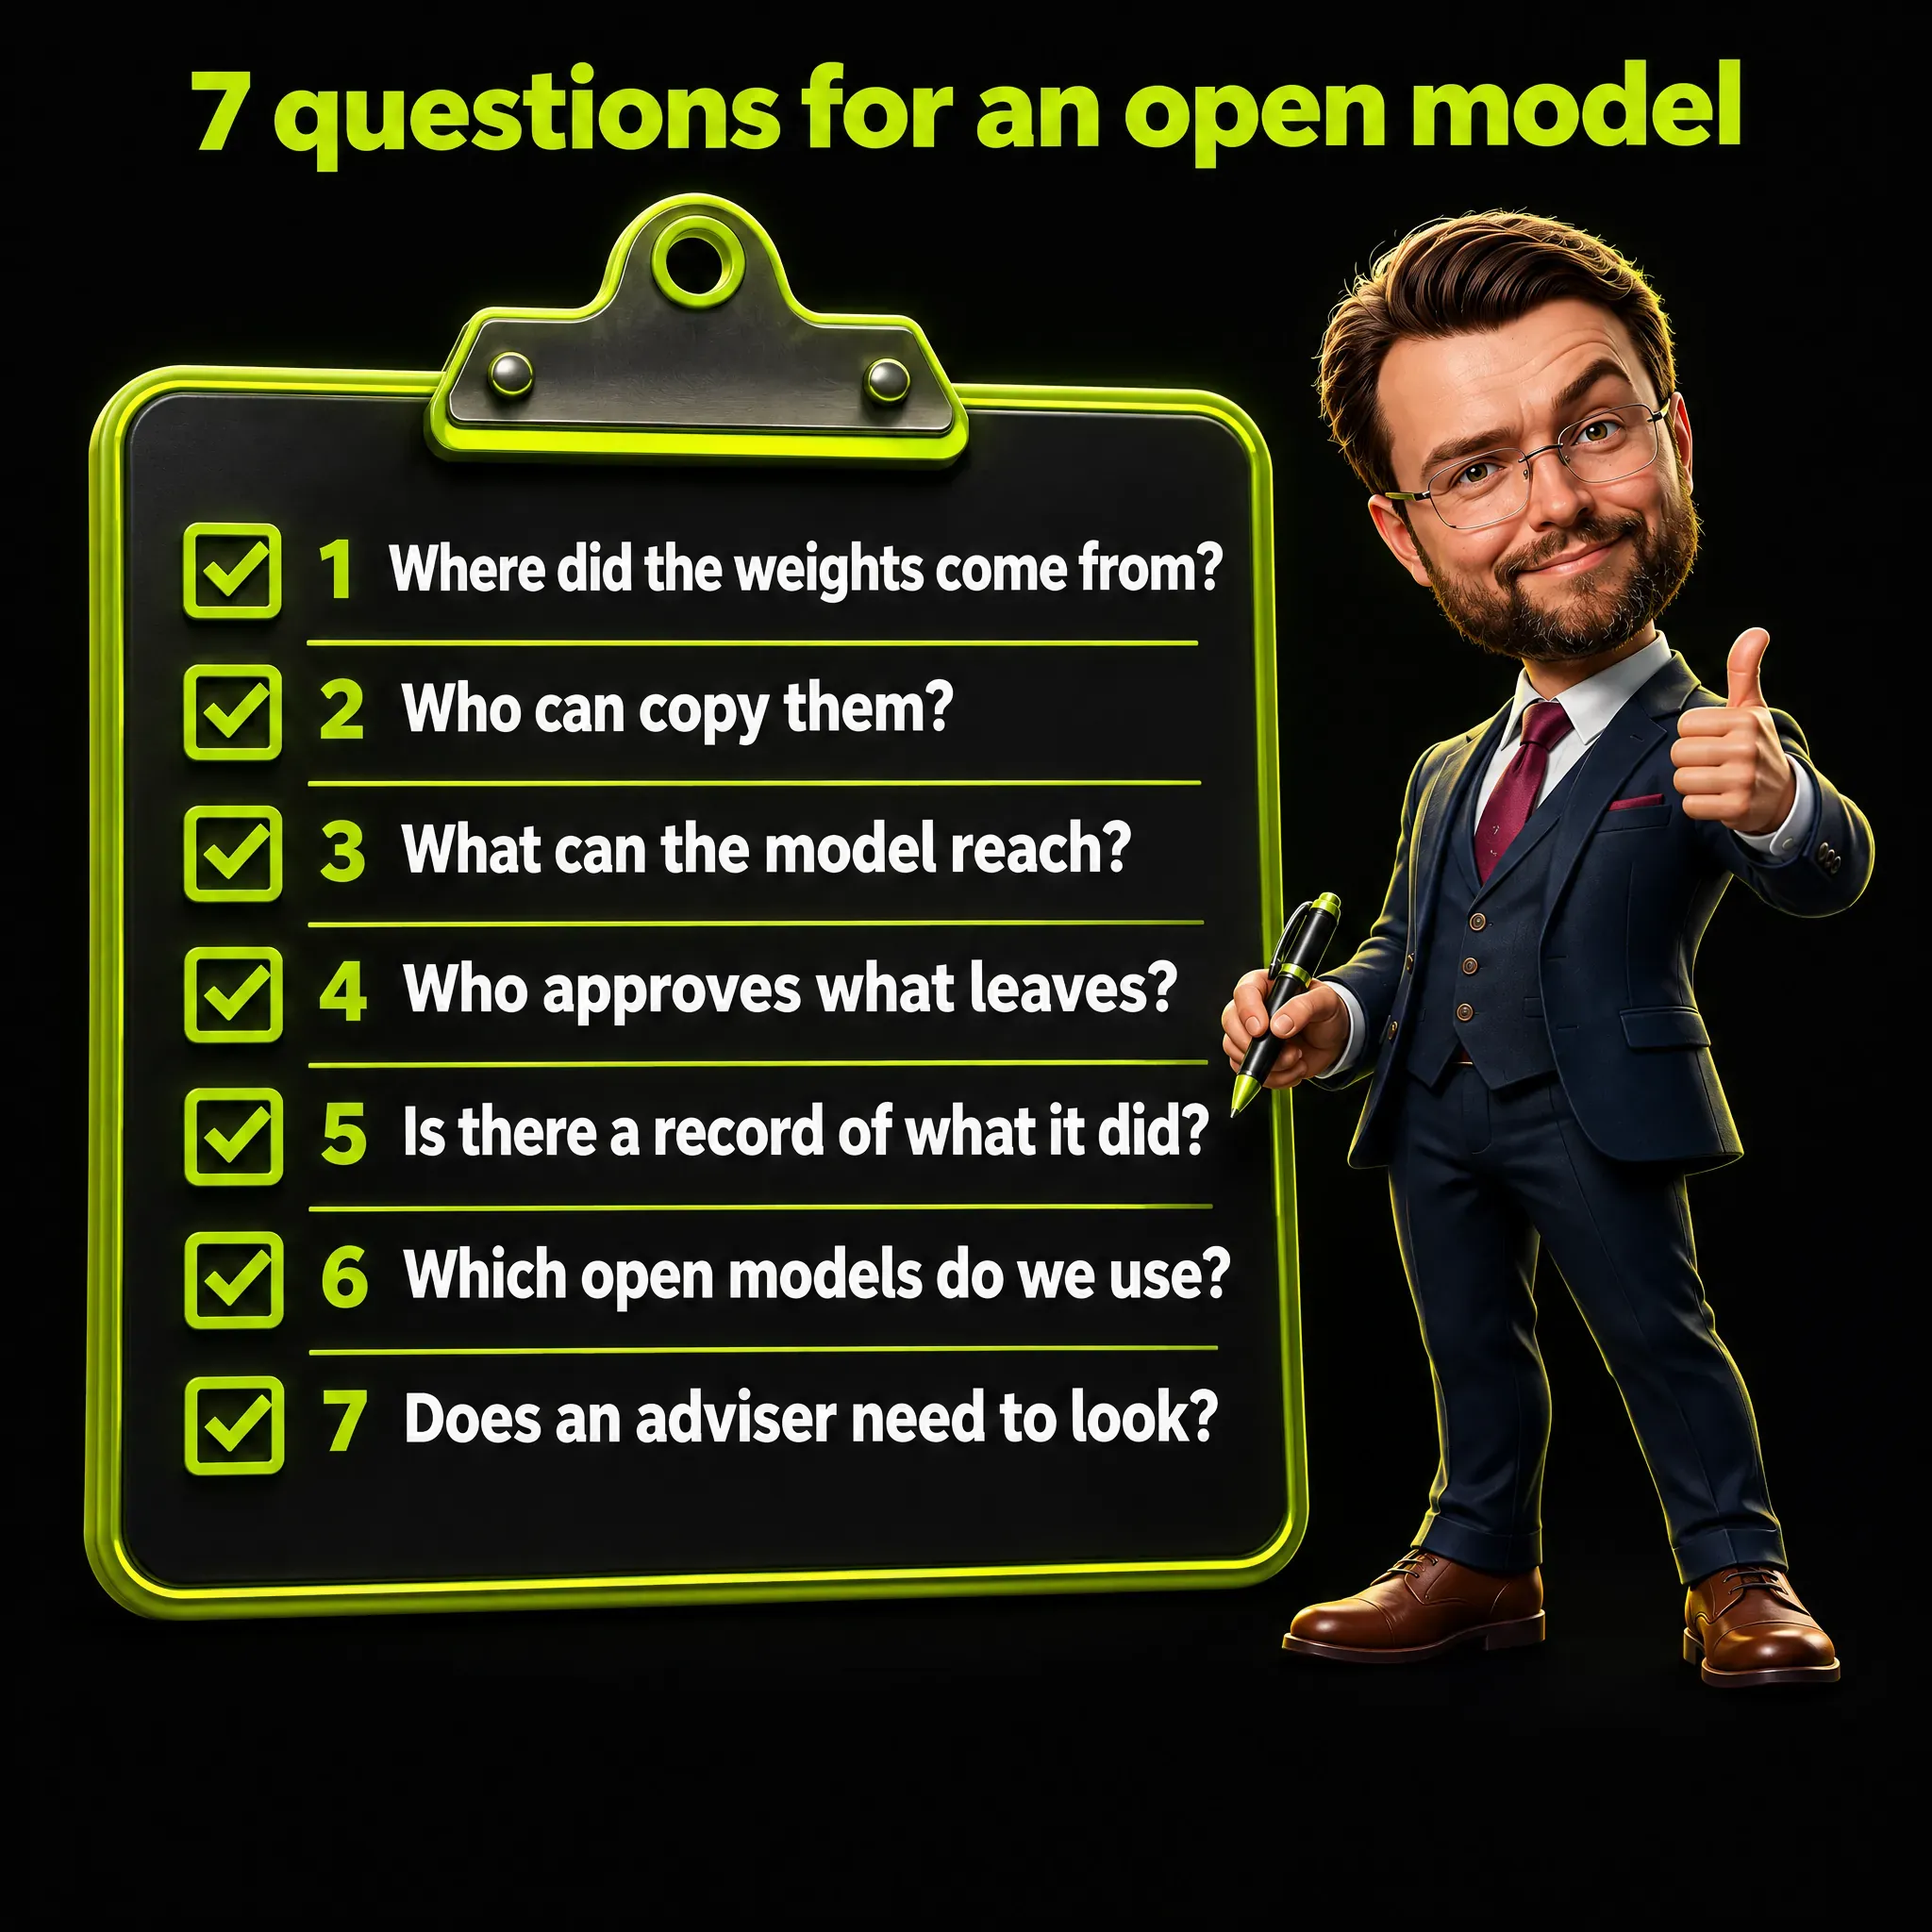
Чек-лист перед использованием или покупкой открытой модели
Эта таблица превращает источники в вопросы, которые менеджер без технической подготовки может задать провайдеру или ИТ-команде:
| Вопрос | Почему это важно | Что бы я запросил |
|---|---|---|
| Откуда взяты веса? | Anthropic пишет, что несколько разработчиков опубликовали аблитерированные версии GLM-5.3 | Страницу самого разработчика в качестве источника, зафиксированную письменно |
| Кто на нашей стороне может копировать веса? | CSA: относиться к весам модели как к чувствительным активам | Названного ответственного и короткий список людей с доступом |
| До чего может дотянуться модель? | CSA: исходить из того, что защитные механизмы на основе отказов не выдержат | Список учётных записей, папок и инструментов, которыми модель может пользоваться |
| Кто одобряет действия, выходящие за пределы компании? | CSA: защитные механизмы провайдера не должны быть основным средством контроля | Человека, который одобряет всё, что отправляется наружу |
| Есть ли запись того, что делала модель? | AISI: мониторинг на стороне провайдера нельзя универсально применить к публичным весам | Журналы, которые кто-то читает |
| Какие модели с открытыми весами мы уже используем? | CSA: составить опись | Список с владельцем, назначением и источником каждой |
| Нужно ли показать это консультанту? | Лицензия и персональные данные - юридические вопросы | Короткое заключение юридического консультанта или консультанта по защите данных |
Частые вопросы
Что такое аблитерация?
Аблитерация - это приём, который убирает у модели отказы правкой её опубликованных весов, как описано в начале статьи. Anthropic использует это слово для «стандартной техники снижения отказов» и ссылается на работу Ардити с соавторами 2024 года.
Что такое аблитерированная модель?
Это копия модели с открытыми весами, у которой поведение отказа вырезано правкой. Anthropic сделала такую копию GLM-5.3 для тестов и сообщает, что другие разработчики опубликовали свои «в течение нескольких дней после выпуска модели».
Как работает аблитерация?
Работа 2024 года, на которую ссылается Anthropic, обнаружила, что в 13 протестированных открытых чат-моделях отказ определяется одним направлением внутри модели. Если убрать это направление, отказы прекращаются, а остальные способности остаются в основном прежними.
Аблитерация - то же самое, что джейлбрейк?
Джейлбрейк в обычном смысле - это запрос, который убеждает модель выполнить просьбу, и он работает снаружи. Аблитерация меняет файлы модели, а для этого нужна копия весов. Работа 2024 года называет свой метод «white-box jailbreak», так что термины пересекаются.
Можно ли аблитерировать Claude?
Anthropic говорит, что нельзя, потому что веса Claude пользователям не передаются. По той же логике модель, веса которой не опубликованы, так отредактировать нельзя, если только веса не утекут (это мой вывод). CSA называет выкрадывание весов (exfiltration, то есть копирование без разрешения) риском для собственных копий компаний, а тестов других закрытых моделей я не нашёл.
Снижает ли аблитерация способности модели?
Anthropic сообщает об одинаковом результате на GPQA-Diamond и о результате на несколько процентов ниже на подмножестве CyberGym. Работа 2024 года сообщает о минимальном влиянии на другие способности.
Сколько стоит аблитерация?
Anthropic сообщает о примерно 2 200 GPU-часах и около 4 400 долларов за первую попытку на GLM-5.3 и оценивает около 1 200 долларов для опытной команды. CSA и The Decoder повторяют эти цифры, а независимой проверки нет.
Стоит ли бизнесу избегать моделей с открытыми весами?
Исходя из этих источников, я бы не стал, поскольку AISI называет реальные преимущества, такие как частный хостинг и основа, которую провайдер не может отозвать. Источники подсказывают относиться к весам как к активу и строить средства контроля безопасности вокруг модели.
Мой вывод
История с аблитерацией сводится к принципу: когда файлы публичны, отказы разработчика остаются настройкой по умолчанию, которую другие могут изменить. Работа 2024 года проверила это на других, меньших моделях, а AISI и CAISI формулируют то же самое в общих словах.
Масштаб эффекта для GLM-5.3 опирается на один отчёт Anthropic. CSA и The Decoder пересказывают его, независимой проверки нет, поэтому, пока CAISI или AISI не опубликуют воспроизведение, я читаю эти цифры как измерение одной компании.
Для моей работы это меняет порядок вопросов. Раньше я спрашивал, отказывает ли модель на вредные запросы, а теперь спрашиваю, до чего модель может дотянуться и кто одобряет её действия, потому что эти ответы верны при любой доле отказов.