Свой LLM на сервере: что не учитывает экономия Revolut в 90%
Свой LLM на сервере: Revolut утверждает, что модели GLM сократили счёт на ИИ-программирование в 10 раз. Что входит в цифру, что нет и о чём спросить заранее.
Свой LLM на сервере - это большая языковая модель, которую компания запускает на компьютерах, купленных или арендованных ею самой, вместо запросов в облачный сервис поставщика; расходы при этом переходят от платы за токен, небольшую единицу текста, к оборудованию и людям, которые его обслуживают.
В начале ноября 2026 года заголовки сообщали, что Revolut, цифровой банк из Европы, сократил расходы на программирование с ИИ на 90 процентов, то есть в десять раз, запустив модели GLM от Z.ai на выделенных GPU (графических процессорах, чипах, на которых работают ИИ-модели). Запуск модели для ответов на запросы называется инференсом (inference). Цифры взяты из доклада, который представил на конференции AI Engineer в Нью-Йорке David Abitbol, руководитель Revolut по операциям и инфраструктуре.
Я работаю в маркетинге и пользуюсь ИИ-моделями каждый рабочий день, в основном локальными моделями, обученными под мои задачи. Поэтому я читаю эту историю как пользователь ИИ-инструментов и не претендую на инженерную экспертизу. Прежде чем такая цифра попадёт на бюджетную встречу, я хочу знать, что внутри неё.
Эта статья разбирает заявление по частям и заканчивается вопросами, которые стоит задать, прежде чем размещать модель у себя.
Она о затратах и контроле: юридических советов здесь нет, а геополитику я оставляю за рамками. Прайс-листы и три способа запустить модель GLM описаны в моей статье о китайских нейросетях для бизнеса.
Главное коротко
- Ни один источник не называет цену собственного хостинга, которую можно перенести на другой случай. Лучше всего задокументирован случай Revolut, и на странице конференции сказано, что его цифры «описывают развёртывание и использование Revolut, а не универсальную цену для любой модели на собственных серверах».
- 90% - это сравнение двух счетов за нагрузку одной компании. Revolut говорит, что его расходы составляют около десятой части прежнего счёта от Anthropic и OpenAI, а это более узкое утверждение, чем падение на 90% всего, что ИИ стоит компании.
- Расходов вокруг GPU в заголовке нет. Red Hot Cyber пишет, что экономия не включает расходы на облако, персонал и мониторинг. Ни цифр по ним, ни упоминания этого исключения я не нашёл ни в докладе, ни в The Register.
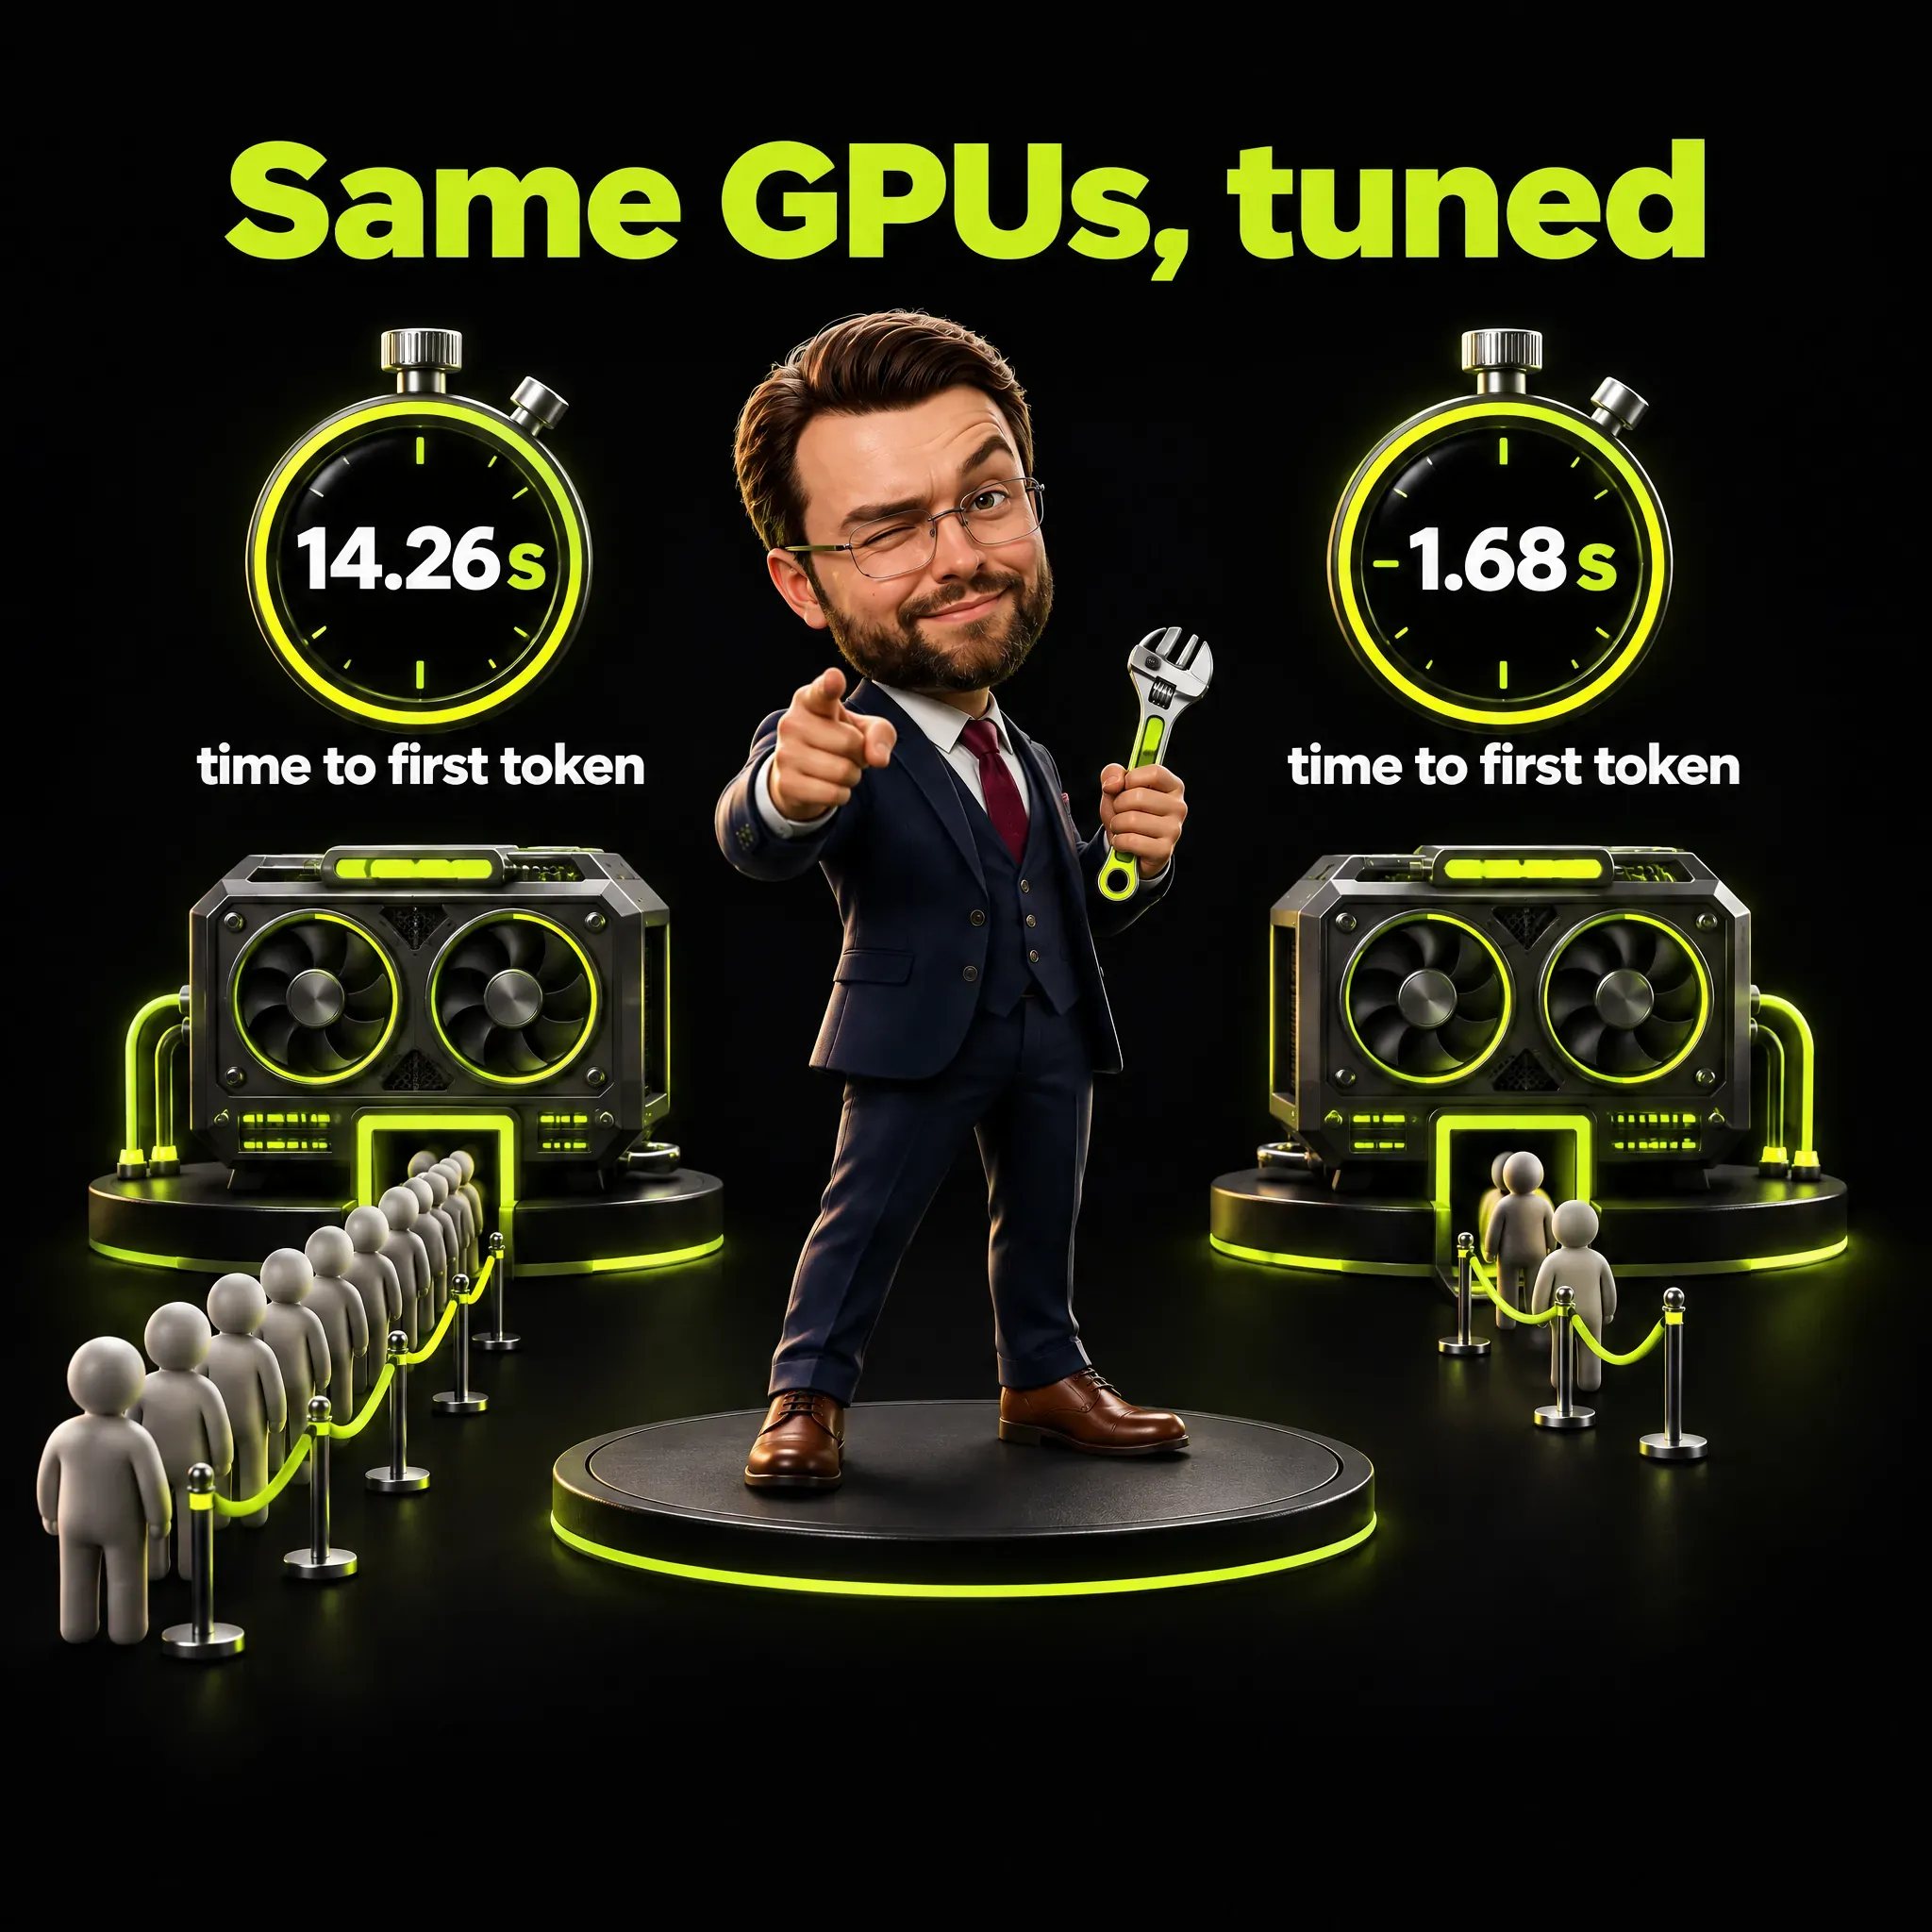
- На мой взгляд, цена токена зависит от того, насколько загружены машины. На тех же 56 GPU Revolut после настройки сообщает о росте числа запросов в секунду на 76% и о сокращении ожидания первого слова ответа на 88%.
- Собственный хостинг добавляет контроль, который кто-то должен вести. Revolut сочетает более дешёвый инференс с песочницей, правилами подтверждения и подробными журналами, а страница конференции говорит, что банк при самостоятельном хостинге отвечает и за сниженные расходы на инференс, и за правила песочницы, и за телеметрию.
- Маркетинговой команде я советую начать с модели, которую размещает поставщик. Ни один источник это не проверял, а вопросы в конце статьи - то, как я бы это проверил.
Что сообщил Revolut и кто что говорит
Всё, что ниже, восходит к трём видам источников. Первый - сам доклад, который я читал через письменное резюме конференции AI Engineer (ниже - страница конференции) и через его расшифровку. Второй - журналистика, пересказавшая доклад, в основном The Register и Red Hot Cyber.
Третий - моя собственная арифметика на их цифрах. Я разделяю все три вида, потому что каждый пересказ немного менял утверждение, а доклад - это рассказ компании о собственной конфигурации.
Сначала четыре термина, они понадобятся в таблице:
- Токен: небольшая единица текста, которую модель читает и пишет, часто короткое слово или часть длинного.
- Смешанная стоимость (blended cost): одна усреднённая цена на всё, что входит в модель и выходит из неё.
- Первый токен (first token): первый фрагмент ответа, который появляется на экране.
- Время на код и lead time: часы, которые инженер тратит на написание кода, и дни от взятия функции в работу до готовности к развёртыванию.
| Показатель | Значение | Источник |
|---|---|---|
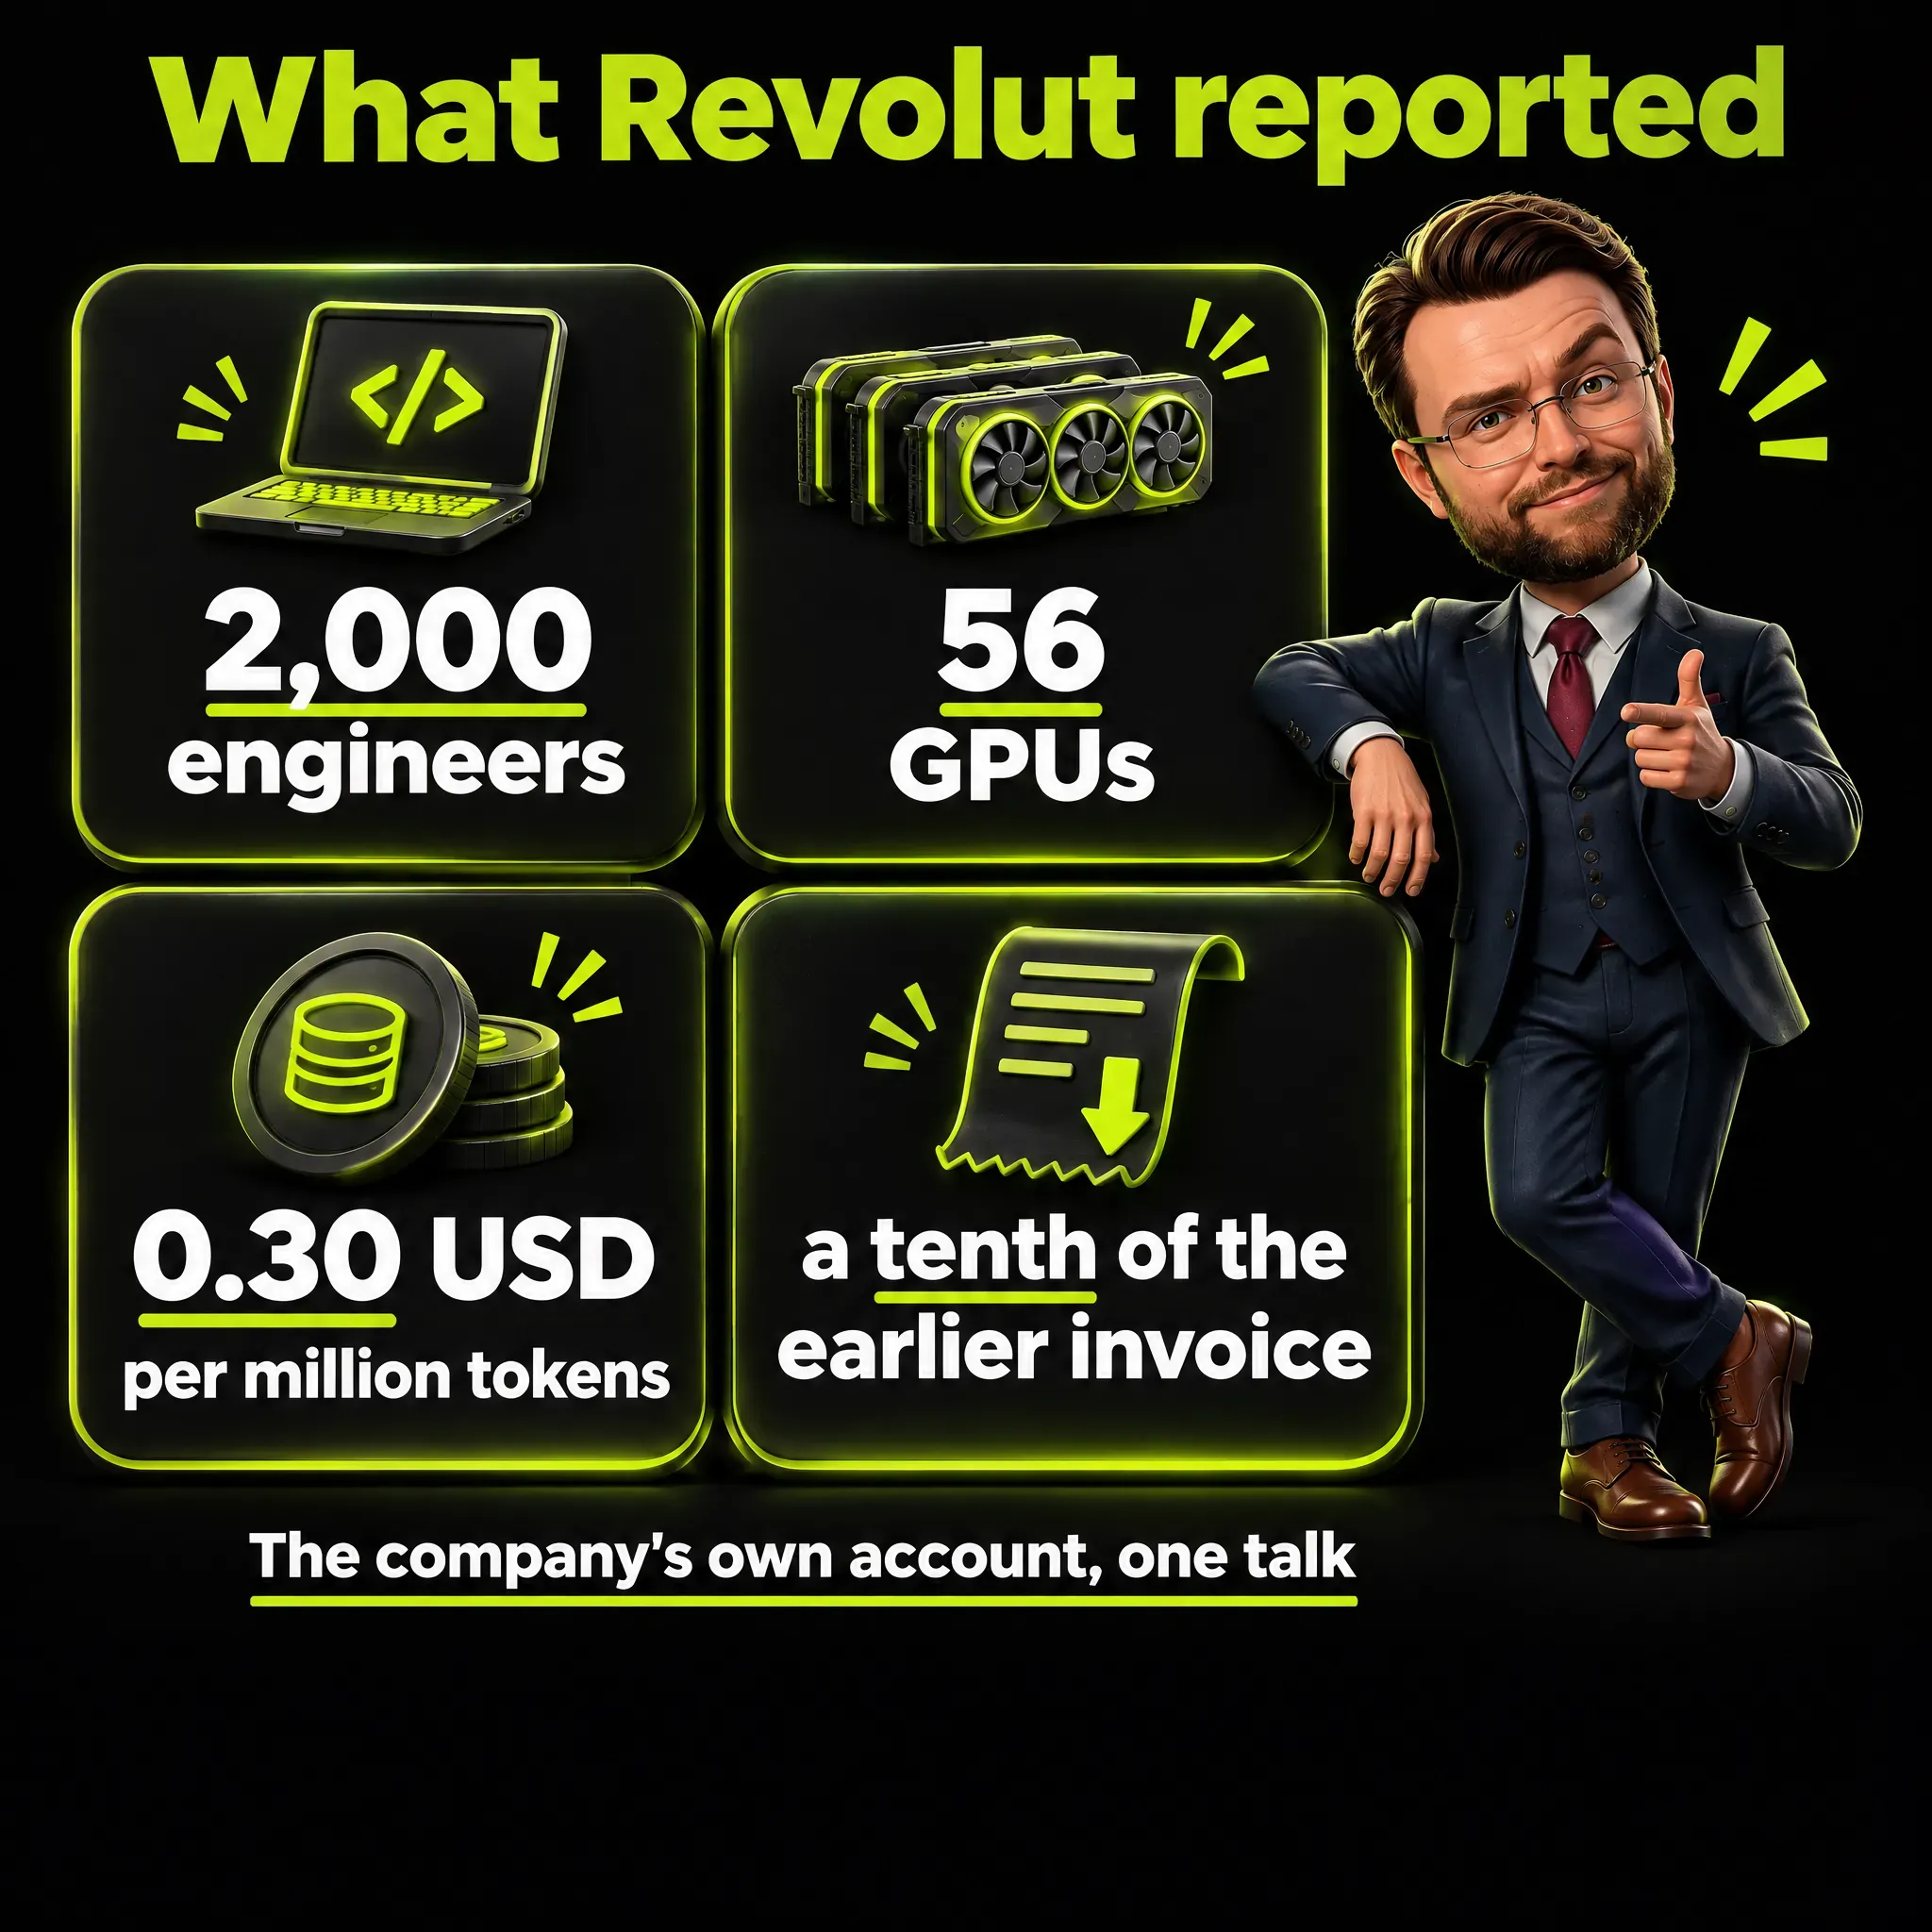
| Пользователи | Около 2 000 инженеров | Доклад |
| Оборудование | 56 GPU Nvidia B200, обслуживающих GLM-5.3 | Доклад, The Register |
| Стоимость токена | Смешанная стоимость около 0,30 доллара за миллион токенов | Доклад (страница конференции) |
| Расходы | Около десятой части прежнего счёта от Anthropic и OpenAI | Доклад (страница конференции) |
| Эффект для работы | Примерно на 60% лучше время на код, на 70% лучше lead time | Доклад, с оговоркой |
| Ожидание ответа | Первый токен через 14,26 секунды, затем через 1,68 секунды на тех же GPU | Слайд, описанный на странице конференции |
| Цели | Первый токен быстрее 3 секунд, около 200 токенов в секунду | Доклад |
Для улучшений на 60% и 70% нужна оговорка, которую страница конференции формулирует сама: «Внутреннее сравнение не отделяет смену модели от других причин». Значит, график показывает, что происходило в Revolut за месяцы внедрения, а не то, что сделала одна модель. Red Hot Cyber называет один из прочих факторов: отмену лимитов на токены.
Доклад называет 0,30 доллара за миллион токенов для «GLM», не указывая версию, а The Register связывает эту цифру с прежней конфигурацией на GLM-5.1, поэтому я не стал бы привязывать число к одной модели. По словам Abitbol, у Revolut 80 миллионов клиентов, но эта нагрузка - около 2 000 инженеров.
Три утверждения, одна цифра
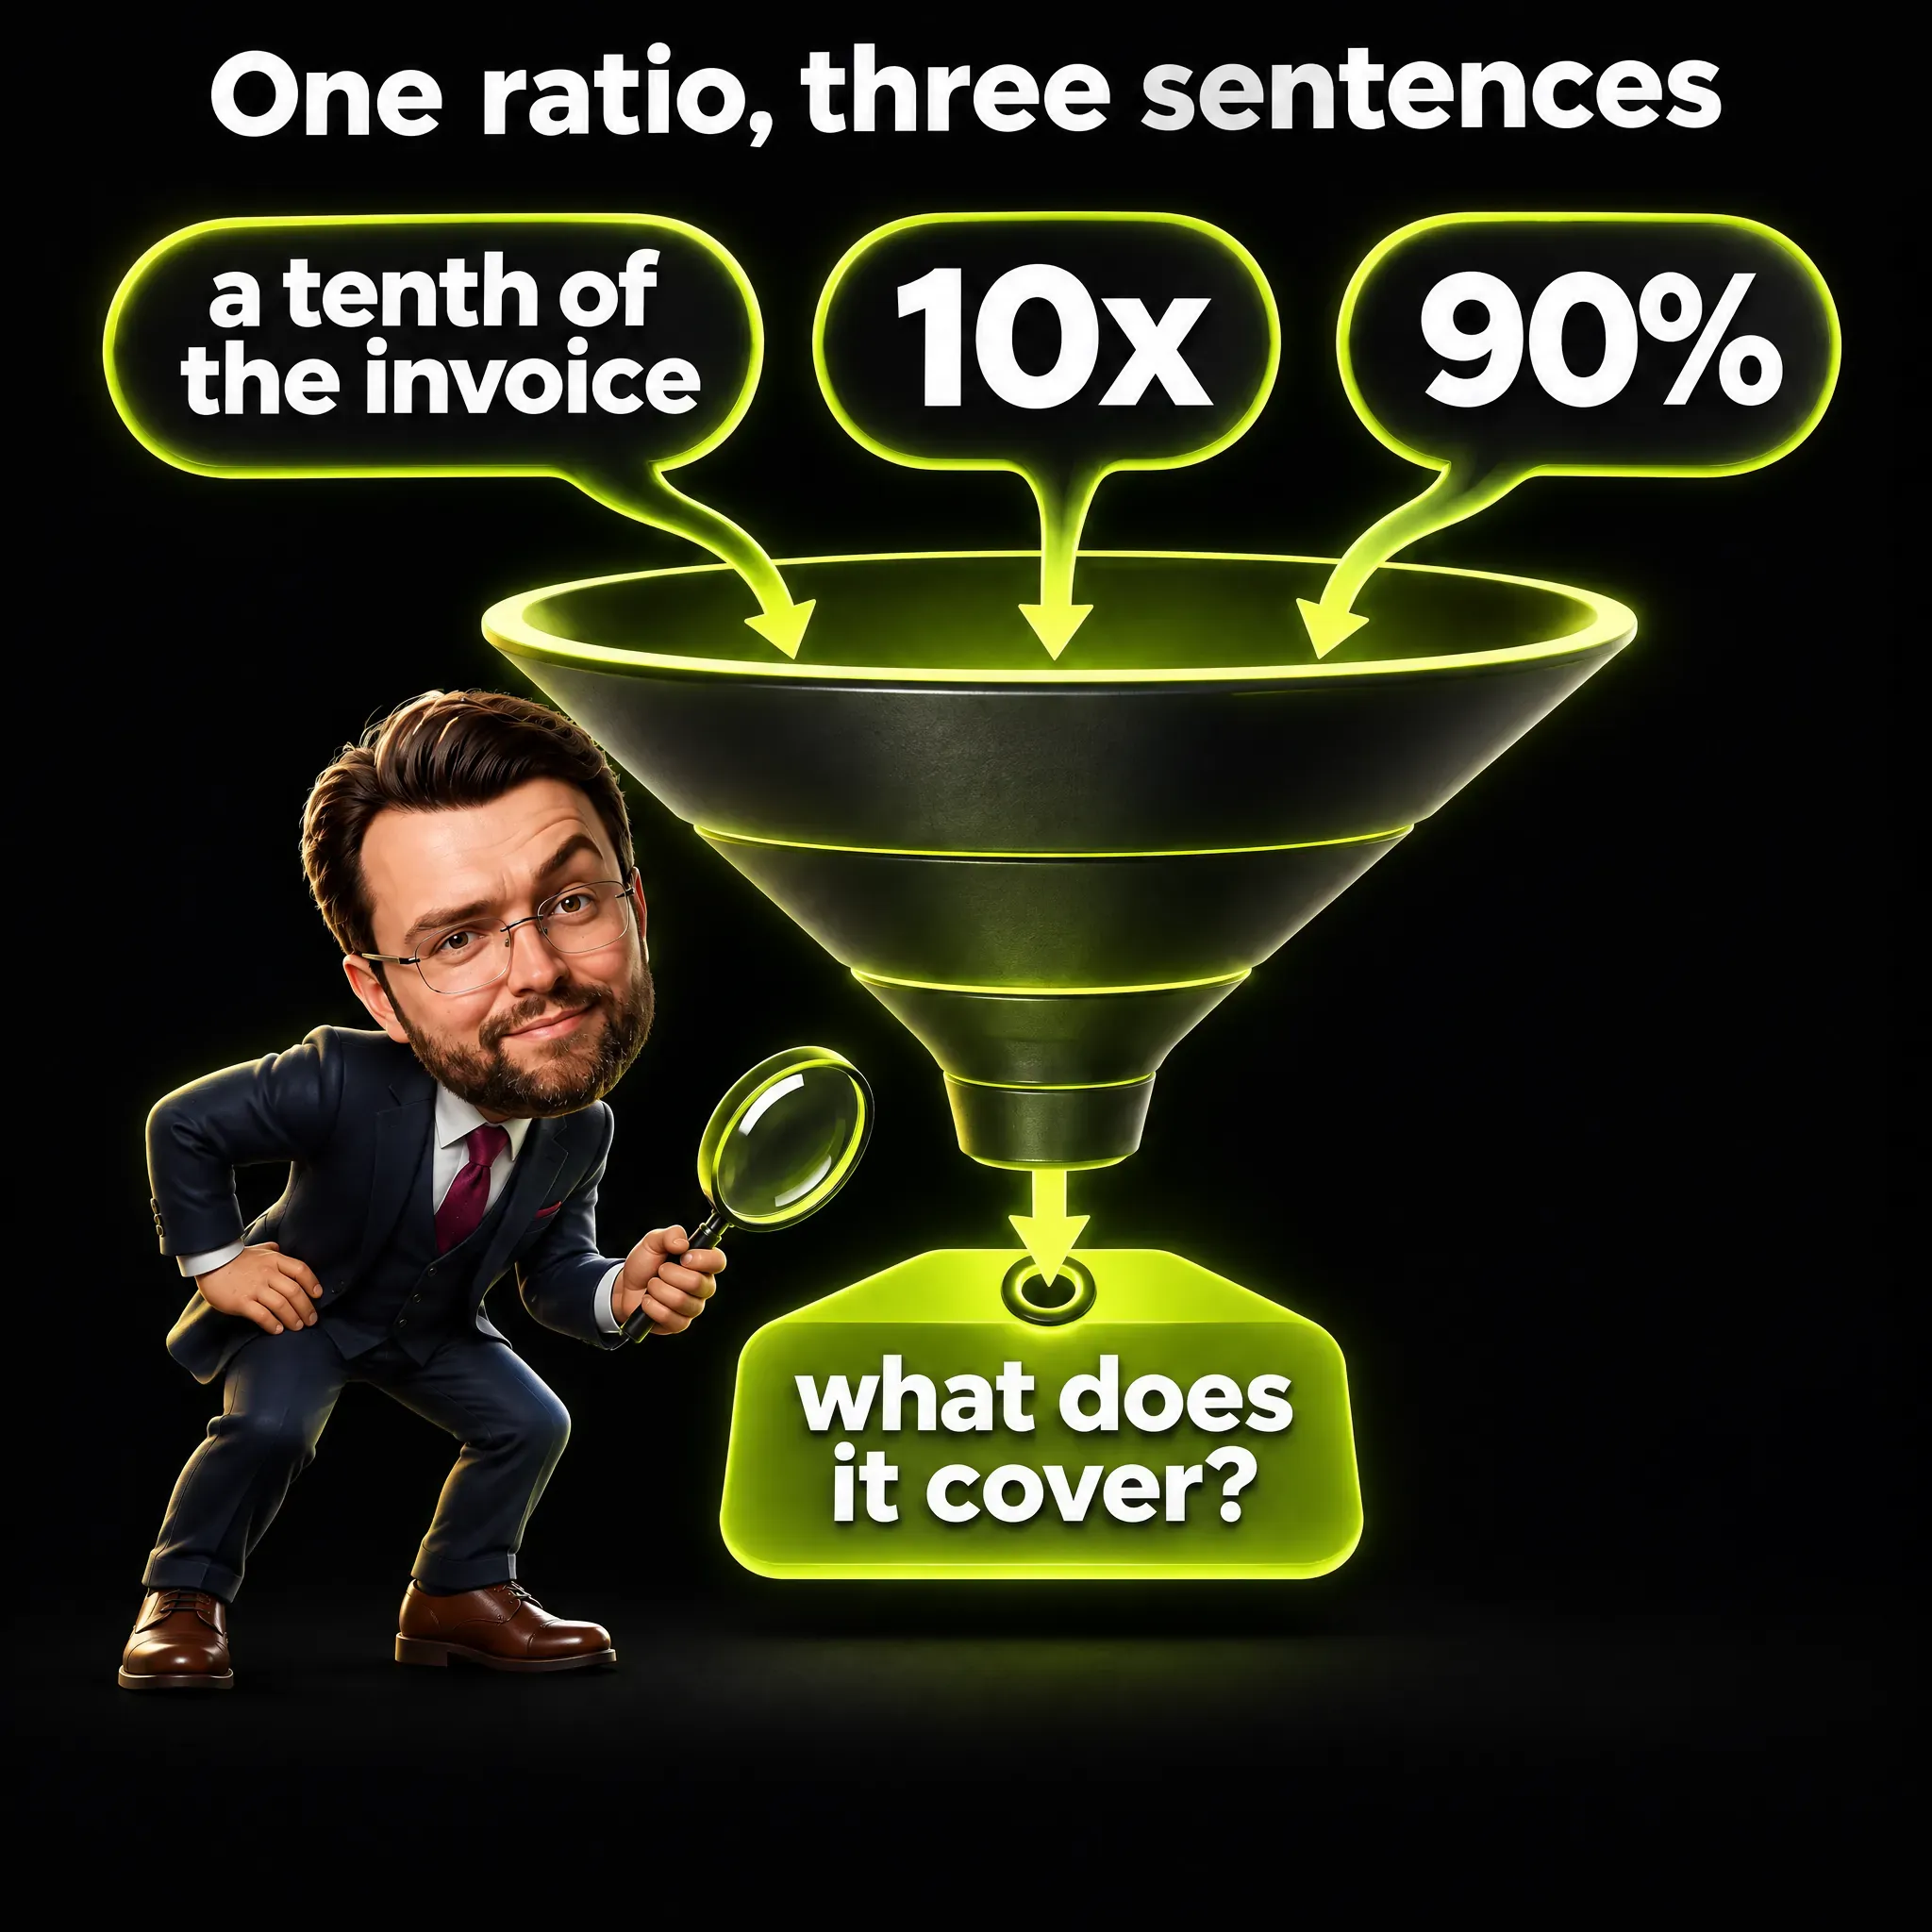
Из одной арифметики получились три разные формулировки, и повторять их с одинаковой уверенностью нельзя. «В десять раз дешевле» и «на 90 процентов меньше» - одно и то же соотношение, различается лишь то, что оно, по утверждению, охватывает.
Первое утверждение принадлежит самому Abitbol, как его резюмирует страница конференции: расходы Revolut составляют около десятой части прежнего счёта от Anthropic и OpenAI. Оно сравнивает то, что одна компания платила поставщикам, с тем, что она платит сейчас за один вид работы - программирование силами примерно 2 000 инженеров.
Abitbol также рассказывает, что при первом внедрении Claude Code некоторые инженеры тратили «тысячу в месяц, 10 000 в месяц без особого ROI» (то есть без заметной отдачи от вложений), по напечатанной в The Register цитате - в долларах, и поэтому компания запустила инструмент «со строгими бюджетными лимитами». Выходит, прежний счёт покрывал использование в строгом рационе, а нынешний - использование без оглядки на счётчик, и сравниваются два способа работы.
Второе - заголовок The Register, где сказано, что Revolut сократил расходы на программирование с ИИ в 10 раз «за счёт отказа от Claude и перехода на собственный хостинг». Текст местами осторожнее: там написано, что GLM «не заменил GPT или Claude полностью», и приведены слова Abitbol «передовые модели - исключение». Передовые модели (frontier) здесь - самые мощные модели крупных поставщиков, и страница конференции согласна, что такие сервисы остаются доступными для исключений.
Текст статьи тоже формулирует соотношение иначе, чем доклад. Там сказано, что при 0,30 доллара за миллион входных и выходных токенов собственный хостинг GLM-5.1 стоил примерно в десять раз меньше, чем использование Codex или Claude Code - агентов для программирования от OpenAI и Anthropic. Моё прочтение: здесь цена токена сопоставлена с продуктом, а это не то же самое, что сравнение двух счетов.
Третье - у Red Hot Cyber: издание вынесло в заголовок 90%, а затем оговорило эту цифру. Там написано: «Экономия в 90% не включает расходы на облако, персонал и мониторинг и зависит от тщательной оптимизации». Дальше сказано, что небольшие компании, «не обладающие масштабом и инфраструктурной командой Revolut», могут не добиться такого же результата.
Откуда цифра: из сравнения прежнего счёта Revolut с нынешними расходами, представленного в докладе. Что это значит: для этой нагрузки, при таком объёме и после такой настройки счёт за программирование с ИИ составляет около десятой части прежнего. Что меняется: цифра показывает, насколько уменьшился один счёт, но не показывает, насколько уменьшилась полная стоимость всей работы.
Разбивки расходов на облако, персонал и мониторинг я не нашёл ни на странице конференции, ни в расшифровке, ни в The Register. Red Hot Cyber тоже называет это исключение без цифр, а формулировки самого доклада, «наш счёт» и «там можно получить свои GPU», оставляют открытым вопрос, входит ли в эту десятую часть счёт за арендованные GPU. Исключение я рассматриваю как утверждение Red Hot Cyber и как предел самой цифры.
Почему цену токена нельзя сравнивать, не зная состава трафика
Прайс-листы Z.ai показывают, почему усреднённой цифре нужен её состав. Вход GLM-5.3 стоит 1,40 доллара за миллион токенов, кэшированный вход - 0,26, а выход - 4,40. Кэшированный вход - это текст, который система уже обработала и тарифицирует по сниженной ставке.
Агенты для программирования на каждом шаге заново отправляют много одного и того же текста, поэтому в их трафике преобладает кэшированный вход. На странице Coding Plan у Z.ai, то есть в подписке для инструментов программирования, заложена доля попаданий в кэш 95%: из каждых 100 входных токенов 95 - уже обработанный текст. Вот арифметика на этих двух источниках: 0,95 × 0,26 + 0,05 × 1,40 даёт около 0,32 доллара за миллион входных токенов по прайс-листу.
Это близко к смешанным 0,30 у Revolut, и вывода из этого я не делаю. Источники не называют состав входа, кэшированного входа и выхода у Revolut, а выходные токены в прайс-листе Z.ai стоят 4,40. Abitbol при этом говорит слушателям проверить, что попадание в кэш для нагрузки программирования «должно быть выше 90%», а смешанные 0,30 могут получиться из очень разных сочетаний.
Когда кто-то называет стоимость миллиона токенов для собственного хостинга, я бы задал три вопроса: включает ли она вход, выход или оба, какая доля входа пришла из кэша и считаются ли только GPU. Без ответов это число нельзя сопоставить с прайс-листом поставщика, и поэтому я читаю сравнение Revolut как сравнение двух счетов.
Полный прайс-лист - в моём руководстве по китайским нейросетям для бизнеса. Чтобы понять, где расходы на модели стоят среди остальных инструментов команды, я пользуюсь схемой из статьи о моём маркетинговом тех-стеке на 2026 год.
Почему цена токена зависит от загрузки машин
Доклад Abitbol посвящён «самостоятельному хостингу модели с открытым исходным кодом на выделенных GPU», то есть на машинах, закреплённых за самим Revolut. Как я это понимаю, зарезервированные машины стоят одинаково, ответят они на один запрос или на тысячу. Значит, цена токена - это фиксированный счёт, делённый на число токенов, которые машины обработали.
Придуманный пример с круглыми числами, не данные Revolut: допустим, машины стоят 100 условных единиц в месяц. Если они обрабатывают 100 миллионов токенов, каждый миллион стоит 1 единицу. Если настройка позволяет тем же машинам обработать 500 миллионов, каждый миллион стоит 0,2 единицы, а счёт не изменился.
Revolut не формулирует свою экономию так, но график настройки подходит под этот механизм. Abitbol предупреждает, что загрузка весов на GPU и запуск инференса, то есть шага, на котором модель отвечает на запросы, без такой настройки дают «ужасную производительность». Команда настраивала систему, которая обслуживает запросы к модели, под свой реальный спрос, а на графике число GPU остаётся неизменным с апреля по август.
Слайд, как его описывает страница конференции, показывает на 76% больше запросов в секунду и на 88% меньшее время до первого токена: с 14,26 секунды во время миграции до 1,68 секунды в стабильной конфигурации. Время до первого токена - это ожидание между отправкой запроса и появлением первого слова ответа. По моей арифметике, ожидание стало короче примерно в 8,5 раза.
Цели у Abitbol конкретные. Он стремится к «времени до первого токена меньше 3 секунд» и говорит: «как только вы превышаете 5 секунд, мой Slack начинает разрываться». Его совет - «сопротивляться масштабированию», то есть сначала настроить имеющиеся GPU и только потом покупать новые.
Abitbol говорит, что инженеры, подключающиеся после пяти вечера, могут получать 800 токенов в секунду, тогда как страница конференции называет достаточными для интерактивной работы 200. На мой взгляд, вечером спрос ниже, поэтому те же машины отвечают быстрее, а простаивающие вечерние мощности оплачены в любом случае. Для команды из нескольких пользователей тот же фиксированный счёт делится на намного меньшее число токенов.
Что нужно, чтобы запустить такую модель, простыми словами
Модели класса GLM требуют оборудования уровня дата-центра. The Register сообщает, что у GLM-5.1 примерно 754 миллиарда параметров, из которых 40 миллиардов активируются для каждого генерируемого токена, и что для хранения её весов нужно около 380 ГБ памяти GPU. Параметры - это числа, которые модель усвоила при обучении, а веса - файлы, в которых они хранятся.
Поверх этого память занимает открытый разговор каждого пользователя. The Register оценивает его ещё в 6-26 ГБ на пользователя в зависимости от точности хранения чисел. На странице GLM-5.3 в Hugging Face, публичной библиотеке, где публикуют такие модели, указаны 753 миллиарда параметров, и эту цифру я использую для нынешней модели.
Вот решения, которые описывают доклад и The Register, в порядке, понятном не инженеру:
- Размер контекста. Контекстное окно - это объём текста, который модель держит в поле зрения одновременно, и оно конкурирует с запросами других пользователей за память GPU. Abitbol говорит: «длинный контекст - афёра»: модель может обслуживать миллион токенов, но его инженерам нужно 256 000.
- Более компактное хранение весов. Квантизация (quantization) - это хранение чисел с меньшим количеством разрядов ради экономии памяти, и Revolut на своих GPU B200, нынешнем чипе Nvidia для дата-центров, предпочитает 4-битный формат.
- Распределение модели по GPU. Страница конференции отмечает, что размещение весов на четырёх GPU может оставить слишком мало памяти для кэша уже обработанного текста, поэтому распределение на восемь GPU может работать лучше.
- Передача части задач в другое место. Модель GLM, которую Revolut использует для программирования, работает только с текстом, поэтому Revolut применяет маршрутизатор (router), который отправляет запросы с изображениями в Gemini или GPT Luna, а генерация кода остаётся на GLM.
Цена токена скрывает эти решения о памяти, скорости и маршрутизации. В стоимость собственной модели входит умение принимать их, а Revolut продолжал платить поставщикам за задачи, которые модель не умеет решать.
Расходы, которые никто не опубликовал
Вот каждая строка расходов, которую я хотел бы видеть заполненной, прежде чем сравнивать собственный хостинг с ценой поставщика. «Нет данных» означает, что ни в одном прочитанном мной источнике я не нашёл цифры, и пробел я не заполнял оценкой.
| Статья расходов | Что говорят источники | Цифра |
|---|---|---|
| GPU, купленные или арендованные | 56 GPU B200 обслуживают GLM-5.3 | Нет данных |
| Облако | Red Hot Cyber пишет, что 90% не включают расходы на облако | Нет данных |
| Люди, которые это эксплуатируют | Red Hot Cyber пишет, что 90% не включают персонал; у небольших компаний может не быть инфраструктурной команды | Нет данных |
| Мониторинг и журналы | Red Hot Cyber пишет, что 90% не включают мониторинг; Abitbol требует подробной телеметрии для расследования инцидентов | Нет данных |
| Время на настройку | График охватывает период с апреля по август на тех же GPU | Часы не указаны |
| Поставщики, оставленные для исключений | Передовые сервисы остаются доступными; запросы с изображениями идут в Gemini или GPT Luna | Нет данных |
| Переход с одной модели на следующую | Revolut перешёл с GLM-5.1 на GLM-5.3 | Нет данных |
Один вопрос остаётся открытым. Red Hot Cyber описывает машины как собственную инфраструктуру Revolut в США, а Abitbol говорит «там можно получить свои GPU» в перечисленных им странах и упоминает провайдеров GPU, которые по умолчанию не хранят копию данных, что он называет «нулевым хранением данных» (zero data retention). Из источников я не могу понять, куплены GPU или арендованы, а от ответа зависит форма счёта.
Мой совет - использовать таблицу как форму. Когда вам называют экономию в 90%, попросите заполнить каждую строку для их собственного случая или сказать, какие строки цифра не учитывает. Экономию, которая выдержит такое упражнение, я бы внёс в бюджет.
Расходы, которые появляются уже после счёта, - это время человека, проверяющего результат. Уровни Claude я сравниваю в статье модели Claude для маркетинга. Метод оттуда, слепая проверка 20 реальных образцов, так же работает и для модели GLM, которую размещает поставщик.
Как дешёвые токены меняют работу людей
Для меня самая полезная часть доклада - о поведении. Страница конференции описывает, что происходило при лимитах на токены: когда токены кажутся дефицитом, инженеры берегут их для трудной задачи по программированию и не используют на остальной работе вокруг неё. Ответом Revolut стала фиксированная стоимость, которая позволила инженерам делегировать больше.
По собственной трактовке Abitbol, в задержки разработки входят почта, Jira и Confluence - инструменты для отслеживания проектов и ведения документации вокруг кода. Более дешёвый доступ, по его словам, расширил круг задач, которые люди были готовы передать модели. The Register цитирует его об отладке и работе с тикетами: «Когда у вас неограниченные токены, вы вольны это делать».
Из-за этого цифры 60% и 70% трудно читать. Часть улучшения может давать модель, часть - инженеры, которые стали использовать ИИ для большего числа видов работы, а страница конференции говорит, что сравнение их не разделяет. Я не стал бы приписывать улучшение ни одной только модели, ни одному только собственному хостингу.
Для своей области я могу предложить только сценарий, и он придуманный. Представьте маркетинговую команду, которая ограничивает ИИ-агента, потому что каждое длинное задание стоит реальных денег, и поэтому использует агента для ежемесячного отчёта, а ежедневную разметку и проверки делает вручную. Если бы счёт был фиксированным, та же команда могла бы передать и эти мелкие задачи.
Ни один источник не измеряет это для маркетинга. Кто-то всё равно платит за машины, а выигрыш появляется, только если дополнительная работа агента достаточно хороша, чтобы её оставить после проверки человеком.
Куда уходят данные и чего доклад не решает
Страница конференции делает простое замечание: скачать веса и запустить их на инфраструктуре, которую выбирает компания, - это другой путь данных, чем отправка запросов в размещённый сервис разработчика модели.
Abitbol говорит, что опасения о приватности китайских моделей относятся к обращению к выделенной конечной точке в Китае, а когда веса берут и ставят «на сервис в США», случай другой. The Register резюмирует его позицию так: собственные машины компании, то есть её серверы on-premises, или облачный провайдер в том же регионе оставляют мало поводов для беспокойства. Это формулировка журналиста, а не цитата Abitbol.
Он добавляет, что хранение данных в странах из «рамки эквивалентности данных» (так расшифровка передаёт data equivalency framework), куда он включает США, ЕС, Великобританию и Израиль, допустимо, а у провайдеров инференса и GPU будет «нулевое хранение данных по умолчанию». Ни один из прочитанных мной источников не проверяет это утверждение о провайдерах. Это его слова о Revolut, банке, и страница конференции подчёркивает, что их «не следует понимать как общий вывод о том, что модель, регион или песочница автоматически удовлетворяют обязательствам другой организации».
Что касается собственного API разработчика (программного интерфейса, через который программы обращаются к модели), политика конфиденциальности Z.ai говорит, что её сервисы, как правило, предоставляются из Сингапура, а в дополнении к API есть положение о том, что содержимое не хранится. Оба утверждения исходят от самой Z.ai, и ни одно не проверено третьей стороной. Оба документа я разбираю в разделе о данных своей статьи о китайских нейросетях.
Я не юрист, и это не юридическая консультация. Если в любую модель попадут персональные данные, например списки клиентов или выгрузки лидов, я сначала задал бы консультанту по защите данных три вопроса: какая страна, по какому договору, с каким сроком хранения.
Контроль вокруг модели
Заключительная мысль Abitbol - о контроле вокруг модели. Revolut настраивает песочницу (sandbox), то есть огороженную область, в которой работает агент для программирования, вместе с правилами подтверждения для операций, которые компания не хочет разрешать. Его пример: «можно разрешить grep, но не gradle», то есть правило может позволить агенту искать по файлам и запретить ему запускать инструмент сборки.
Он говорит, что задачи по программированию не считаются автономными агентами, потому что «с ними всегда человек в контуре», то есть решения проверяет человек, и что песочница в этом вопросе успокаивает регулятора. Он также говорит, что песочница защищает от злоупотреблений со стороны сотрудников компании. Последнее требование - телеметрия, то есть подробные журналы, чтобы команда могла проследить инцидент по всей системе.
О prompt injection - атаке, при которой спрятанный в документе или на веб-странице текст пытается дать агенту новые приказы, - Abitbol говорит коротко: «Сейчас это не так уж важно, учитывая, насколько умны модели, но тема есть всегда». Это его мнение в докладе, и в этом месте он не ссылается ни на один тест.
Страница конференции перечисляет сниженные расходы на инференс, правила песочницы и телеметрию и заканчивается словами: «Самостоятельный хостинг оставляет Revolut ответственным за все три».
С открытыми весами, то есть файлами модели, которые разработчик публикует для скачивания любым желающим, связана ещё одна ответственность. Встроенные в такую модель отказы выполнять вредные запросы хранятся в этих файлах, и отчёт Anthropic о GLM-5.3 описывает их удаление техникой, которую я объясняю в статье о том, что такое аблитерация. Cloud Security Alliance, отраслевая группа по безопасности, повторяет цифры Anthropic и рекомендует считать веса модели чувствительными активами.
Маркетинговой команде, которая никогда не размещает модель у себя, песочница, правила подтверждения и журналы всё равно нужны, как только агент получает возможность действовать в её аккаунтах. Шаг подтверждения я описываю в статье о проверке ИИ человеком (human in the loop), а более широкие риски - в материале о безопасности ИИ-агентов.
Вопросы, которые стоит задать, прежде чем запускать свой LLM на сервере
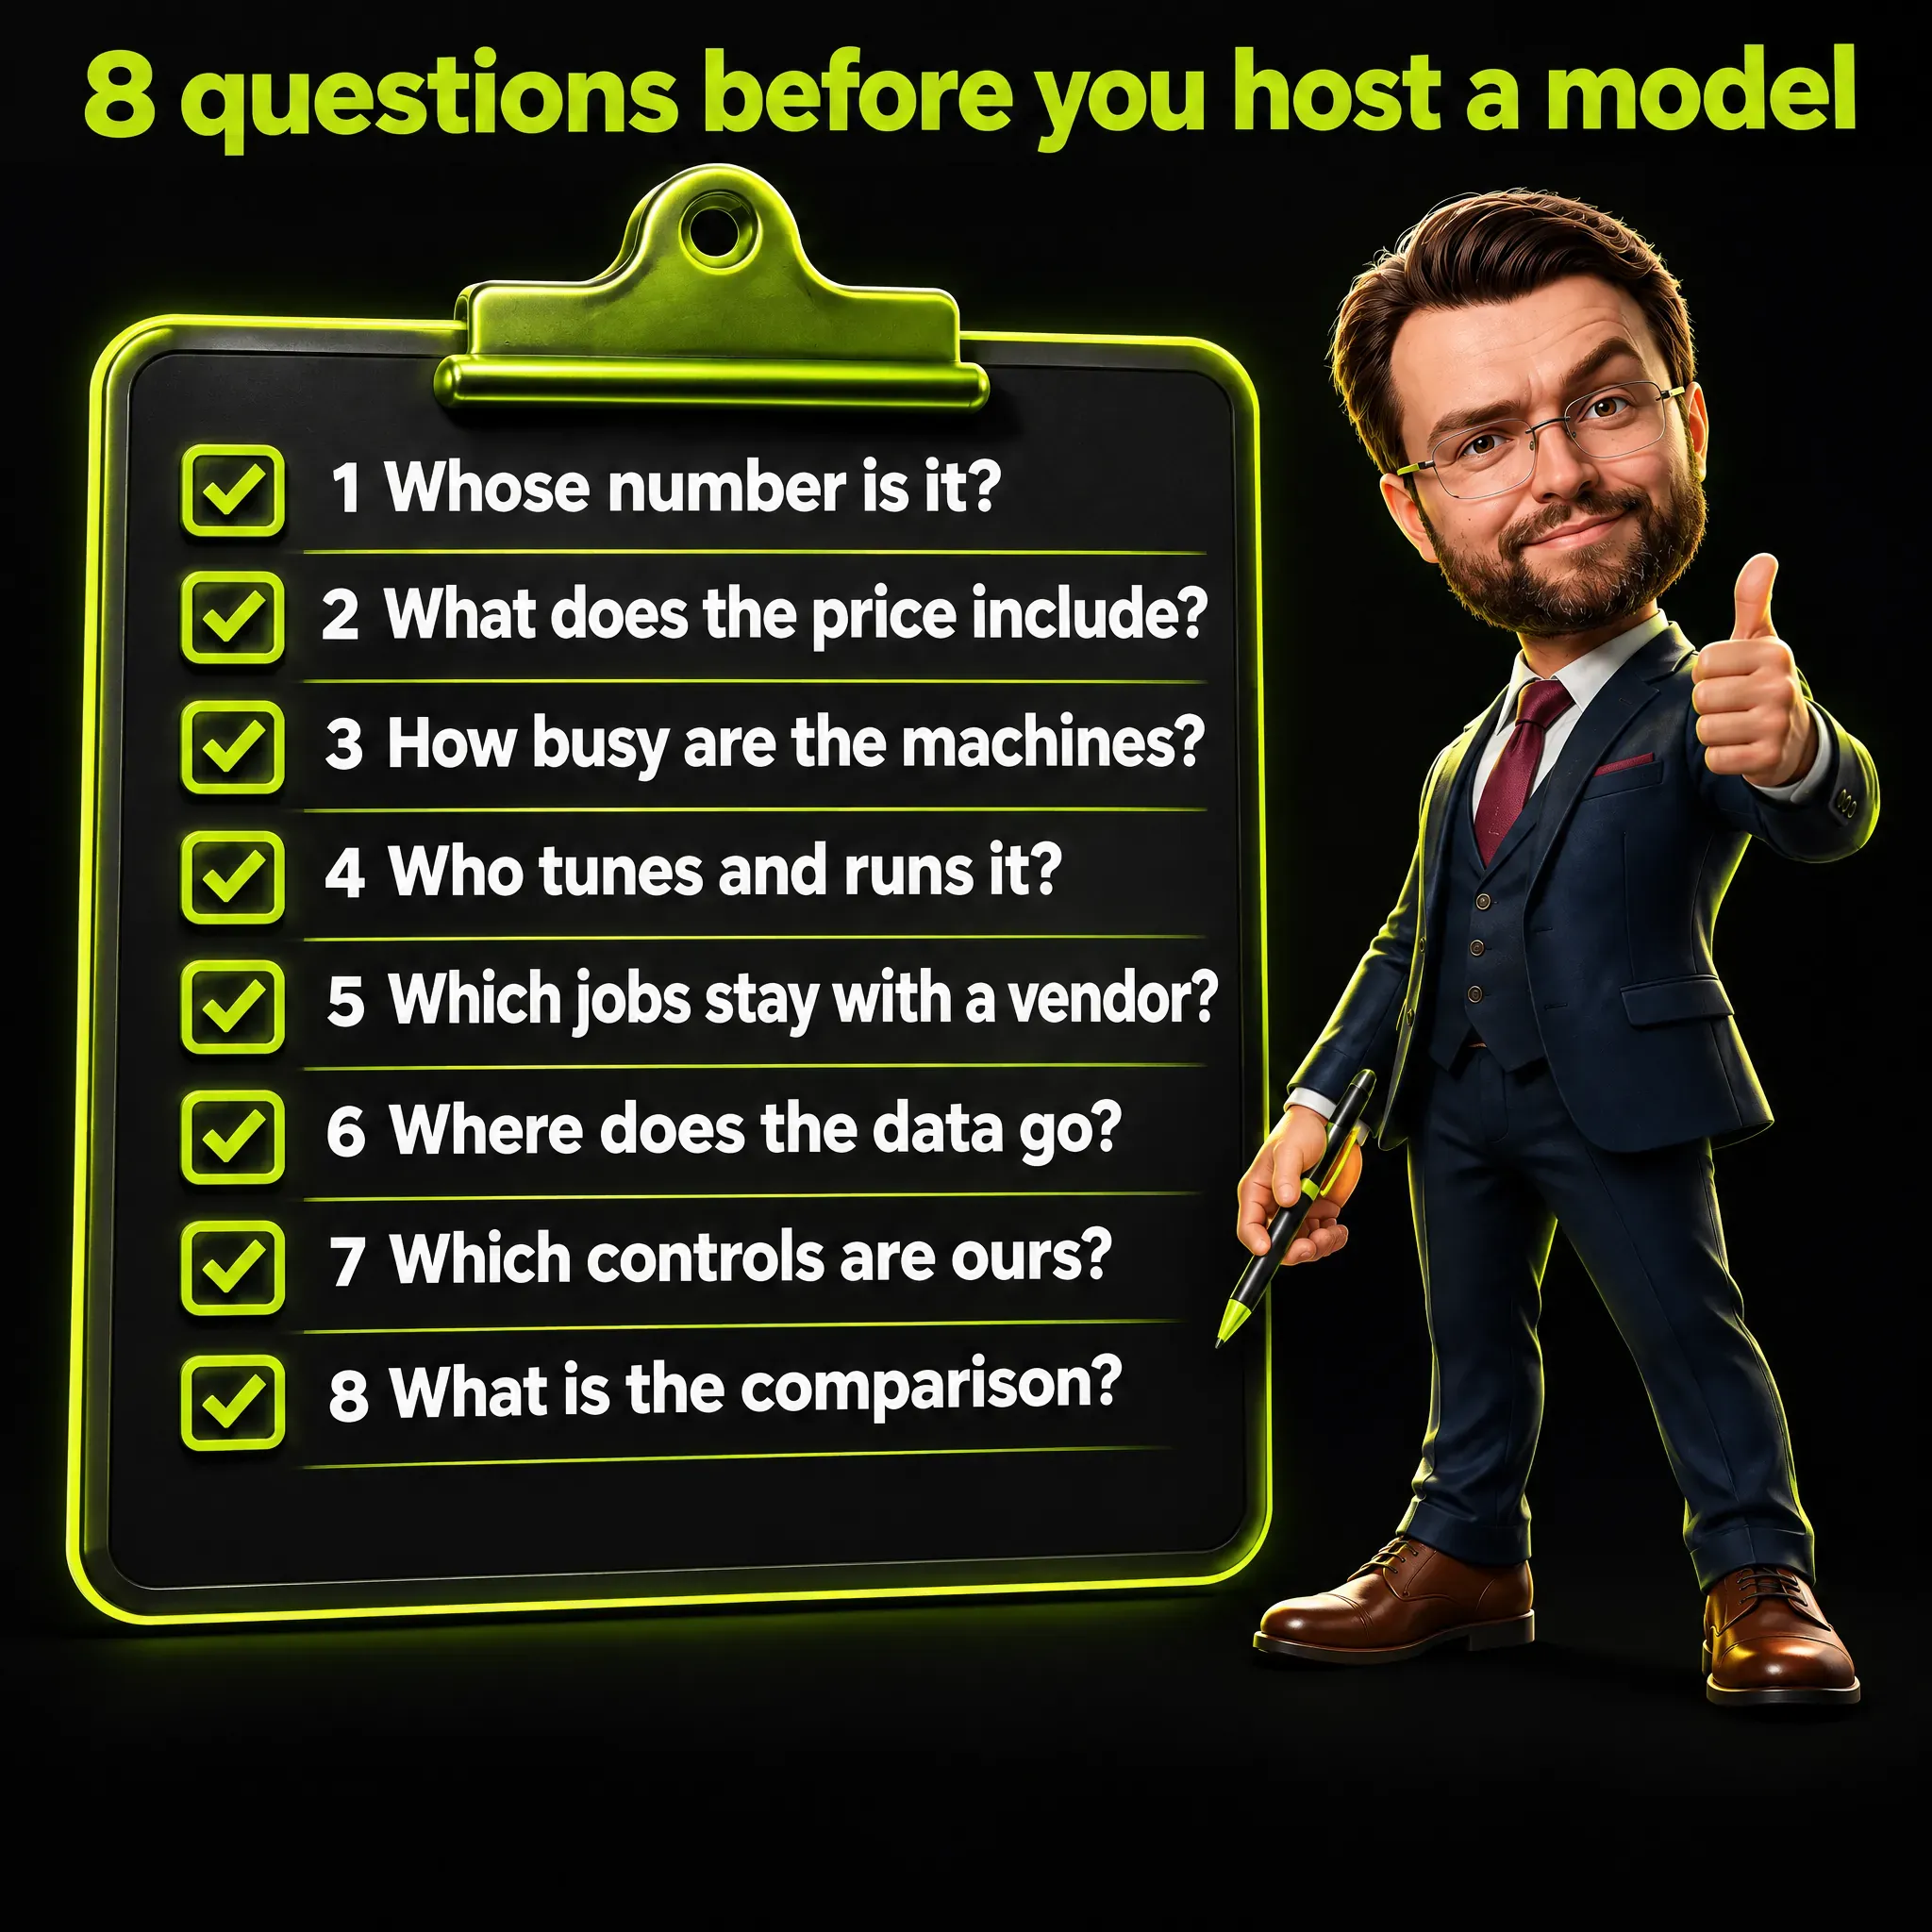
Я превратил разделы выше в восемь вопросов. Это мой собственный чек-лист, и он подходит, откуда бы ни исходило утверждение: из доклада на конференции или со слайда поставщика.
| Вопрос | Что я хотел бы увидеть |
|---|---|
| Чья это цифра? | Источник экономии, период и нагрузка, которую она охватывает |
| Что входит в стоимость токена? | Вход, выход или оба, доля попаданий в кэш и считаются ли только GPU |
| Насколько будут загружены машины? | Ожидаемое число пользователей и запросов, потому что цена токена падает по мере роста использования |
| Кто настраивает и эксплуатирует? | Названная команда и её часы, потому что график настройки Revolut охватывает период с апреля по август |
| Какие задачи остаются у поставщика? | Список задач, например запросов с изображениями, которым по-прежнему нужна другая модель |
| Куда уходят данные? | Страна, договор и срок хранения, вынесенные на обсуждение с консультантом по защите данных |
| Какие средства контроля наши? | Песочница, правила подтверждения, журналы и человек, отвечающий за веса |
| С чем сравниваем? | Модель, которую размещает поставщик, на той же задаче, оценённая вслепую на 20 реальных образцах |
Если ответы расплывчаты, я считаю экономию гипотезой. Если они конкретны, а объём большой, собственный хостинг становится серьёзным вариантом. Для небольшой команды мой вывод из цифр Revolut таков: препятствиями остаются фиксированный счёт и необходимость в инфраструктурной команде.
Частые вопросы
Что такое self-hosted LLM, или свой LLM на сервере?
Это большая языковая модель, которую компания запускает на машинах, купленных или арендованных ею самой, вместо обращения к размещённому сервису поставщика. Файлы модели должны быть доступны для скачивания, поэтому собственный хостинг обычно означает модель с открытыми весами, то есть такую, разработчик которой публикует эти файлы.
Сколько стоит запуск LLM на своём сервере?
Универсальной цены ни один прочитанный мной источник не называет. Revolut сообщает о смешанной стоимости около 0,30 доллара за миллион токенов и о расходах примерно в десятую часть прежнего счёта при 56 GPU B200 на около 2 000 инженеров. Расходы на облако, персонал и мониторинг не опубликованы.
Дешевле ли свой сервер, чем платить за API?
Для Revolut, по его собственному рассказу, да. В общем случае я сказать не могу, потому что ответ зависит от объёма, загрузки машин и стоимости людей, которые их обслуживают, а найденные мной источники описывают один случай.
Можно ли запустить LLM на собственном компьютере?
Модель такого класса - нет. У GLM-5.3 по данным её страницы в Hugging Face 753 миллиарда параметров, а The Register оценивает веса прежней GLM-5.1 примерно в 380 ГБ памяти GPU, что намного превышает возможности ноутбука.
В чём разница между open-weight и self-hosted?
Open-weight (открытые веса) значит, что разработчик публикует файлы модели. Self-hosted значит, что вы запускаете их на машинах, которые контролируете. Открытые веса может разместить для вас и третья сторона, и это второй вариант из моей статьи о китайских нейросетях.
Сохраняет ли собственный хостинг конфиденциальность данных?
Он меняет путь, по которому идут данные, и страница конференции называет это другим путём данных по сравнению с размещённым сервисом разработчика. Юридических вопросов он не решает, а защитные механизмы и журналы делает вашей собственной работой, поэтому вопрос о данных я отнёс бы консультанту по защите данных.
Нужна ли инфраструктурная команда?
Red Hot Cyber пишет, что небольшие компании без масштаба и инфраструктурной команды Revolut могут не добиться такого же результата. Насколько большой должна быть такая команда, в источниках не указано.
Нужен ли маркетинговой команде свой LLM на сервере?
Моё мнение, а не вывод исследования: сначала я бы взял модель, которую размещает поставщик, и прошёл по восьми вопросам выше. Такой путь оставляет счёт переменным, но избавляет от машин, настройки и средств контроля, которые к ним прилагаются.
Мой вывод
Из случая Revolut я беру метод чтения любой экономии. Экономия в 90% заслуживает тех же вопросов, что и любое утверждение на бюджетной встрече: чья это цифра, за какой период, что внутри и что осталось за скобками. На последний вопрос Red Hot Cyber отвечает облаком, людьми и мониторингом; в самом докладе исключения не перечислены, а этих расходов никто не опубликовал.
Изменение поведения я тоже воспринимаю всерьёз. Если счёт перестаёт нормировать использование ИИ, люди передают ему больше работы, и влияние на продуктивность может оказаться таким же большим, как влияние на счёт. Это относится и к фиксированной подписке, и к моделям, которые размещает поставщик, не меньше, чем к собственным GPU.
Я бы начал с модели поставщика, несколько месяцев измерял реальное использование и заполнил таблицу расходов выше собственными цифрами. Если объём и команда оправдывают собственные машины, то при запуске своего LLM на сервере планировать в первую очередь стоит настройку и средства контроля.