Server-Side-Tracking: Was sich ändert und was nicht
Server-Side-Tracking gibt Ihnen Kontrolle über Ihre Daten, aber keine verweigerte Einwilligung. Was es ändert, was es kostet und wie Sie es richtig testen.
Im Oktober meldete mir ein Test, das Server-Side-Tracking eines Kunden verliere jedes Ereignis, sobald ein Besucher Cookies akzeptiert hatte. Der Test war falsch.
Server-Side-Tracking heisst, dass die Messungen Ihrer Website über einen Server laufen, den Sie kontrollieren, bevor sie Google, Meta und Ihre anderen Werbe-Tools erreichen. Ohne es schickt der Browser jedes Besuchers sie direkt an jedes einzelne Tool.
Dieser Artikel richtet sich an die Person, die entscheidet und bezahlt, nicht an die Person, die konfiguriert. Er behandelt, was der Server ändert, was er unberührt lässt (vor allem die Einwilligung), was er kostet, wann ich ihn empfehle und wie man ihn testet, ohne die Daten zu verfälschen. Der Abschnitt zum Testen enthält einen kurzen technischen Teil für alle, die ihn konfigurieren.
Preise und Zitate stammen von offiziellen Seiten, die ich am 4. November 2026 gelesen habe, oder aus meiner eigenen Kundenarbeit. Wo eine Zahl meine Schätzung ist, sage ich es; Zitate aus englischsprachigen Quellen habe ich selbst übersetzt.
Das Wichtigste vorab
- Server-Side-Tracking ist eine Sortierstelle. Ihre Website schickt Messungen an einen Server auf Ihrer Domain, und der Server entscheidet, was an welches Tool geht.
- Es bringt Kontrolle, keine Einwilligung. Ein Besucher, der Nein gesagt hat, bleibt ein Nein, und der Server respektiert diese Entscheidung nur, wenn er dafür eingerichtet ist.
- Es arbeitet neben dem Tag im Browser. Klicks, Scrollen und Formulare werden weiterhin im Browser erfasst.
- Die Rechnung ist fix und wiederkehrend. Die Seiten von Google selbst widersprechen sich, wie viele Server Sie brauchen, 2 oder 3; fragen Sie also nach der Anzahl der Server, der Region und den Protokollen.
- Für eine kleine Website ohne Werbung lohnt es sich selten. Meine Regel: Erwägen Sie es nur, wenn alle Bedingungen erfüllt sind, allen voran ein gemessener technischer Verlust.
- Beweisen Sie es mit einem Signal, das am Ziel ankommt. «Ich sehe nichts im Protokoll» heisst nicht «es wurde nichts gesendet».
Der Test, der «keine Ereignisse» meldete und falsch lag
Ich testete den Server-Side-Aufbau auf der Website eines Kunden. Nachdem der Besucher auf «Alle akzeptieren» geklickt hatte, zeigten meine Prüfungen auf Seitenebene, dass die Ereignis-Tags nichts sendeten. Der Bericht lautete: keine Ereignisse.
Ich schloss daraus, dass der Aufbau Ereignisse verlor. In einer Liste harter Kriterien, die ich vorher aufgeschrieben hatte, stand, dass eine durchgefallene Version nicht online bleiben darf, also nahm ich die Version zurück, die ich etwa eine Stunde zuvor veröffentlicht hatte.
Der Schluss war falsch: Nach der Einwilligung sendete ein Service Worker die Messungen an den Server und weiter an Google Analytics 4. Ein Service Worker ist ein kleines Programm, das der Browser im Hintergrund am Laufen hält und das hier die Daten anstelle der Seite sendet. Werkzeuge, die nur beobachten, was die Seite sendet, sehen ihn standardmässig nicht.
Korrigiert hat mich eine Prüfung, die nicht von der ersten abhing. Ich sendete ein Testereignis mit einem Namen, den noch nie jemand verwendet hatte, und suchte es dort, wo es ankommen musste, im Echtzeitbericht von Google Analytics 4. Es war da, zusammen mit den übrigen Testereignissen dieses Tages, insgesamt 33, und jedes davon stammte von mir, kein einziges war ein echter Kontakt.
Also änderte ich den Test, nicht den Aufbau. Die Version habe ich erneut veröffentlicht, nachdem ich sie mit einem echten Klick geprüft hatte; die Testmethode steht weiter unten im Abschnitt zum Testen. Die Lehre für alle, die solche Arbeit beauftragen: Verlangen Sie den Beweis am Ziel und nicht die Abwesenheit von Fehlern in einem Protokoll.
Was Server-Side-Tracking ist: eine Sortierstelle auf Ihrer Domain
Stellen Sie sich den üblichen Aufbau so vor, dass ein Besucher je einen eigenen Brief an Google, an Meta und an jedes weitere Tool schickt, jedes mit eigener Adresse. Beim Server-Side-Tracking schickt der Browser einen einzigen Brief an eine Sortierstelle auf Ihrer eigenen Domain. Die Sortierstelle entscheidet, was sie an wen weiterleitet.
Google beschreibt es in der Einführung in Server-Side-Tagging fast mit denselben Worten: «Ein Server-Container läuft nicht im Browser des Nutzers oder auf seinem Telefon. Stattdessen läuft er auf einem Server, den Sie kontrollieren.» Weiter heisst es: «Der Server empfängt Webanfragen vom Gerät des Nutzers und wandelt diese Anfragen in Ereignisse um.»
Googles Variante heisst Server-Side Google Tag Manager, kurz sGTM. Sie können sie selbst auf Google Cloud betreiben oder bei einem verwalteten Dienst wie Stape mieten. Der Abschnitt zu den Kosten vergleicht beide.
Ein Punkt überrascht viele: Der Server ersetzt das Tag im Browser nicht. Der Kurs von Google fragt «Ersetzt Server-Side-Tagging das clientseitige Tagging?» und antwortet «Die Antwort lautet nein, aber es kann die Arbeit der clientseitigen Tags stark ergänzen und verbessern.» Der Server-Container «hat keinen Zugriff darauf, was auf einer Webseite oder in einer App passiert.»
Klicks, Scrollbewegungen und abgeschickte Formulare erfasst also weiterhin ein Tag im Browser, und der Server sortiert nur, was ihm der Browser übergibt. Der Server ist ein Teil Ihres weiteren Marketing-Tech-Stacks, und er lohnt sich nur, wenn er ein Messproblem löst, das Sie benennen können.
Was sich ändert, wenn die Daten über Ihren eigenen Server laufen
Google nennt das Ziel in seinem Kurs: «Server-Side Tag Manager wurde entwickelt, um Ihnen mehr Kontrolle über die Daten zu geben, die bei Ihren Nutzern erhoben werden. Er fungiert als Puffer zwischen dem Nutzer und den Anbietern, an die die Daten weitergeleitet werden.» Daraus folgen drei Dinge.
- Sie kontrollieren, was hinausgeht. Bei einem Browser-Aufbau gilt: «Es ist schwierig zu kontrollieren, welche Informationen verarbeitet werden. So wird zum Beispiel die IP-Adresse des Nutzers bei der Kommunikation mit den Servern der Anbieter immer mitgesendet.» Mit einem Server gilt: «Der Anbieter sieht nur eine Anfrage vom Server, nicht vom Browser oder Gerät des Nutzers.»
- Sie können Daten entfernen oder maskieren. Laut Google können Sie «HTTP-Anfragen validieren, parsen, anonymisieren oder sogar blockieren», bevor sie weitergehen.
- Sie können hinzufügen, was der Browser nicht halten darf. Serverseitige Prozesse «können genutzt werden, um die Daten mit Informationen anzureichern, die dem Browser nicht offengelegt werden sollten», zum Beispiel mit der Marge einer Bestellung.
Google verspricht Kontrolle. In seinen Seiten habe ich keine Zahl zu zurückgewonnenen Conversions gefunden. Material von Anbietern nennt zwar Zuwächse, aber nicht aus kontrollierten Vergleichen, darum lasse ich diese Zahlen weg.
Eine vierte Änderung, langlebigere Cookies, hat weiter unten einen eigenen Abschnitt, denn sie kommt mit einer Bedingung.
Was Server-Side-Tracking nicht ändert: die Einwilligung
Server-Side-Tracking macht aus einem Nein kein Ja. In der Dokumentation von Google zum Consent Mode steht es klar: «Der Consent Mode bietet kein Einwilligungsbanner und kein Widget.» Er arbeitet mit dem Banner, das Sie bereits haben.
Das Banner entscheidet, und die Tags passen sich an. In der Basisversion «verhindern Sie, dass Google-Tags geladen werden, bis ein Nutzer mit einem Einwilligungsbanner interagiert.» In der erweiterten Version werden die Tags geladen, und wenn ein Besucher die Einwilligung verweigert, «speichern Tags, die die Einwilligung berücksichtigen, keine Cookies», sondern senden cookielose Pings.
Google listet auf, was ein solcher Ping enthält: einen Zeitstempel, den Browsertyp, die verweisende Seite, ob der Link Informationen zu einem Anzeigenklick enthielt, den Einwilligungsstatus und eine Zufallszahl.
Wo passt der Server hinein? Nach meiner Lesart der Dokumentation von Google ist der Server der Ort, an dem Einwilligungsentscheidungen umgesetzt werden, und kein Weg, sie zu umgehen. In den Aufbauten, die ich baue, wird die Einwilligung im Web-Container gesetzt (dem Tag-Manager-Arbeitsbereich, der im Browser läuft), und die Server-Tags respektieren sie.
Ein Besucher, der ablehnt, kann diese Pings trotzdem senden, und nichts zwingt einen schlecht konfigurierten Server, die Ablehnung zu befolgen. Er tut es nur, wenn er dafür eingerichtet ist.
Auch der Datenschutz verschwindet nicht. Sie holen ein Unternehmen dazu, das die Daten Ihrer Besucher verarbeitet, also brauchen Sie mit ihm einen Auftragsverarbeitungsvertrag und eine aktualisierte Datenschutzerklärung. Eine weitere Tatsache ist noch schlichter: Wenn der Browser nie ein Ereignis sendet, sieht der Server es nie.
Bei Schweizer Websites kommt eine weitere Ebene dazu. Google hat seine Richtlinie zur Einwilligung ausgeweitet: «Ab dem 31. Juli 2024 weitet Google den Geltungsbereich seiner EU-Richtlinie zur Einwilligung von Nutzern auf Nutzer in der Schweiz aus.»
Der Eidgenössische Datenschutz- und Öffentlichkeitsbeauftragte (EDÖB) hat Leitlinien zur Datenbearbeitung mit Cookies veröffentlicht, in der Version 1.1 vom 6. Oktober 2025.
Für Websites mit Schweizer Inhaber gilt bei mir eine Regel mit zwei Stufen: Bei Statistik gilt ein Opt-out, Werbung und Profiling brauchen ein Ja, im Einklang mit der Einwilligungsrichtlinie von Google für die Schweiz, und ein Server ändert daran nichts. In welche Stufe eine Messung fällt, ist eine Rechtsfrage, und meine Checkliste zur Tracking-Einwilligung in der Schweiz (auf Englisch) nennt die Prüfpunkte und die Quellen; sie ist keine Rechtsberatung. Dieselbe Logik gilt bei E-Mails, wo ein Tracking-Pixel ebenfalls eine Anfrage an einen Server ist; die Regeln dazu behandle ich in Regeln zum E-Mail-Tracking in Europa.
Safari und die Lebensdauer von Cookies: länger, aber nicht automatisch
Safari begrenzt über eine Funktion namens Intelligent Tracking Prevention (ITP), wie lange Cookies leben. Die Seite von WebKit zur Tracking-Prävention sagt: «ITP löscht alle mit JavaScript erstellten Cookies und jeden anderen per Skript beschreibbaren Speicher nach 7 Tagen ohne Nutzerinteraktion mit der Website.» Die 7 Tage zählen Tage der Safari-Nutzung, nicht Kalendertage.
Kommt ein Besucher von einer Seite, die ITP als Tracker einstuft, über einen Link mit Tracking-Parametern, ist die Obergrenze enger: ITP «begrenzt die Lebensdauer von Cookies, die per JavaScript auf der Landingpage erstellt werden, auf 24 Stunden.»
Ein Cookie, das Ihr Server in seiner Antwort setzt, wird anders behandelt. Die Tabelle von WebKit zeigt dafür keine Obergrenze, ausser Safari erkennt «Drittanbieter-CNAME-Cloaking und Drittanbieter-IP-Adress-Cloaking-Anfragen», dann liegt die Obergrenze bei 7 Tagen.
Cloaking heisst, dass ein Name auf Ihrer Domain im Hintergrund ein Alias für den Server eines anderen Unternehmens ist. Nach dieser Definition könnte eine Subdomain, die ein Alias für einen verwalteten Dienst ist, unter die Regel fallen, und das ist ein weiterer Grund zum Testen.
Google ist bei seinem eigenen Produkt optimistischer. Das Ausliefern von Ihrer eigenen Domain ist nach seinen Worten eine bewährte Praxis, die die Vorteile bei Sicherheit und Haltbarkeit serverseitig gesetzter Cookies bringt, und seine Tabelle gibt einer Subdomain «Vollen Zugriff auf die Vorteile bei Sicherheit und Haltbarkeit.»
Auf der Standarddomain lautet der Zugriff auf serverseitig gesetzte Cookies: «Keiner. Nur JavaScript-Cookies können gesetzt werden.» Die Regeln von WebKit sind der Grund, warum der Vorteil nicht automatisch eintritt.
Manche Anbieter-Blogs gehen weiter: Eine Subdomain, die auf eine andere IP-Adresse zeigt als Ihre Website, könne trotzdem auf 7 Tage begrenzt werden. Die Seite von WebKit definiert diese Regel nicht, darum behandle ich sie als etwas, das man testen muss.
Mein Fazit für alle, die entscheiden: Ein serverseitiger Aufbau kann Cookies in Safari länger leben lassen, aber nicht automatisch. Es hängt davon ab, wie die Subdomain angebunden ist, und ich empfehle, es in Safari auf Ihrer eigenen Website zu testen, bevor Sie sich darauf verlassen.
Was Server-Side-Tracking kostet: mieten oder selbst betreiben
Die Seiten von Google nennen für einen Server ähnliche Zahlen, widersprechen sich aber, wie viele Server man betreiben soll. Der Einrichtungsleitfaden für Cloud Run sagt «jeder Server kostet etwa 45 $ pro Monat (USD)» und empfiehlt «mindestens 2 Instanzen».
Die Übersicht sagt «Sie können mit 30 bis 50 $ pro Server und Monat rechnen» und empfiehlt «mindestens 3 Instanzen pro Container». Der Kurs sagt «Der Preis beträgt etwa 50 USD pro Instanz und Monat.»
Hier meine eigene Rechnung in drei Schritten, mit den Einheitspreisen auf der Preisseite von Google Cloud Run:
- Ein Server mit 1 vCPU (einem virtuellen Prozessorkern) und 0,5 GiB Arbeitsspeicher, der den ganzen Monat läuft, sind 2.592.000 Sekunden. Das ergibt 2.592.000 vCPU-Sekunden und 1.296.000 GiB-Sekunden, die Einheiten, nach denen die Seite abrechnet.
- Bei 0,000018 USD pro vCPU-Sekunde und 0,000002 USD pro GiB-Sekunde sind das 46,66 plus 2,59, also etwa 49 USD pro Server.
- Mit dem empfohlenen Minimum von 2 oder 3 Servern wird die Rechnung etwa 98 oder 148 USD im Monat, vor einem Gratiskontingent im Wert von rund 5 USD.
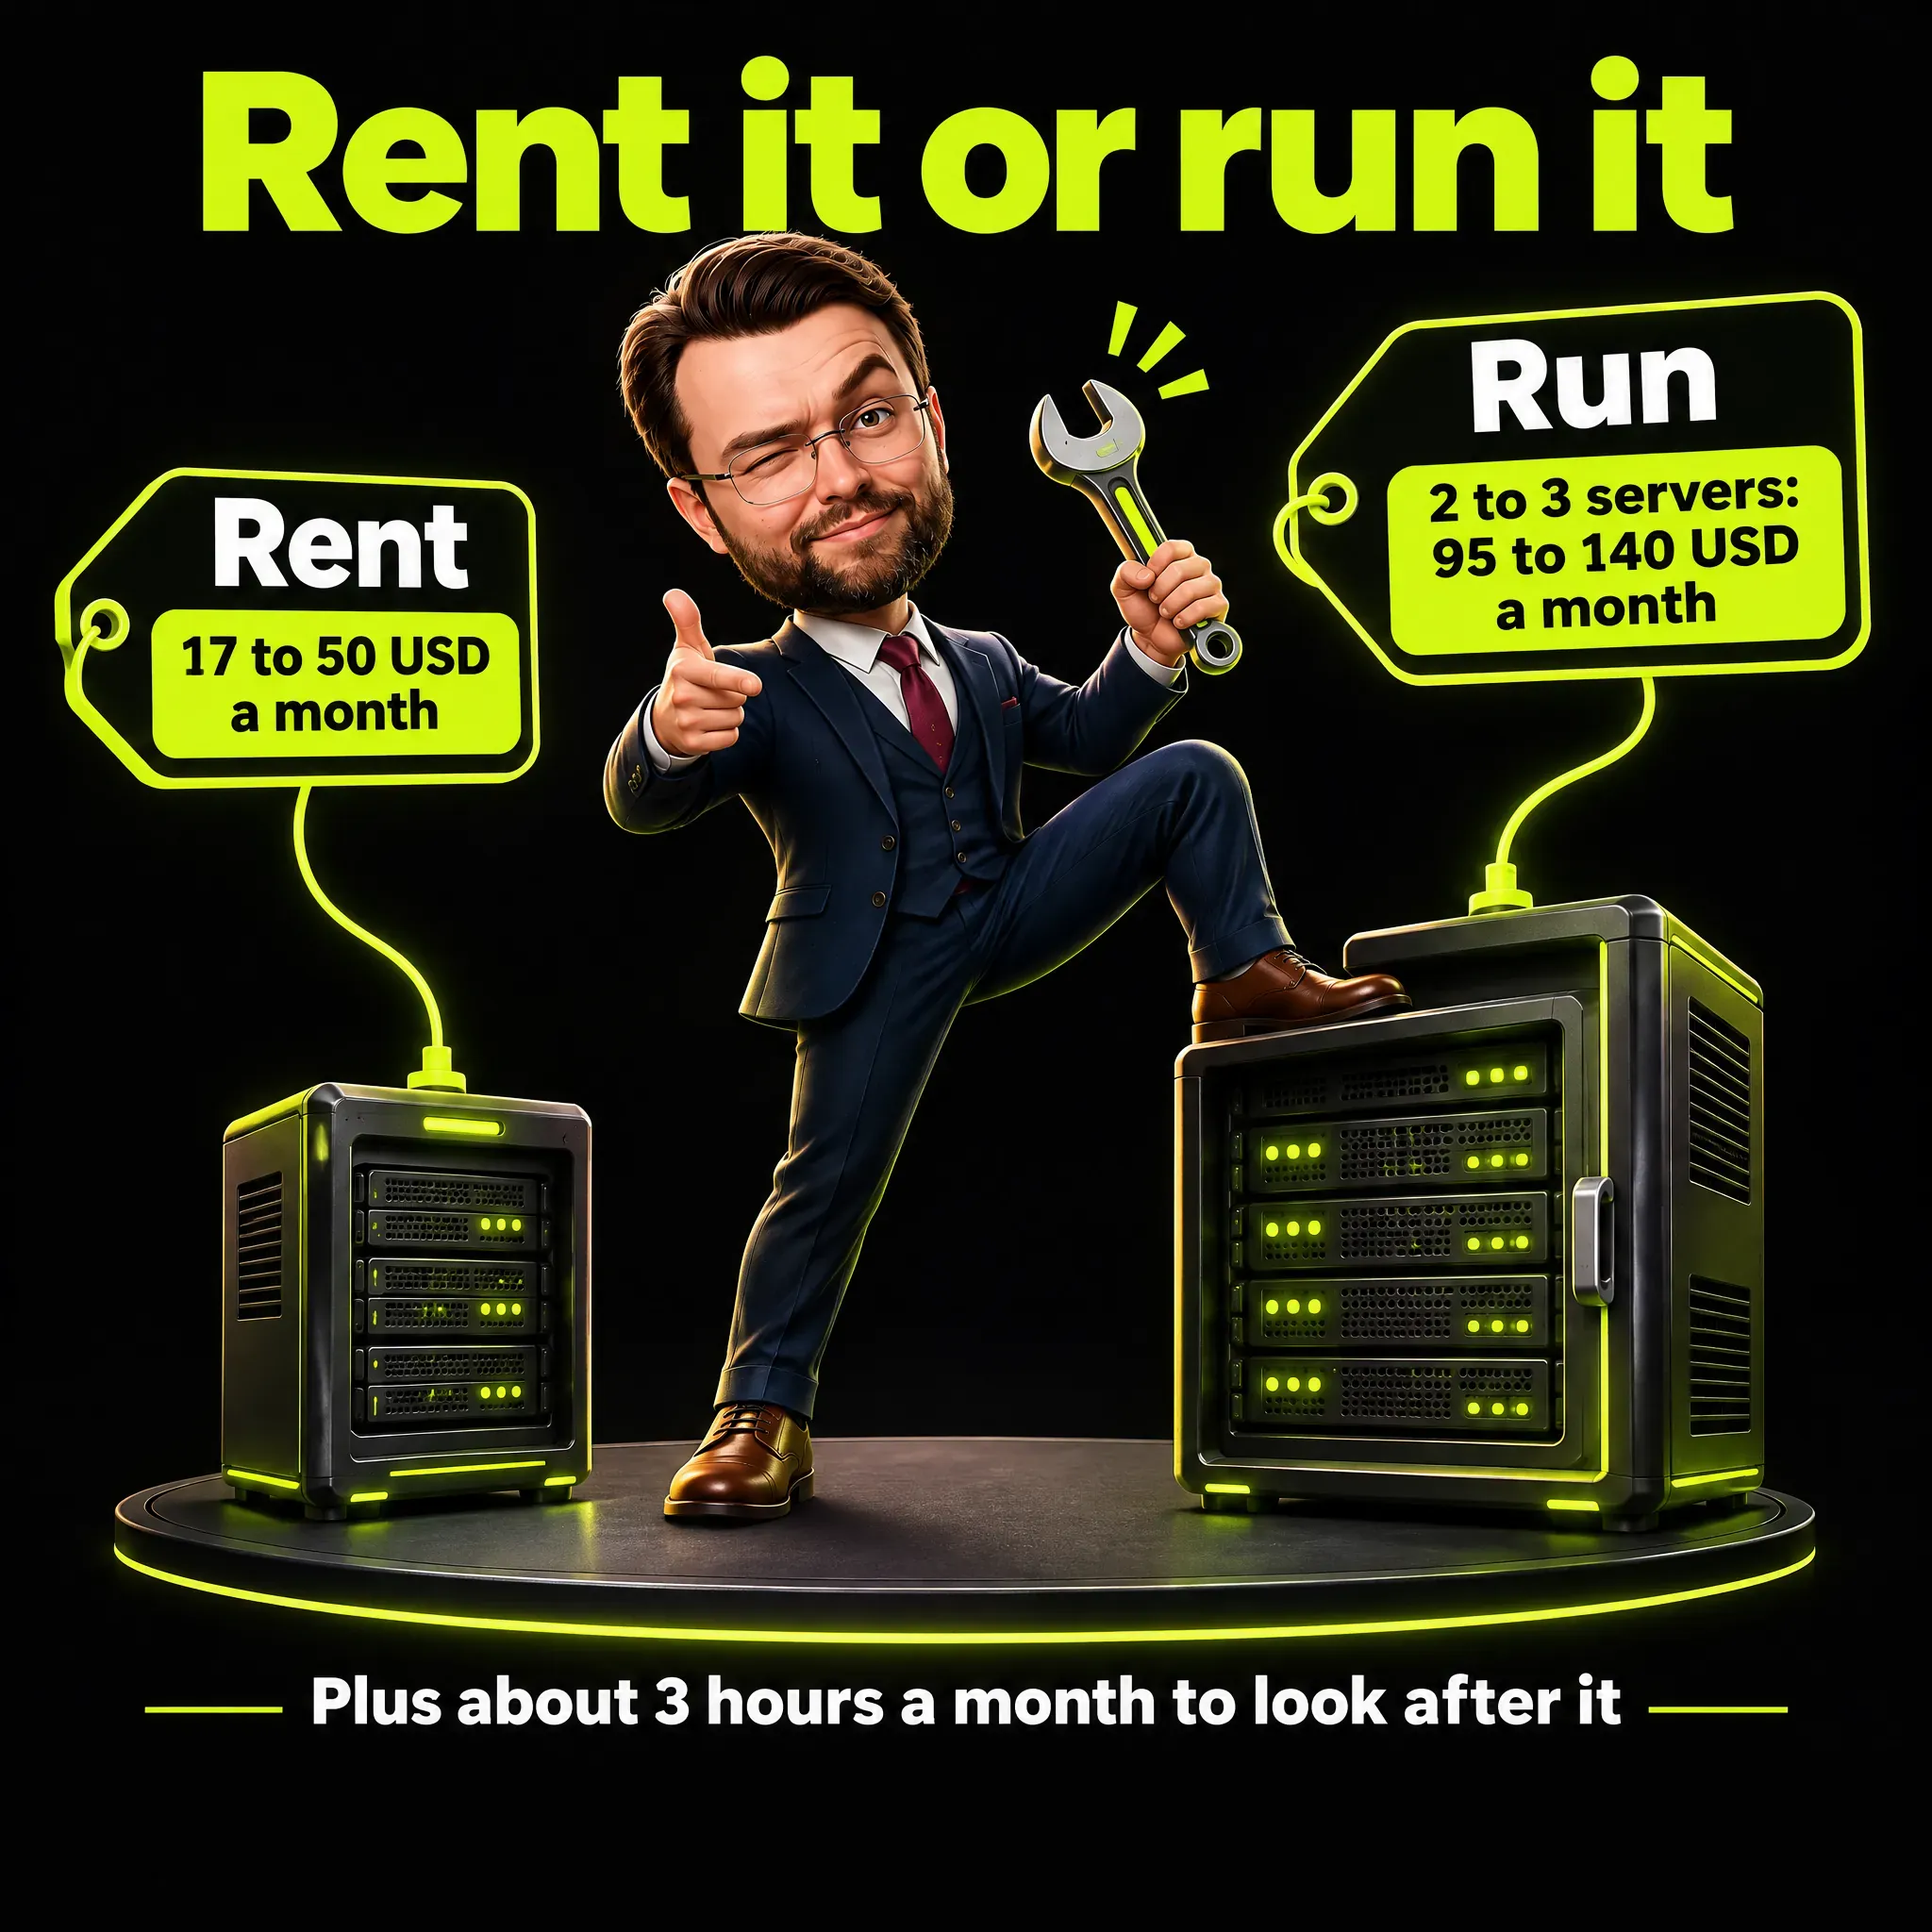
Die Preisseite mischt verschiedene Regionen, lesen Sie diese Zahlen also als Grössenordnungen. Mein eigenes Kostenblatt vom 9. Oktober 2026 zeigt ein fixes Minimum von 95 bis 140 USD im Monat, was nahe an dieser Spanne liegt.
Die Lehre ist nicht die Zahl. Bevor Sie etwas unterschreiben, fragen Sie, von wie vielen Servern das Angebot ausgeht, in welcher Region und mit welchen Protokollen.
Die Hosting-Rechnung ist nicht die ganze Rechnung. Google warnt: «Netzwerk-Egress kann zum Kostenfaktor werden, wenn Ihr Endpunkt für Server-Side-Tagging grössere Ressourcen oder JavaScript-Bibliotheken ausliefert.» Egress sind die Daten, die Ihren Server verlassen.
Google warnt auch: «Sobald Sie genug Anfragen sammeln, um das kostenlose Kontingent von Cloud Logging zu überschreiten, kann die Speicherung der Protokolle erhebliche Kosten verursachen.» Cloud Logging ist der Dienst von Google, der die Protokolle des Servers speichert, das Tagebuch dessen, was er empfangen hat. Und jemand muss sich um den Server kümmern: Mein Kostenblatt rechnet mit etwa 3 Stunden im Monat.
Die Alternative ist ein verwalteter Dienst. Auf der Preisseite von Stape, gelesen am 4. November 2026, deckt der kostenlose Plan «bis zu 10K Anfragen» ab.
Pro kostet 17 USD im Monat mit Jahresplan und 20 USD ohne (der zweite Betrag stammt vom Registrierungslink), für «bis zu 500K Anfragen», und bewahrt die Protokolle 3 Tage auf. Business kostet 83 USD mit Jahresplan und 100 USD ohne, für «bis zu 5M Anfragen».
Die Pläne werden in Anfragen gezählt, nicht in Ereignissen. Nach meiner Erfahrung zählen auch Skript-Ladevorgänge und Bots als Anfragen, ein Plan füllt sich also schneller, als die Ereignisse in GA4 vermuten lassen. Eine Offenlegung: Stape betreibt ein Partnerprogramm mit wiederkehrender Provision, prüfen Sie meine Zahlen also anhand der öffentlichen Preisseite, statt sich auf mein Wort zu verlassen.
Wann sich Server-Side-Tracking lohnt und wann nicht
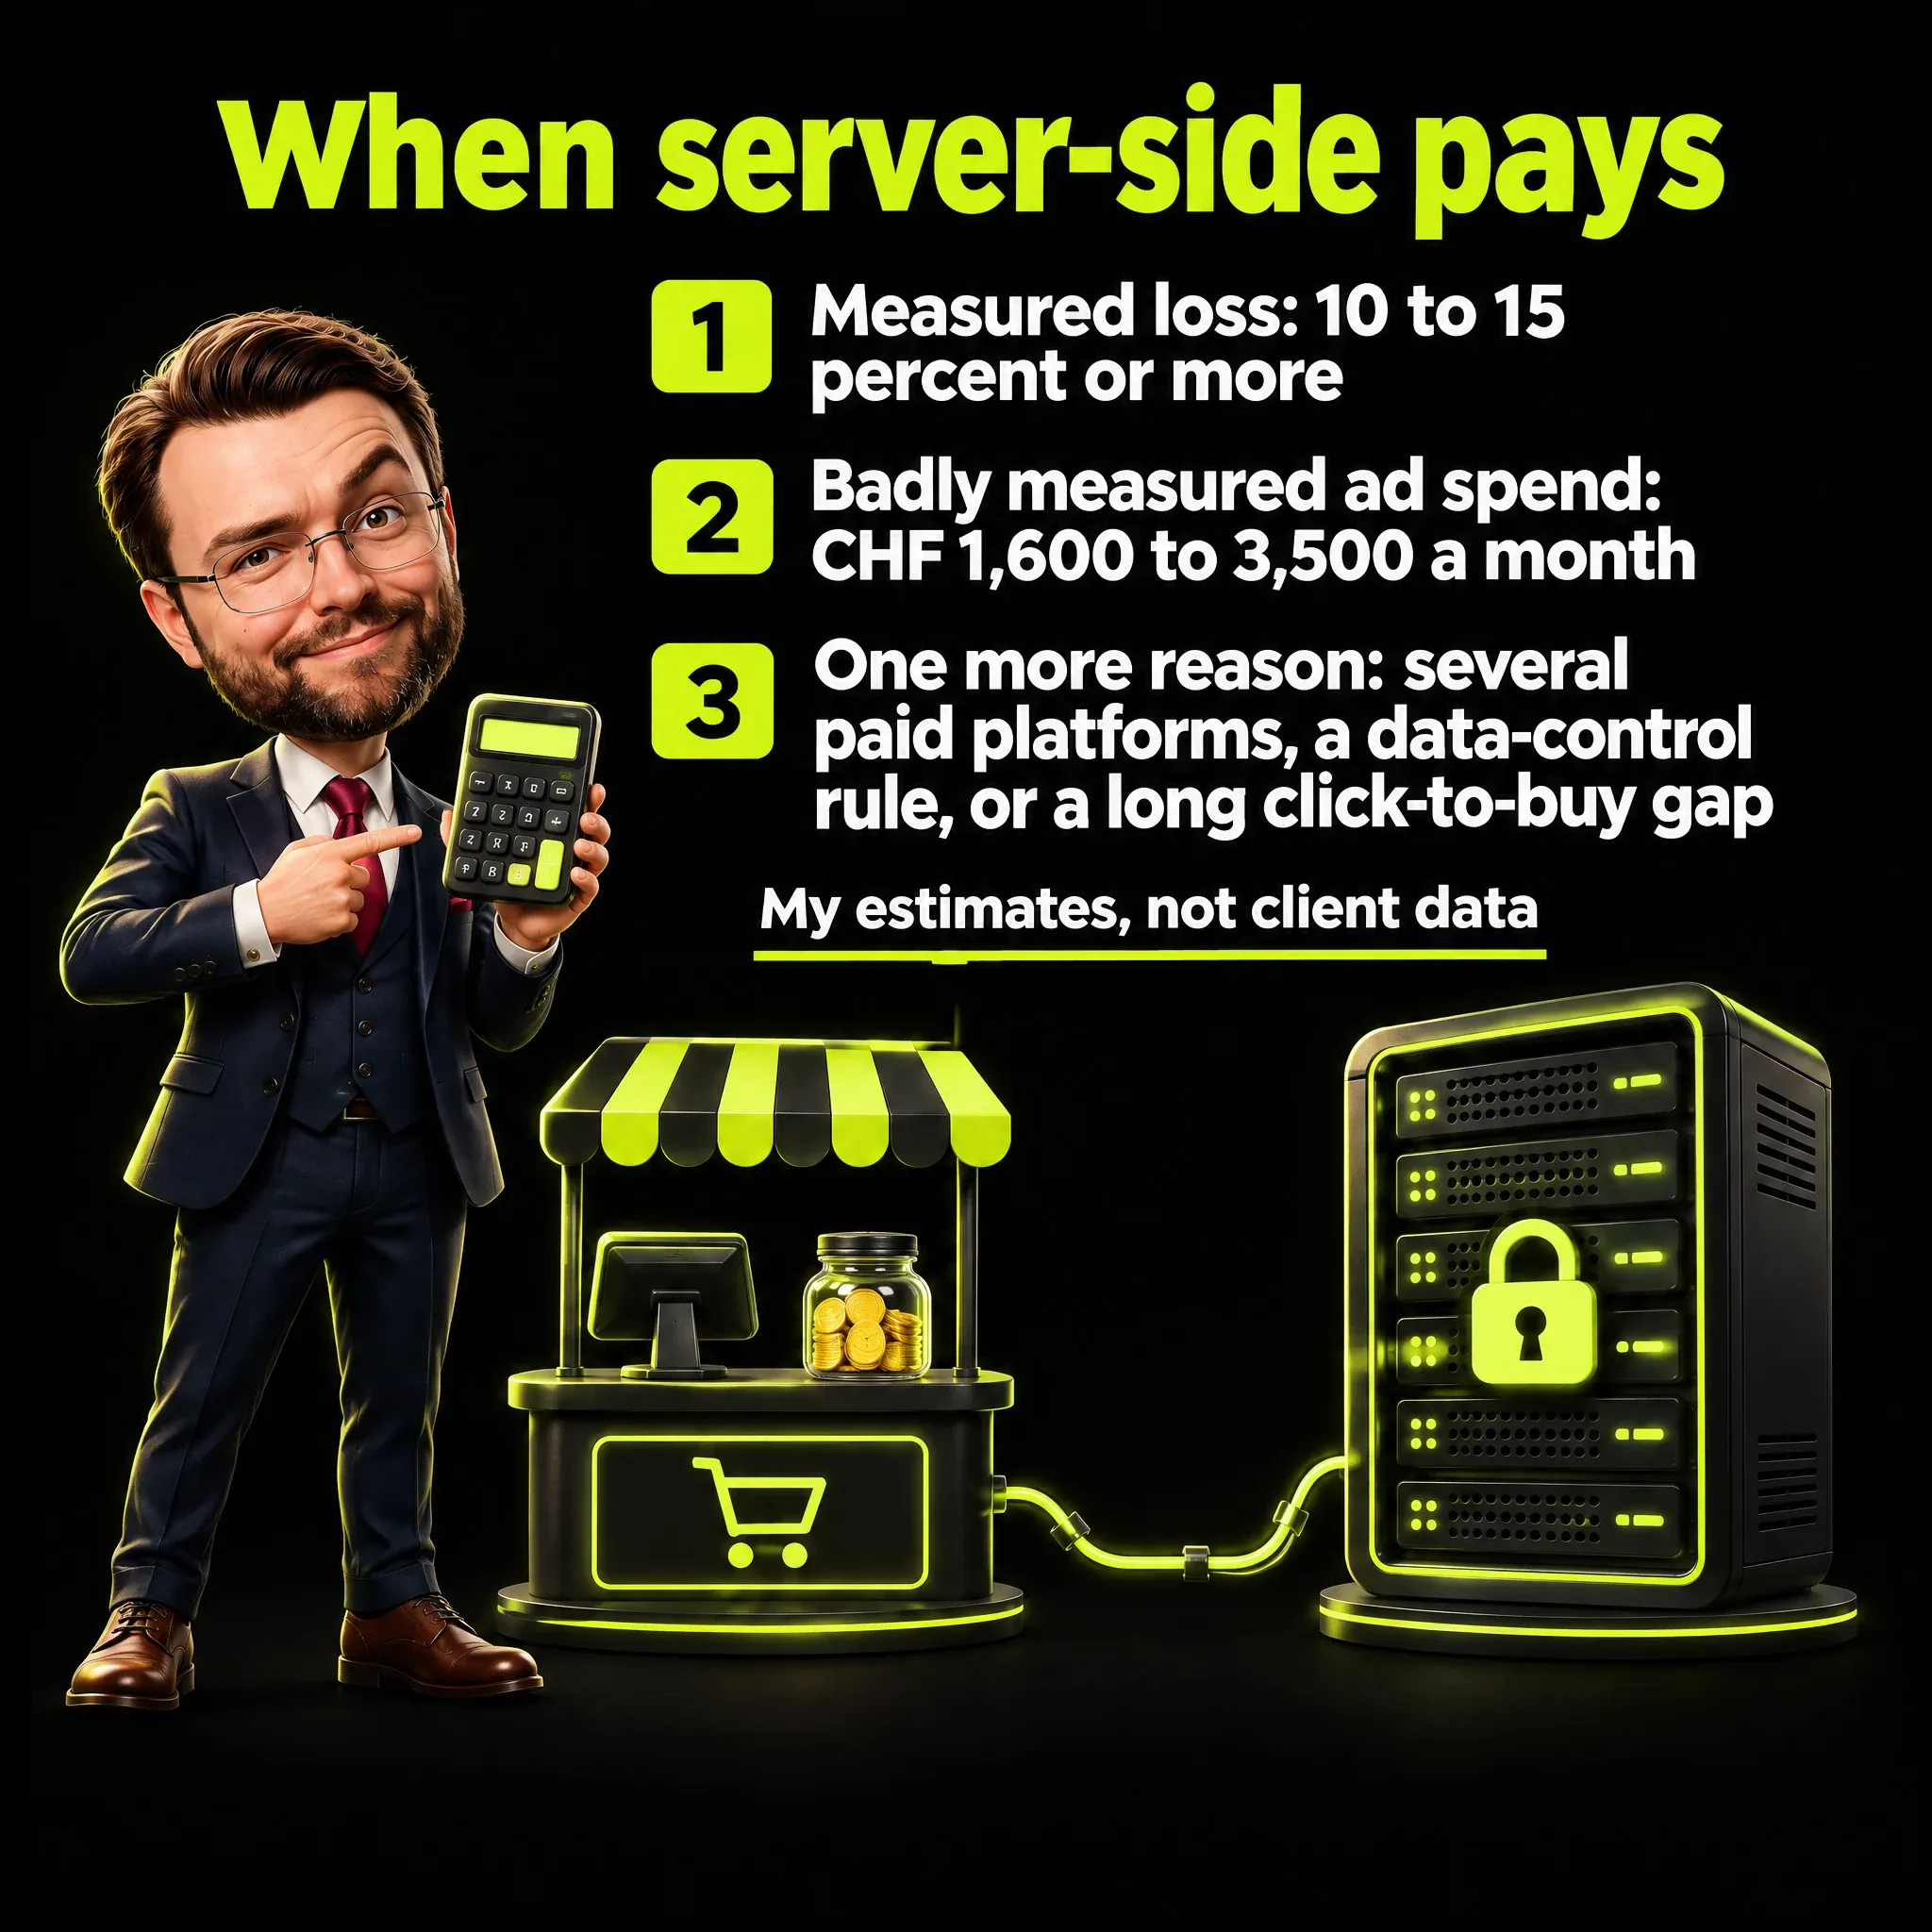
Meine Regel ist einfach zu formulieren: Erwägen Sie Server-Side-Tracking nur, wenn alle diese Bedingungen erfüllt sind. Die Schwellen sind meine Schätzungen, aus Anbieter- und Kostenzahlen gebildet und nicht bei einem Kunden gemessen.
- Ein gemessener technischer Verlust von mindestens 10 bis 15 Prozent, unabhängig von der Einwilligung: weniger als etwa 85 Sitzungen in Google Analytics auf je 100 Anzeigenklicks, sobald die Einwilligungseinstellungen stabil sind.
- Schlecht gemessene Werbeausgaben von mindestens CHF 1.600 bis 3.500 im Monat, also der Teil Ihrer Ausgaben, dessen Ergebnisse Sie nicht richtig sehen können.
- Mindestens ein weiterer Grund: zwei oder mehr bezahlte Plattformen mit genügend Ereignissen (meine Arbeitswerte sind etwa 50 Ereignisse pro Woche und Anzeigengruppe bei Meta, wobei eine Anzeigengruppe eine Gruppe von Anzeigen mit eigener Zielgruppe und eigenem Budget ist, und etwa 30 Conversions im Monat bei Google); eine schriftliche Vorgabe Ihres Unternehmens oder seines Datenschutzbeauftragten, die Kontrolle über die Daten zu behalten; oder ein langer Abstand zwischen Klick und Kauf, über 7 Tage, zusammen mit einem Safari-Anteil von mindestens 30 Prozent am Traffic und einer Serveradresse auf Ihrer eigenen Domain.
Woher kommt die zweite Zahl? Schritt eins: Die monatlichen Gesamtkosten auf dem günstigsten Weg betragen etwa CHF 315 bis 350. Das sind 17 bis 50 USD für einen verwalteten Plan oder einen Server (1 USD gerechnet als etwa 1 CHF), plus etwa 3 Stunden Arbeitszeit zu einem angenommenen Satz von CHF 100 pro Stunde.
Schritt zwei: Ich will, dass die schlecht gemessenen Ausgaben das 5- bis 10-Fache dieser Rechnung betragen, weil sich nur ein Teil der verlorenen Conversions zurückholen lässt. Das ergibt CHF 1.575 bis 3.500, gerundet auf 1.600 bis 3.500. Schritt drei: Unterhalb dieser Ausgaben ist die Rechnung zu schwer für das, was ein Server zurückgewinnen kann.
Mit dem von Google empfohlenen Minimum von 2 oder 3 Servern liegt allein das Hosting bei 95 bis 140 USD, die Gesamtrechnung bei etwa CHF 395 bis 440, und dieselben zwei Schritte verschieben die Schwelle auf etwa CHF 2.000 bis 4.400.
Nehmen wir einen Beispiel-Shop mit gerundeten Zahlen: etwa 1.000 Anzeigenklicks im Monat zu etwa CHF 1 pro Klick, eine Conversion-Rate von etwa 0,5 Prozent und eine durchschnittliche Bestellung von CHF 100. Schritt eins: 1.000 Klicks bei 0,5 Prozent sind etwa 5 Bestellungen. Schritt zwei: Nehmen Sie als Schätzung an, dass von 100 Klicks 3 bis 5 aus technischen Gründen verloren gehen.
Schritt drei: Das sind 0,15 bis 0,25 Bestellungen im Monat, die in den Berichten fehlen, nicht im Verkauf, oder CHF 15 bis 25 im Monat. Gegenüber einer fixen Rechnung von CHF 315 bis 350 und Ausgaben von CHF 1.000, die unter der obigen Schwelle liegen, lohnt es sich nicht.
Verlorene Conversions fallen dort stärker ins Gewicht, wo die Ausgaben gross sind, denn zu wenig gezählte Conversions lassen Ihre ausgewiesenen Kundenakquisitionskosten schlechter aussehen, als sie sind. Ein Server kann einer kleinen Website trotzdem auf andere Weise helfen: durch Kontrolle darüber, was hinausgeht (personenbezogene Daten entfernen, Hosting in der EU oder der Schweiz, eine zentrale Stelle für die Einwilligung), und durch Stabilität für Besucher, die zustimmen, etwa Cookies, die von Ihrer eigenen Domain gesetzt werden.
Was ich zuerst empfehle, in der Reihenfolge des Ertrags:
- Diagnostizieren Sie die Käufe, die in Ihren Anzeigen null zeigen.
- Gleichen Sie einmal pro Woche mit den tatsächlichen Bestellungen aus dem Shop ab: Vergleichen Sie die Bestellungen in Ihrem Shop mit den Bestellungen, die Ihre Anzeigen melden.
- Bringen Sie die Einwilligungseinstellungen und das Design des Banners in Ordnung, denn sie entscheiden, wie viele Besucher überhaupt gemessen werden können.
- Ergänzen Sie einen cookielosen Zähler, einen Besuchszähler, der keine Cookies setzt, als Gegenprobe für die Gesamtzahlen.
- Nutzen Sie Enhanced Conversions, bei denen Google eine codierte Form der E-Mail-Adresse eines Kunden dem Anzeigenklick zuordnet, oder die Conversions API von Meta, bei der Ihr Server den Verkauf direkt an Meta meldet.
Die meisten davon kosten Stunden und keine monatliche Gebühr. Beurteilen Sie jede Massnahme danach, was sie schützt, so wie Sie jede Frage zum Marketing-ROI beurteilen würden.
So testen Sie Server-Side-Tracking, ohne Ihre Daten zu verfälschen
Ein serverseitiger Aufbau kann mit «200 OK» antworten und das Ereignis trotzdem verlieren. Wenn Sie die Arbeit beauftragen, verlangen Sie drei Dinge:
- Ein Test, der Ihre echten Daten nicht berühren kann. Der Test läuft in einem geschlossenen Raum, sodass kein Testverkehr Ihre Berichte erreicht.
- Ein Signal, das noch niemand verwendet hat. Der Test löst ein Ereignis mit einem eindeutigen Namen aus und findet es dort, wo es ankommen muss, im Echtzeitbericht von Google Analytics 4. Das ist der positive Beweis am Ziel.
- Kriterien für Bestehen oder Durchfallen, die vor der Veröffentlichung schriftlich feststehen. Fällt eines durch, geht die vorherige Version wieder live.
Wer den Aufbau konfiguriert, braucht die Einzelheiten. Das sind die Regeln, mit denen ich teste, jede auf einer echten Website geprüft:
- Im geschlossenen Raum testen. Liefern Sie den Service Worker aus lokalen Dateien aus und sagen Sie dem Browser, dass der echte Server nicht existiert, damit kein Testverkehr Ihre echten Daten erreicht.
- Testbesuche kennzeichnen. Ich setze eine Kampagnenquelle wie
sgtm_qaund verwende eine normale Browser-Identität, weil GA4 Headless-Browser (Browser, die ohne Bildschirm laufen) als Bots verwirft. - Einwilligungscodes von der Live-Website kopieren. Ein von Hand getippter Einwilligungsparameter
gcd, ohne das Suffix der echten, kann als «verweigert» gelesen werden: Der Server antwortet 200, und das Ereignis kommt nie an. Der verwandte ParametergcszeigtG100, wenn die Einwilligung verweigert wird, undG111, wenn sie erteilt wird, wie auf einer Live-Website beobachtet. - Kriterien vor der Veröffentlichung festlegen. Meine: kein Mess-Cookie und kein vom Server gesetztes Cookie vor der Einwilligung, kein direkter Messaufruf an google-analytics.com, 200er-Antworten von der Domain des Servers,
G111nach «Alle akzeptieren» und das Ereignis sichtbar in GA4. - In echten Berichten nach Hostnamen filtern. In GA4 ist das die Dimension
hostName, die Adresse, unter der ein Besuch erfasst wurde. Und senden Sie nie plausible Werte an Endpunkte, die zählen.
Das eigene Debug-Werkzeug von Google deckt die Hälfte davon ab. Der Vorschau- und Debug-Modus für die Serverseite «ermöglicht es Ihnen, eingehende HTTP-Anfragen von Ihrer Website oder App zu untersuchen und zu verstehen, wie sie verarbeitet werden.» Das zeigt, was der Server empfangen hat, nicht aber, dass das Ziel es empfangen hat, darum brauchen Sie beide Beweise.
Es ist dasselbe Prinzip, das ich bei KI-Agenten anwende: eine Prüfung, die nicht von dem abhängt, was sie prüft. Darüber habe ich in KI-Marketing-Agenten und in Human-in-the-Loop-Verifikation bei KI geschrieben.
Praktisch sind Testbesuche gekennzeichnet, sodass man sie aus den Zahlen filtern kann, die ein Kunde sieht, und das zählt, wenn als Nächstes ein Bericht ansteht. Wie ich das handhabe, beschreibe ich im Marketing-Report.
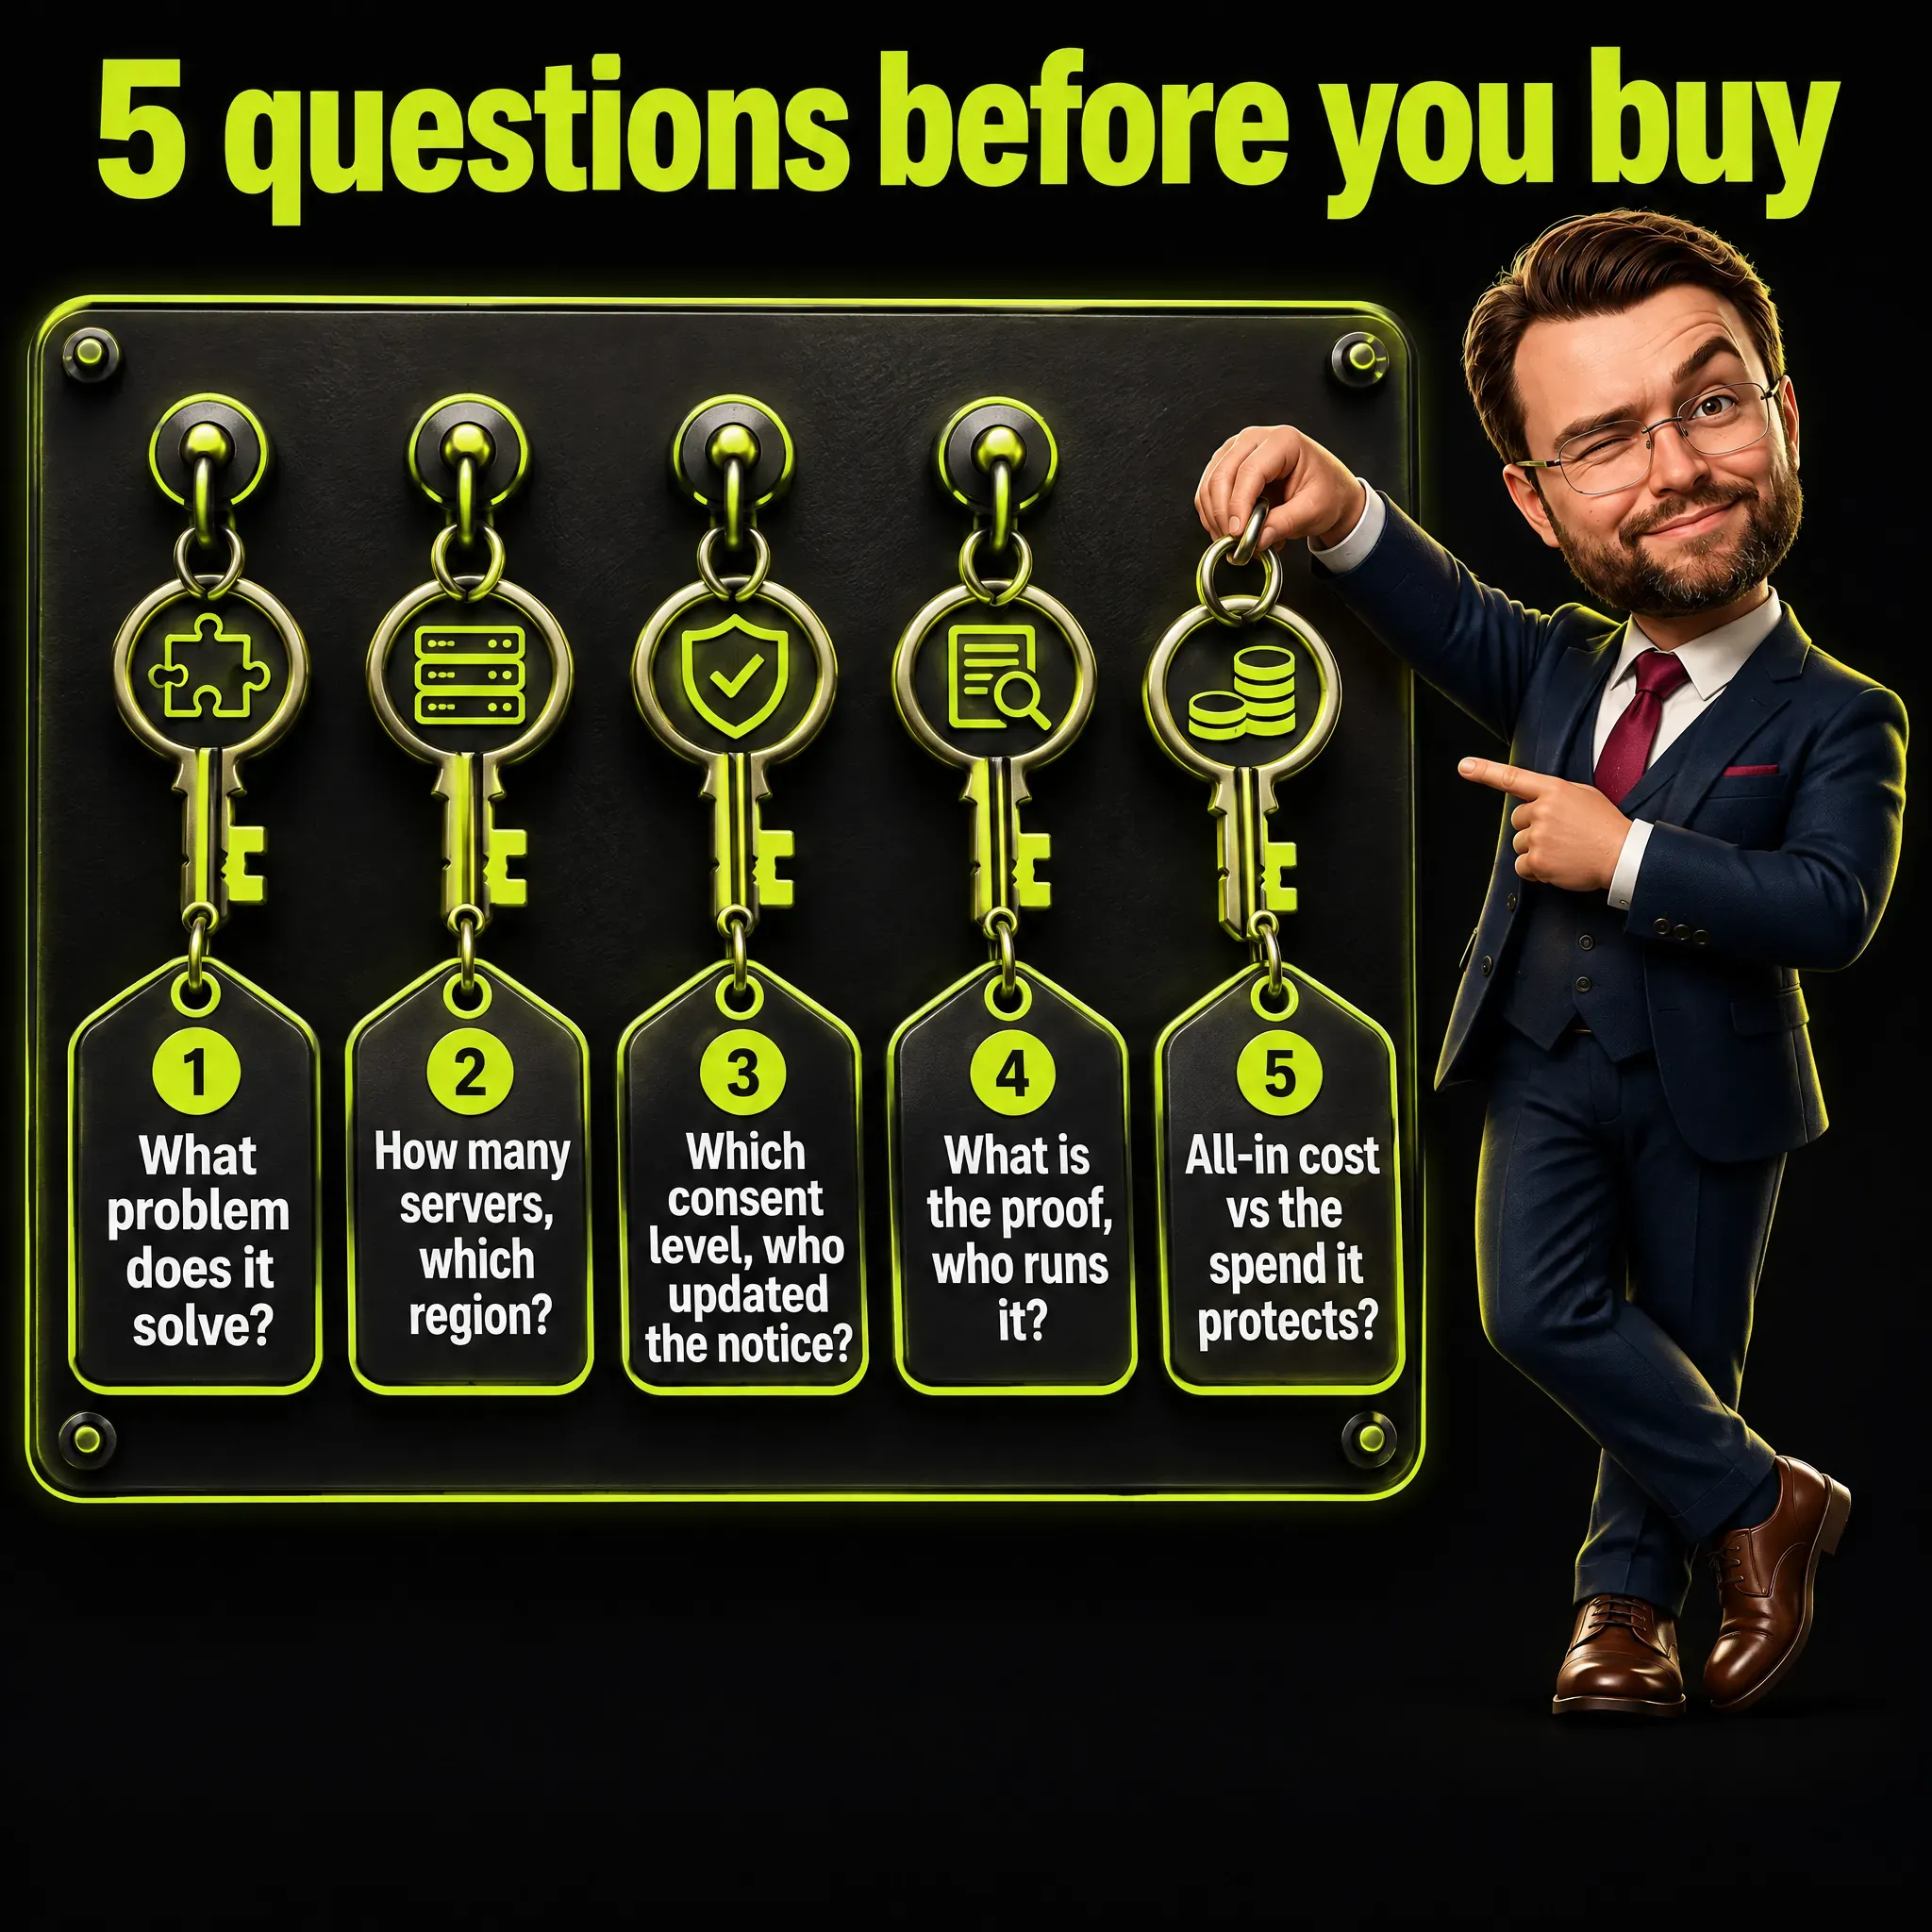
Fünf Fragen, bevor Sie Server-Side-Tracking freigeben
- Welches Problem löst es für uns: technischer Verlust, Kontrolle oder Governance?
- Von wie vielen Servern oder Anfragen geht das Angebot aus, in welcher Region, mit welchen Protokollen?
- In welche Einwilligungsstufe fällt jede Messung, und wer hat die Datenschutzerklärung und den Auftragsverarbeitungsvertrag aktualisiert?
- Was ist der Beweis am Ziel, und wer führt ihn durch?
- Wie verhalten sich die monatlichen Gesamtkosten zu den Ausgaben, die sie schützen?
Die fünfte Frage entscheidet die meisten Fälle. Wenn Sie eine Zahl daneben stellen können, sind Sie bereit, über Server-Side-Tracking zu entscheiden.
Häufige Fragen
Was ist ein serverseitiges Tag?
Ein Tag, das im Server-Container (der Serverversion eines Tag-Manager-Arbeitsbereichs) statt im Browser des Besuchers läuft. Es funktioniert wie ein Browser-Tag, mit denselben Triggern und Variablen, und erhält Ereignisse von einem «Client», der eine Anfrage in ein Ereignis umwandelt; Google sagt dazu: «Tags, Trigger und Variablen in einem Server-Container funktionieren genau wie in anderen Containertypen».
Was ist sGTM?
Es ist der serverseitige Google Tag Manager: Sie betreiben den Container auf einem Server, den Sie kontrollieren, etwa Google Cloud Run, und die Messungen Ihrer Website erreichen ihn, bevor sie Google, Meta und die anderen Tools erreichen. Er ergänzt den Web-Container und ersetzt ihn nicht.
Wie prüft man die Kommunikation zwischen zwei Servern?
Mit zwei Beweisen, und Sie brauchen beide: Die Server-Vorschau zeigt, was der Server empfangen hat, und ein Testereignis mit eindeutigem Namen, im Echtzeitbericht von GA4 gesucht, zeigt, was angekommen ist. Das Browserprotokoll allein genügt nicht, weil ein Service Worker in Tests, die nur die Seite beobachten, nicht auftaucht.
Wofür wird der Google Tag Manager verwendet?
Um die Mess- und Werbe-Tags einer Website über eine einzige Oberfläche zu verwalten. Google beschreibt ihn als «ein Tag-Management-System, mit dem Sie Tags auf Ihrer Website einrichten und verwalten können, ohne den Code Ihrer Website zu ändern.»
Umgeht Server-Side-Tracking die Cookie-Einwilligung?
Nein: Der Consent Mode passt das Verhalten der Tags an die Entscheidung des Besuchers an, und Google nennt die Berücksichtigung der Cookie-Einwilligung unter den Aufgaben des Server-Containers. Für Schweizer Websites gilt weiterhin meine Zwei-Stufen-Regel aus der Checkliste.
Wie viel kostet ein Server für Server-Side-Tagging pro Monat?
Das hängt vom Weg ab: Ein verwalteter Dienst beginnt bei 0 USD bis 10.000 Anfragen und kostet 17 bis 20 USD bis 500.000 Anfragen (gelesen am 4. November 2026); auf Google Cloud Run nennt Google etwa 45 bis 50 USD pro Server, und bei seinem empfohlenen Minimum von 2 oder 3 Servern sind es grob 90 bis 150 USD im Monat, dazu kommen Protokolle, Datenverkehr und die Zeit der Person, die den Server betreut.
Lohnt sich Server-Side-Tracking für eine kleine Website ohne Werbung?
Im Allgemeinen nein: Ohne Werbeausgaben, die es zu schützen gilt, übersteigt die fixe Rechnung den Nutzen. Ich empfehle, zuerst das Einwilligungsbanner in Ordnung zu bringen und die tatsächlichen Bestellungen abzugleichen.
Hält ein Server-Cookie in Safari länger?
Es kann länger halten als die 7 Tage von Cookies, die per JavaScript geschrieben werden, aber nicht automatisch. Das hängt davon ab, wie die Subdomain angebunden ist, also testen Sie es in Safari auf Ihrer eigenen Website.


