自建大模型成本:Revolut节省90%的说法漏掉了什么
Revolut称,自建GLM模型让它的AI编程账单降到原来的十分之一。这个数字涵盖了什么、漏掉了什么,以及在自建大模型之前该先问清楚的八个问题和一张成本核对表。
自建大模型是指公司在自己拥有或租用的计算机上运行大语言模型(LLM),而不是把请求发给厂商托管的服务。这样一来,成本就从按token(词元,一小段文字)计费,转到了机器和运行机器的人身上。
2026年11月初,有新闻标题称,欧洲数字银行Revolut在专用GPU(图形处理器)上运行Z.ai的GLM模型,把AI编程成本降低了90%,也就是降到十分之一。GPU是运行AI模型的那类芯片,让模型运行起来回答请求,叫做推理(inference)。这些数字来自Revolut运维与基础设施负责人David Abitbol在纽约AI Engineer大会上的演讲。
我做营销,每个工作日都在用AI模型,多半是为我自己的需求训练的本地模型,所以我是以AI工具用户的身份来读这件事,不自称懂工程。这样的数字进入预算会议之前,我想先知道里面装了什么。
这篇文章把这个说法拆开来看,最后给出在任何人自建大模型之前该问的问题。
文章只谈成本与掌控,不构成法律意见,也不涉及地缘政治。价格表以及运行GLM模型的三种方式,在我的文章中国AI大模型企业使用指南里。
要点先看
- 没有任何来源给出可以照搬的自建价格。 记录最详细的案例是Revolut,而大会页面明确写道,它的数字“描述的是Revolut的部署与使用情况,不是任何自建模型都能照搬的价格”。
- 这90%比较的是同一家公司同一类工作负载的两张账单。 Revolut称,它现在的支出约为先前Anthropic和OpenAI账单的十分之一,这个说法比“公司所有AI成本下降90%”要窄得多。
- GPU周边的成本不在标题里。 Red Hot Cyber写道,这笔节省不含云、人员和监控成本。我在演讲和The Register的报道里,既没有找到其中任何一项的数字,也没有找到提及这项排除的地方。
- 我的理解是,每个token的价格取决于机器有多忙。 在同样的56块GPU上,Revolut称调优后每秒处理的请求多了76%,回答的第一个词出现前的等待缩短了88%。
- 自建会带来必须有人去运行的管控。 Revolut把更便宜的推理与沙箱(sandbox)、审批规则和详细日志配在一起;大会页面写道,自建让银行对更低的推理成本、沙箱规则和遥测(也就是详细日志)一并负责。
- 对营销团队,我的建议是先用托管模型。 没有来源测试过这一点,文末的那些问题就是我检验它的办法。
Revolut报告了什么,谁说了什么
下面的一切都能追溯到三类来源。第一类是演讲本身,我是通过AI Engineer大会对它的书面摘要(下文称大会页面)和演讲文字记录读到的。第二类是转述它的新闻报道,主要是The Register和Red Hot Cyber。
第三类是我对他们的数字做的算术。我把这三类分开,是因为每一次转述都把说法改动了一点,而演讲本身是一家公司在描述自己的部署。文中引用的英文原话,都是我自己翻译的。
先说四个术语,因为表格里要用到:
- token(词元): 模型读写的最小文字单位,常常是一个短词,或者长词的一部分。
- 综合成本(blended cost): 对输入和输出的全部内容算出的一个平均价格。
- 首个token(first token): 回答中最先出现在屏幕上的那一小段。
- 编码时间与交付周期(coding time、lead time): 前者是工程师写代码花的小时数,后者是从接手一个功能到它可以部署的天数。
| 项目 | 数字 | 来源 |
|---|---|---|
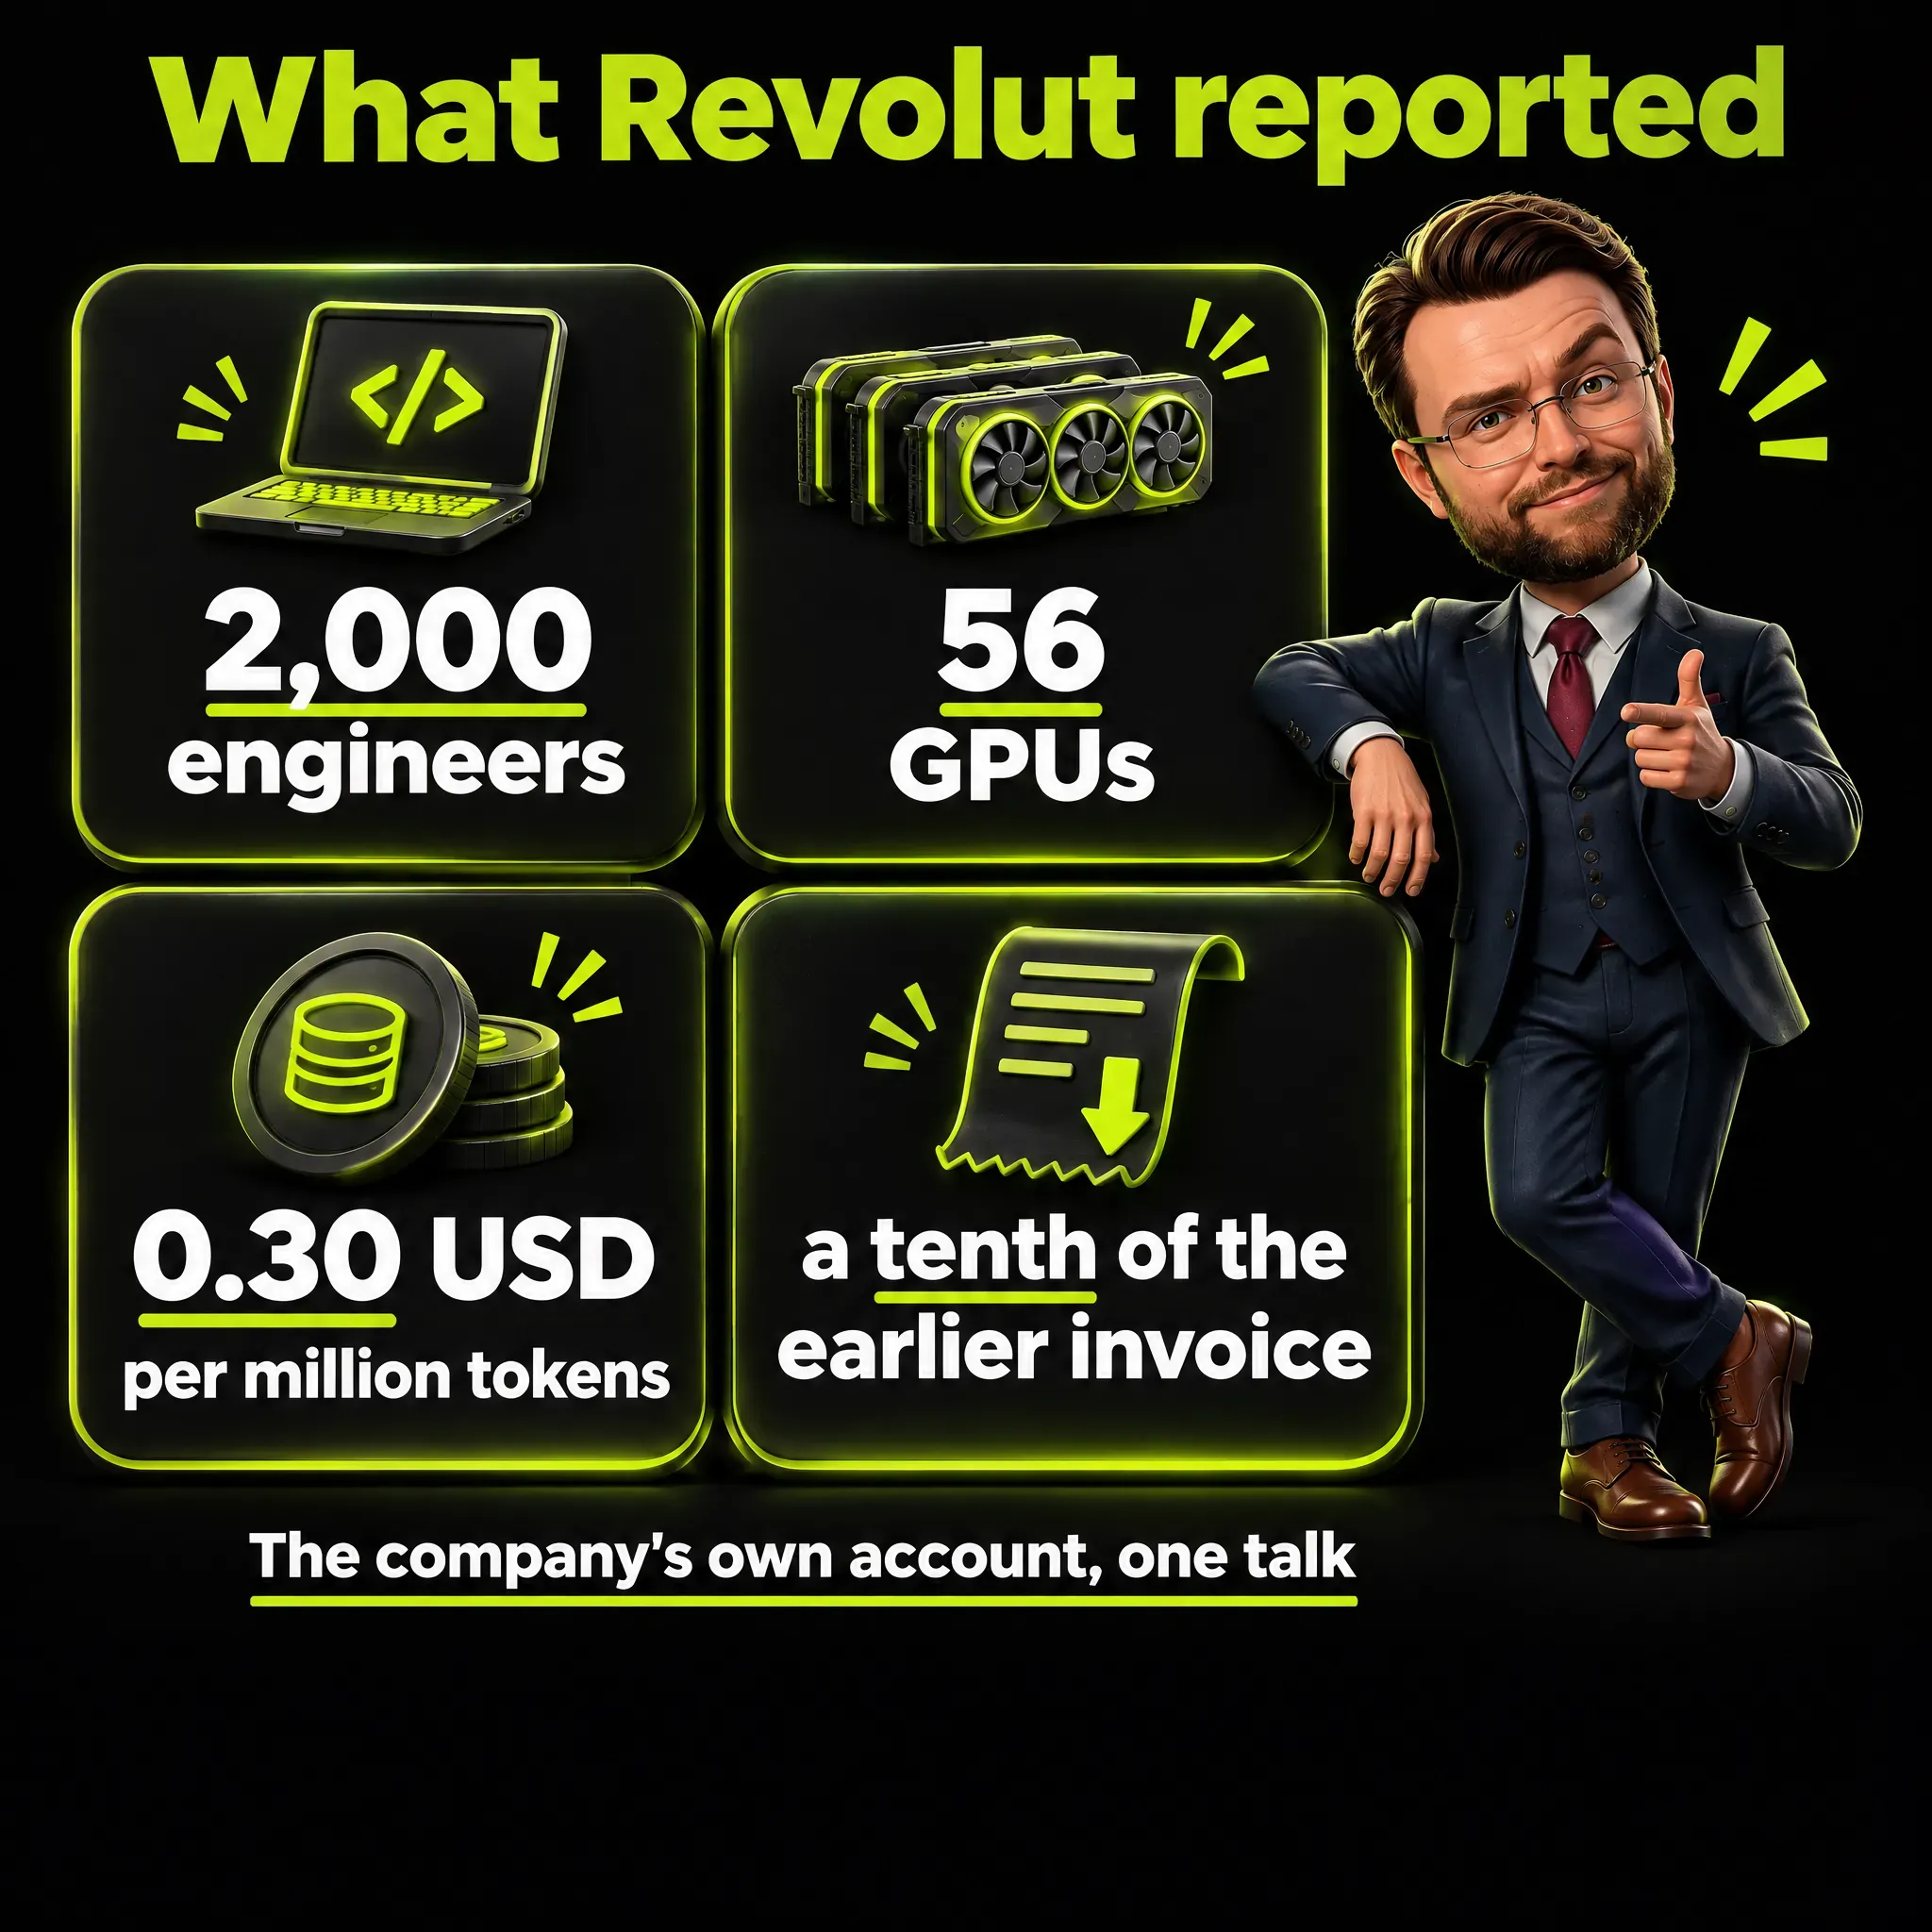
| 使用者 | 约2,000名工程师 | 演讲 |
| 硬件 | 56块Nvidia B200 GPU运行GLM-5.3 | 演讲,The Register |
| 每个token的成本 | 综合成本约为每百万token 0.30美元 | 演讲(大会页面) |
| 支出 | 约为先前Anthropic和OpenAI账单的十分之一 | 演讲(大会页面) |
| 对工作的影响 | 编码时间改善约60%,交付周期改善70% | 演讲,附一项说明 |
| 等待回答的时间 | 同样的GPU上,首个token从14.26秒降到1.68秒 | 大会页面描述的一张幻灯片 |
| 目标 | 首个token不超过3秒,每秒约200个token | 演讲 |
60%和70%的改善需要一项说明,大会页面自己就写了:“内部比较没有把模型的更换与其他原因区分开。”所以这张图展示的是推出过程中的几个月里Revolut发生了什么,而不是模型本身起了什么作用。Red Hot Cyber点出了其他因素之一:取消了token限额。
演讲给出的每百万token 0.30美元,对应的是“GLM”,没有写明版本,而The Register把它与先前的GLM-5.1部署联系在一起,所以我不会把这个数字挂在某一个模型名下。据Abitbol说,Revolut有8000万客户,但这里的工作负载只涉及约2,000名工程师。
三种说法,一个数字
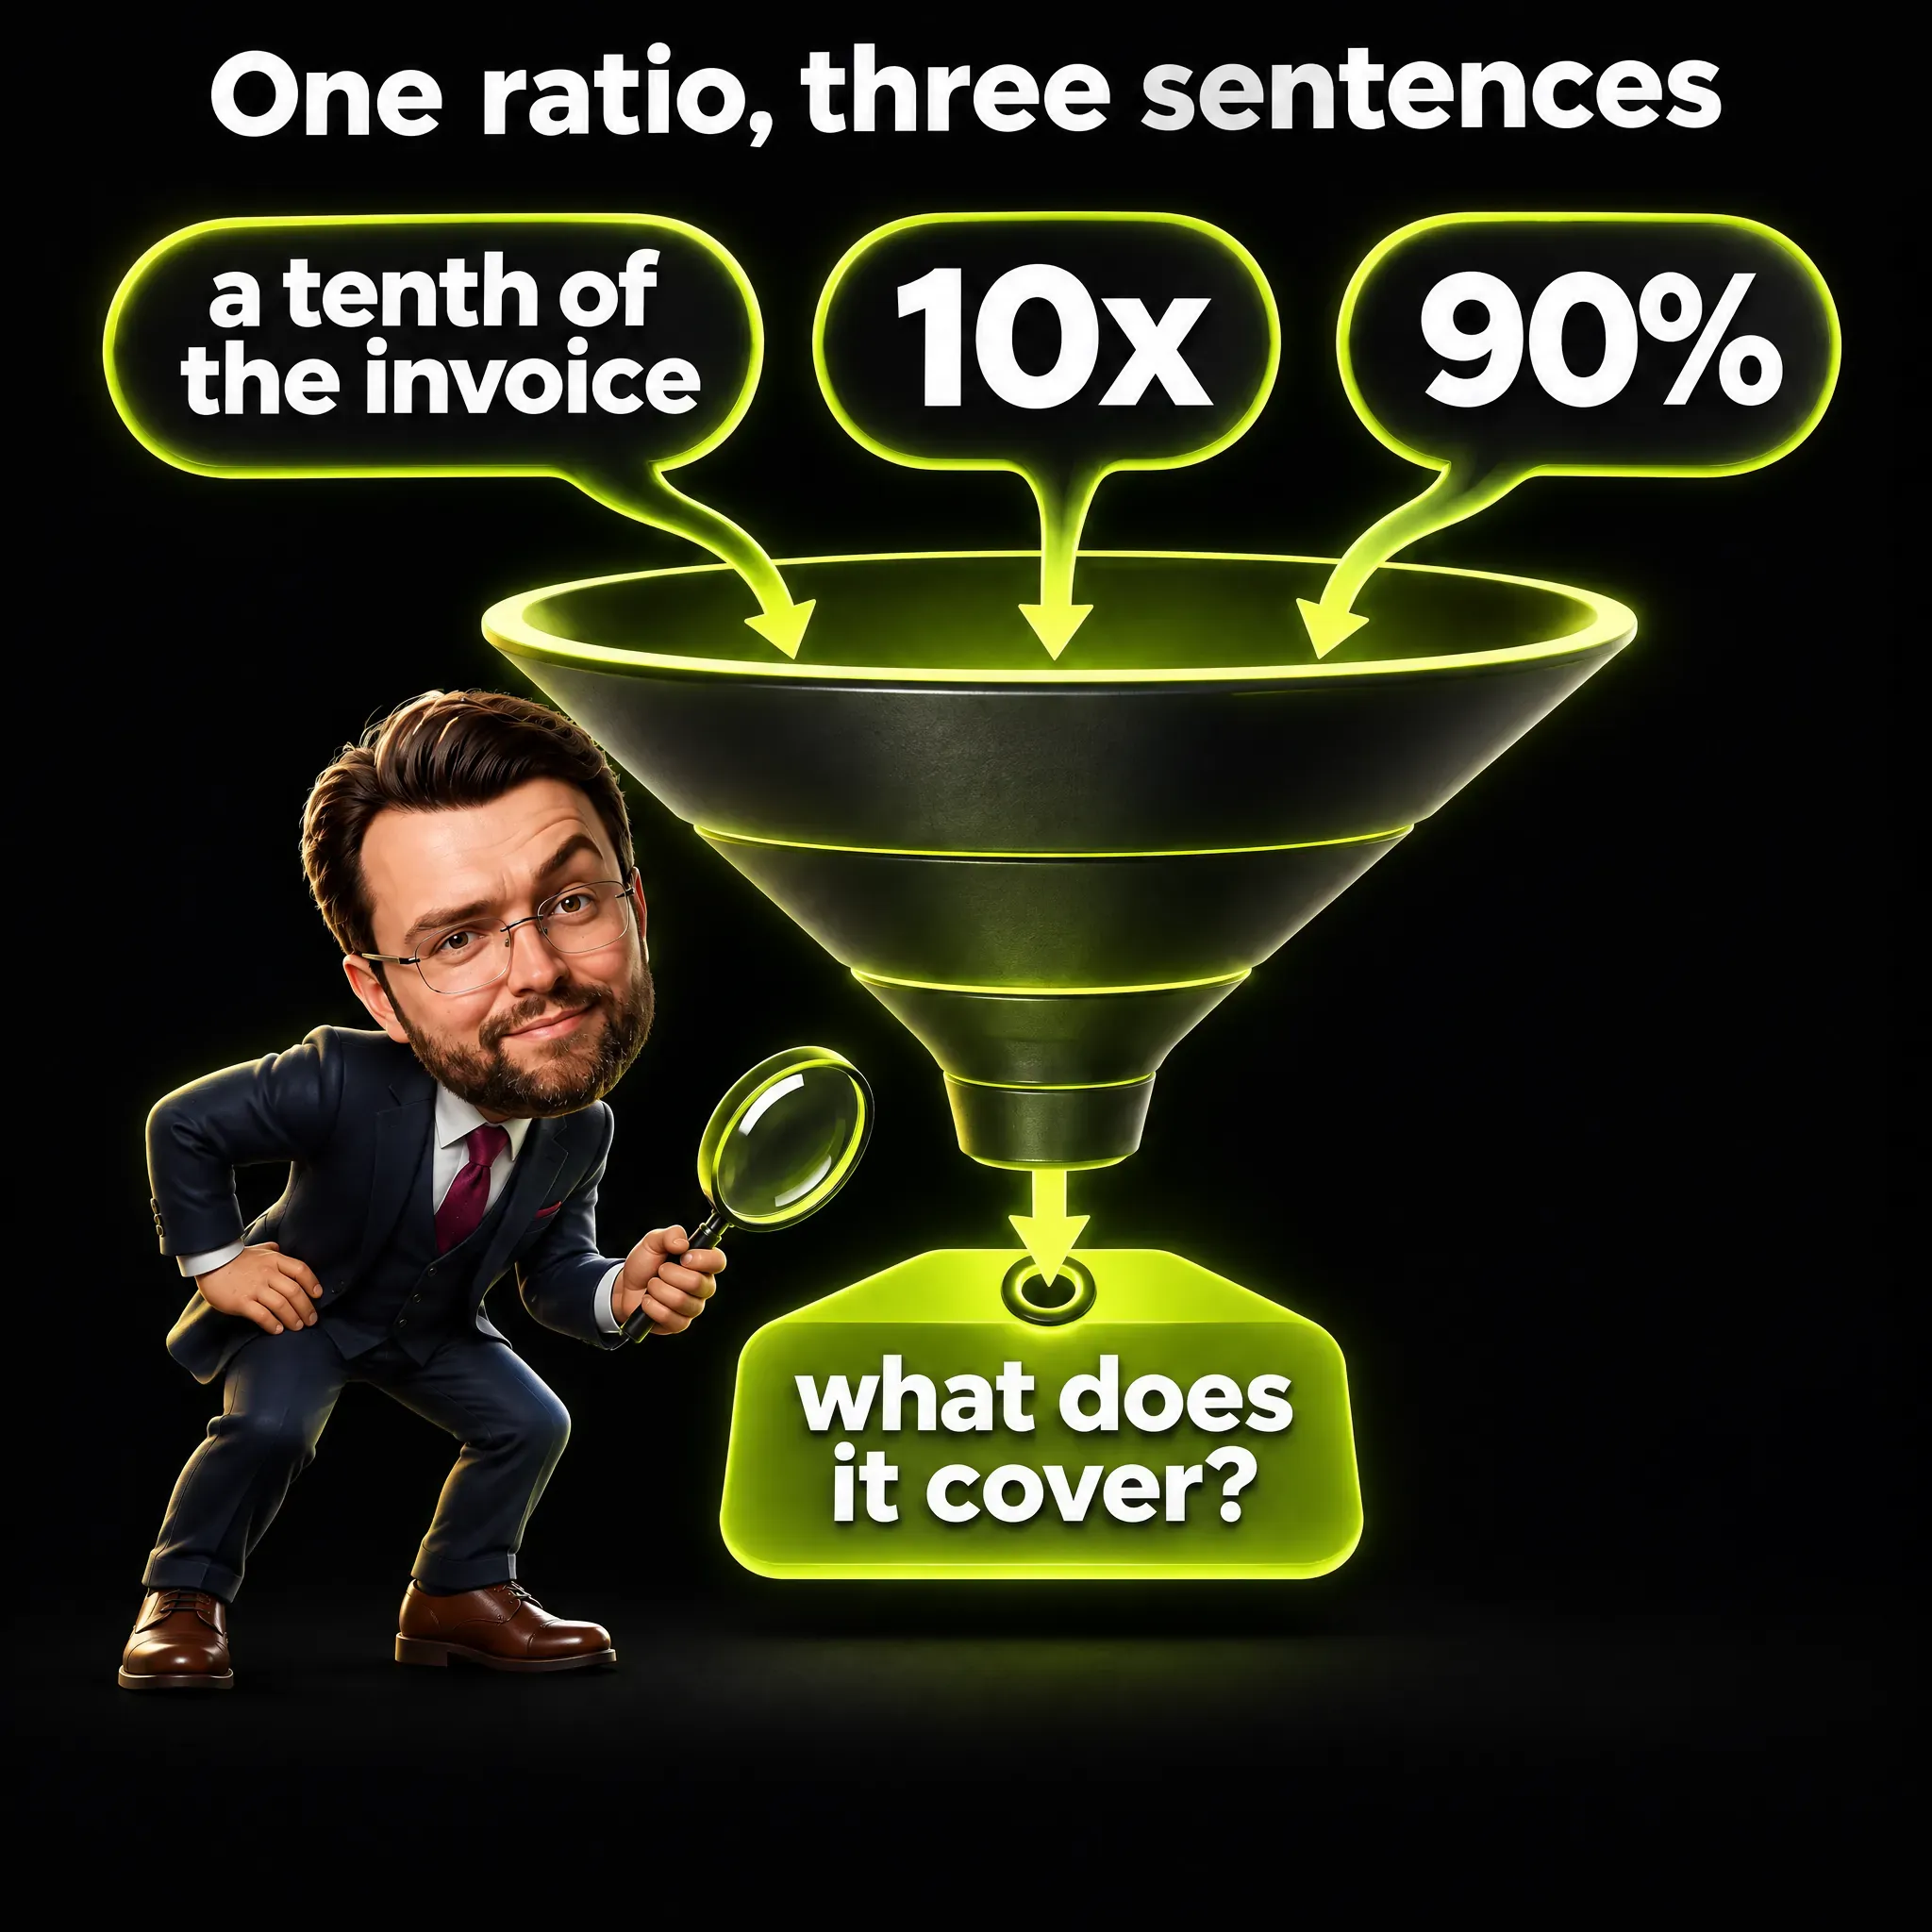
同一道算术得出了三种不同的说法,它们并不是都适合原样转述。“便宜10倍”和“少了90%”是同一个比率,区别在于这个比率被说成涵盖了哪些东西。
第一种是Abitbol自己的说法,大会页面是这样概括的:Revolut的支出约为先前Anthropic和OpenAI账单的十分之一。这比较的是一家公司先前付给厂商的钱,与它现在为同一类工作付出的钱,这类工作就是约2,000名工程师的编码。
Abitbol还说,Revolut刚推出Claude Code时,有些工程师“每月1,000,每月10,000,投资回报(ROI)却不怎么样”,按The Register刊出的引文,单位是美元,所以公司推出时设了“严格的预算限制”。因此,先前的账单对应的是受限的使用,现在的账单对应的是工程师不必盯着计费表就能做的使用,比较的是两种工作方式。
第二种是The Register的标题,称Revolut把AI编程成本砍掉了10倍,办法是“撇开Claude,转向自建”。正文在某些地方更谨慎:它写道GLM“并没有完全取代GPT或Claude”,还引用了Abitbol的话:“前沿模型是例外。”这里的前沿模型(frontier),指大厂最强的那批模型,大会页面也说,这类服务仍然可以用于例外情况。
正文对比率的表述也与演讲不同。它写道,按每百万输入和输出token 0.30美元计算,自建GLM-5.1的成本约为使用Codex或Claude Code的十分之一,这两个是OpenAI和Anthropic的编程智能体(agent,能自己调用工具完成任务的程序)。我的理解是,这是拿每个token的成本去对比一款产品,与两张账单的比较不是一回事。
第三种来自Red Hot Cyber,它用90%做了标题,随后又加了限定。它写道:“这90%的节省不含云、人员和监控成本,并且取决于细致的优化。”它还补充说,规模较小的公司“没有Revolut那样的规模和基础设施团队”,未必能得到同样的结果。
数字的来源:Revolut在演讲中,拿先前的账单与当前的支出做的比较。它的含义:对那项工作负载,在那个规模和那样的调优下,AI编程的账单约为原来的十分之一。带来的变化:这个数字只说明一张账单缩小了多少,并没有说明整个运营的总成本缩小了多少。
大会页面、文字记录和The Register里,我都没有找到云、人员或监控成本的细目。Red Hot Cyber陈述了这项排除,同样没有给出数字;而演讲自己的措辞,“我们的账单”和“你可以在那里拿到你的GPU”,也没有说明这十分之一是否已经包含租用GPU的账单。我把这项排除当作Red Hot Cyber的说法,同时也当作这个数字的一个局限。
为什么不看构成,就没法比较token价格
Z.ai的标价表说明了,为什么一个综合数字需要看它的构成。以美元每百万token计,GLM-5.3的输入是1.40,缓存输入是0.26,输出是4.40。缓存输入指系统已经处理过的文字,按较低的费率计费。
编码智能体每一步都会把大量相同的文字再发一遍,所以缓存输入在它们的流量里占大头。Z.ai面向编程工具的订阅Coding Plan,其页面假设缓存命中率为95%,也就是每100个输入token里有95个是已经处理过的文字。基于这两个来源做一道算术:0.95 × 0.26 + 0.05 × 1.40,按标价约为每百万输入token 0.32美元。
这和Revolut综合的0.30很接近,但我不据此下任何结论。来源没有给出Revolut在输入、缓存输入和输出上的构成,而按Z.ai的标价,输出token每百万要4.40美元。Abitbol确实对听众说过,编码工作负载的缓存命中率“需要高于90%”,而0.30的综合数字可以由许多不同的构成得出。
有人给出自建方案的每百万token成本时,我会问三件事:它涵盖输入、输出还是两者,输入里有多大比例来自缓存,以及它是否只算了GPU。这几个问题没有答案,这个数字就无法与厂商的价格表相比,这也是我把Revolut的比较读作两张账单之间的比较的原因。
完整价格表在我的中国AI大模型企业使用指南里。至于模型成本在团队其他工具中处于什么位置,我用的是我的2026年营销技术栈一文里的框架。
为什么每个token的价格取决于机器有多忙
Abitbol的演讲讲的是“在专用GPU上自建开源模型”,意思是机器专门留给Revolut自己使用。我的理解是,留给自己的机器,无论回答一个请求还是一千个请求,花的钱都一样。所以每个token的价格,就是固定的账单除以机器处理的token数量。
举一个虚构的例子,数字取整,不是Revolut的:假设机器每月花100个单位。如果它们处理1亿个token,每一百万token花1个单位。如果调优后同样的机器能处理5亿个,每一百万就花0.2个单位,而账单一分没变。
Revolut并没有这样表述它的节省,但它的调优图表符合这个机制。Abitbol提醒说,把权重加载到GPU上就开始推理(模型回答请求的那一步),不做调优的话会得到“糟糕的性能”。团队按自己的实际需求调优了服务系统,他们的图表显示,从4月到8月GPU数量保持不变。
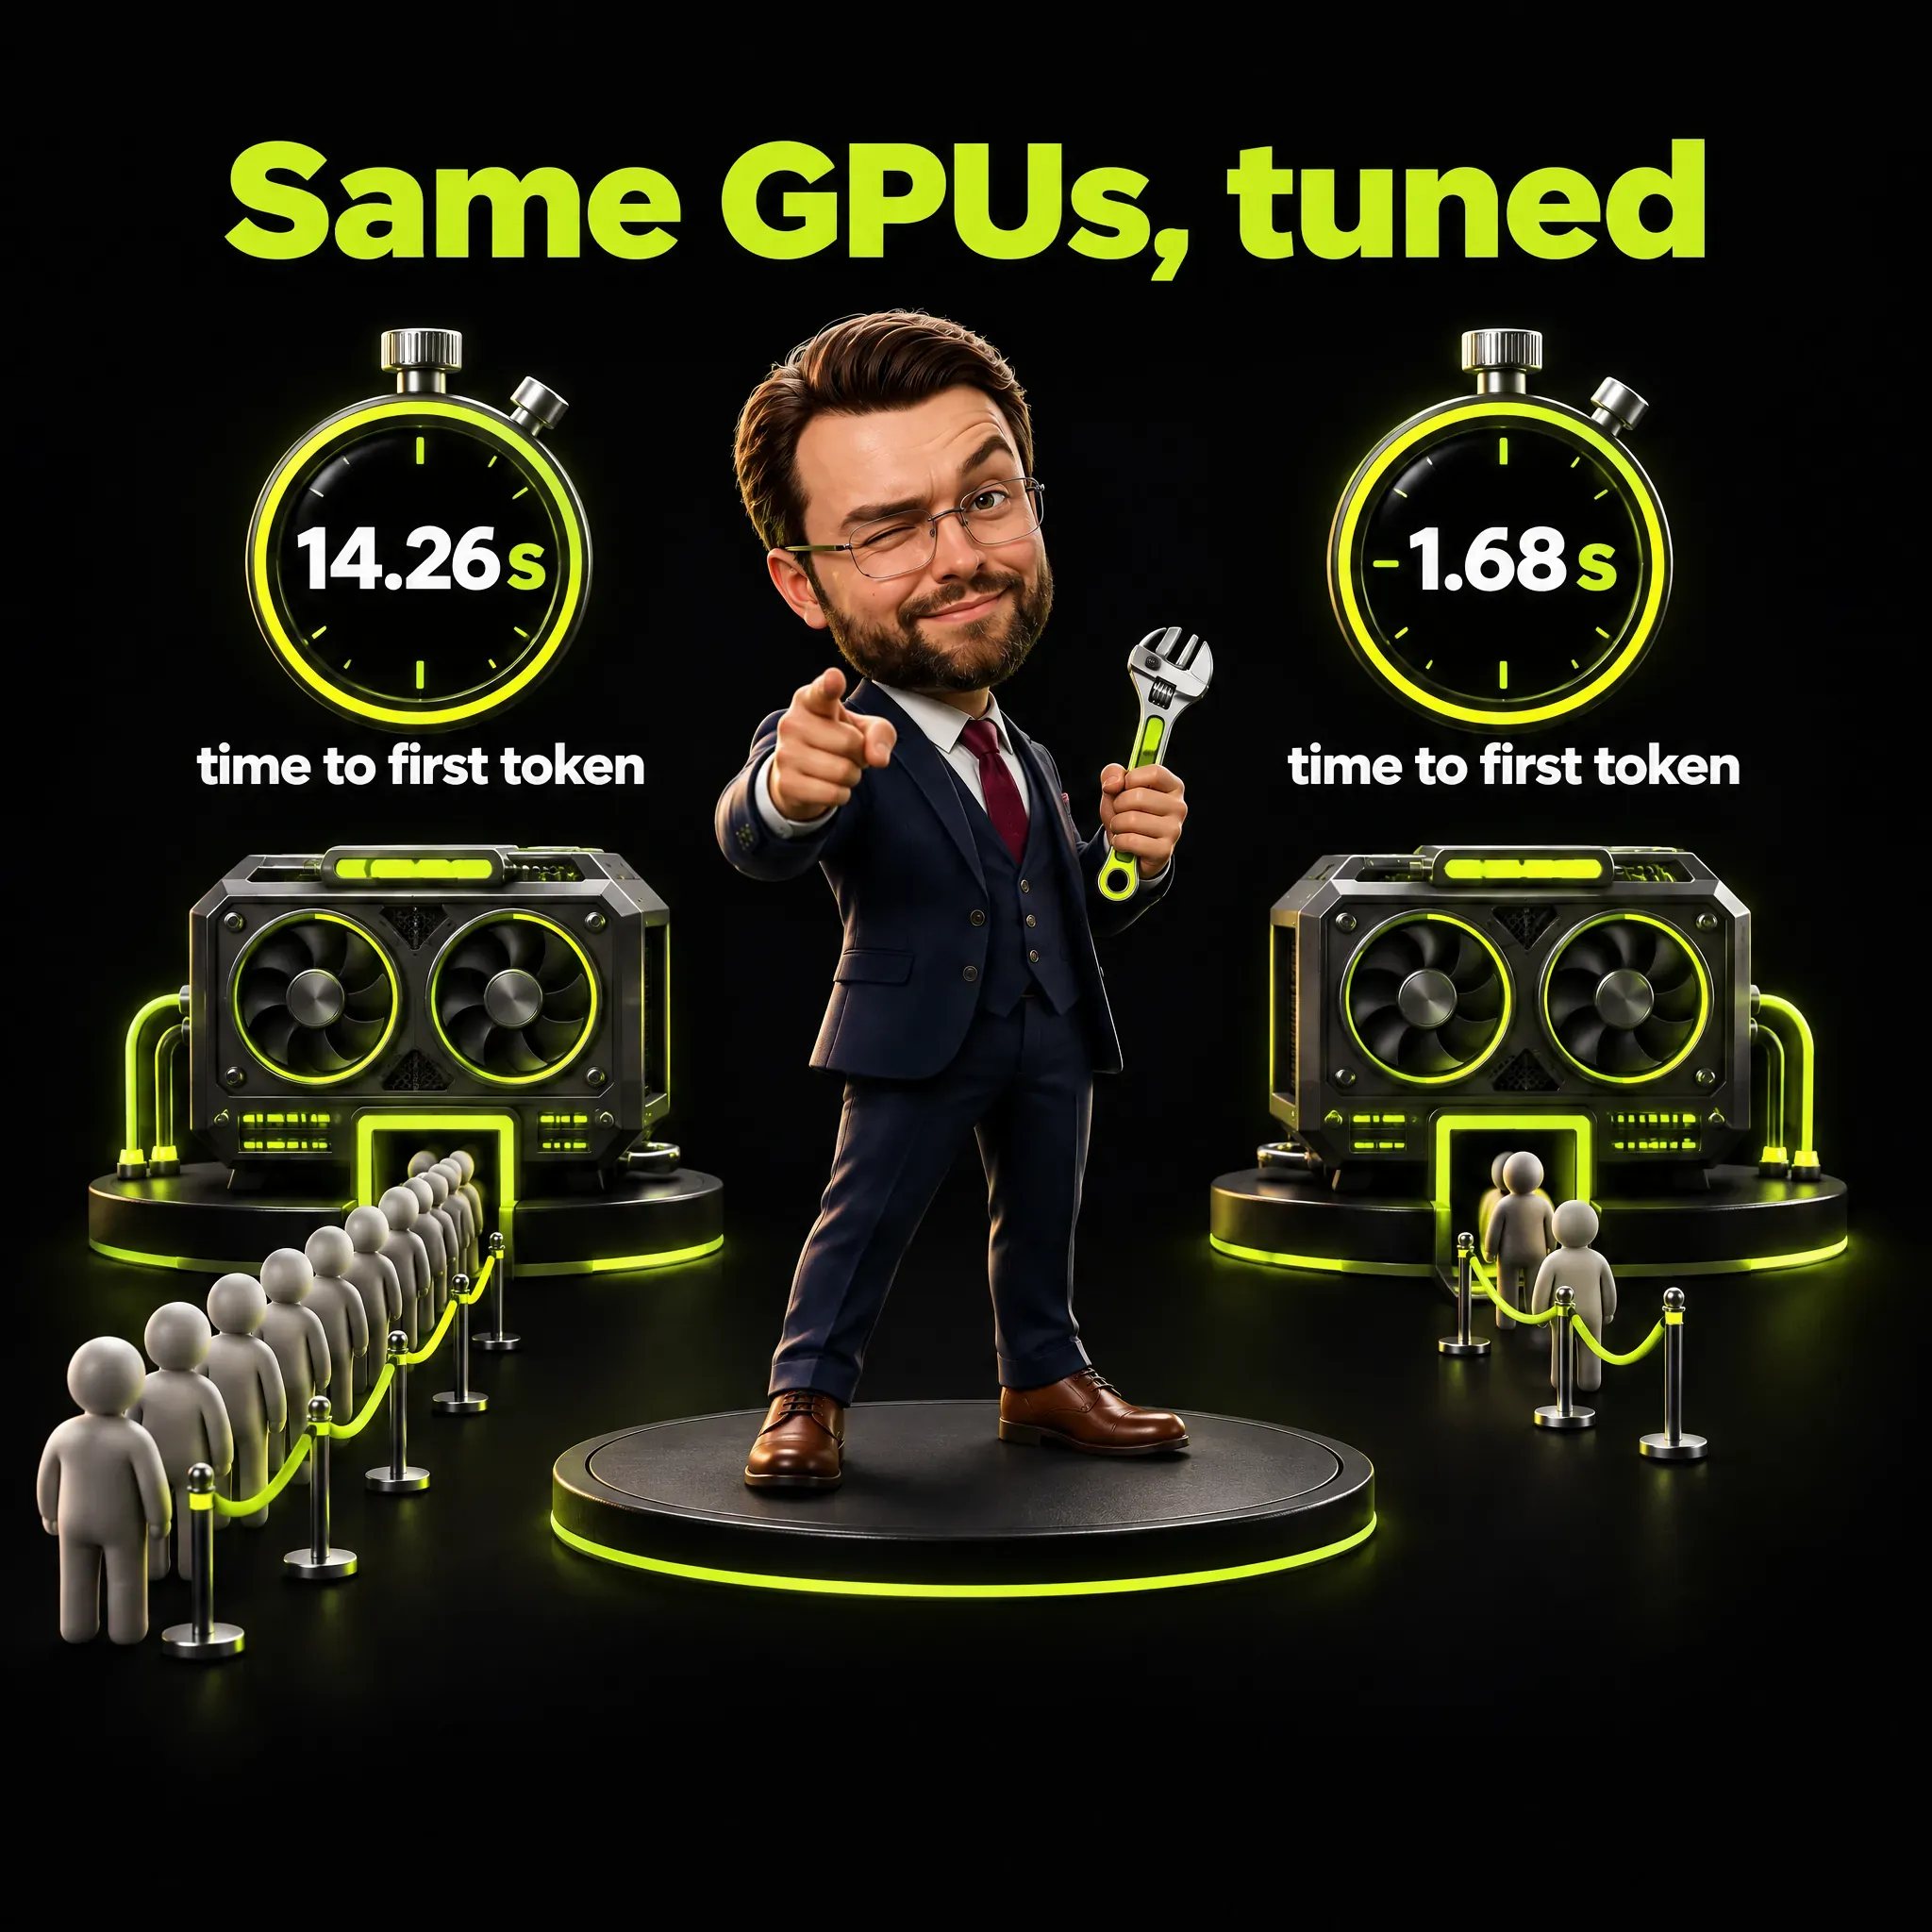
大会页面描述的这张幻灯片显示,每秒请求数提高了76%,首token时间缩短了88%,从迁移期间的14.26秒降到稳定配置下的1.68秒。首token时间(time to first token)指从发出请求到看到回答第一个词之间的等待。按我的算术,等待时间缩短了约8.5倍。
Abitbol的目标很具体。他要的是“首token时间在3秒以内”,并说“一旦超过5秒,我的Slack收件箱就开始爆炸”。他的建议是“抵制扩容”,意思是先调优现有的GPU,再考虑买更多。
Abitbol说,下午5点以后接入的工程师,每秒能拿到800个token,而大会页面认为交互式工作每秒200个就够用。我的理解是,晚上需求少,同样的机器回答得更快,而晚上闲置的算力反正是要付钱的。对只有少数几个用户的团队来说,同样的固定账单要摊到少得多的token上。
运行一个这样的模型需要什么,用大白话说
GLM这个级别的模型需要数据中心的硬件。The Register报道,GLM-5.1约有7540亿个参数,每生成一个token会激活其中的400亿个,并且需要约380 GB的GPU内存来装下它的权重。参数是模型在训练中学到的那些数字,权重是存放这些数字的文件。
每位用户打开的对话还要在此之外占用内存。The Register给出的数字是每位用户再加6到26 GB,取决于精度。Hugging Face是发布这类模型的公共库,GLM-5.3在它上面的页面列出的是7530亿个参数,这是我用于当前模型的数字。
演讲和The Register描述的决策有这些,我按非工程师能跟上的顺序排列:
- 上下文大小。 上下文窗口(context window)是模型一次能放在眼前的文字量,它要和其他用户的请求争夺GPU内存。Abitbol说“长上下文是个骗局”:模型能处理100万个token,但他的工程师需要的是256,000个。
- 更紧凑地存放权重。 量化(quantization)指用更少的位数存放这些数字以节省内存,Revolut在它的B200 GPU(Nvidia当前的数据中心芯片)上偏好4位格式。
- 把模型分摊到多块GPU上。 大会页面指出,把权重分摊到四块GPU上,可能让已处理文字的缓存没有足够的内存,所以八路拆分的表现可能更好。
- 把部分工作交给别处。 Revolut用于编程的GLM模型只处理文字,所以它用了一个路由器(router),把图片请求发给Gemini或GPT Luna,代码生成则留在GLM上。
每个token的价格把这些关于内存、速度和路由的选择都藏起来了。自建模型的成本包括做出这些选择的能力,而且Revolut对模型做不了的工作,仍然在向厂商付费。
没人公布的成本
这里是我在把自建方案与厂商价格相比之前,希望填上的每一行成本。“无数据”表示我读过的任何来源里都没有数字,而我没有用估算去填这个空白。
| 成本项 | 来源怎么说 | 数字 |
|---|---|---|
| 买来或租来的GPU | 56块B200 GPU运行GLM-5.3 | 无数据 |
| 云 | Red Hot Cyber称这90%不含云成本 | 无数据 |
| 运行它的人 | Red Hot Cyber称这90%不含人员;规模较小的公司可能没有基础设施团队 | 无数据 |
| 监控与日志 | Red Hot Cyber称这90%不含监控;Abitbol要求用详细的遥测来调查事件 | 无数据 |
| 调优时间 | 图表跨越4月到8月,用的是同样的GPU | 工时无数据 |
| 留给例外情况的厂商 | 前沿服务仍然可用;图片请求交给Gemini或GPT Luna | 无数据 |
| 从一个模型迁移到下一个 | Revolut从GLM-5.1迁移到GLM-5.3 | 无数据 |
有一点仍然悬而未决。Red Hot Cyber把这些机器描述为Revolut在美国的自有基础设施,而Abitbol在他列出的国家里说“你可以在那里拿到你的GPU”,还提到默认不保留数据副本的GPU服务商,他称之为“零数据留存”(zero data retention)。我无法从这些来源判断GPU是买的还是租的,而答案会改变账单的形状。
我的建议是把这张表当作一份待填的表单。有人对你说节省了90%,就请他把每一行按自己的情况填上,或者说明这个数字漏掉了哪几行。经得起这番检验的节省,我才会写进预算。
至于发票之后才出现的成本,也就是检查输出的那个人的时间,我在Claude价格与模型对比里比较了Claude的两个档位。那里的方法,即盲测20个真实样本,对托管的GLM模型同样适用。
更便宜的token改变了人们怎么工作
对我来说,演讲里最有用的部分讲的是行为。大会页面描述了token限额之下发生的事:token显得稀缺时,工程师把它们留给一项困难的编码任务,而不会用在周围的其他工作上。Revolut的答案是一笔固定的成本,让工程师可以把更多事情交出去。
Abitbol自己的解释是,工程中的延误包括收件箱、Jira和Confluence,也就是代码周围的项目跟踪与文档工具。按他的说法,用起来更便宜,扩大了人们愿意交给模型的任务范围。The Register引用了他谈调试和工单工作的话:“有了无限的token,你就可以放手去做。”
这就让60%和70%的数字难以解读。改善的一部分可能来自模型,一部分来自工程师把AI用在更多种类的工作上,而大会页面说这个比较并没有把两者分开。我既不把功劳单独记给模型,也不单独记给自建。
对我自己的领域,我只能给出一个情景,而且是虚构的。设想一个营销团队给AI智能体限量,因为每个长任务都要花真钱,于是只让智能体做月度报告,日常的打标签和检查仍靠手工。如果账单是固定的,同一个团队也许会把这些小活也交出去。
没有来源为营销衡量过这一点。机器总要有人付钱,只有当智能体多做的工作,在有人检查之后好到值得留下时,收益才会显现。
数据去哪里,以及演讲没有说清的地方
大会页面说了一个直截了当的观点:下载权重并在公司自己选定的基础设施上运行,与把请求发给模型开发者的托管服务,是两条不同的数据路径。对此,Abitbol说,对中国模型的隐私担忧,针对的是调用位于中国的专用端点,而把权重拿来放在“美国本土的服务”上,则是另一回事。The Register把他的看法概括为:本地部署(on-premises,也就是公司自己的服务器),或同一地区的云服务商,没有多少可担心的,这是记者的措辞,不是Abitbol的引语。
他还补充说,数据只要留在文字记录里写作“data equivalency framework”(数据等效框架)的那些国家,也就是他列出的美国、欧盟、英国和以色列,就没有问题,并且推理和GPU服务商“默认零数据留存”。我读过的来源里,没有一个核实过关于服务商的这个说法。这些是他谈Revolut的话,而Revolut是一家银行,大会页面说它们“不应被解读为一般性的结论,即某个模型、地区或沙箱会自动满足另一家机构的义务”。
至于模型厂商自己的API(程序调用接口),Z.ai的隐私政策称其服务一般从新加坡提供,它的API附加协议里有一条不存储条款。这两点都是Z.ai自己的说法,没有第三方核实过。两份文件,我在中国AI大模型那篇文章的数据一节里逐一讲过。
我不是律师,这也不是法律意见。如果客户名单或销售线索导出文件这类个人数据要送进任何模型,我会先向数据保护顾问提三个问题:哪个国家,在什么合同之下,保留多久。
模型周围的管控
Abitbol的结束语讲的是模型周围的管控。Revolut设置了沙箱,也就是编码智能体运行所在的一块围起来的区域,同时对公司不想放行的操作设置审批规则。他举的例子是“你可以允许grep,但不允许gradle”:规则可以让智能体在文件里搜索,同时禁止它运行构建工具。
他说这些编码任务不被当作自主运行的智能体,因为“它们始终有人在回路中”,并称沙箱在这一点上让监管机构放心。他还说,沙箱能防范公司内部人员的滥用。最后一项要求是遥测(telemetry),也就是详细日志,好让团队能在整个系统里追溯一次事件。
关于提示词注入(prompt injection,即藏在文档或网页里的文字试图给智能体下新命令的攻击),Abitbol的评论很短:“如今没那么回事了,毕竟模型这么聪明,但它始终是个问题。”这是他在演讲中的看法,而在那一段里,他没有引用任何测试来支持它。
大会页面列出更低的推理成本、沙箱规则和遥测,并以“自建让Revolut对这三者都负责”收尾。
开放权重(厂商公布、任何人都可以下载的模型文件)还带来另一项责任。这类模型内置的拒答机制就存在这些文件里,Anthropic关于GLM-5.3的报告描述了用我在abliteration是什么里讲解的技术把它们去掉的过程。行业安全组织云安全联盟(Cloud Security Alliance)转述了Anthropic的数字,并建议把模型权重当作敏感资产对待。
一个从不自建模型的营销团队,只要智能体能在它的账号上执行操作,也同样需要沙箱、审批规则和日志。审批这一步,我在人在回路的AI验证里讲过,更广泛的风险则在我关于AI智能体安全的文章里。
自建大模型之前要问的问题
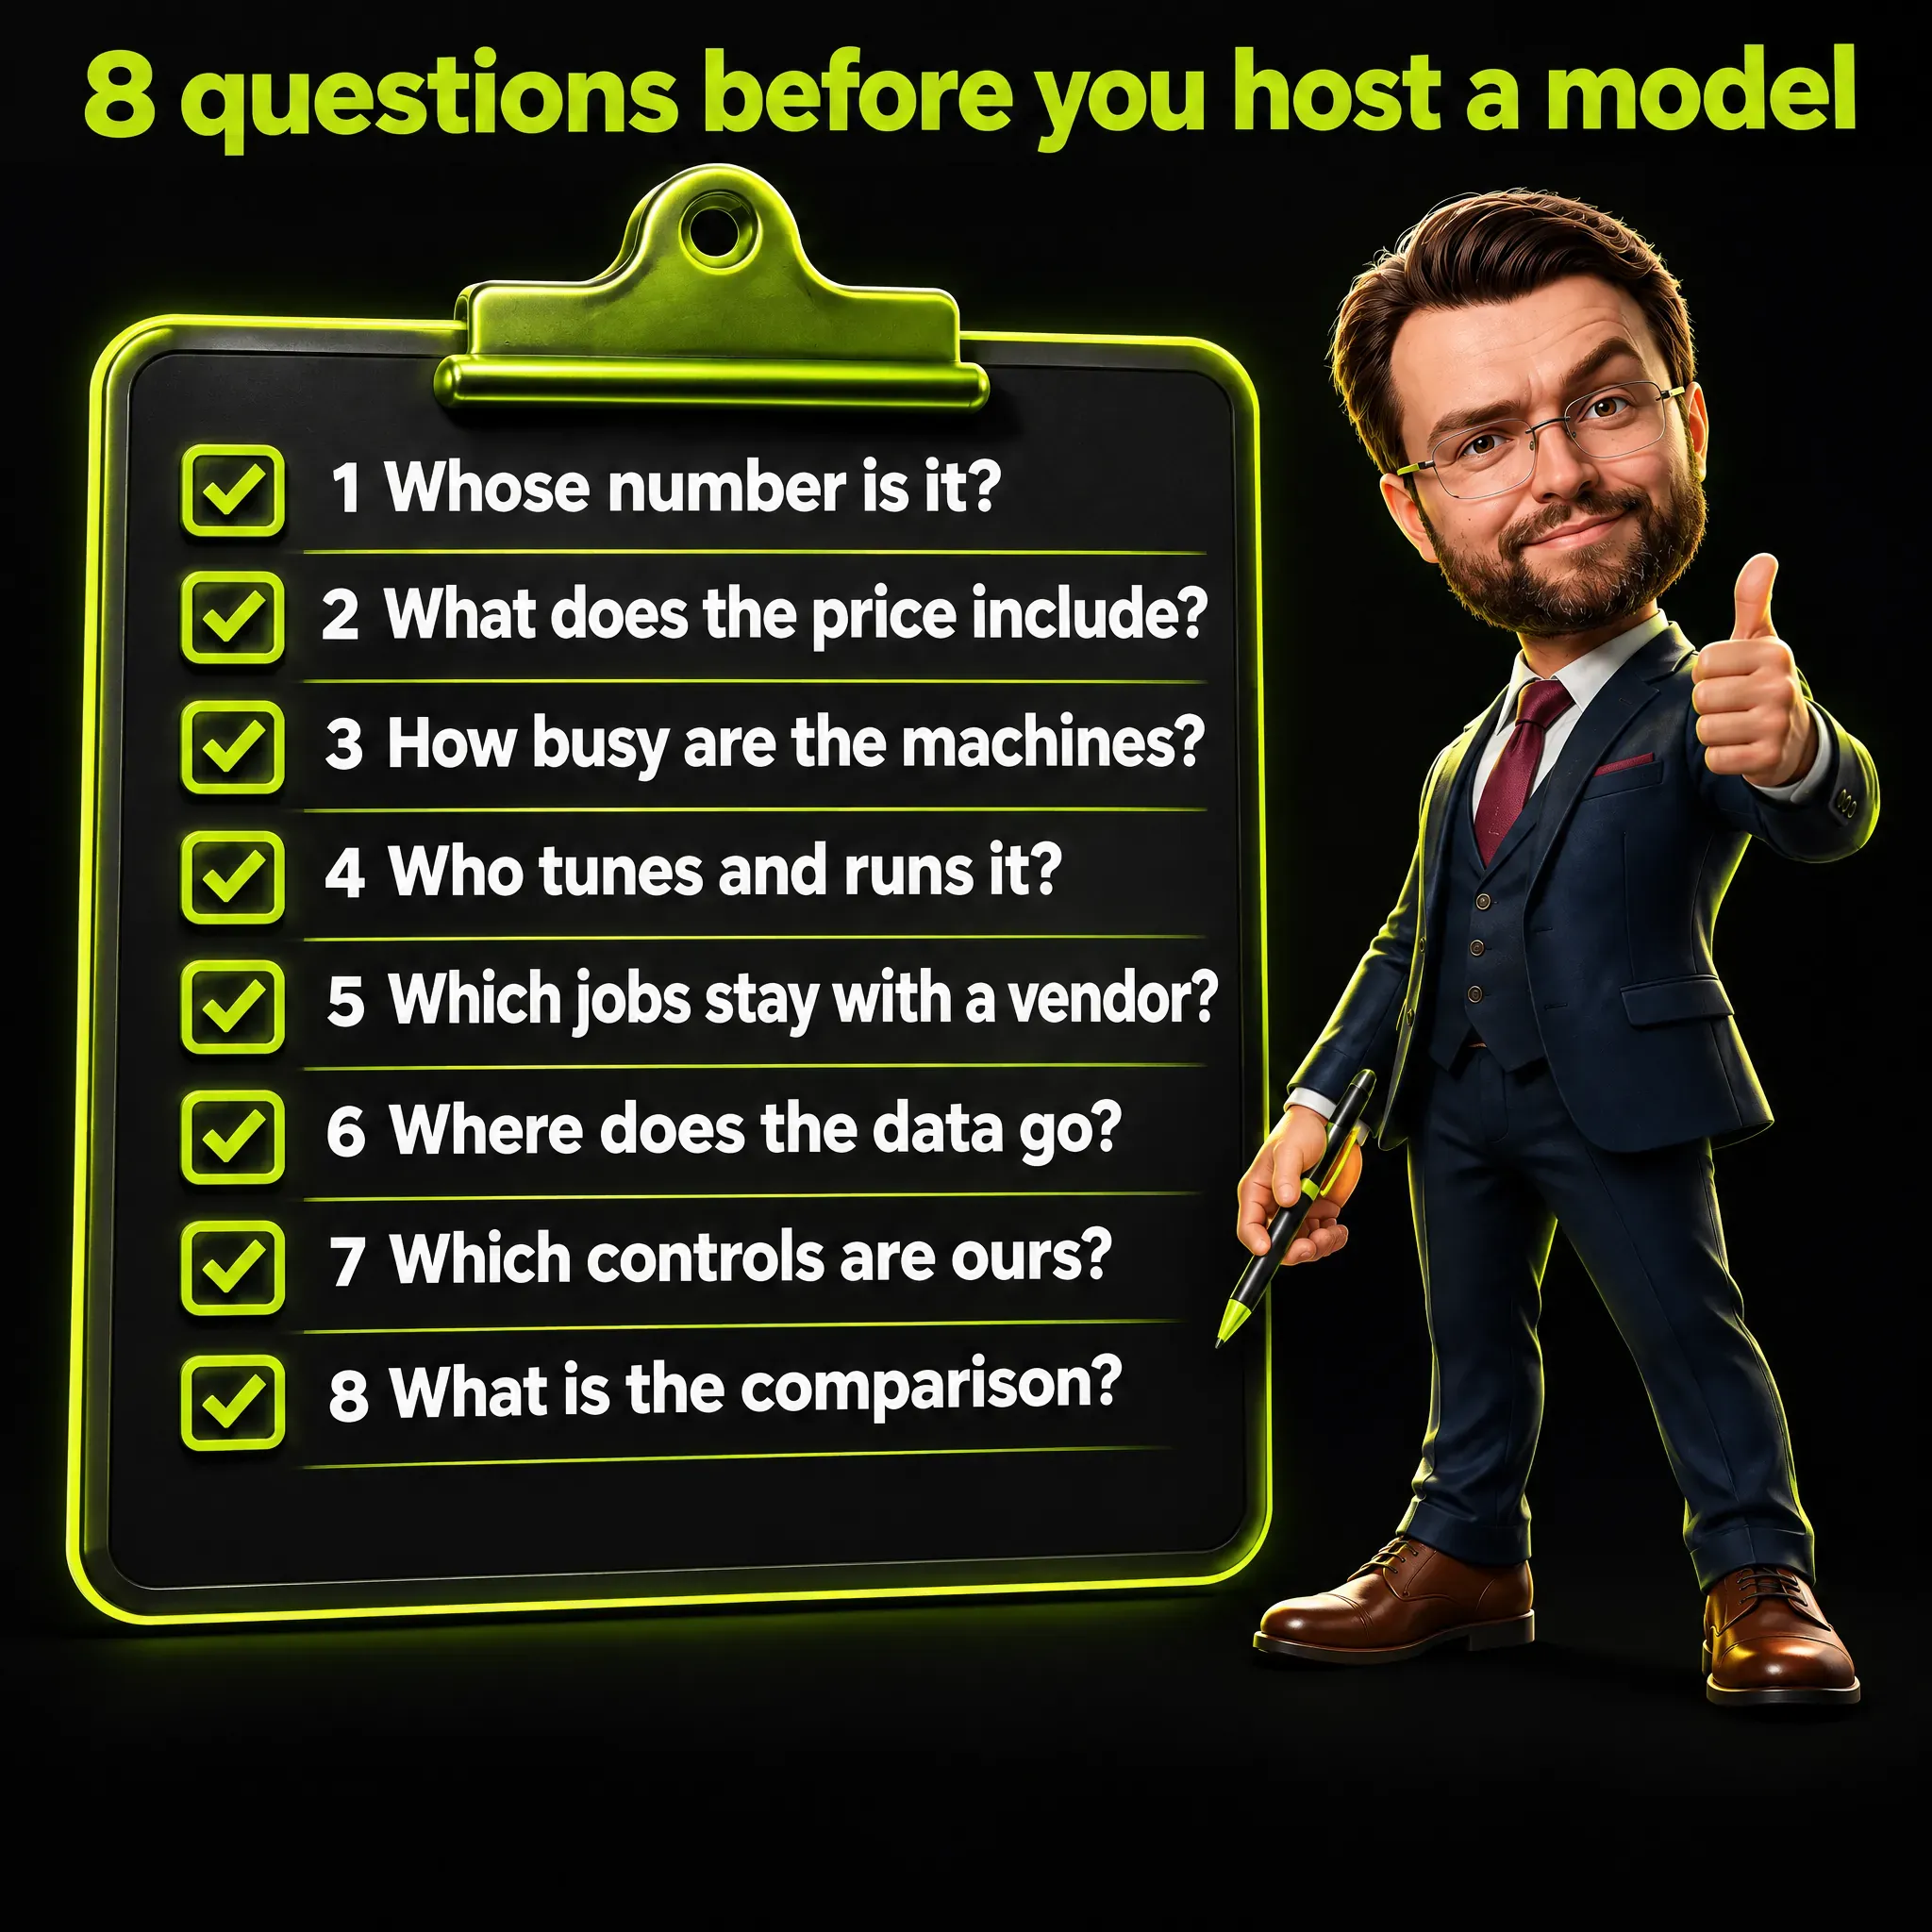
我把上面各节整理成了八个问题。它们是我自己的清单,不论说法出自会议演讲还是厂商的幻灯片,都适用。
| 问题 | 我希望看到什么 |
|---|---|
| 这是谁的数字? | 节省的来源、期间,以及它涵盖的工作负载 |
| “每个token的成本”包括什么? | 输入、输出还是两者,缓存命中率,以及是否只算了GPU |
| 机器会有多忙? | 预期的用户和请求量,因为用得越多,每个token的价格越低 |
| 谁来调优、谁来运行? | 一个有名有姓的团队及其工时,因为Revolut的调优图表跨越了4月到8月 |
| 哪些工作仍留给厂商? | 一份任务清单,比如仍需要另一个模型的图片请求 |
| 数据去哪里? | 国家、合同和保留期限,拿去问数据保护顾问 |
| 哪些管控由我们负责? | 沙箱、审批规则、日志,以及一位负责权重的人 |
| 比较的对象是什么? | 同一项任务上的托管模型,用20个真实样本盲测评判 |
如果答案含糊,我就把这笔节省当作假设。如果答案具体而且规模很大,自建就成为一个认真的选项。对小团队来说,我从Revolut的数字推断,障碍是固定的账单和对基础设施团队的需求。
常见问题
什么是自建大模型?
它是公司在自己拥有或租用的机器上运行的大语言模型,而不是调用厂商的托管服务。模型文件必须可以下载,所以自建通常指的是开放权重模型,也就是厂商公布这些文件的模型。
自建大模型要花多少钱?
我读过的来源没有一个给出可以照搬的价格。Revolut报告的综合成本约为每百万token 0.30美元,支出约为先前账单的十分之一,用56块B200 GPU服务约2,000名工程师。云、人员和监控的成本没有公布。
自建比付API(程序调用接口)费用更便宜吗?
对Revolut来说,按它自己的说法是的。总的来说我无法判断,因为答案取决于用量、机器有多忙以及运行它们的人的成本,而我找到的来源只描述了一个案例。
能在自己的电脑上运行大模型吗?
这个级别的不行。GLM-5.3按其Hugging Face页面有7530亿个参数,The Register把更早的GLM-5.1的权重定为约380 GB的GPU内存,远远超出一台笔记本电脑。
开放权重和自建有什么区别?
开放权重是指厂商公布模型文件。自建是指你在自己掌控的机器上运行它们。第三方也可以为你托管这些开放权重,这正是我那篇中国AI大模型文章里的第二条路线。
自建能保证我的数据隐私吗?
它改变的是数据走的路径,大会页面称之为与开发者托管服务不同的数据路径。它回答不了法律问题,还把保护措施和日志变成你自己的工作,所以我会把数据问题拿去问数据保护顾问。
我需要基础设施团队吗?
Red Hot Cyber称,规模较小、没有Revolut那样的体量和基础设施团队的公司,未必能得到同样的结果。这样的团队需要多大,来源里没有数据。
营销团队自建大模型值得吗?
这是我的看法,不是调查结论:我会先用托管模型,并过一遍上面的八个问题。托管的路线让账单保持可变,同时避开了机器,以及随机器而来的调优和管控。
我的看法
我从Revolut这个案例里学到的,是一种读任何节省数字的方法。节省90%的说法,应当和预算会议上的任何说法一样,受到同样的追问:这是谁的数字,哪个期间,里面有什么,漏掉了什么。最后一个问题,Red Hot Cyber的回答是云、人员和监控;演讲本身没有列出任何排除项,而这些成本也没有人公布过。
我也认真对待行为上的变化。如果账单不再限制AI的使用,人们就会把更多工作交给它,对生产率的影响可能和对账单的影响一样大。这一点对固定订阅和托管模型同样成立,不只对自己的GPU成立。
我会先用托管模型,用几个月衡量真实用量,再把上面那张成本表用你自己的数字填上。如果用量和团队让自建大模型有了理由,调优和管控就是该最先规划的部分。