Claude vs ChatGPT(2026年11月):没有通用赢家,用四个问题来选
Claude vs ChatGPT,截至2026年11月:入门价同为$20,在一个独立指数上头部分数只差3分。四个问题加一张工作地图,帮你分清事实和观点。

截至2026年11月,Claude vs ChatGPT没有通用的赢家。两家公司都说自己在自家测试里领先,而本文引用的唯一一个独立指数,把头部模型的差距定在3分。真正有用的答案取决于四件事:你的任务、你的文件和应用、你每天的用量,以及你的数据会被怎样处理。
大多数对比文章都会给你一张记分卡,每一行标出一个赢家。这种记分卡几周就过时。我写这篇文章的当天,OpenAI的官方页面给免费版写了两个不同的模型系列,Anthropic的页面也有自己对不上的地方。
我是一名营销工程师(Marketing Engineer):12岁开始接触数字世界,20岁起全面做营销。我在日常工作里两个工具都用,所以这篇指南把每个事实都链接到带日期的官方页面,每个观点都标明是我自己的。
要点先看
- 没有谁处处都赢。 在Artificial Analysis指数上,Claude的一个设置得65分,接下来四行都是62分,两家的模型都有。每家都在自己的测试里领先,而两张表比较的是不同的模型组合。
- 入门价一样。 截至2026年11月,按月付费时Claude Pro和ChatGPT Plus都是每月$20。
- 额度的算法不同。 Claude的聊天和编程共用一个额度池,ChatGPT则把Work和Codex共用的额度与Chat分开。
- 两家都可能用个人聊天记录训练模型。 两家都提供一个开关来控制,也都说在工作版套餐里默认不训练。
- 按工作来选,然后测试。 把同一个真实任务在两个工具上各跑三天,记下修改结果花了多长时间。
Claude和ChatGPT是什么(截至2026年11月)?
Claude是Anthropic做的AI助手,ChatGPT是OpenAI做的。两者都能回答问题、写东西、读文件、上网搜索。它们各自运行在一个模型家族上,模型就是生成答案的引擎,就像同一个品牌的两辆车可以装不同的发动机。
截至2026年11月,Anthropic模型概览列出了四个当前模型:Fable 5.2、Opus 5.5、Sonnet 5.5和Haiku 5.5。OpenAI把它的档位叫作Astra、Sol、Terra和Luna。2026年10月7日的ChatGPT更新说明写道:“Plus、Pro、Business和Enterprise使用GPT-6 Sol;Free和Go使用GPT-6 Luna。”
Astra负责Pro的推理功能。OpenAI关于模型的帮助页把Luna称为“GPT-5.6家族中最快、成本最低的模型”,但对GPT-6 Luna没有类似的说法。
这类名字变得很快,所以下面每个事实都带日期。每个页面我都是在2026年11月18日读的,建议你付钱之前先打开链接里的页面看一眼。
Claude比ChatGPT好吗?两家公司各自怎么说
没有人证明过Claude在所有工作上都比ChatGPT好,反过来也一样没被证明。每家公司都发布自己模型排第一的测试。本文引用的唯一一个独立指数,把领先者的差距定在3分,所以下面每一条说法,都请当作利益相关方的说法来看。
基准测试(benchmark)是一组固定任务,用来给模型打分,就像用统一考试给学生打分。Anthropic在2026年11月9日的Fable 5.2发布文章里附了一张基准测试结果表。在一个叫FrontierSWE v2的编程基准上,表里Fable 5.2是69.9%,GPT-6 Astra是65.5%。
同一张表也显示,发布方并不是每一行都赢。在AutomationBench这个测试业务流程的基准上,两家都不是的Gemini 4 Carbon得了53.9%。Fable 5.2是51.4%,GPT-6 Astra是41.4%。
OpenAI在2026年11月17日的GPT-6.2发布文章给出了相反的说法。在一个叫Agents’ Last Exam的基准上,它说GPT-6.2 Astra“比Claude Fable 5.2高出5.5分”,成本只有5%。一条脚注补充道:“其排行榜上Fable 5.2的结果排除了九个使用了后备模型的任务。”
这两张表拼不出一个结论。Anthropic拿Fable 5.2和GPT-6 Astra比,OpenAI拿更新的GPT-6.2 Astra和Fable 5.2比。每家还自己挑选展示哪些基准。
独立数据来自Artificial Analysis排行榜,它用自己所说的智能指数(Intelligence Index)给115个模型打分。我看的时候,第一行是Claude Fable 5.2,65分,设置为Max和Default Fallback。接下来四行都是62分:Fable 5.2的另外两个设置,以及GPT-6.2 Astra的两个设置。
Default Fallback是页面自己的标签,页面没有解释它是什么。页面还记录了每个任务的成本和耗时,所以每个分数都要和这两项放在一起看。
排行榜页面没有显示更新日期,差距也会随你选的推理设置而变。我把它当作某一天的一次测量。
Claude vs ChatGPT怎么选?用四个问题代替记分卡
分数太接近了,所以选Claude还是ChatGPT,我会用关于自己工作的四个问题来决定。这四个问题分别是任务、文件和应用、每天的用量,以及数据。
先说明我自己的立场,方便你打个折扣。在日常工作里,我用Claude处理涉及文件和代码的长时间工作,ChatGPT加Codex是我在代码上的备选,也用来做图片。这个习惯本身就是偏见,所以后面几节以官方页面为依据,我的观点都会标明是观点。
问题1:你最常做的是哪类任务?
常见任务两个产品都能做,所以从每周占你最多时间的那一类开始。快速提问、长文档、成品文件、代码和图片,是不同的工作。
Work和Codex帮助页说明了ChatGPT怎么区分它们:“Chat用于快速的对话式协助和日常问题。Work是一个智能体,为更长的多步骤工作和成品交付而设计。”同一页面还说,Codex仍然专门用于软件开发和技术工作。
这里的智能体(agent)指的是一种模式:工具自己连续完成几个步骤,比如读文件,然后产出一份完整的报告。Claude也有智能体功能。Claude价格页在Free版里列出了网页搜索、文件创建和代码执行,从Pro版开始还有Claude Code和任务定时。
问题2:你在哪些文件和应用里工作?
这里要看两件事:工具一次能装下多少文字,以及它能不能连接你存放文件的应用。公开的数字按套餐和模型拆分的方式各不相同,所以只当作大致参考。
上下文窗口(context window)是模型在一次对话里能同时看到的文字量,就像你摊开文件的那张桌子有多大。它用token来计量,token是词的片段,按经验,一百万token大约相当于750,000个英文单词。
Claude的用量与长度限制页说,在付费套餐上“最新的模型支持最高1M token的上下文窗口”,其他模型支持500K或200K。
ChatGPT把即时模型(马上回答)和推理模型(在更难的问题上多花时间)分开。ChatGPT价格页给推理模型列的是:Go和Plus为256K token,Pro为400K。即时模型在Free上是27K,Go和Plus是54K,Pro是128K。
ChatGPT的Work和Codex区域有自己的数字:帮助页写明,GPT-6.1 Sol在那里的默认窗口是500,000 token。这些都是各家自己给的数字,所以我会拿自己最长的文件去测。
应用方面,Claude价格页从Pro版开始列出Claude in Chrome和Microsoft 365。ChatGPT价格页列出了Excel、Word、PowerPoint和Google Sheets的扩展,在Free和Go上有限制,Plus上包含。两个页面也都列出了项目(projects)和跨对话记忆,各套餐的限制不同。
问题3:你每天会用多少?
两家都没有公布每天固定的消息条数,所以没人能告诉你一个套餐对你来说够用到什么程度。官方页面说明的是各自怎么计算用量。两种设计不一样,如果你在同一个订阅里既聊天又写代码,这个区别最要紧。
ChatGPT关于模型的帮助页写道:“Free和Go用户可以无限次进行日常文字聊天,但受防滥用保护措施约束。”其他工具有各自的限制。页面列出了文件上传、图片生成、语音和数据分析,并说Work和Codex的用量规则与Chat分开。
这个“无限”只覆盖日常文字聊天。OpenAI的价格表在Free、Go、Plus和Pro上都标为“Unlimited”(无限),并附了一条关于合理使用的脚注。
ChatGPT Plus页面补充说,Plus可能有用量限制,比如消息上限,尤其是在需求高峰期。模型页面写明:“Pro订阅不包含无限使用GPT-6 Pro模型。”
Claude的算法不同。它的限制页面说,付费套餐有“每五小时重置一次的会话限制,以及每周重置一次的每周限制”。价格页补充说“没有固定的消息条数”,网页版、桌面版、手机版和Claude Code都从同一个额度池里扣。
在我看来,两种设计本身没有优劣。一个额度池容易掌握,但写代码很多的一天会吃掉你的聊天额度。单独的Work和Codex额度让智能体和编程工作不占聊天额度,但这两者共用一份,你要盯的表也不止一个。
两家都给自己留了调整限制的空间。Anthropic写道:“我们可能会自行调整用量限制,以管理容量并确保所有用户都能公平使用。”
问题4:你的数据会怎样?
在个人账户上,两家都可能用你的聊天记录训练模型,也都提供一个开关来控制。在工作版套餐上,两家都说默认不训练。区别在于措辞、数据保留多久,以及广告。
OpenAI的数据使用页面说,当你使用面向个人的服务时,也就是Free、Plus和Pro,“我们可能会使用你的内容来训练我们的模型”。这个开关叫Improve the model for everyone(为所有人改进模型),在Settings(设置)下的Data controls(数据控制)里。工作方面,页面说OpenAI默认不使用ChatGPT Business、Enterprise或Edu的内容来改进模型。
Anthropic关于模型训练的页面说,训练适用于“你选择允许我们使用你的聊天和编程会话来改进Claude”的情况。这个开关叫Model Improvement,在Privacy Settings(隐私设置)里,页面还提到被标记进行安全审查的对话。对于Team和Enterprise,Claude价格页写的是:“默认不会用你的内容训练模型”。
两家的价格页给个人套餐上的训练用了同一个词:opt-out(默认开启,可以自行关闭)。Anthropic的隐私页面把它描述为你做出的选择,而它2025年8月28日的条款更新说,新用户在注册时选择这个偏好。注册当天就去打开这个设置看看。
反馈是另一条通道:点赞或点踩会把整个对话发过去,两个页面都说这些反馈可能会被用来训练模型。Anthropic说这样的对话最多保存5年。OpenAI说即使你已经选择不参与训练,这种使用也照样适用。
两家都有一种不进入训练的聊天模式。OpenAI说:“临时聊天在保持临时状态期间,不会被用于改进OpenAI的模型”。Anthropic说:“你的无痕(Incognito)聊天不会被用于改进Claude,即使你开启了Model Improvement”。
关于保留期,也就是聊天记录保存多久,资料就少了。上面那份Anthropic条款更新写的是:允许训练保存五年,不允许则保存30天。这篇文章已经快15个月了,OpenAI的训练页面也没有写保存期限,所以在依赖任何一方之前,两边都要核实。
关于广告,OpenAI广告页面写道:“Free和Go套餐的用户可能会看到广告。Plus、Pro、Business、Enterprise和Edu账户不会有广告。”它还说:“广告不会影响ChatGPT的回答。”
Anthropic的价格页没有提到广告。我把这理解为页面上没写,而不是一个承诺。广告主那一面,我在ChatGPT广告指南里讲过。
Claude Pro vs ChatGPT Plus:套餐多少钱?
按月付费时,Claude Pro和ChatGPT Plus价格一样:截至2026年11月都是每月$20。Claude Pro按年付费降到每月$17,而OpenAI说Plus没有按年付费的选项。两家也都有免费版,以及从$100起的更高档套餐。
| 套餐档位 | Claude,截至2026年11月 | ChatGPT,截至2026年11月 |
|---|---|---|
| 免费 | Free版 | Free版 |
| 入门付费套餐 | Pro:按月$20,或按年付费每月$17(预付$200) | Plus:按月$20,没有按年付费 |
| 更高档个人套餐 | Max $100,Ultra $200 | Pro 100 $100,Pro 200 $200,Pro 500 $500 |
| 低价套餐 | 没有列出 | Go:价格页文字里没有价格 |
| 团队 | Team:2到150人,按年付费每人$20,按月$25 | Business:2个用户起,价格页文字里没有价格 |
以上来源都在2026年11月18日读过:Claude价格页、ChatGPT价格页、ChatGPT Plus页面,以及ChatGPT Pro档位页面。
更高档的套餐主要是加用量。Anthropic把Max描述为“5倍Pro用量”,把Ultra描述为“10倍Pro用量”。OpenAI的Pro分三档,只能按月付费,价格页还加上了基于GPT-6 Astra的Pro推理。
Claude哪个版本最好?ChatGPT又是哪个?
最好的版本取决于任务,连Anthropic自己也不让所有人都用最顶级的模型。对于大多数编程和知识类任务,它的发布文章说“我们建议用户从Claude Opus 5.5开始,这是我们最强的日常主力模型”。Fable 5.2在它之上,用于最有野心的技术工作,下面是Sonnet 5.5和Haiku 5.5。
各套餐能用的模型不同。在Claude价格页上,Free版列的是Sonnet和Haiku。Fable在Pro上要用用量积分(usage credits)付费,在Max和Ultra上包含在内,最多可用每周额度的一半。
ChatGPT这边,Sol是付费套餐在Chat里的模型,一个Luna模型服务Free和Go,Astra负责Pro推理。OpenAI的帮助页补充说,Plus套餐在ChatGPT Work和Codex里包含GPT-6 Astra。
如果你在这些模型上开发软件,就按token付费,截至2026年11月,顶级模型的标价是一样的。Anthropic给Fable 5.2的标价是每百万输入token $8、每百万输出token $40,OpenAI给GPT-6.2 Astra的标价也是这两个数。较小的Claude模型,我在Claude价格与模型对比里做过比较。
为什么官方页面对你用的是哪个模型说法不一?
最可能的原因是时间差:模型几周就变,页面却在不同时间更新。2026年8月6日的一条更新说明宣布GPT-5.6 Luna成为Free和Go的默认模型,2026年10月7日的一条写的却是GPT-6 Luna。2026年11月18日,有两个OpenAI页面给免费版写的是GPT-6 Luna,另有两个帮助页仍写着GPT-5.6 Luna。
OpenAI的价格页在Free上列了“Unlimited text chats with GPT-6”(与GPT-6无限次文字聊天),套餐表里把GPT-6 Luna标为包含,把GPT-5.6 Luna标为不包含。Free档常见问题说Free用户可以使用GPT-5.6 Luna。关于模型的帮助页写的是:“GPT-5.6 Luna正在成为Free和Go用户的默认模型。”
这四个页面都没说哪种说法是最新的。Anthropic的页面也要同样小心。它的价格页说Free的用量“每5小时和每周”受限,而它自己的常见问题却说“付费套餐在此基础上增加每周限制”。
那个页面同样没有日期,保留期的数字来自一篇2025年8月的文章。
我的结论是:每个模型名旁边都写上日期。想了解OpenAI的发布节奏,可以看我写的GPT-6发布日期。
Claude Code还是Codex:编程和自动化用哪个?
两家都提供在终端里工作的编程工具,终端就是开发者输入命令的那个文字窗口。Anthropic的是Claude Code,OpenAI的是Codex。在这些来源里,没有哪项独立测试能说明哪一个在你的项目上写的代码更好,所以实际的区别在于使用权限和额度。
根据价格页,Codex出现在ChatGPT的每个个人套餐里:Free和Go有限制,Plus包含,Pro扩展。至于Claude Code,Anthropic的价格页说它“包含在所有付费套餐中”。
额度的问题和问题3一样。Claude Code和你的聊天共用一个额度池,Codex用的是Work和Codex的额度,与Chat分开。如果你整天写代码,我认为这个细节比一个基准分数更重要。
2026年夏天,我花了大约一个月评估要不要把编程工具换成另一家的。在我的工作上,两边的模型水平相当。真正影响决定的是用量限制和切换成本,因为技能、脚本和各种连接都得重新搭。
两家的价格页都列出了技能(skills),也就是一个个装着说明、有时还有脚本的文件夹,工具在做重复性工作时加载它们。Anthropic的版本我在Claude Skills指南里讲过。
你的这一个月也可能得出相反的结论,所以要用真实的工作来比较,并算上重新搭建配置的成本。
写作上Claude和ChatGPT对比:有证据吗?
没有。在写作和营销文案上,没有哪个公开了方法的来源能说明谁写得更好,所以你在这一点上读到的任何说法,包括我的,都是观点。
我信得过的检验,就是要点里那个三天测试,用你自己的文案来跑。例子:同一份客户简报和同样三个文件,周一、周二、周三分别交给两个工具,在每份草稿旁边记下修改花了多少分钟。
我那篇ChatGPT营销讲了这个工具在实际工作中的局限,按我的经验,其中大部分对任何AI助手都适用。
ChatGPT和Claude要同时用吗?
要,前提是每一个都能帮你做一件另一个做不了的工作。截至2026年11月,两个入门套餐加起来每月$40,所以第二个工具得靠一个你说得出名字的任务来证明它值得。
在我自己的工作里,图片是最清楚的例子。ChatGPT价格页在每个个人套餐里都列出了图片创建,Free版有限制,更新说明还在2026年11月4日宣布了ChatGPT Images 2.6。Anthropic的页面没有在功能里列出图片生成,但这并不能证明Claude做不到。
所以我用ChatGPT的图片生成器为页面做参考图,搭建和检查则在另一个工具里完成。如果图片是你的主要工作,我那篇GPT Image 2和Nano Banana 2.1对比讲了每张图的价格。
如果是小企业,我会先从一个套餐开始,把它做不好的任务记下来,只为这些任务再加第二个工具。
什么时候选Claude,什么时候选ChatGPT:一张工作地图
选Claude还是ChatGPT,一次看一项工作。官方页面显示,在付费套餐上,Claude最新模型公布的窗口更大,适合长文档。ChatGPT则在每个个人套餐里都列出了图片创建和无限次日常文字聊天。
下面这张地图按来源的说法给常见工作分类,最后一列标明每一行的依据出自哪里。没有哪一行给所有人指定赢家,因为证据支持不了任何一个。
| 工作 | 来源怎么说,截至2026年11月 | 证据类型 |
|---|---|---|
| 日常提问 | 两家的免费版都能做。ChatGPT在个人套餐上写明日常文字聊天无限次,有保护措施。Claude没有公布固定的消息条数。 | 官方页面 |
| 长文档 | Claude:付费套餐上最新模型最高1M token,其他模型500K或200K。ChatGPT:推理模型在Go和Plus上256K,Pro上400K,在Work和Codex里用GPT-6.1 Sol为500,000。 | 官方页面 |
| 图片 | ChatGPT从Free版起列出图片创建。Anthropic的页面没有列出图片生成。 | 官方页面 |
| 编程和自动化 | Claude Code在所有付费套餐上,与聊天共用额度池。Codex从Free版起有限制地提供,用Work和Codex共用的额度。 | 官方页面 |
| 客户数据或敏感数据 | 两家的工作版套餐默认不训练。个人套餐上两家都有一个开关。 | 官方页面 |
| 模型总体分数 | 第一行Claude Fable 5.2,65分。接下来四行62分,分属Fable 5.2和GPT-6.2 Astra。页面没有更新日期。 | 第三方:Artificial Analysis |
| 营销文案 | 没有公开方法的来源。我用同一份简报测试两者。 | 我的观点 |
| 语气和个性 | 个人口味。公开评论两个方向都有。 | 我的观点 |
我建议的测试很小。从你这一周里拿一个真实任务,在两个工具上各跑三天,记下你修改每个结果花了多长时间。
无论选哪个工具,结果交给客户之前都要检查。按我的经验,两者都可能很自信地说出错误的内容,我的检查流程写在AI幻觉与人工审核里。
一条真实评论:基准测试决定不了谁更好
一个比较这两个工具的公开Reddit帖子,在搜索预览里显示了一条关于基准测试的评论。我引用的只有这段预览:它标注为八个月前,也没有显示用户名。
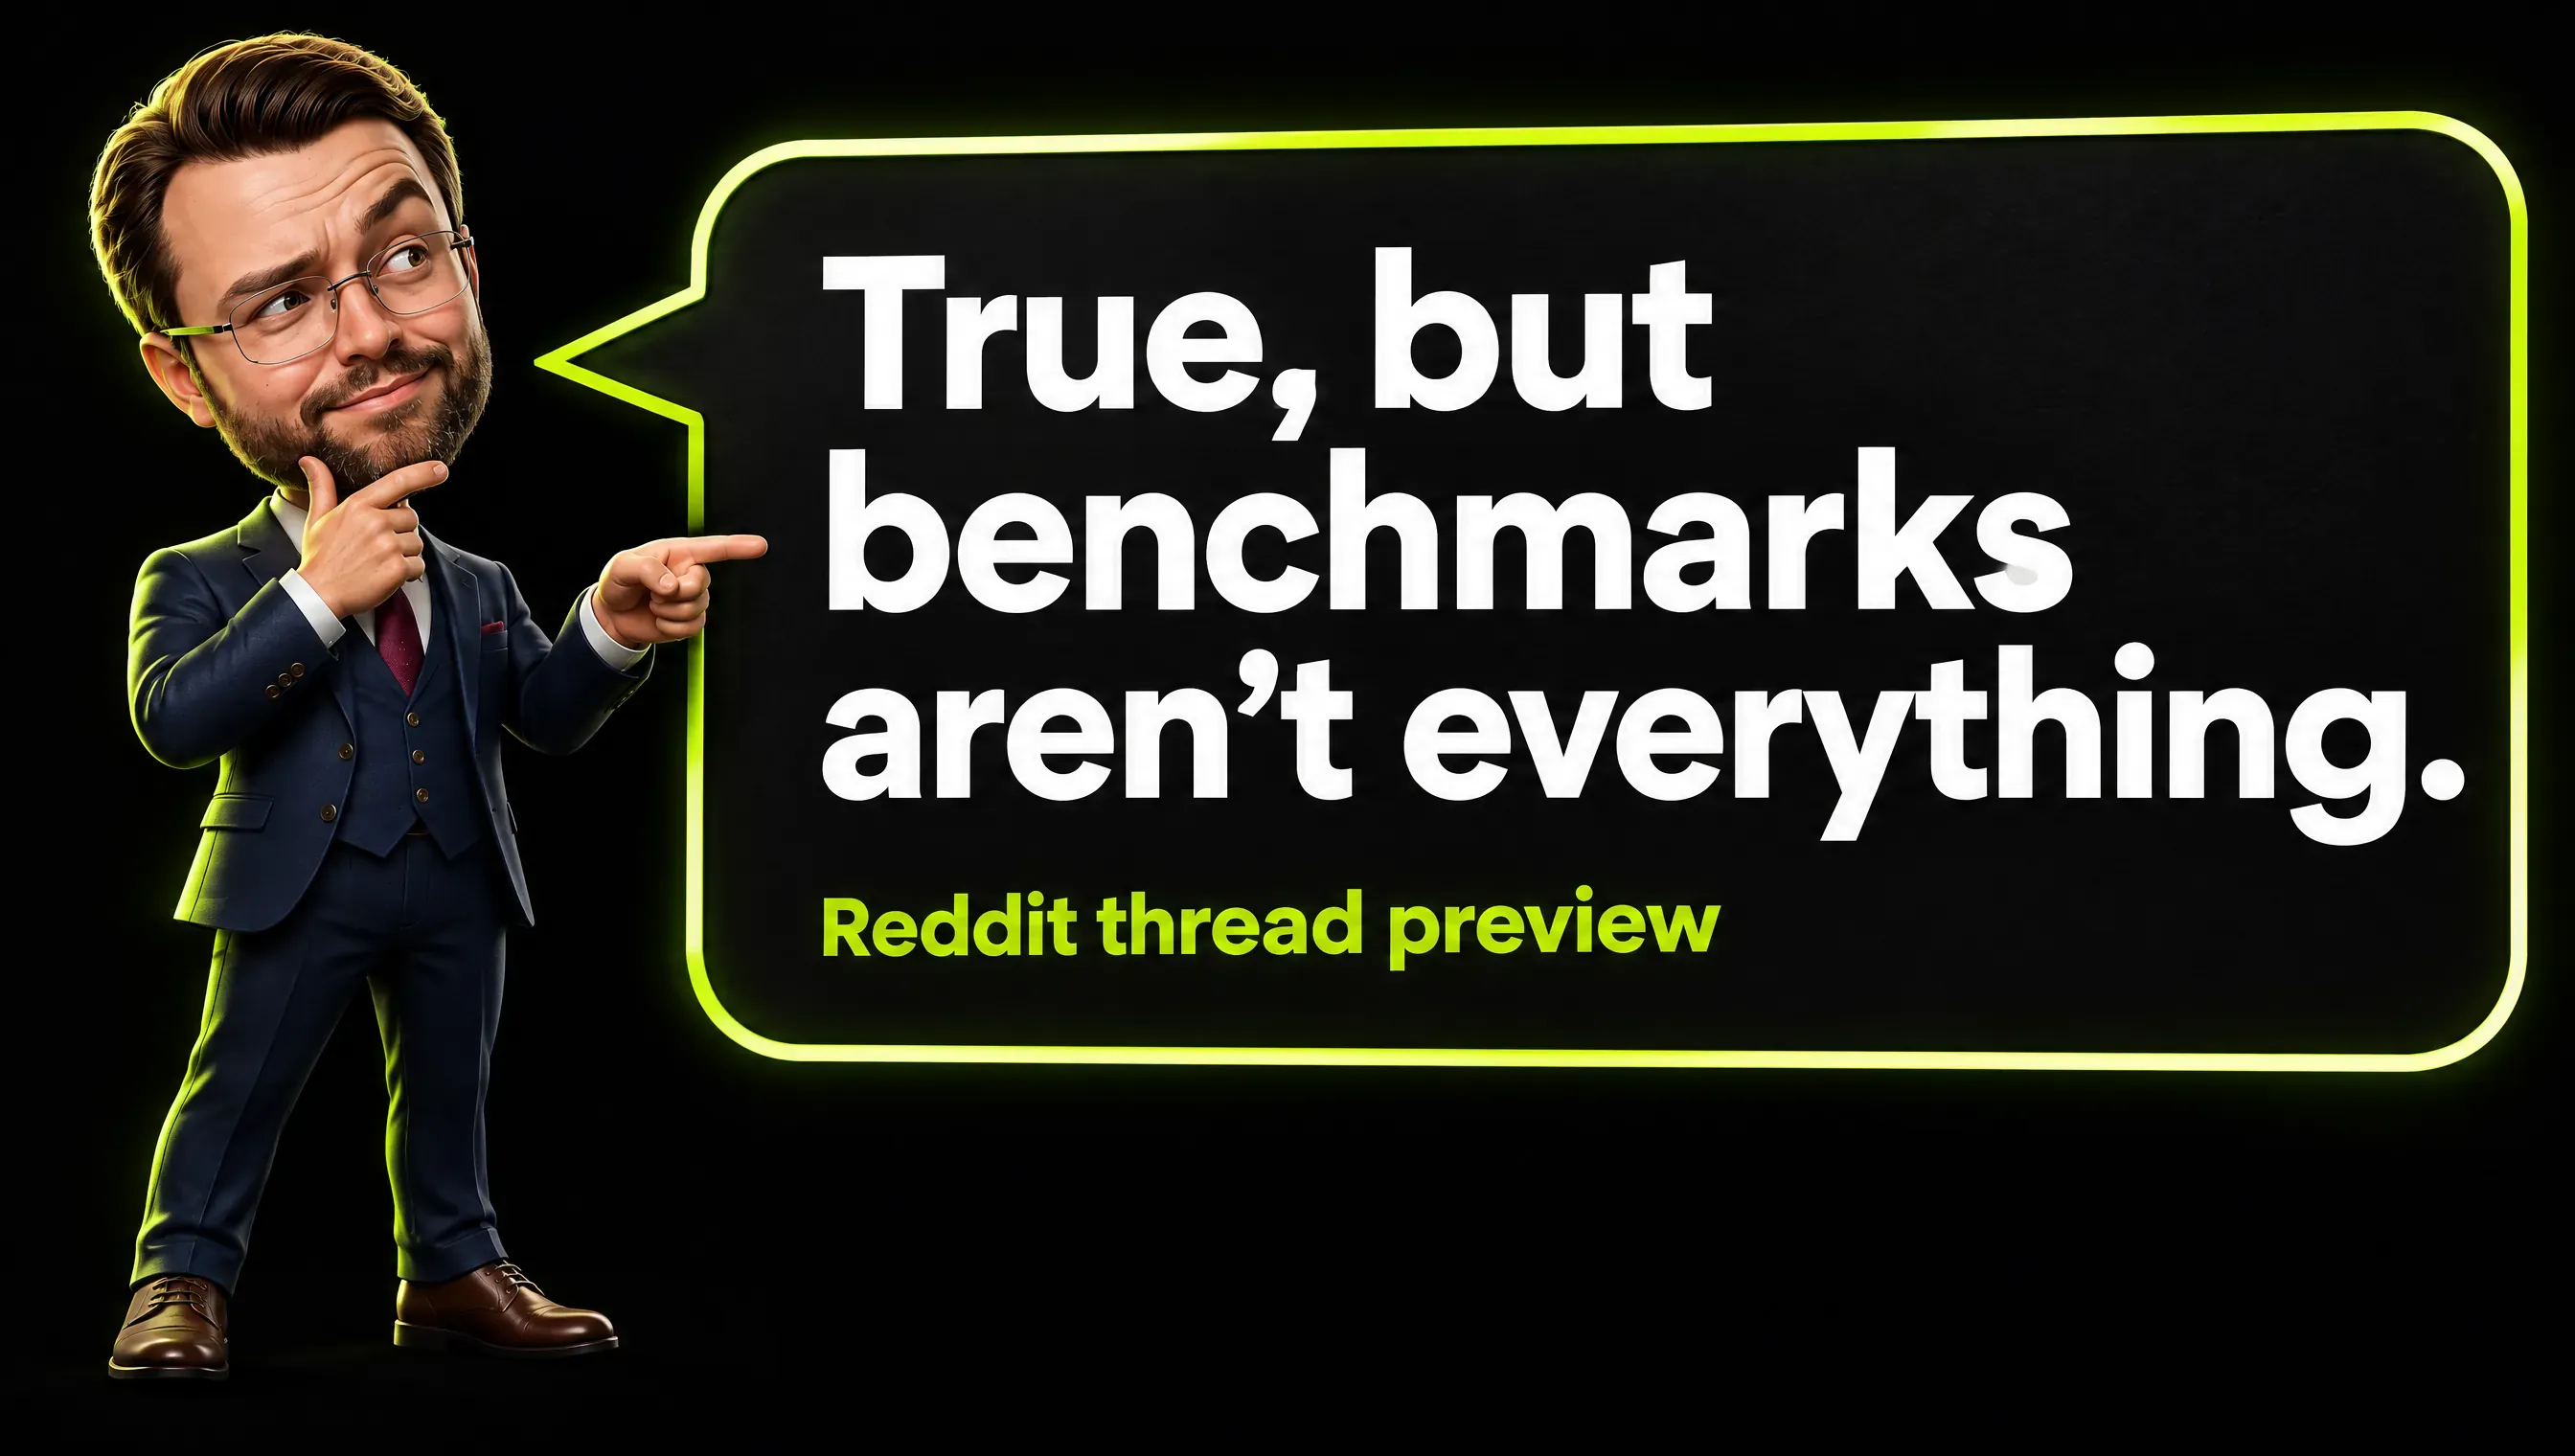
真实评论,来自一个关于ChatGPT和Claude的Reddit帖子的搜索预览。
评论原文是:“True, but benchmarks aren’t everything.”(没错,但基准测试不是一切。)它接着说,比较这两者时,真实使用中的表现和用途同样重要。
我同意,但有一个条件。真实使用胜过分数,前提是你去测量它,否则很容易用感觉替代基准测试。
个人结论也指向相反的方向,下面这两条同样来自搜索预览,没有显示用户名。另一个Reddit帖子的预览同样标注为八个月前,里面先是“看你想要什么。”,然后是“我喜欢Claude的个性,多得多”。
一条公开Facebook群组帖子,预览显示是两天前,把ChatGPT排在前面:“两个我每天都用,到现在根本不是势均力敌的比赛”。两位作者意见相反,两条评论都不是测量,所以适用于你的结论来自你自己的测试。
常见问题
Claude比ChatGPT好吗?
不是对所有人都好,也无法证明。截至2026年11月,Artificial Analysis指数上Claude的一个设置是65分,另有四行并列62分,两家的模型都有。每家公司都在自己的测试里领先,而这些测试比较的是不同的模型组合,所以要根据你的任务、文件、每天的用量和数据需求来选。
做营销和写作,用Claude还是ChatGPT?
没有哪个公开了方法的来源能给出定论。给两者同一份简报和同样的文件,然后比较你修改每份草稿花了多长时间。
Claude AI完全免费吗?
不是,只有一部分免费。Claude有Free版,包含网页搜索、文件创建、代码执行和记忆,用量每五小时和每周受限。截至2026年11月,付费套餐从每月$20起,按年付费为每月$17。
ChatGPT和Claude哪个更便宜?
入门档价格一样:按月付费时,ChatGPT Plus和Claude Pro都是每月$20。Claude Pro按年付费降到每月$17,而OpenAI说Plus没有按年付费的选项。
Claude哪个版本最好?
Anthropic建议大多数工作从Claude Opus 5.5开始,Fable 5.2留给最有野心的任务。Sonnet 5.5和Haiku 5.5更便宜,Free版列出的是Sonnet和Haiku。
Claude能像ChatGPT一样生成图片吗?
截至2026年11月18日,Anthropic的页面没有在Claude的功能里列出图片生成。ChatGPT从Free版起就列出了图片创建,OpenAI还在2026年11月4日发布了ChatGPT Images 2.6。
ChatGPT或Claude会用我的聊天记录训练模型吗?
在个人账户上两家都可能会,也都提供一个开关来控制。在ChatGPT Business和Claude Team这样的工作版套餐上,两家都说默认不训练。
对小企业主来说,Claude比ChatGPT好吗?
对小企业来说,没有哪个默认就更好。先从一个$20的套餐开始,用真实任务跑三天测试,如果你要处理客户数据,再看看工作版套餐。
Claude vs ChatGPT一句话总结
2026年11月,Claude vs ChatGPT没有唯一的赢家:入门价相同,头部分数只差3分。回答这四个问题,用一个真实任务把两者都测一遍,然后在你的选择旁边写上日期。
我写营销、AI,以及它们背后的数字。如果这篇文章对你有用,欢迎在LinkedIn(领英)上关注我。